AISTATS 2025 | 大语言模型在时间序列预测上也会被欺骗?

AISTATS 2025 | 大语言模型在时间序列预测上也会被欺骗?

时空探索之旅
发布于 2025-05-19 11:09:56
发布于 2025-05-19 11:09:56
🔗 论文标题:Adversarial Vulnerabilities in Large Language Models for Time Series Forecasting
👨💻 作者:Fuqiang Liu*(刘福强), Sicong Jiang*(姜思聪), Luis Miranda-Moreno, Seongjin Choi, Lijun Sun(孙立君)
🏫 单位:麦吉尔大学(McGill),明尼苏达大学双城分校(UMN)
🗓️ 收录会议:AISTATS 2025
🔍链接:https://arxiv.org/abs/2412.08099
🔗 开源代码: https://github.com/JohnsonJiang1996/AdvAttack_LLM4TS
🧪项目页面: https://fuqliu.github.io/attack-llm4ts/
点击文末阅读原文跳转本文项目链接
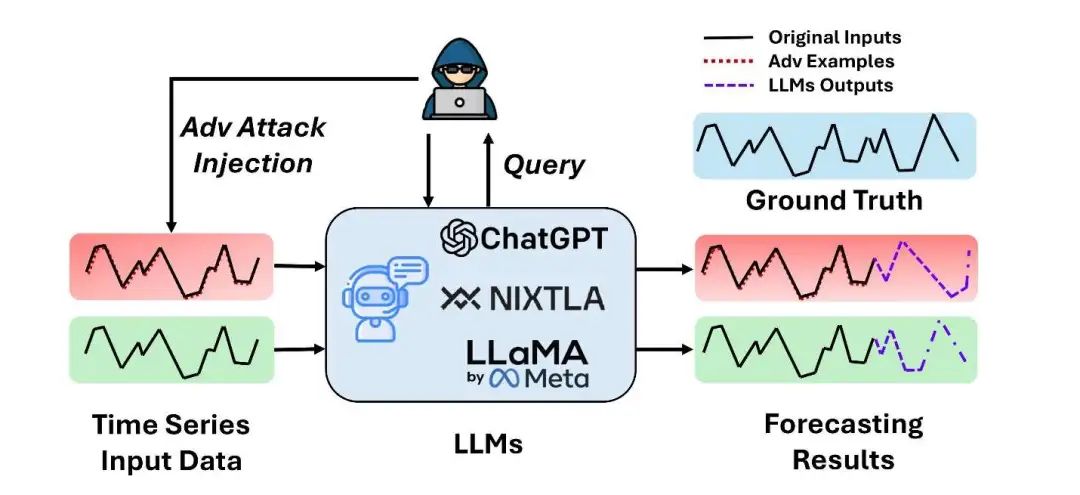
🧵 TL;DR:本文首次系统研究了大语言模型(LLMs)在时间序列预测中的对抗鲁棒性,针对LLM内部参数不可知的特点提出了黑盒无梯度攻击框架Directional Gradient Approximation (DGA) ,在多个数据集和不同的主流 LLM 架构(TimeLLM, LLMTime, TimeGPT)上都能产生显著的攻击效果,强调了 LLM4TS 在部署前需进行鲁棒性评估与防御设计的重要性。
🧩 研究动机:LLMs + 时间序列鲁棒性如何?
LLMs 正逐步在时间序列预测中大展身手,从能源调度、金融预测到智能交通。但一个核心问题被忽略了:
它们真的鲁棒吗?尤其在面临小扰动攻击时,还能正常预测吗?
作者指出,相较于常规的预测/图像/文本任务,基于大模型的对抗攻击研究远远滞后,而 LLM 的黑盒属性、预测结构、token 编码等特性使其对攻击更脆弱,且更难防御。
同时,基于 LLM 的时间序列预测模型的漏洞仍未得到充分理解。具体而言,由于以下两个挑战,现有的对抗性攻击无法直接应用于这些模型:
1. 表示未来某个时间步长值的 ground truth 在时间序列预测的运行过程中不可用。尽管如此,大多数现有的对抗性攻击依赖于 ground truth 来计算梯度并产生扰动;
例如,考虑提前 5 分钟的股票价格预测。上午 10:00 的 ground truth 对应于上午 10:05 的股票价格,而该价格在上午 10:00 时对于预测者和攻击者而言都是无法获得的。典型的攻击方法,例如 FGSM 和 PGD,依赖于 ground truth 来计算梯度并生成对抗性样本。
2. 由于难以访问其内部工作原理和参数,LLM 必须被视为严格的黑盒系统。
例如,考虑攻击商业预测模型 TimeGPT。攻击者无法访问模型的参数,因此使用这些参数生成对抗性示例是不可行的。
🧨 核心创新:无梯度 + 黑盒 + 极小扰动 = 高效攻击
本工作提出了一个黑盒无梯度对抗攻击方法——Directional Gradient Approximation(DGA) ,该方法专对时间序列中的大语言模型设计,具备以下特定:
- 无需模型结构或梯度信息,只需要对模型进行少量query;
- 构造微小扰动,使 LLM 输出接近随机游走(如高斯白噪声);
- 在不破坏原始输入结构的前提下,显著干扰模型预测;
- 泛用性强,广泛适配于 LLMTime、TimeGPT、TimeLLM 等不同架构。
该方法通过梯度方向估计替代精确计算,并用有限差分构造最优扰动方向,攻击目标是最大化模型预测与其自身输出的差距(不能用 ground truth),优化目标如下:
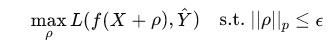
由于模型为黑盒,作者提出以随机微扰方式模拟梯度方向,再通过扰动强度+梯度方向构建扰动:
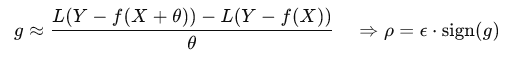
目标是使得加入扰动后的输出 Y 向高斯白噪声偏移,破坏预测效果。
🧪 实验设置与实验结果
🧩 测试模型:
🔹 TimeGPT:一个专门为时间序列训练的大模型;
🔹 LLMTime:使用LLMs直接做时间序列预测,本文实验中选择了GPT-3.5、GPT-4、LLaMa、Mistral等多个base LLMs进行测试;
🔹 TimeLLM:把时间序列重编程为“文本提示”,微调大模型进行预测;
🔸 TimeNet 和 iTransformer:两种经典的非大模型时间序列预测方法。
📊 数据集(5个):
- 电力数据(ETTh1/2)
- 城市交通(IstanbulTraffic)
- 气象(Weather)
- 外汇(Exchange)
📐 评估指标:
- MAE / MSE:误差量化
- 分布偏移:预测值 vs 随机噪声的差异
- 自相关函数(ACF):时序结构是否被破坏
实验结果:
总体实验表格:
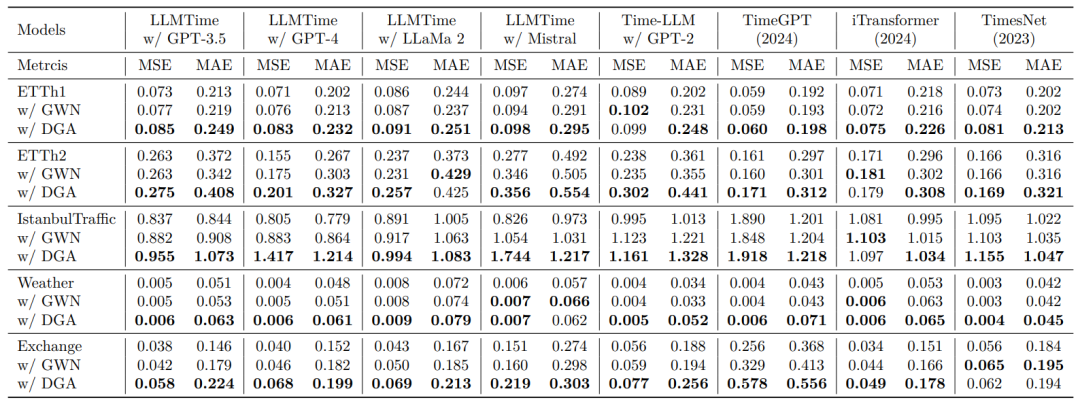
下表展示了在五个典型时间序列数据集(ETTh1/2、IstanbulTraffic、Weather、Exchange)上,主流 LLM 预测模型(如 LLMTime-GPT-3.5/4、TimeGPT、TimeLLM 等)与两个非 LLM 模型(iTransformer、TimesNet)在三种输入设置下的预测误差。可见,在加入高斯白噪声(GWN)后模型性能仅轻微下降,但在加入本文提出的 DGA(方向性梯度近似)扰动后,所有 LLM 模型的误差均显著上升,甚至超出原始误差 20% 以上。例如在 IstanbulTraffic 数据集上,LLMTime-GPT-4 的 MAE 从 0.779 提升至 1.214,而非 LLM 模型(如 iTransformer)仅小幅上升,显示出更强鲁棒性。这充分说明了 LLM 在时序任务中面对针对性扰动时的脆弱性。
输入与输出误差可视化:
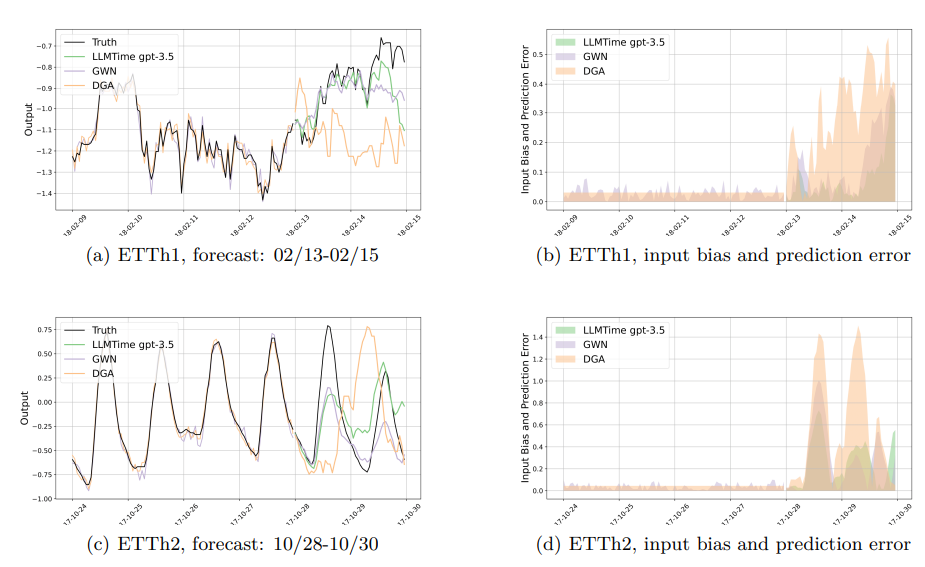
这一组图直观呈现了 DGA 扰动对 LLMTime-GPT-3.5 模型的具体影响。左侧展示了 ETTh1 和 ETTh2 数据集上模型在干净输入、GWN 和 DGA 三种条件下的预测输出对比:在干净输入下(绿色线),模型能较好跟随真实趋势(黑线);而加入 GWN 后(紫色线)模型输出仅有轻微偏移;但一旦加入 DGA(橙色线),预测序列即出现明显漂移甚至震荡失控。右侧则量化了输入扰动带来的预测误差变化,DGA 所对应的误差面积远大于 GWN,特别是在预测时间段末端,误差剧烈放大,反映出模型在面对微弱但方向精准的扰动时的易崩性。
输入与输出分布偏移:
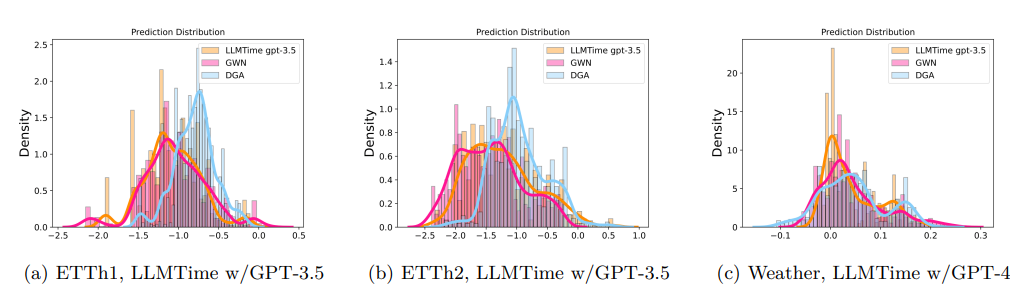
图中展示了 LLMTime-GPT-3.5 和 GPT-4 模型在 ETTh1、ETTh2 和 Weather 数据集上,面对干净输入、高斯白噪声(GWN)与 DGA 三种情况时的预测值分布对比。可以看到,DGA(蓝色分布)使预测值集中区域发生明显偏移,并呈现更大的方差和更低的峰度,表现出强烈的“随机游走”特征。而 GWN 仅带来有限扰动,分布仍近似于原始输出。这一分布偏移意味着 DGA 攻击不仅破坏了单点预测准确性,还在整体上打乱了模型的结构性输出,使其丧失对时序数据的全局建模能力。
📌 关键发现
- 攻击显著破坏预测性能: DGA造成的误差远高于同强度高斯白噪声,表现为预测值偏移、波动增强、稳定性下降。
- 高性能模型更易受攻击: LLMTime(GPT-3.5/4)和 TimeGPT 等高性能模型,在攻击下出现更大预测偏差。
- 输出分布偏移严重: 分布分析显示:对抗扰动可破坏模型对时间序列结构的建模能力,使输出产生严重偏移。
- 非LLM模型更稳健: 在相同扰动下,iTransformer 等经典模型表现出更强鲁棒性。
🛡️ 防御怎么办?
尽管对抗训练是主流解决方案,但作者指出:
LLM4TS 的预训练与微调成本极高,对抗训练几乎不可行(尤其像 TimeGPT 这种超大模型)。
因此建议:
- ✅ 轻量级输入预处理(如时序滤波器、异常检测器)
- ✅ 黑盒鲁棒性评估机制
- ✅ 任务前防御模块 + 后置异常校验机制
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2025-05-17,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号