RAG全链路设计:文档解析、Chunk策略、向量+BM25混合检索、高效召回、重排序22.1
原创
RAG全链路设计:文档解析、Chunk策略、向量+BM25混合检索、高效召回、重排序22.1
原创
未闻花名
发布于 2026-09-10 08:52:25
发布于 2026-09-10 08:52:25
一、前言
做RAG的过程中,大家应该都会遇到同一个难题:明明跟着教程搭好了基础RAG框架,知识库也上传了完整文档,可进行提问时,要么召回内容不相关、答非所问,要么关键信息缺失、回答空洞,微调模型也完全没效果。其实绝大多数RAG项目翻车,根本不是大模型能力不足,而是检索链路设计不合理。RAG的核心逻辑从来不是让大模型更聪明,而是给大模型找对、找全、找准参考资料。
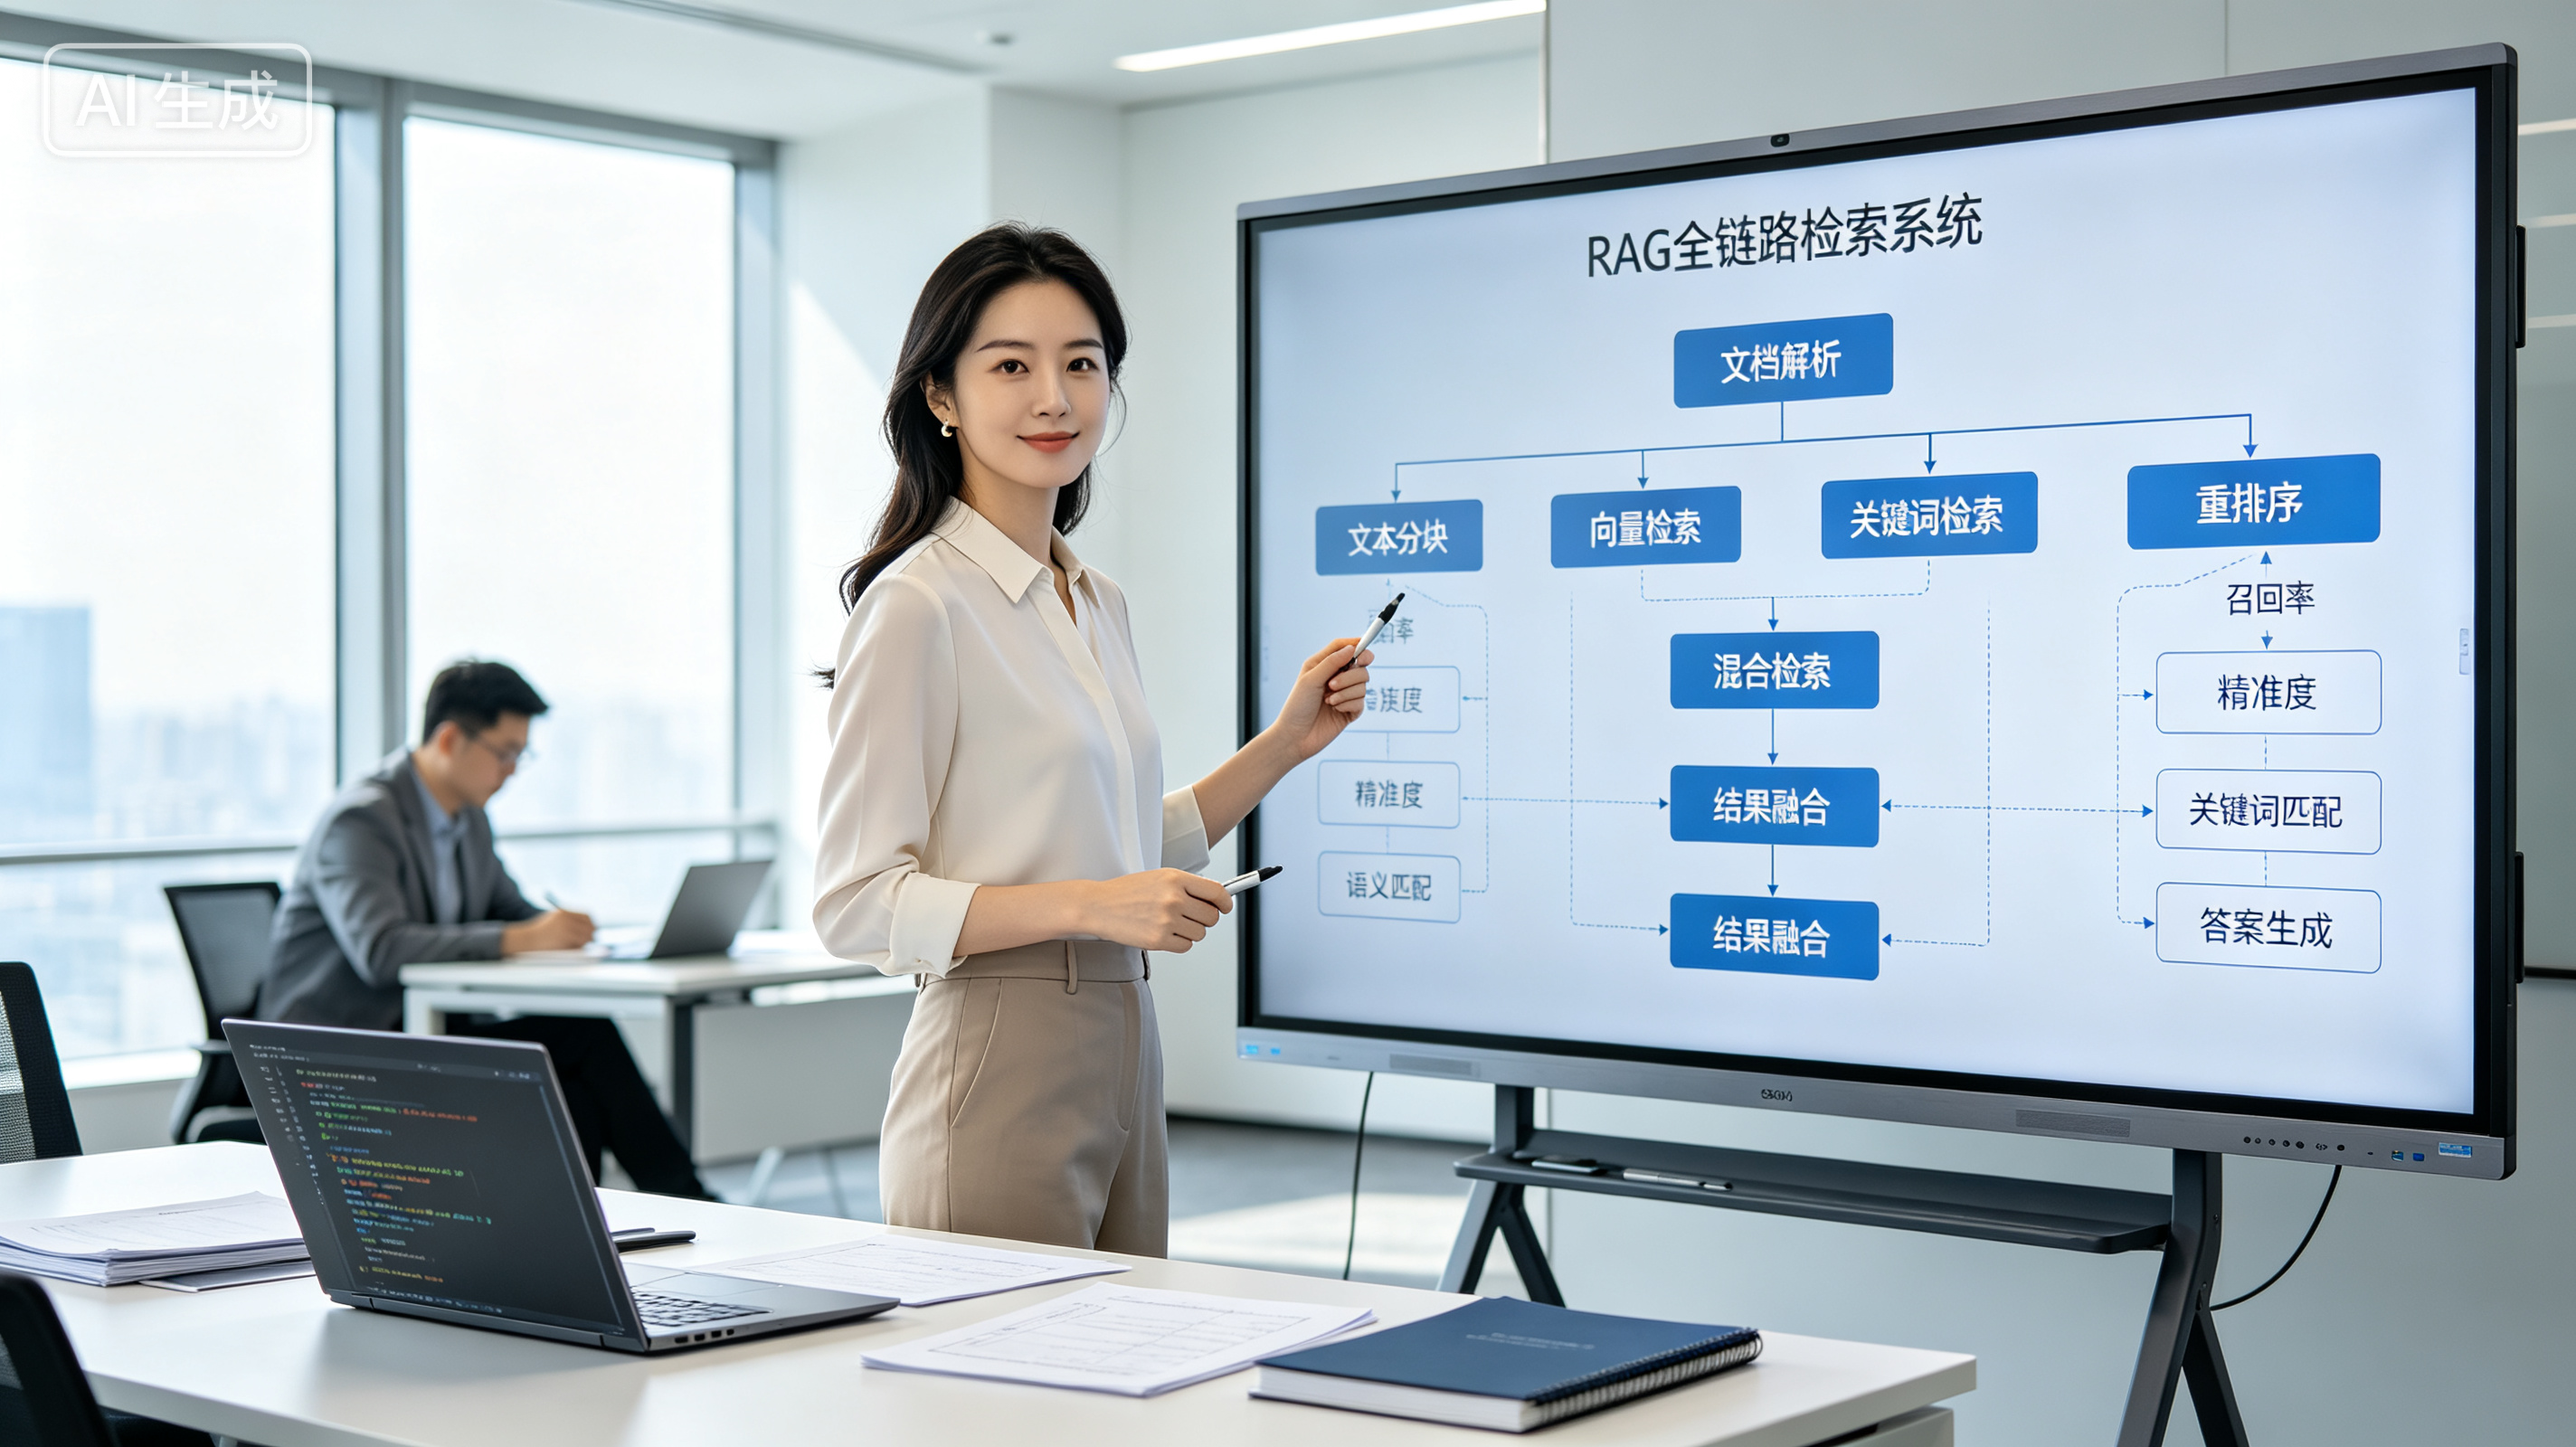
完整的RAG全链路包含文档解析、Chunk分块、双路检索、结果融合、重排序五大核心环节,每一步的选型和调优,都直接决定最终问答效果。早期在接触过程中,也搜索很多资料都是很碎片化的,很多都只单独讲解向量检索或BM25,很少串联完整工程链路。今天结合实际应用总结回顾整理,首先梳理RAG全链路逻辑,其次根据不同业务场景,独立设计最优的检索方案,彻底解决RAG召回不准、效果差的问题。
二、RAG全链路认知
1. 什么是RAG全链路
RAG全称检索增强生成,核心是“先检索、后生成”,用私有知识库的真实数据,弥补大模型训练数据滞后、知识受限、易幻觉的缺陷。通常很容易误以为RAG就是“文档向量化+向量检索”,这是非常片面的认知,单一向量检索只能满足极简场景,复杂业务下必然失效。
完整的RAG全链路,是一套闭环的工程流水线,从前到后依次为:文档解析清洗→文本分块策略→文本向量化存储→多路检索召回→检索结果融合→重排序优化→大模型生成。每一个环节环环相扣,前一步的误差,都会被后续环节放大,最终导致整体效果崩塌。

简单来说,大模型只负责“整理语言、生成答案”,所有的知识准确性、内容相关性,全部依赖前置检索链路。这也是为什么工程界常说:RAG的上限由检索决定,大模型只负责兜底。
2. 各环节核心作用
为了让大家快速建立全局认知,我们逐个理清各环节的核心价值:
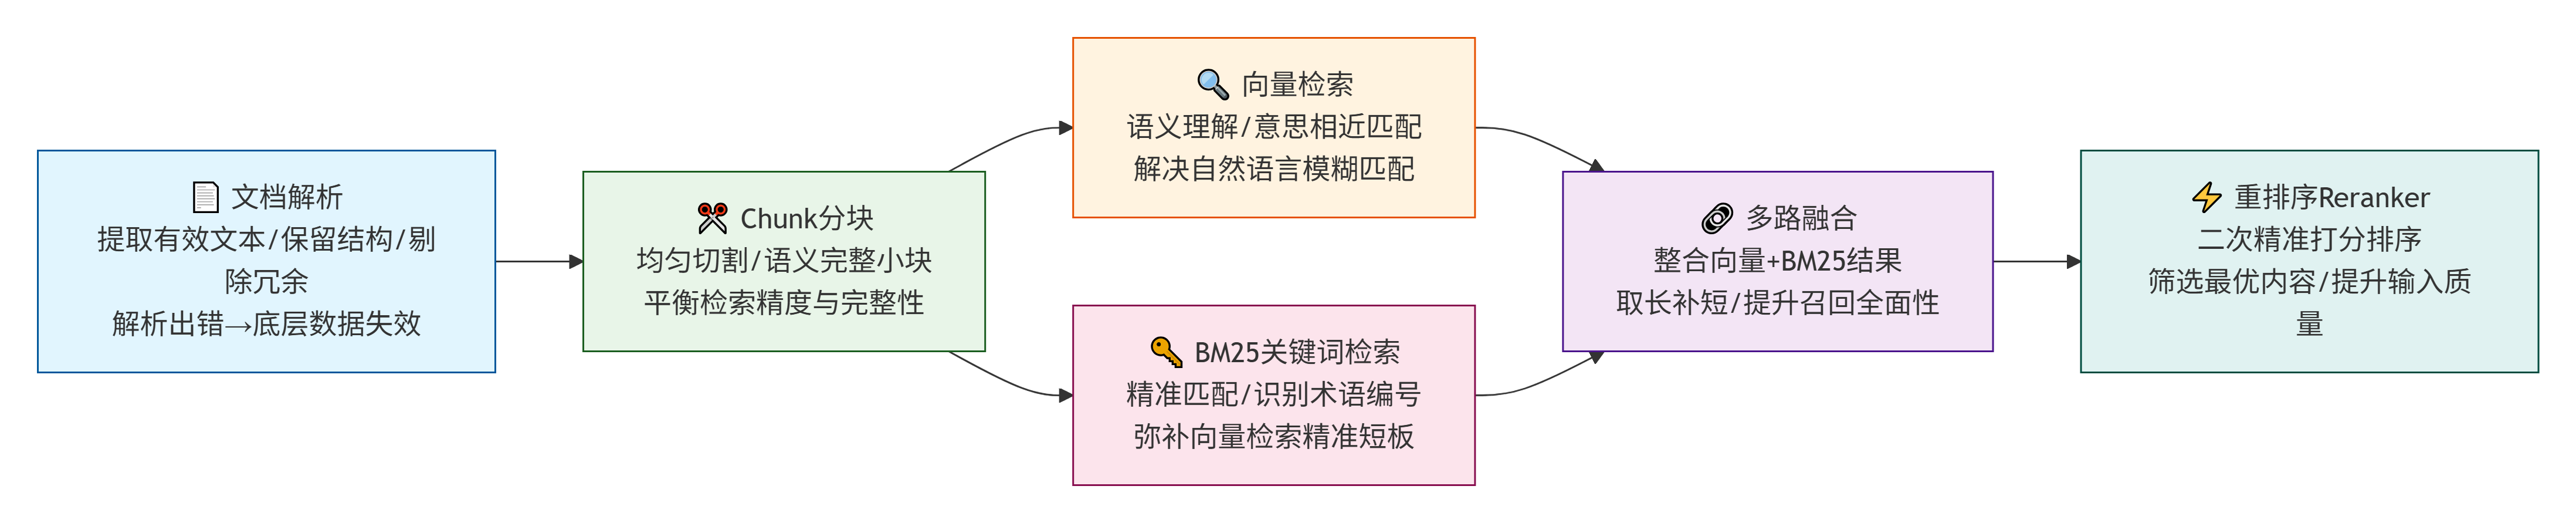
- 1. 文档解析:原始文档格式杂乱、包含冗余信息,解析环节负责提取有效文本、保留结构信息,剔除无效内容,是所有流程的基础,解析出错会直接导致底层数据失效。
- 2. Chunk分块:大段文本无法精准检索,分块是将长文本切割为均匀、语义完整的小块,平衡检索精度与语义完整性,是影响召回效果的核心基础步骤。
- 3. 向量检索:主打语义理解,能匹配意思相近、表述不同的问题与文本,解决自然语言模糊匹配场景的检索需求。
- 4. BM25关键词检索:主打精准匹配,识别专业术语、编号、专有名词,弥补向量检索精准词匹配失效的短板。
- 5. 多路融合:整合向量检索与BM25检索的结果,取长补短,避免单一检索的局限性,提升召回全面性。
- 6. 重排序Reranker:对融合后的候选结果二次精准打分排序,筛选最优内容,大幅提升最终输入大模型的文本质量。
3. 常见误区说明
刚开始做RAG效果差,根源是陷入了三大认知误区,这里总结,供大家提前避坑:
- 第一,重模型、轻检索。一味追求更大参数的大模型、更好的Embedding模型,却忽略分块策略、检索组合、重排序的优化,本质是本末倒置。
- 第二,只用单一向量检索。向量检索擅长语义匹配,但对精准关键词、专属编号、专业术语不敏感,纯向量检索极易丢失关键信息。
- 第三,跳过融合与重排序。直接将粗召回的结果喂给大模型,冗余内容多、有效信息杂,不仅增加模型负担,还容易导致回答错乱。
4. 全链路基础示例
为了快速建立整体落地认知,这里提供极简可运行的RAG全链路应用示例,包含解析、分块、向量检索、BM25检索基础逻辑,无复杂依赖,对应本章讲解的全链路核心流程。
# RAG全链路极简入门Demo
import re
from typing import List
# 模拟文档解析、清洗
def parse_and_clean_doc(raw_text: str) -> str:
    # 剔除空行、特殊符号、冗余空格
    text = re.sub(r'\s+', ' ', raw_text)
    text = re.sub(r'页码|页眉|页脚|版权', '', text)
    return text.strip()

# 模拟固定长度分块
def chunk_text(text: str, chunk_size: int = 600, overlap: int = 80) -> List[str]:
    chunks = []
    start = 0
    while start < len(text):
        end = start + chunk_size
        chunk = text[start:end]
        chunks.append(chunk)
        start = end - overlap
    return chunks

# 模拟双路检索占位(后续章节完善)
if __name__ == "__main__":
    # 原始文档文本
    raw_doc = "这里是业务知识库原始文档内容,包含各类业务规则、参数说明、流程方案..."
    clean_text = parse_and_clean_doc(raw_doc)
    chunk_list = chunk_text(clean_text)
    print(f"文档分块完成,总块数:{len(chunk_list)}")
三、文档数据解析
1. 解析的核心价值
文档解析是RAG的第一步,也是最容易被忽视的关键一步。通常我们拿到PDF、Word、PPT等原始文档后,直接全局读取文本,看似省时,实则埋下大量隐患。原始业务文档往往包含页眉页脚、水印、图片、表格、空白换行、广告冗余、格式乱码等无效内容,直接使用会导致知识库掺杂大量垃圾数据。
如果解析环节不做好清洗和结构化,后续分块、向量化、检索再优化都无济于事。RAG有一句工程铁律:垃圾数据进,垃圾答案出。解析的核心目标很明确:剔除无效冗余信息,保留纯有效文本、表格、标题层级、段落结构,还原文档原本的逻辑,为后续分块和检索提供高质量数据源。
2. 主流文档解析方案
业务场景中常见的文档格式分为文本类、版式类、富媒体类,不同格式适配不同解析方案,按需选择:
简单文本格式(TXT、Markdown):
- 这类文档无复杂格式、无乱码,解析难度最低。
- 直接读取全文,清洗多余空行、特殊符号即可,重点保留原有段落和标题层级,无需复杂处理。
办公格式(Word、Excel、PPT):
- Word文档需保留标题、段落、列表结构,剔除批注、修订记录;
- Excel重点解析表格结构化数据,避免表格文本碎片化;
- PPT需提取每页核心文本,忽略版式空白和配图注释。
- 推荐使用python-docx、python-pptx等轻量工具,适配常规业务场景。
版式文档(PDF):
- 这是RAG最常用、最难解析的格式。
- 普通可复制PDF,可用PyPDF2、pdfplumber解析,其中pdfplumber优势更强,能精准保留表格、段落排版,减少文本错乱;
- 扫描版PDF属于图片格式,普通解析工具无效,必须搭配OCR文字识别工具,先识别文本再清洗过滤。
3. 解析必备清洗规则
无论哪种文档格式,解析后都必须进行标准化清洗,这是保证数据质量的关键,核心规则分为四点:
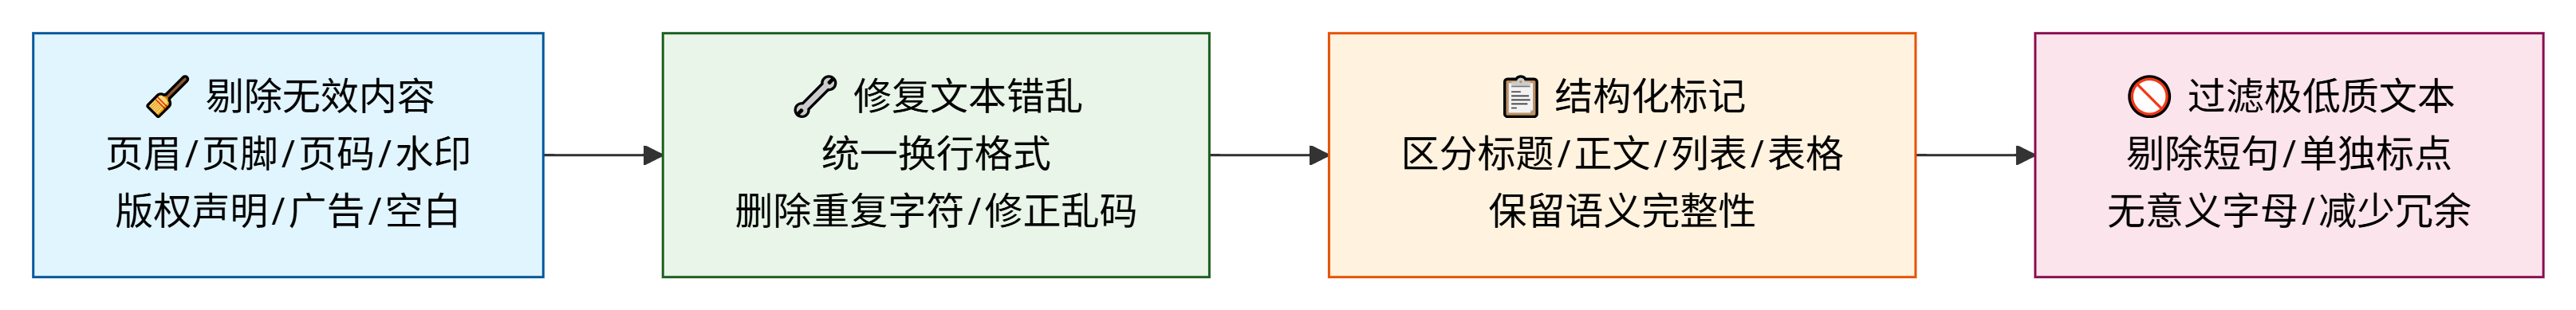
- 1. 剔除无效内容:批量删除页眉、页脚、页码、水印、版权声明、广告文案、空白段落,这类内容无业务价值,只会干扰检索。
- 2. 修复文本错乱:统一换行格式、删除重复字符、修正乱码,保证文本语句通顺、段落完整,避免出现句子截断、语义断裂的情况。
- 3. 结构化标记:区分标题、正文、列表、表格内容,做简易标记,后续分块时可依据结构切分,最大程度保留语义完整性。
- 4. 过滤极低质文本:剔除字数过少、无实际语义的短句,比如单独的标点、单个数字、无意义字母,减少知识库冗余数据。
通常RAG检索精度低,根源就是解析环节未做结构化清洗。做好这一步,能直接提升30%以上的召回精准度,是性价比最高的优化手段。
4. 文档解析实践示例
针对本章讲解的多格式文档解析、标准化清洗规则,提供适配PDF、TXT、Word的实战代码,包含无效内容剔除、文本修复、结构化过滤全流程,可直接用于项目落地。
# 文档解析与标准化清洗实战代码
import re
from pathlib import Path

# 通用文本清洗函数
def clean_document_text(text: str) -> str:
    # 1. 剔除页眉页脚、水印、版权等无效关键词
    invalid_words = ["页眉", "页脚", "页码", "版权所有", "水印", "广告", "免责声明"]
    for word in invalid_words:
        text = text.replace(word, "")
    # 2. 修复文本错乱,统一换行和空格
    text = re.sub(r'\n+', '\n', text)
    text = re.sub(r'\s+', ' ', text)
    # 3. 剔除过短无意义文本
    text_lines = [line.strip() for line in text.split("\n") if len(line.strip()) > 5]
    return "\n".join(text_lines)

# TXT文档解析
def parse_txt(file_path: str) -> str:
    with open(file_path, "r", encoding="utf-8") as f:
        raw_text = f.read()
    return clean_document_text(raw_text)

# PDF文档解析(可复制PDF)
def parse_pdf(file_path: str) -> str:
    import pdfplumber
    raw_text = ""
    with pdfplumber.open(file_path) as pdf:
        for page in pdf.pages:
            page_text = page.extract_text() or ""
            raw_text += page_text + "\n"
    return clean_document_text(raw_text)

# 批量解析文档入口
if __name__ == "__main__":
    txt_content = parse_txt("test.txt")
    pdf_content = parse_pdf("test.pdf")
    print("TXT解析清洗后内容:\n", txt_content[:500])
四、Chunk分块策略
1. 分块的核心逻辑
经过解析清洗后的文本,往往是上万字的长文档,绝对不能直接向量化存储。一方面,长文本语义混杂,包含多个主题,用户提问大概率只关联其中一小部分,全局向量化会导致语义模糊、检索不准;另一方面,向量模型有固定输入长度限制,超长文本无法正常编码,强行处理会丢失大量细节信息。
Chunk分块的本质,就是在语义完整的前提下,将长文本切割为尺寸适中、主题单一的文本小块。优质的分块策略,需要平衡两个核心指标:
- 块尺寸越小,检索精度越高,但上下文语义越容易断裂;
- 块尺寸越大,语义完整性越好,但冗余信息越多,检索精度下降。
没有万能的分块尺寸,只有适配场景的最优方案。
2. 主流Chunk策略详解
主流的分块策略分为基础固定分块、层级语义分块、智能语义分块,难度逐级提升,效果也逐级优化:
固定长度分块(基础入门):
- 这是最简单、最通用的分块方式,设定固定字符长度,比如500字符、800字符,同时设置重叠字数,一般50-100字符。
- 重叠的核心作用是避免段落交界处的语义被截断,保证相邻分块衔接完整。
这种方法优点是实现简单、适配所有文档、计算成本低;缺点是完全不关注文本结构,容易把完整语义的句子、段落强行切断,产生大量语义残缺的无效分块。仅适合新手入门、简单知识库、低精度要求的场景。
层级结构分块(进阶通用):
- 这是生产级项目最常用的方案,摒弃固定长度切割,优先依据文档自然结构分块。
- 遵循“先大后小”的拆分逻辑:优先按一级标题、二级标题拆分章节,章节过长则按段落拆分,段落过长则按句号、逗号拆分,层层递进。
这种策略完美贴合人类阅读逻辑,能最大程度保留单块文本的主题完整性,几乎不会切断完整语义,适配说明书、教程、技术文档、规章制度等结构化文档,性价比极高,绝大多数业务场景优先选择此方案。
智能语义分块(高阶精准):
- 目前最先进的分块方案,核心是借助Embedding模型,计算文本句子之间的语义相似度,将语义相近、主题统一的句子聚合为一个分块,自动避开语义边界。
简单来说,机器会自主判断“哪些句子是讲同一件事”,自动聚合分块,不依赖固定长度和文档结构。这种分块效果最优,能彻底解决语义断裂、主题混杂问题,但缺点是计算成本高、耗时更长,适合高精度问答、专业知识库、科研文献等高端场景。
3. 分块参数场景化调优
关于分块尺寸,常用的应用标准,根据实际情况直接套用即可:
- 通用问答场景:单块500-800字符,重叠80字符,兼顾精度与完整性;
- 精准细节查询(参数、规则、报错方案):单块300-500字符,小尺寸提升精准度;
- 长逻辑问答(流程、方案、原理讲解):单块800-1200字符,大尺寸保留完整逻辑;
- 同时所有场景必须开启分块重叠,避免关键信息被切割丢失,这是最容易忽略的细节。
4. Chunk策略实践示例
对应本章讲解的固定分块、层级分块、语义分块三大策略,提供完整可运行代码,包含场景化参数配置,可直接根据业务场景切换使用。
# Chunk分块三大策略完整实战代码
import re
from typing import List
from sentence_transformers import SentenceTransformer

# 1. 固定长度重叠分块(基础版)
def fixed_chunk(text: str, chunk_size: int = 600, overlap: int = 80) -> List[str]:
    chunks = []
    start = 0
    text_len = len(text)
    while start < text_len:
        end = min(start + chunk_size, text_len)
        chunk = text[start:end]
        chunks.append(chunk.strip())
        start = end - overlap
    return chunks

# 2. 层级结构分块(进阶生产版)
def hierarchy_chunk(text: str) -> List[str]:
    # 按标题、段落层级拆分
    title_pattern = re.compile(r'第.+[章节]|[\d]+\. ')
    raw_blocks = title_pattern.split(text)
    chunks = []
    for block in raw_blocks:
        if len(block.strip()) > 100:
            # 超长段落二次拆分
            if len(block) > 800:
                chunks.extend(fixed_chunk(block))
            else:
                chunks.append(block.strip())
    return chunks

# 3. 简易语义分块(高阶精准版)
model = SentenceTransformer('all-MiniLM-L6-v2')
def semantic_chunk(text: str, threshold: float = 0.75) -> List[str]:
    sentences = [s.strip() for s in re.split(r'[。!?]', text) if s.strip()]
    chunks = []
    temp_chunk = [sentences[0]]
    for sent in sentences[1:]:
        # 计算句子语义相似度
        vec1 = model.encode("".join(temp_chunk))
        vec2 = model.encode(sent)
        sim = float(vec1 @ vec2.T)
        if sim > threshold:
            temp_chunk.append(sent)
        else:
            chunks.append("".join(temp_chunk))
            temp_chunk = [sent]
    chunks.append("".join(temp_chunk))
    return chunks

# 场景化调用示例
if __name__ == "__main__":
    doc_text = "此处为清洗后的完整文档文本..."
    # 通用场景
    print(fixed_chunk(doc_text))
    # 结构化文档场景
    print(hierarchy_chunk(doc_text))
    # 高精度问答场景
    print(semantic_chunk(doc_text))
五、双路检索机制
1. 单一检索的致命缺陷
早期基础RAG大多只使用向量检索,如果仅做这一步没有后续优化,这也是效果差的核心原因。向量检索和传统关键词检索各有致命短板,单一检索完全无法适配复杂业务场景。
向量检索擅长语义模糊匹配,用户换一种说法提问、口语化提问,都能匹配到相关内容,但对精准关键词、专属编号、专业术语、稀有名词极度不敏感。比如用户搜索“TS-999故障码解决方案”,向量检索可能召回大量普通故障排查内容,却错过唯一包含该故障码的精准文档。
而传统关键词检索刚好相反,精准匹配能力极强,但完全不懂语义,用户轻微改写句式、替换近义词,就会检索失效,召回结果为零。因此,生产级RAG必须采用向量稠密检索+BM25稀疏检索的双路检索架构,取长补短。
2. 向量检索核心原理
向量检索的核心逻辑可以通俗拆解为三步:
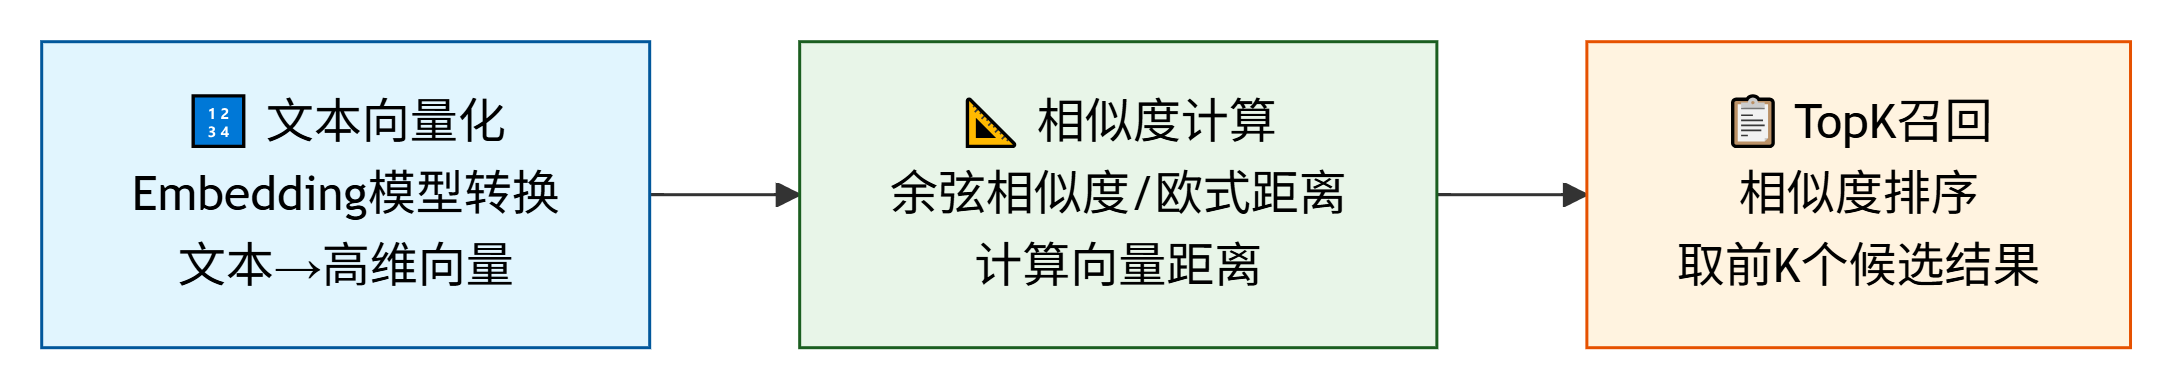
- 1. 文本向量化:通过Embedding模型,将每一个文本Chunk、用户的提问Query,转化为高维数字向量,文字语义被转化为向量空间的坐标;
- 2. 相似度计算:语义越相近的文本,在向量空间中的距离越近,通过余弦相似度、欧式距离等算法,计算Query与所有Chunk的相似度分数;
- 3. TopK召回:按照相似度分数从高到低排序,取出前K个最相关的文本块,作为检索候选结果。
向量检索的核心优势是语义泛化能力强,适配日常问答、模糊查询、语义理解类场景,是RAG的基础检索能力。
3. BM25关键词检索原理
BM25是目前最主流的稀疏关键词检索算法,Elasticsearch、Lucene等搜索引擎默认排序算法都是BM25,它是对传统TF-IDF算法的优化升级,解决了旧算法的缺陷。
其核心逻辑可以通俗理解为:根据查询词在文本中的匹配情况、出现频率、文档长度、词汇稀有度,计算文本相关性分数。核心优势有两点:
- 1. 精准匹配专有名词、编号、术语,不漏关键信息;
- 2. 抑制高频无效词汇,避免“的、地、得”等通用词汇干扰检索结果。
BM25完美弥补向量检索的精准匹配短板,适合查询规则、参数、故障码、专业术语、合同条款等对精准度要求极高的场景。
4. 向量检索+BM25检索示例
核心是双路检索互补,下面提供完整可运行的双路检索代码,包含向量相似度计算、BM25关键词检索实现,是混合检索的前置核心代码。
# 向量检索 + BM25双路检索实战代码
import numpy as np
from rank_bm25 import BM25Okapi
from sentence_transformers import SentenceTransformer

# 初始化模型
embedding_model = SentenceTransformer('all-MiniLM-L6-v2')

# 1. 向量检索实现
def vector_search(query: str, chunk_list: List[str], top_k: int = 10) -> List[tuple]:
    query_vec = embedding_model.encode(query)
    chunk_vecs = embedding_model.encode(chunk_list)
    # 余弦相似度计算
    sim_scores = np.dot(chunk_vecs, query_vec) / (np.linalg.norm(chunk_vecs, axis=1) * np.linalg.norm(query_vec))
    # 排序取TopK
    rank_results = sorted(zip(chunk_list, sim_scores), key=lambda x: x[1], reverse=True)
    return rank_results[:top_k]

# 2. BM25关键词检索实现
def bm25_search(query: str, chunk_list: List[str], top_k: int = 10) -> List[tuple]:
    # 文本分词(简易分词,中文场景可替换jieba分词)
    tokenized_chunks = [list(chunk) for chunk in chunk_list]
    bm25 = BM25Okapi(tokenized_chunks)
    tokenized_query = list(query)
    scores = bm25.get_scores(tokenized_query)
    rank_results = sorted(zip(chunk_list, scores), key=lambda x: x[1], reverse=True)
    return rank_results[:top_k]

# 双路检索调用
if __name__ == "__main__":
    chunks = ["业务故障码TS-999排查方案...", "系统通用故障解决流程...", "参数配置规范说明..."]
    user_query = "TS-999故障怎么解决"
    vec_res = vector_search(user_query, chunks)
    bm25_res = bm25_search(user_query, chunks)
    print("向量检索结果:", vec_res)
    print("BM25检索结果:", bm25_res)
六、多路检索融合
1. 混合检索的核心价值
双路检索完成后,我们会得到两组独立的召回结果:向量检索的语义相关结果、BM25的精准匹配结果。这两组结果各有优劣、互不重叠,如果直接单独使用,依然会丢失部分有效信息,因此必须进行多路召回融合,也就是混合检索。
混合检索的核心目标,是整合稠密向量检索与稀疏BM25检索的优势,既保留语义泛化能力,又守住精准匹配能力,实现“语义不丢、精准不漏”,大幅提升召回全面性,从根源解决RAG漏召、错召问题。
2. 主流融合算法落地
最常用、效果最稳定的融合方式是RRF倒数排序融合,全程无需复杂调参、无需人工加权,原理通俗易懂:
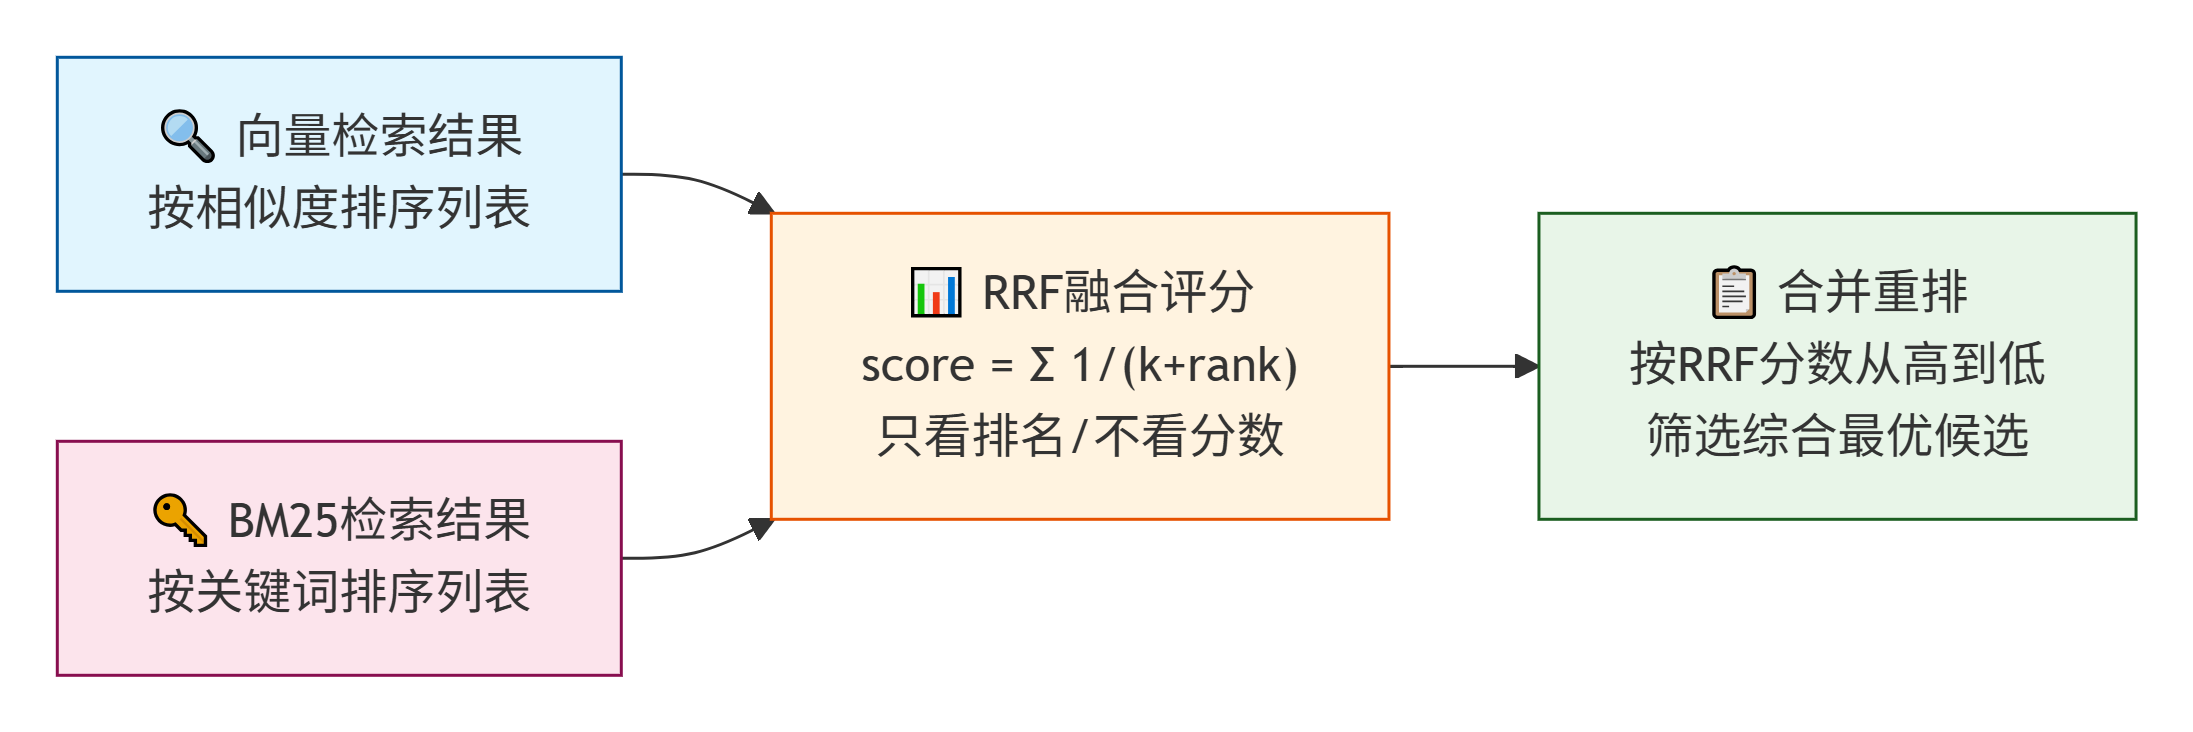
- RRF算法不关注原始检索的相似度分数,只关注每条结果在各自检索列表中的排名。
- 排名越靠前,权重分数越高。
- 系统会分别给向量检索、BM25检索的结果计算RRF分数,合并排序后,筛选出综合最优的候选结果。
这种融合方式的最大优势是兼容适配性强,不会因为某一路检索分数虚高,淹没另一路的优质结果。比如向量检索排名靠后的精准关键文档,不会被语义相似的普通文档覆盖,完美实现双路优势互补。
3. 融合策略场景适配
除了通用RRF融合,不同场景可微调融合策略,实现最优效果:
- 专业精准场景(参数、术语、编号查询):略微提升BM25检索权重,优先保障精准匹配,避免关键信息丢失;
- 通用语义场景(常识、方案、原理问答):略微提升向量检索权重,优先保障语义匹配,适配口语化、模糊化提问;
- 通用综合场景:采用默认RRF均等融合,兼顾语义与精准,适配绝大多数业务需求。
4. RRF多路融合算法示例
针对本章核心的多路召回融合,提供标准RRF排序融合代码,支持权重微调,适配不同业务场景,可直接对接上方双路检索结果。
# RRF倒数排序融合 实战代码
def rrf_fusion(vec_results: list, bm25_results: list, k: int = 60) -> list:
    """
    :param vec_results: 向量检索结果(有序列表)
    :param bm25_results: BM25检索结果(有序列表)
    :param k: RRF平滑系数,默认60
    :return: 融合后排序结果
    """
    score_dict = {}
    # 累加向量检索排名分数
    for idx, (chunk, _) in enumerate(vec_results):
        score_dict[chunk] = score_dict.get(chunk, 0) + 1 / (idx + 1 + k)
    # 累加BM25检索排名分数
    for idx, (chunk, _) in enumerate(bm25_results):
        score_dict[chunk] = score_dict.get(chunk, 0) + 1 / (idx + 1 + k)
    # 综合排序
    sorted_res = sorted(score_dict.items(), key=lambda x: x[1], reverse=True)
    return sorted_res

# 场景化权重微调封装
def scene_fusion(vec_res, bm25_res, scene_type="common"):
    if scene_type == "precision":
        # 精准场景:加重BM25权重
        fusion_res = rrf_fusion([], bm25_res) + rrf_fusion(vec_res, [])
    elif scene_type == "semantic":
        # 语义场景:加重向量权重
        fusion_res = rrf_fusion(vec_res, []) + rrf_fusion([], bm25_res)
    else:
        # 通用场景:均等融合
        fusion_res = rrf_fusion(vec_res, bm25_res)
    return fusion_res

# 调用示例
if __name__ == "__main__":
    # 承接上一章双路检索结果
    vec_res = [("语义匹配文本1", 0.89), ("普通文本2", 0.76)]
    bm25_res = [("精准关键词文本3", 25.6), ("普通文本2", 18.2)]
    final_res = scene_fusion(vec_res, bm25_res)
    print("RRF融合最终结果:", final_res)
七、检索重排序优化
1. 重排序的必要性
经过混合检索融合后,我们已经得到了一批相关性较高的候选文本,但依然存在瑕疵。粗召回阶段为了保证召回率,会放宽筛选条件,最终的候选集中,依然掺杂少量相关性一般、匹配度弱的内容,且结果排序不够精准。
如果直接将这批结果输入大模型,不仅会增加模型的计算负担,冗余信息还会干扰模型判断,导致回答不够精准、简洁。此时就需要Reranker重排序模型,对粗召回结果做精细化二次筛选排序。
简单来说,粗召回是“广撒网、多捞鱼”,保证不丢有效信息;重排序是“精挑细选、择优录取”,筛选出最贴合用户问题的优质内容,是RAG效果跃升的关键一步。
2. Reranker核心原理
重排序模型和Embedding向量模型的工作逻辑完全不同:
- Embedding向量模型是单向编码,分别对Query和文本Chunk单独编码,再计算相似度,无法深度理解Query和文本的交互关系;
- Reranker重排序模型是双向交互编码,会将用户Query和候选文本拼接为整体,联合输入模型,通过完整的注意力机制,深度判断二者的真实匹配相关性,输出精准的相关性分数。
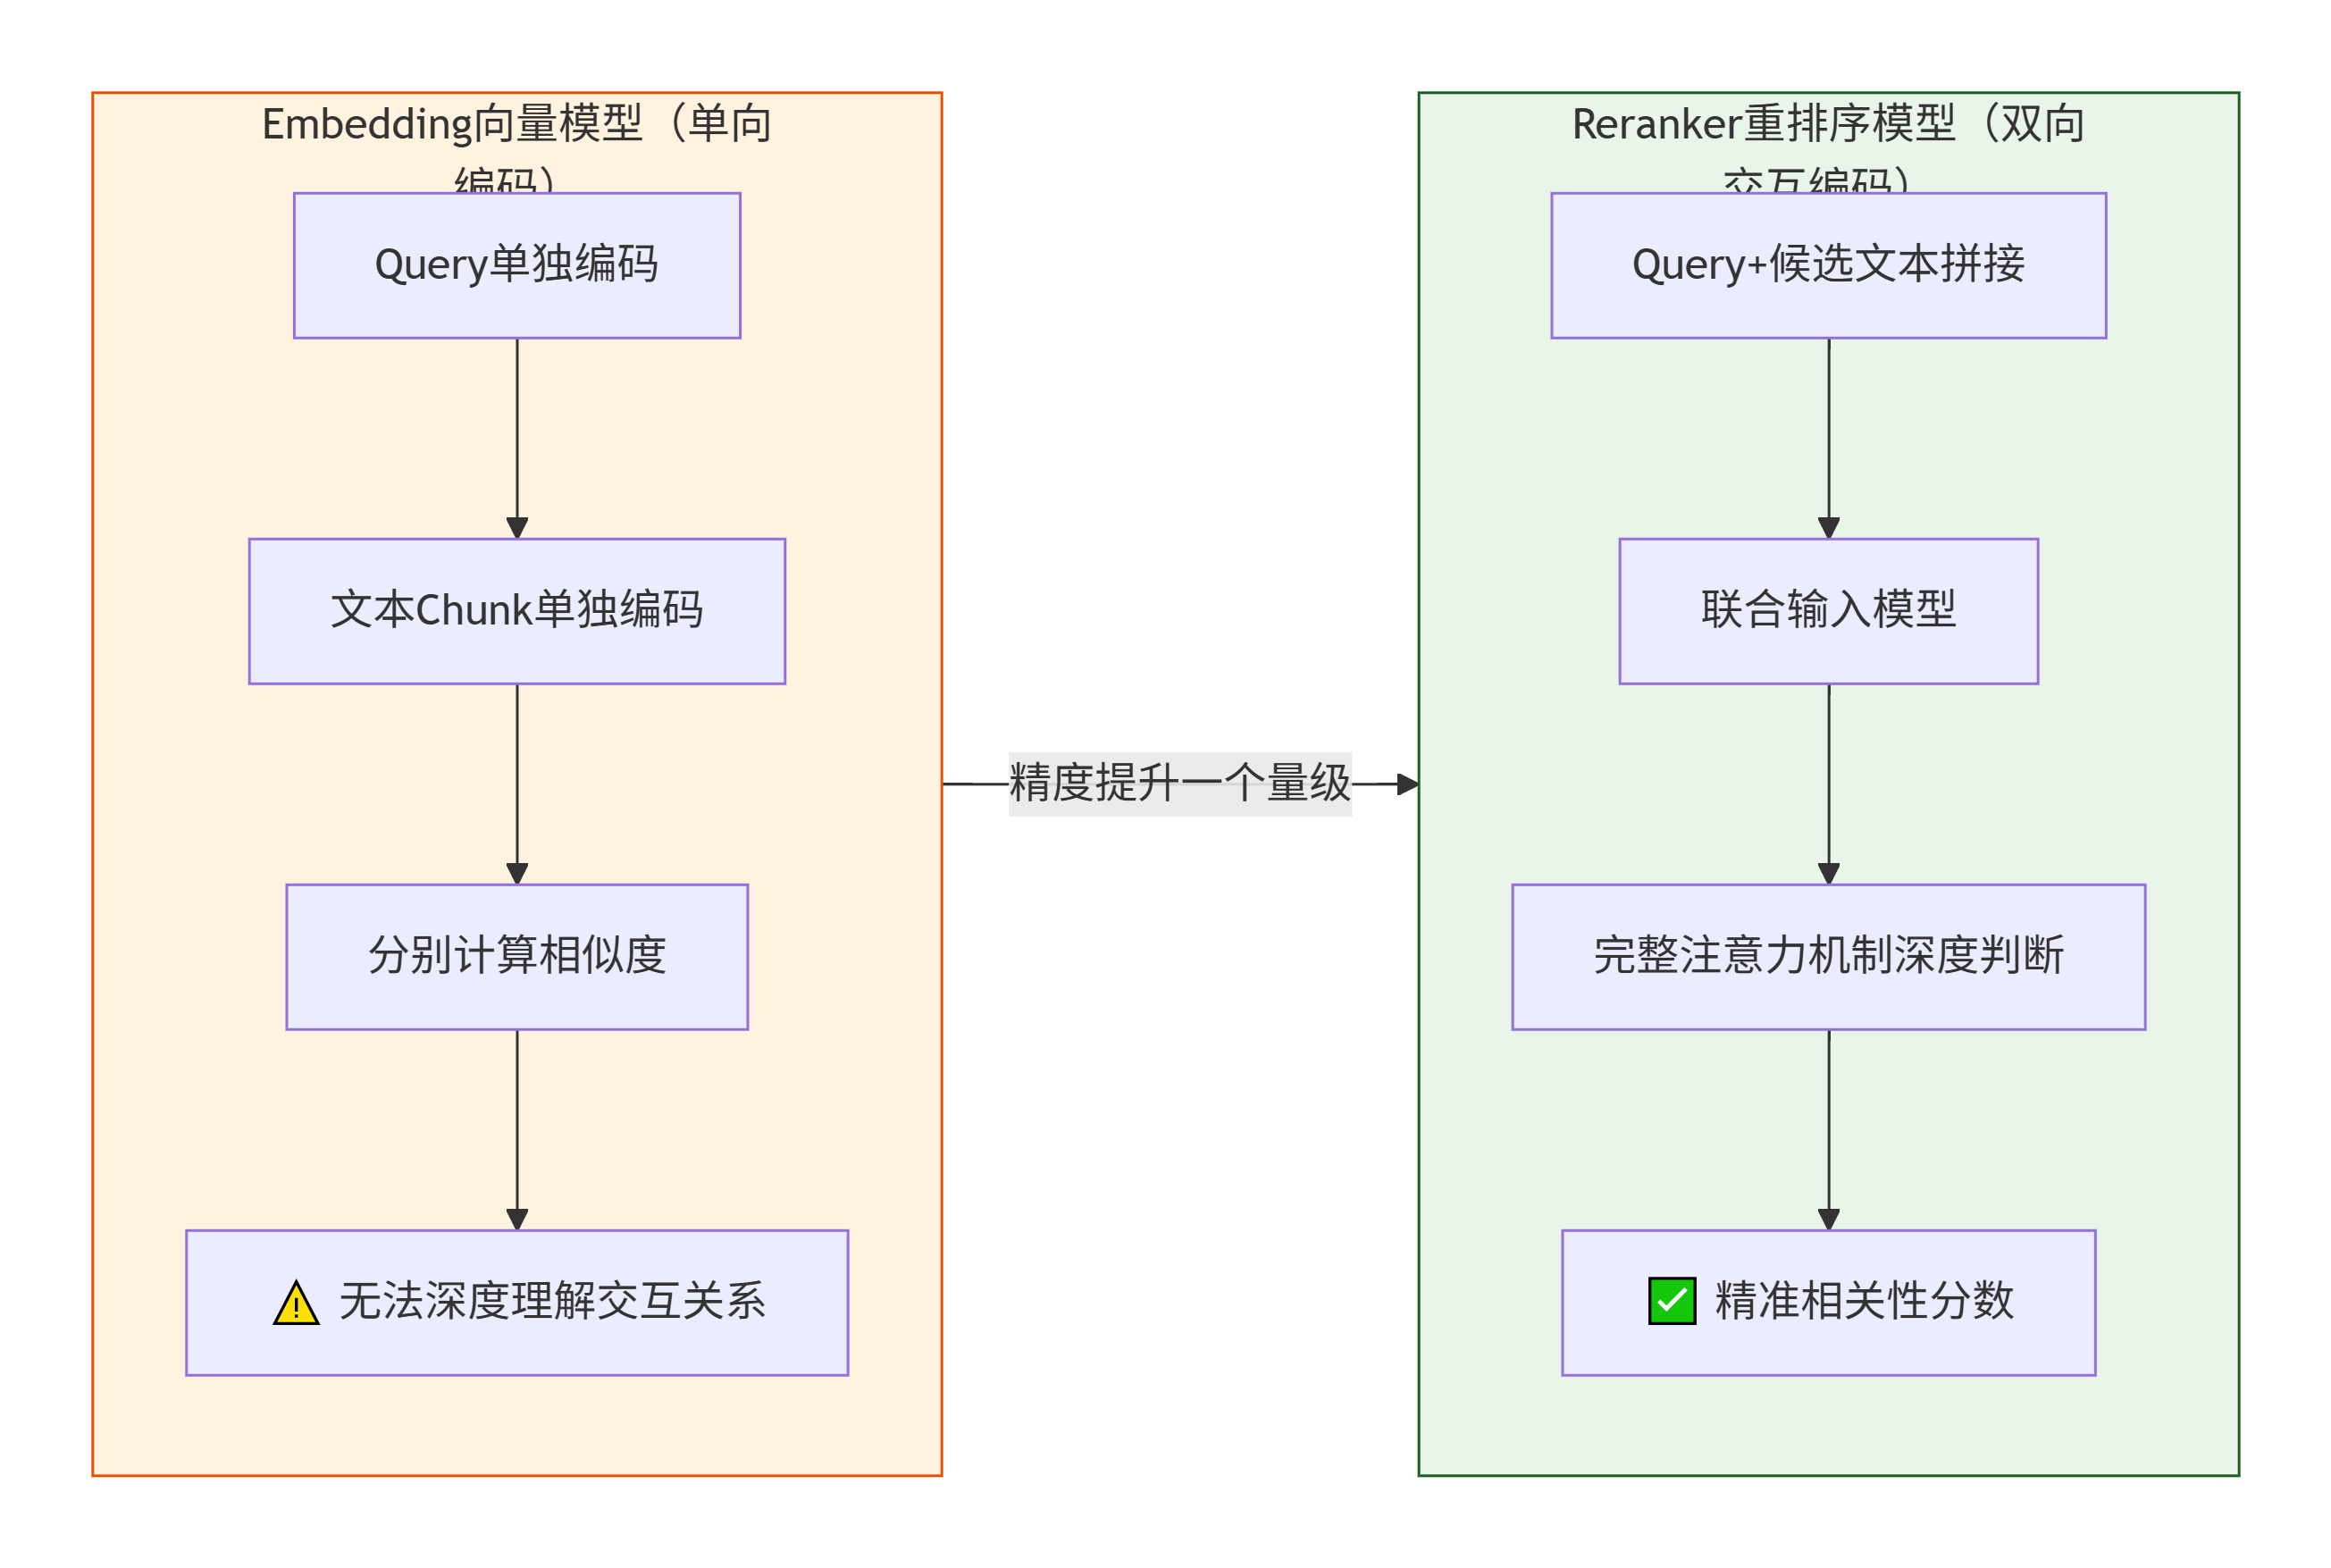
简单对比:向量检索是“凭印象打分”,重排序是“逐字逐句核对细节打分”,精度提升一个量级。虽然重排序速度比向量检索慢一点,但精度提升效果极其显著,是生产级RAG的必备环节。
3. 重排序落地实践
为了兼顾效果与性能,落地时遵循“粗召多、精排少”的核心原则:
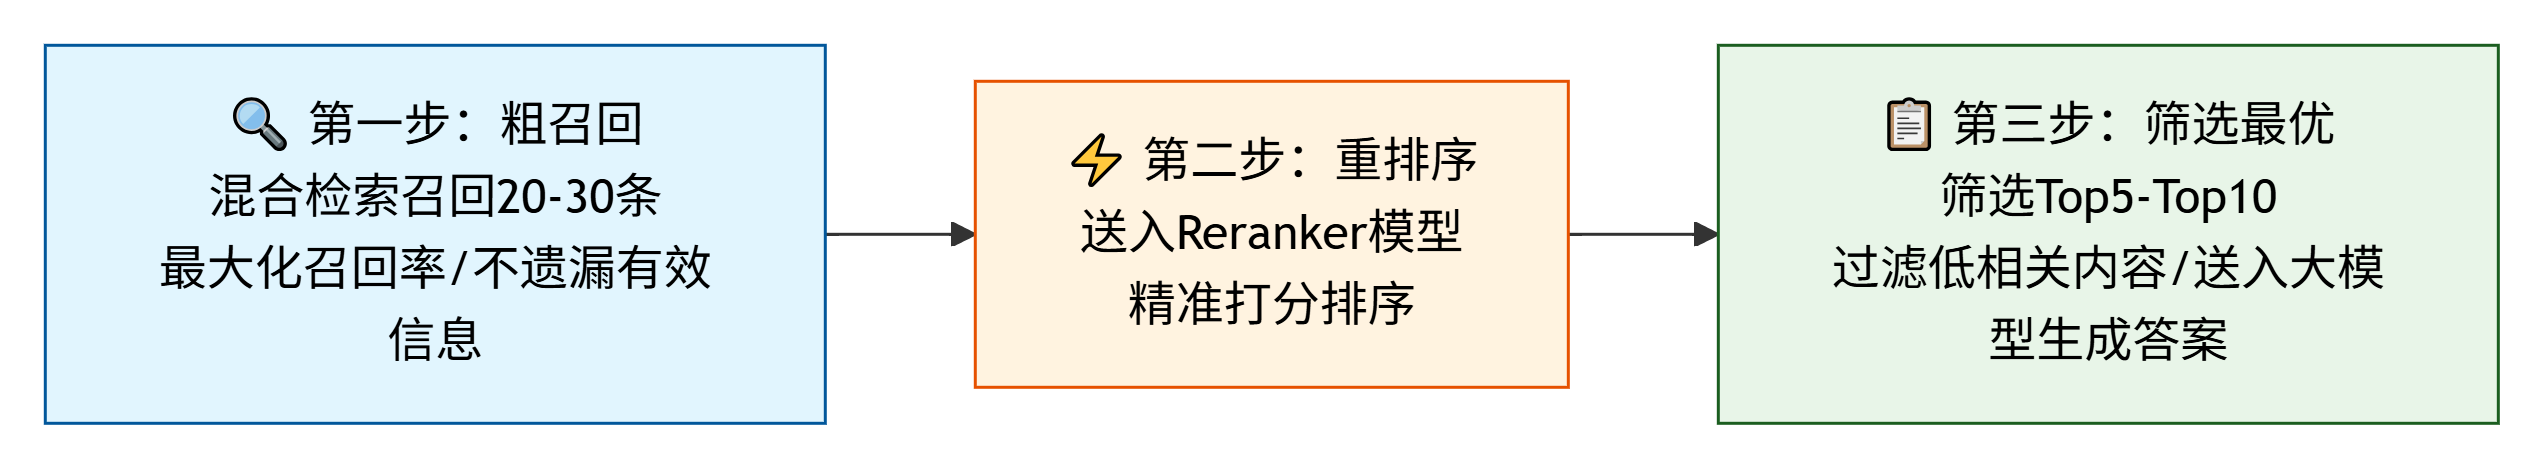
- 第一步,粗召回阶段,通过混合检索召回20-30条候选文本,最大化保证召回率,不遗漏任何有效信息;
- 第二步,重排序阶段,将20-30条候选文本送入Reranker模型,精准打分排序;
- 第三步,筛选Top5-Top10最优结果,过滤低相关内容,输入大模型生成答案。
这套流程能完美平衡召回率与精准度,是目前最优落地范式。
4. Reranker重排序示例
结合重排序原理与落地规范,提供轻量Reranker重排代码,实现“粗召多、精排少”的完整流程,无缝对接融合检索结果。
# Reranker重排序实战代码
from transformers import AutoTokenizer, AutoModelForSequenceClassification
import torch

# 加载轻量开源重排序模型
rerank_model_path = "cross-encoder/ms-marco-MiniLM-L-6-v2"
tokenizer = AutoTokenizer.from_pretrained(rerank_model_path)
rerank_model = AutoModelForSequenceClassification.from_pretrained(rerank_model_path)
rerank_model.eval()

def rerank(query: str, candidate_chunks: list, top_n: int = 8) -> list:
    """
    对融合后的候选文本进行精准重排序
    :param query: 用户提问
    :param candidate_chunks: 多路融合后的候选文本列表
    :param top_n: 重排序后保留最优条数
    :return: 排序后的优质文本
    """
    score_list = []
    with torch.no_grad():
        for chunk in candidate_chunks:
            # 双向交互编码,拼接query和文本
            inputs = tokenizer(query, chunk, return_tensors="pt", truncation=True, max_length=512)
            score = rerank_model(**inputs).logits[0][0].item()
            score_list.append((chunk, score))
    # 按相关性分数倒序排序
    sorted_res = sorted(score_list, key=lambda x: x[1], reverse=True)
    return [item[0] for item in sorted_res[:top_n]]

# 完整链路调用示例
if __name__ == "__main__":
    # 多路融合后的粗召回结果(20条)
    candidate_texts = ["候选文本1", "候选文本2", "候选文本3"]
    user_query = "TS-999故障详细排查步骤"
    # 重排序筛选Top8最优内容
    final_chunks = rerank(user_query, candidate_texts)
    print("重排序后最优检索内容:", final_chunks)
八、检索方案适配
1. 通用问答场景方案
- 适用于企业知识库、产品手册、科普问答、日常咨询等通用场景,用户提问口语化、问题宽泛、无固定专业术语。
- 整体链路设计:标准文档结构化解析+500-800字符层级分块+向量为主、BM25为辅的双路检索+RRF融合+轻量重排序。
- 该方案兼顾速度与效果,适配绝大多数轻量化RAG项目。
2. 精准查询场景方案
- 适用于参数查询、故障码排查、合同条款检索、规章制度核对等高精度场景,对关键词、专有名词匹配要求极高。
- 整体链路设计:精细化文档清洗+300-500字符小尺寸分块+BM25优先、向量为辅的双路检索+加权RRF融合+高精度重排序;
- 最大程度保证精准匹配,杜绝关键信息遗漏。
3. 长逻辑推理场景方案
- 适用于流程讲解、方案解读、原理分析、案例复盘等需要完整上下文的场景,需要保证文本逻辑连贯。
- 整体链路设计:结构优先解析+800-1200字符大尺寸分块+均等双路检索+标准RRF融合+重排序;
- 保留完整语义逻辑,支撑大模型深度推理生成。
4. RAG应用整合示例
示例实现场景化RAG完整流水线:按通用问答、精准查询、长逻辑推理三种场景,分别配置不同的分块策略(固定/层级)、融合权重及重排参数,统一串联清洗→分块→混合检索→场景融合→重排五大环节,适配多业务场景。
# 场景化RAG完整流水线整合代码
from typing import List

class SceneRAGPipeline:
    def __init__(self):
        self.model = SentenceTransformer('all-MiniLM-L6-v2')

    # 通用问答场景流水线
    def common_qa_pipeline(self, raw_text: str, query: str) -> List[str]:
        text = clean_document_text(raw_text)
        chunks = fixed_chunk(text, chunk_size=700, overlap=80)
        vec_res = vector_search(query, chunks, top_k=20)
        bm25_res = bm25_search(query, chunks, top_k=20)
        fuse_res = scene_fusion(vec_res, bm25_res, scene_type="common")
        return rerank(query, [i[0] for i in fuse_res])

    # 精准查询场景流水线
    def precision_qa_pipeline(self, raw_text: str, query: str) -> List[str]:
        text = clean_document_text(raw_text)
        chunks = fixed_chunk(text, chunk_size=400, overlap=50)
        vec_res = vector_search(query, chunks, top_k=20)
        bm25_res = bm25_search(query, chunks, top_k=20)
        fuse_res = scene_fusion(vec_res, bm25_res, scene_type="precision")
        return rerank(query, [i[0] for i in fuse_res])

    # 长逻辑推理场景流水线
    def logic_qa_pipeline(self, raw_text: str, query: str) -> List[str]:
        text = clean_document_text(raw_text)
        chunks = hierarchy_chunk(text)
        vec_res = vector_search(query, chunks, top_k=20)
        bm25_res = bm25_search(query, chunks, top_k=20)
        fuse_res = scene_fusion(vec_res, bm25_res, scene_type="common")
        return rerank(query, [i[0] for i in fuse_res])

# 场景化调用
if __name__ == "__main__":
    rag_pipe = SceneRAGPipeline()
    doc = "业务完整知识库文档内容..."
    # 根据业务场景切换流水线
    res = rag_pipe.common_qa_pipeline(doc, "产品使用常见问题")
    print("最终检索结果:", res)
九、结尾
总的来说,RAG不是简单的“文档向量化+检索”,而是一套层层递进、环环相扣的精细化工程体系。从最基础的文档解析、文本分块,到核心的双路检索、混合融合,再到最后的重排序优化,每一个环节都决定着最终的问答效果。随着了解的深入,也会逐步跳出模型至上的误区,明白检索链路才是RAG的核心竞争力。
单一向量检索的局限性注定无法适配复杂业务,只有向量语义检索与BM25精准检索互补,通过多路融合补齐短板,再用重排序完成精准提纯,才能搭建出生产级、高可用的RAG系统。最优设计永远贴合业务场景。通用场景兼顾效率,精准场景侧重匹配,推理场景侧重完整逻辑。根据场景灵活调整分块策略、检索权重、融合方式、重排参数,就能彻底解决RAG幻觉、召回不准、答案空洞等常见问题,真正实现大模型落地赋能。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号