大模型核心原理深度分析:从Token转换到概率输出,完整理解Transformer运行机制22.5
原创
大模型核心原理深度分析:从Token转换到概率输出,完整理解Transformer运行机制22.5
原创
未闻花名
发布于 2026-09-14 12:18:43
发布于 2026-09-14 12:18:43
一、前言
很多人接触大模型、AI生成文本时,都有一个共同困惑:AI到底是怎么读懂人类文字,又精准输出通顺内容的?我们日常对话、文案生成、代码编写、问答交互,所有大模型能力的底层核心,全部来源于Transformer架构。Transformer的核心逻辑非常规整,是一套固定的文本处理流水线:原始文本→Token拆分→向量转换→位置赋值→语义深度解析→权重计算→概率输出。
今天我们从零开始、由浅入深,逐环节拆解Transformer七大核心模块,讲透每个步骤的原理、作用和工作逻辑。搞懂大模型“读懂文字、生成内容”的完整底层逻辑,建立完整的Transformer技术认知。
二、整体架构总览
想要学好Transformer,第一步不要纠结细节,先搭建全局认知。Transformer并非复杂的黑盒算法,而是一套标准化、模块化的AI文本处理架构,也是目前所有大语言模型、多模态模型的基础骨架。在Transformer问世后,彻底取代了传统RNN、LSTM序列模型,成为NLP领域的核心。
Transformer学习极易陷入误区,多数人会出现两类问题:
- 重细节轻整体:过早钻研注意力机制、层归一化、残差连接等细碎知识点,忽略整体运行流程,导致知识点碎片化,无法串联成完整体系。
- 重公式轻逻辑:过度纠结数学公式推导,忽视模块的设计目的与核心作用,只会公式计算、不懂原理落地与实际价值。
可以将Transformer通俗理解为一套AI文本加工工厂,七大核心步骤对应七条环环相扣的流水线,按顺序迭代执行,最终实现文本语义理解与全新内容生成的完整能力。
1. 架构核心组成模块
Transformer整体架构逻辑清晰、分层明确,所有大模型的迭代升级,本质都是对这套基础架构的优化与扩容。三大核心功能模块分工清晰,完整覆盖文本处理全流程:
输入预处理模块:
- 包含Tokenization分词、Embedding向量转换、Positional Encoding位置编码三大前置步骤。
- 核心作用是将人类可读的自然语言,转换为AI可计算的数字矩阵;
- 同时补充文本序列信息,是模型所有运算的基础前提。
核心编码解码模块:
- 由Encoder编码器、Decoder解码器堆叠而成,是Transformer的核心算力与语义处理层。
- Encoder负责理解输入文本语义,挖掘字词关联与上下文逻辑;
- Decoder负责生成全新文本内容,逐字输出合规通顺的文本序列。
输出映射模块:
- 包含Linear线性层、Softmax激活层。
- 核心作用是将模型解析后的深层语义特征,转化为词表对应的预测概率,筛选最优Token完成文本输出。
2. 完整运行全流程
Transformer采用单向递进的流水线运行逻辑,无跳跃、无回溯,七大步骤层层衔接、缺一不可,完整流程如下:

- 第一步:文本分词:原始文本输入,通过Tokenization拆分为模型可识别的最小计算单元Token,完成自然语言到模型语言的转换。
- 第二步:向量转换:通过Embedding将离散的Token数字编号,转换为连续高维语义向量,为每个Token赋予专属语义特征。
- 第三步:位置补全:通过Positional Encoding为语义向量注入序列位置信息,解决并行计算带来的语序缺失问题。
- 第四步:语义编码:多层Encoder堆叠运算,深度挖掘文本上下文关联、语法逻辑与全局语义特征。
- 第五步:文本解码:Decoder依托编码特征与已生成序列,逐字预测、迭代生成全新文本内容。
- 第六步:权重映射:Linear层将深层语义特征映射为完整词表的Token预测权重分布。
- 第七步:概率输出:Softmax将无序权重转换为标准概率分布,筛选最优Token完成最终文本输出。
3. 架构核心优势
相较于传统RNN、LSTM序列模型,Transformer实现了颠覆性架构升级,两大核心优势成为大模型高速发展的核心支撑:
支持并行计算,训练推理效率大幅提升:
- 传统序列模型必须逐字串行计算,前序字符运算完成后才能处理后序内容,无法并行,训练速度慢、算力成本高。
- Transformer可一次性加载整段文本,对所有Token同步并行计算,极大提升模型训练与推理效率。
全局语义捕捉,长文本理解精度更高:
- 传统模型仅能捕捉局部相邻字词关联,长文本语境下极易丢失远距离语义信息。
- Transformer依托注意力机制,可直接建立全文所有字词的关联关系,精准捕捉长文本上下文逻辑,语义理解能力实现质的提升。
整体而言,Transformer架构是一套“文本数字化→信息补全→语义深加工→概率输出”的完整AI智能流水线,所有高阶模型功能,均是这套基础架构的细化与迭代。总的来说,Transformer是一套从“文本语义理解”到“智能文本生成”的全自动AI处理流水线。
三、Tokenization文本分词
Tokenization分词是大模型文本处理的入口核心步骤。人类自然语言无法被AI直接识别与计算,所有中文、英文、符号文本,都必须通过Tokenization完成拆分与映射,转换为模型专属的标准化Token单元后,才能开展后续运算与语义解析。
1. Token核心定义
Token是大模型处理文本的最小计算单元,模型的语义学习、特征提取、文本生成等所有运算逻辑,均基于Token完成,与人类以字、词为阅读单位的逻辑完全不同。
为清晰区分文本处理核心载体,明确三类基础概念:
- 自然文本:人类读写的原始文字,是语言表达载体,无法被模型直接计算。
- Token单元:模型拆分生成的标准化最小单元,是AI识别文本的专属载体。
- Token ID:每个Token对应的专属数字编号,是模型运算的核心数字载体。
三者可通俗类比:自然文本是原始原材料,Token是标准化加工零件,Token ID是零件唯一编号,模型所有运算本质都是对Token ID的数值计算。
2. Tokenization拆分逻辑
主流大模型统一采用子词分词算法,兼顾运算效率与语义精度,规避整词分词词表爆炸、单字分词语义割裂的问题,不同语言的拆分规则标准化、差异化适配:
- 英文拆分规则:以词根、词缀、高频完整单词为核心拆分依据,高频常用单词直接作为独立Token,低频长单词、复杂词汇拆分为多个子词组合,既压缩词表规模,又能适配陌生词汇识别。
- 中文拆分规则:中文无天然空格分隔,模型以单字、高频双字词、固定成语为核心拆分单元,日常短句以单字拆分为主,高频固定词汇整体保留,平衡计算效率与语义完整性。
- 特殊符号处理:文本中的标点、空格、数字、emoji表情等特殊内容,均会拆分为独立专属Token,确保文本原始信息无丢失、无遗漏。
3. Tokenization核心作用
子词分词机制是大模型底层架构的关键设计,摒弃传统整词拆分模式,核心价值体现在三个维度,是模型正常运算的必备基础:
统一计算标准,压缩词表规模:
- 自然语言组合方式无穷无尽,若以完整词语为计算单元,会导致词表体量无限膨胀,模型无法存储与运算。
- 子词拆分可通过有限的标准化Token,组合生成无限的文本内容,大幅压缩词表规模,统一模型计算标准。
兼容陌生词汇,提升模型泛化能力:
- 真实应用场景中存在大量新词、专业术语、网络词汇与生僻内容,固定整词词表无法识别未知文本。
- 子词拆分可通过基础Token自由拼接组合,精准适配各类陌生词汇,有效提升模型的场景泛化能力。
适配模型输入规则,完成格式转换:
- Transformer模型仅支持固定维度的数字序列输入,原始自然语言无法直接参与运算。
- Tokenization完成文本拆分与数字ID映射,是人机数据格式转换的必经步骤,为后续向量运算、语义解析提供基础支撑。
4. Token拆分要点
Token拆分存在固定特性,直接影响模型运算精度与文本处理效果:
- Token与文本字数不对等:Token数量不与文字数量一一对应,英文1个单词通常对应1-3个Token,中文约1.5个汉字对应1个Token,标点、数字、表情符号均会独立占用Token资源。
- 拆分精度决定语义效果:分词精度是模型语义理解的基础,拆分过细会割裂完整语义单元,拆分过粗会导致词表冗余、运算效率降低,分词算法的持续优化是模型迭代的重要方向。
总而言之,Tokenization是大模型的文本转换核心,将多元化的人类自然语言,统一拆解为模型可计算的标准化基础单元,是所有AI文本能力的底层基石。Tokenization的本质,是把五花八门的人类语言,统一拆成模型能计算的最小零件。
四、Embedding词向量转换
Tokenization完成文本拆分后,文本仅被转换为无语义的Token数字编号,这类纯序号不包含任何文字含义与关联关系,模型无法据此理解文本内容。想要实现语义解析,必须通过Embedding词嵌入完成数值升级,将离散数字转化为携带语义特征的可计算向量。
Embedding是大模型语义存储与解析的核心载体,核心作用是为每个Token匹配专属高维向量,让抽象文字转化为可对比、可运算的数字特征,赋予文本真实语义属性。
1. 向量通俗理解
向量是文字语义的数字化载体,由一组有序数字组合而成,其维度与特征直接决定语义表达精度:
维度作用:
- 向量维度越高,可存储、刻画的文字语义特征越精细,语义区分能力越强。
- 主流大模型普遍采用512维、1024维等高维向量,可精准区分海量文字的细微语义差异。
语义关联逻辑:
- 向量数值直接对应文字特征,语义相近的文字,向量数值高度重合;
- 语义对立、无关的文字,向量数值差异显著。
- 例如“夏天”向量自带高温、光照等特征,“冬天”向量自带低温、降雪等特征,模型可通过向量差值精准区分语义。
2. Embedding工作原理
Embedding层本质是可迭代训练的参数矩阵,是模型训练过程中的核心参数之一,整体工作流程分为初始化、训练、推理三个固定阶段:
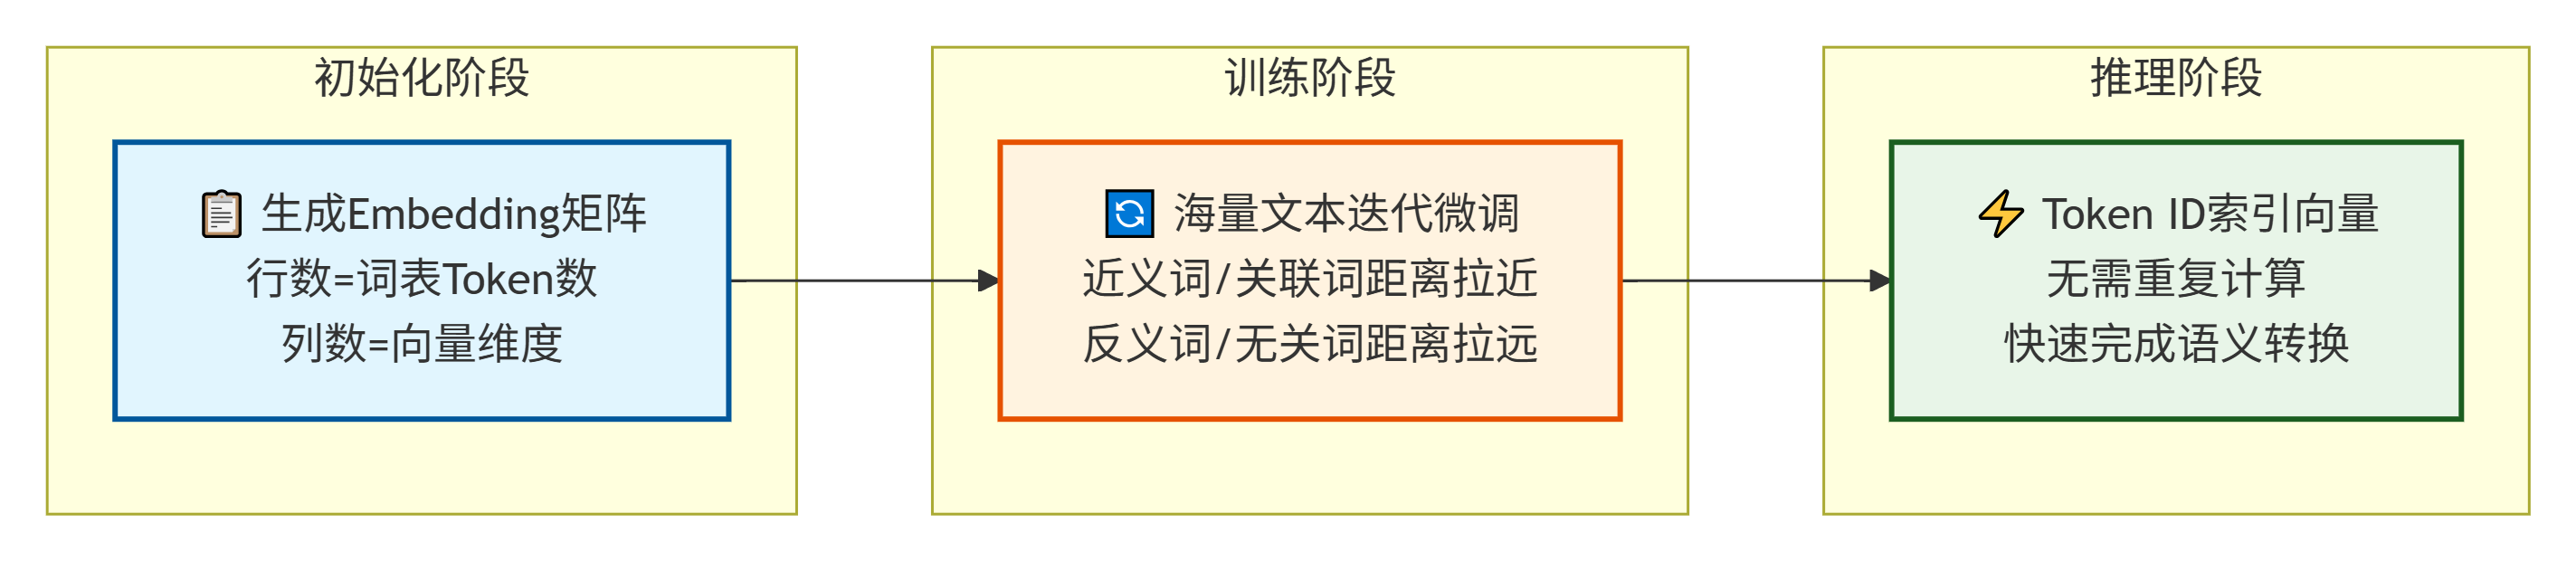
- 模型初始化阶段:系统生成固定尺寸的Embedding矩阵,矩阵行数对应词表全部Token数量,列数对应向量维度,每个Token ID唯一匹配矩阵中的一行参数,即专属语义向量。
- 模型训练阶段:依托海量真实文本数据,持续迭代微调向量参数。不断拉近近义词、关联词的向量距离,拉远反义词、无关词的向量距离,让向量特征持续贴合真实语义逻辑。
- 模型推理阶段:模型落地使用时,无需重复计算向量,直接通过Token ID索引对应专属向量,快速完成数字到语义向量的转换,保障推理效率。
Embedding向量并非静态固定数据,会随模型训练持续优化迭代,模型规格直接决定向量表达能力:
- 模型规格差异化:小模型向量维度低、参数量少,语义表达能力有限,易出现语义理解偏差;大模型高维向量参数丰富,可捕捉文字细微语义差异,理解精度与泛化能力更强。
- 全局底层支撑作用:模型后续的注意力计算、上下文语义解析、特征提取、编解码运算等所有核心逻辑,均基于Embedding向量开展,向量质量直接决定模型文本理解的基础精度。
3. Embedding核心价值
若无Embedding层,模型仅能机械识别数字编号,无法理解文本语义,该模块是AI读懂自然语言的核心前提,核心价值分为三点:
- 赋予Token真实语义属性:将无意义的离散数字编号,转化为携带丰富语义特征的连续向量,让文本具备可计算、可解析、可对比的数字属性,实现自然语言的智能化运算。
- 支撑全局语义关联计算:依托向量相似度匹配机制,模型可自动识别近义词、反义词、上下文关联词,精准捕捉字词间的隐性语义关联,是AI理解语境、梳理上下文逻辑的核心基础。
- 统一模型输入维度:无论输入文本长度、Token数量如何变化,最终均可转换为统一维度的向量矩阵,完美适配Transformer固定输入规范,保障模型架构稳定运行。
Embedding就是为每个文字赋予专属“语义数据标签”,让AI真正读懂文字内涵。
五、Positional Encoding位置注入
Tokenization与Embedding完成后,文本已转换为携带完整语义的高维向量矩阵,但架构本身存在核心缺陷:Transformer的并行计算特性,会导致文本序列的语序信息丢失。
自然语言的语序直接决定核心语义,相同字词的不同排列组合,会产生完全不同的语义结果。若无语序标识,模型无法区分文本前后逻辑,语义理解将彻底失效。Positional Encoding位置编码,正是解决该问题的核心专属模块。
1. 核心作用通俗解读
位置编码功能精准单一,核心是补充文本序列信息,完善向量特征完整性:
- 核心功能:为每个Token的语义向量添加专属位置标签,让模型精准识别每个字符在文本序列中的排序、先后关系与间隔距离,精准区分语序差异。
- 功能分工:Embedding负责定义“文字本身的语义”,Positional Encoding负责定义“文字的序列位置”,二者互补完善文本特征。
- 最终效果:位置向量与语义向量叠加融合后,单个向量可同时承载语义信息与位置信息,形成完整的文本特征,满足模型深度语义解析需求。
位置编码的融合逻辑与架构设计取舍,是理解Transformer的关键细节:
- 信息融合逻辑:位置编码采用叠加融合模式,不会替换、覆盖原有语义向量,仅补充语序信息,实现语义特征与位置信息的完美兼容,无信息损耗。
- 架构取舍逻辑:传统RNN、LSTM采用串行计算,天然自带语序位置信息;Transformer为提升效率采用并行计算,丢失序列信息,必须人工注入位置特征,这是架构优化的核心取舍。
2. 位置编码实现原理
Transformer原始论文采用正余弦位置编码,无需训练、可通过公式实时计算,稳定性与泛化性极强,是当前主流大模型的通用方案,实现逻辑标准化、可复用:
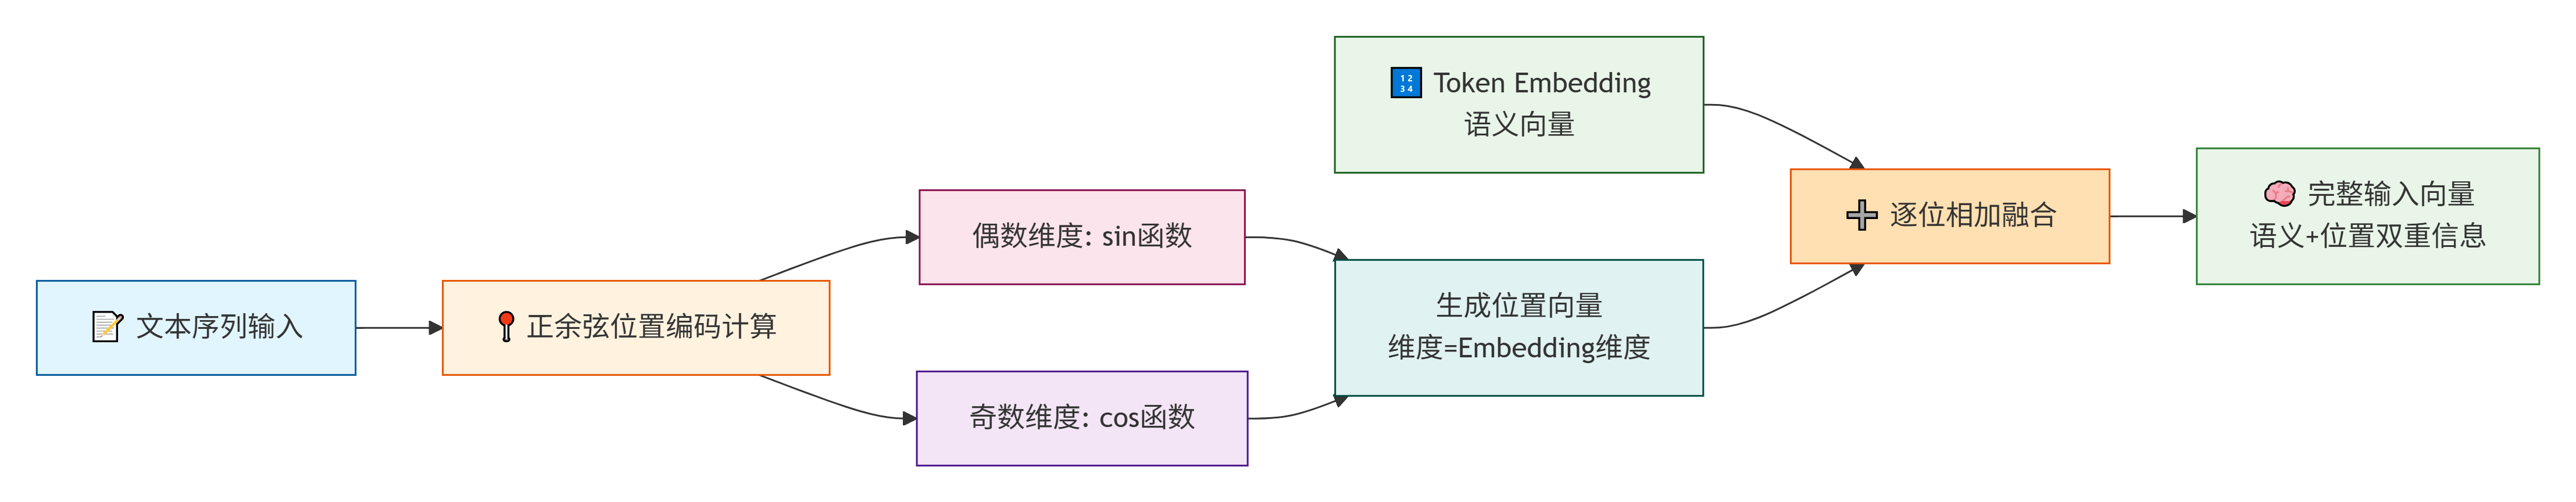
- 生成规则:针对文本序列的每个位置,分别通过正弦、余弦函数生成专属位置向量,向量维度与Embedding语义向量维度完全一致,支持直接叠加融合。
- 维度分配:向量偶数维度采用正弦函数计算,奇数维度采用余弦函数计算,不同序列位置生成独一无二的位置向量,无重复、无混淆。
- 融合方式:将计算完成的位置向量,与对应Token的Embedding语义向量逐位相加,生成同时融合语义、位置双重信息的完整输入向量,送入编码层。
3. 正余弦编码核心优势
相较于可学习式位置编码,正余弦编码更适配大模型大规模训练与长文本推理场景,具备不可替代优势:
- 超长文本泛化能力强:位置向量由公式实时生成,不依赖训练数据与固定序列长度,无论训练、推理的文本长度如何变化,均可精准生成对应位置信息,无超长文本失效问题。
- 具备相对位置感知能力:依托正余弦函数的周期性数学特征,模型可通过向量数值差异,自动判断字词的相对距离与先后顺序,精准捕捉上下文语序关联,贴合自然语言逻辑。
位置编码专门解决Transformer“不认语序”的缺陷,让文本序列有前后、语义逻辑有依据。
六、Encoder Decoder语义编解码
输入文本完成预处理后,携带完整语义与位置信息的向量矩阵,会进入Transformer的核心算力与语义处理层:Encoder编码器与Decoder解码器。两大模块分工协同,构成大模型语义理解与文本生成的核心大脑,所有智能交互能力均源于此。
二者功能边界清晰:Encoder专注输入文本的阅读理解与特征提取,Decoder专注基于特征的全新文本生成,多层堆叠后实现高精度语义解析与流畅内容创作。
1. Encoder编码器:语义理解核心
Encoder编码器的核心任务是全局语义编码与特征提炼,完整读取输入文本,深度挖掘字词关联、语法结构、上下文逻辑,输出全局统一的深层语义特征矩阵,具体结构与工作逻辑如下:
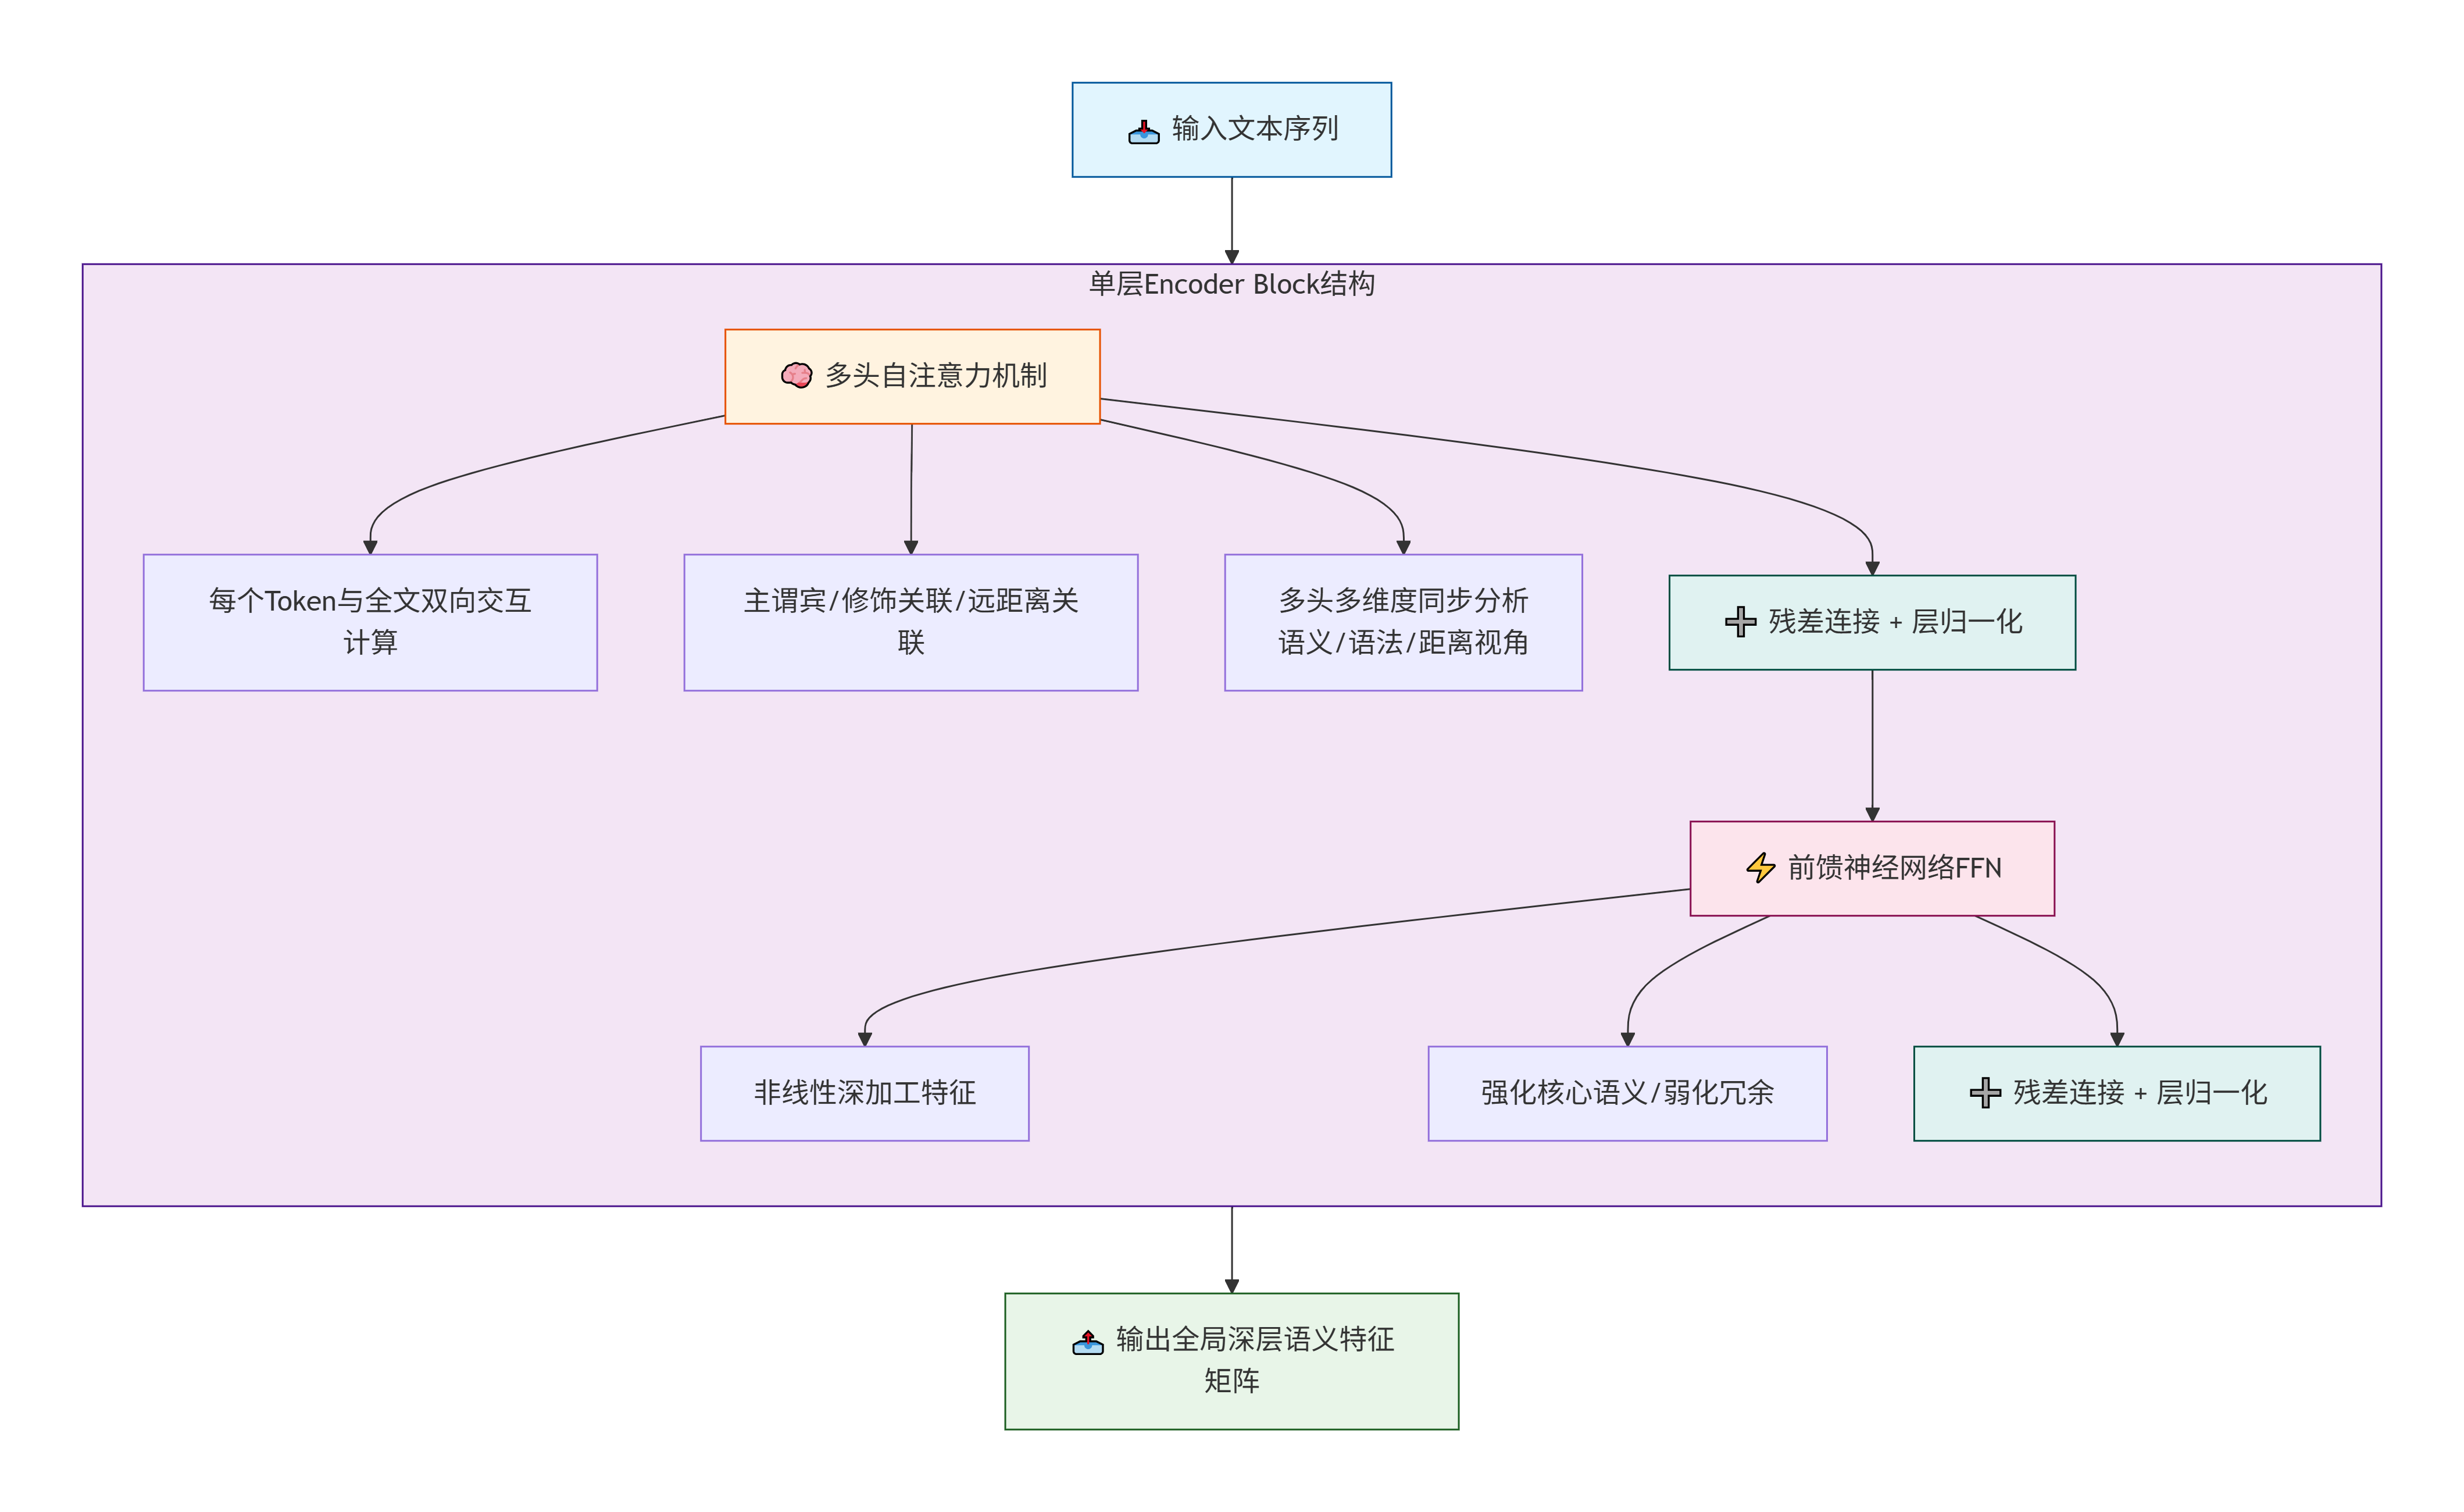
- 堆叠结构:由多个相同的Encoder Block堆叠而成,主流模型通常堆叠6-12层,堆叠层数越多,语义挖掘深度越高,特征提取精度越精细。
- 多头自注意力机制:Encoder核心核心模块,可实现文本中每个Token与全文所有Token的双向交互计算,精准捕捉主谓宾关系、修饰关联、远距离上下文关联。多头机制可从语义、语法、距离等多维度同步分析,规避单一视角的理解偏差。
- 前馈神经网络FFN:注意力层完成关联捕捉后,对每个Token的特征进行非线性深加工,强化核心语义、弱化无效冗余信息,优化向量特征精度,让特征更贴合上下文语境。
- 辅助优化结构:每层搭配残差连接与层归一化。残差连接解决深层模型梯度消失问题,保障多层堆叠后信息不丢失;层归一化统一数据分布,让模型训练更稳定、收敛速度更快。
Encoder最终输出的特征矩阵,脱离了原始字面含义,是融合全局上下文、语法逻辑、语义关联的标准化深层特征,为后续文本生成提供精准、完整的语义依据。
2. Decoder解码器:文本生成核心
Decoder解码器的核心任务是逐字迭代生成文本,依托Encoder提炼的全局语义特征,结合已生成的文本序列,迭代预测最优后续Token,最终输出完整通顺的文本内容,结构适配生成类任务,逻辑更为严谨:
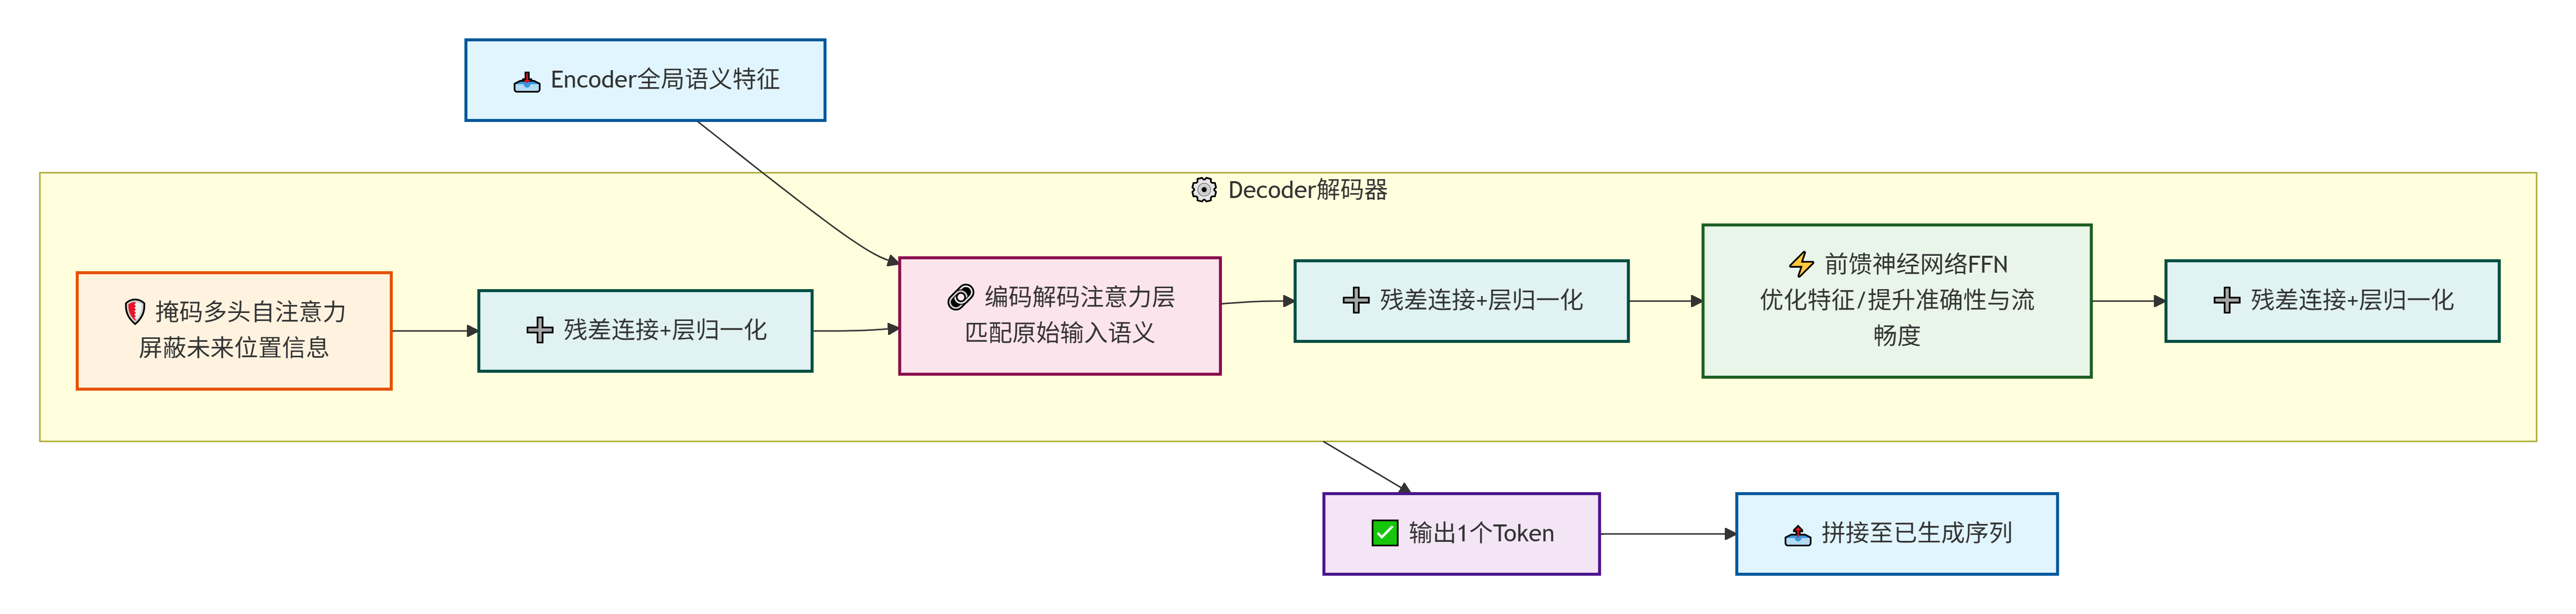
- 掩码多头自注意力:解码器专属核心设计,核心作用是屏蔽未生成的未来位置信息。文本逐字生成过程中,严格禁止模型提前读取后续字符,保证生成逻辑贴合真实交互场景,避免逻辑错乱。
- 编码解码注意力层:对接Encoder输出的全局语义特征,让每一步文本生成都精准匹配原始输入语义,约束生成方向,杜绝答非所问、主题偏离等问题。
- 前馈神经网络FFN:与编码器FFN功能一致,对解码后的特征进行深度优化,细化语义细节、修正特征偏差,提升生成文本的流畅度、准确性与逻辑性。
3. 编解码协同工作逻辑
Encoder与Decoder并非独立运行,而是高度协同、闭环联动,形成完整的语义处理与文本生成链路,完整流程说明:
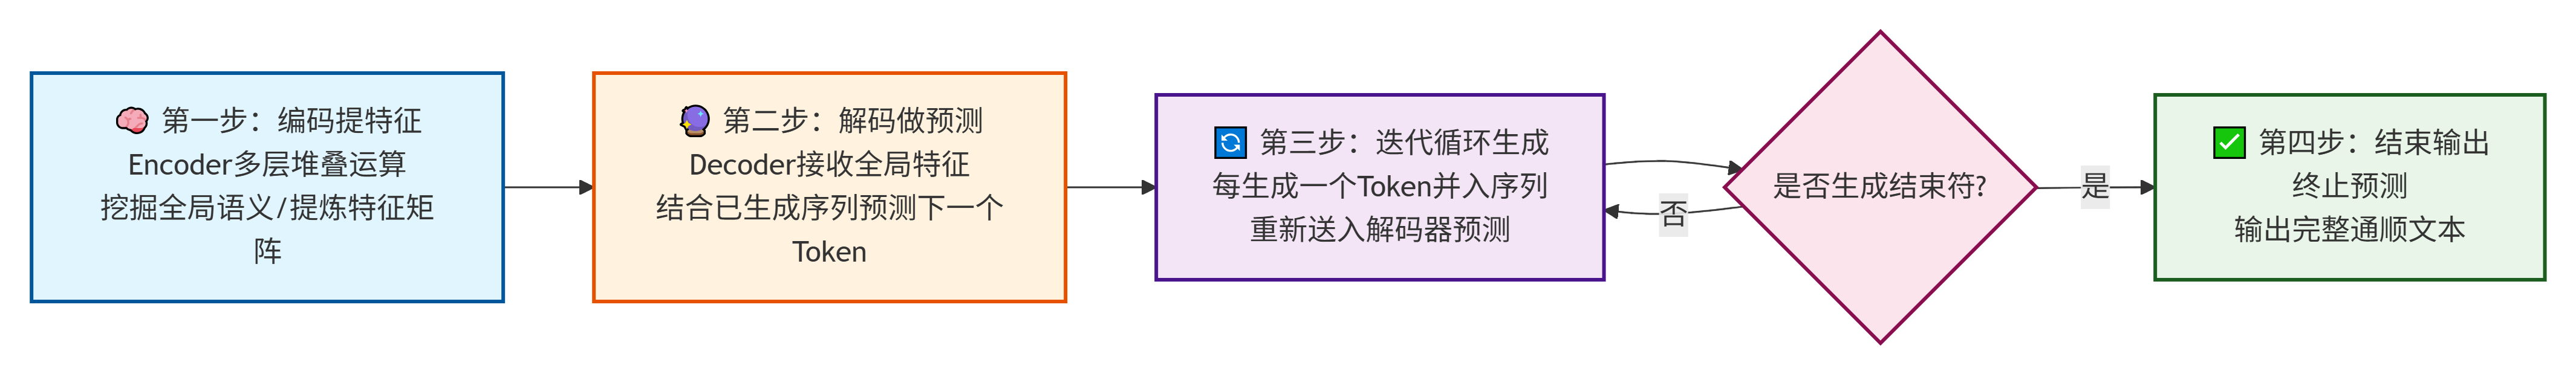
- 第一步:编码提特征:输入文本经Encoder多层堆叠运算,深度挖掘全局语义与上下文逻辑,提炼高维、高精度的全局特征矩阵。
- 第二步:解码做预测:Decoder接收Encoder全局特征,结合当前已生成的文本序列,计算预测下一个最优Token。
- 第三步:迭代循环生成:每生成一个Token,便将其并入输入序列,重新送入解码器开展下一轮预测,循环迭代。
- 第四步:结束输出:持续迭代运算,直至模型生成结束符,终止预测流程,输出完整、通顺、贴合语义的文本内容。
核心分工总结:Encoder是模型的“阅读理解核心”,吃透全部输入信息、提炼全局语义;Decoder是模型的“写作输出核心”,基于理解精准创作,二者协同支撑大模型的文本交互能力。
七、Linear层权重映射
经过Encoder、Decoder多层深度处理后,模型可输出富含全局语义的高维隐藏特征向量,但该向量属于模型内部抽象特征,无法直接对应具体文字。想要完成文本生成,必须通过Linear线性层实现维度转换,将抽象语义特征映射为词表对应的Token预测权重分布。
Linear层是Transformer输出端的核心前置映射模块,结构简洁但不可或缺,是连接模型隐藏特征与最终文本输出的唯一桥梁。
1. Linear层核心原理
Linear层本质是无激活函数的全连接线性变换,核心功能是完成维度适配与特征映射,原理清晰易懂:
- 核心任务:实现模型隐藏层维度与词表维度的匹配转换。模型深层语义特征为固定隐藏维度,可输出文字对应完整词表维度,二者维度不匹配,需通过线性变换完成对齐。
- 映射逻辑:变换后的特征数组,每个维度精准对应词表中的一个Token,数组内的数值即为该Token的上下文匹配权重。
- 权重含义:权重数值大小,代表模型基于当前上下文判定的文字适配度,数值越高,该Token作为下一个输出字符的匹配性越强。
2. 权重分布核心特点
Linear层输出的原始权重分布具备三大典型特征,也是后续必须通过Softmax归一化的核心原因:
- 数值无边界:原始权重无固定数值区间,可正、可负、可大可小,无法直接作为概率使用,不具备直接筛选价值。
- 相对值有效:权重绝对数值无实际意义,不同Token之间的数值差值、相对大小是核心,直接反映模型的预测倾向。
- 全覆盖特性:输出维度完整覆盖词表所有Token,所有可输出文字均拥有专属预测权重,保证模型具备全量文字选择空间。
3. Linear层的核心价值
Linear层是特征到文本的关键过渡模块,核心价值体现在两个核心维度,无可替代:
- 完成维度适配对齐:模型隐藏特征维度与词表维度属于不同数值空间,无法直接映射。Linear层通过标准化矩阵线性变换,完成维度精准匹配,让抽象语义特征可精准对应词表文字。
- 传递语义预测倾向:模型深层抽象语义特征无法直接对应具体文字,Linear层依托可训练参数,学习语义与文字的映射关系,将上下文语义特征转化为各候选Token的匹配分数,为最终文字决策提供依据。
简单来说,Linear层的核心作用是将模型读懂的抽象语义,转化为所有候选文字的匹配权重,完成从特征解析到文字筛选的关键过渡。
八、Softmax概率归一化
Linear层输出的Token权重数值杂乱、无固定区间、无法直接对比筛选,不能用于最终文字输出。Softmax激活函数作为Transformer输出层的最后一环,核心作用是将无序权重分布转化为标准化概率分布,完成最终文字决策,是大模型逐字生成的核心调度模块。
1. Softmax核心作用
Softmax的核心功能可精准概括为权重归一化、生成标准概率,具体功能如下:
- 数值归一化处理:接收Linear层输出的全部Token权重,通过固定公式统一转换,将所有数值压缩至0-1区间,且所有Token概率总和固定为1,形成合规的标准概率分布。
- 生成可决策概率:转换后的概率数值,直接代表对应Token作为“下一个输出文字”的预测概率,概率越高,上下文适配性越强。
Softmax不仅是收尾运算模块,更是大模型可控生成的核心调控单元,日常模型参数调节的核心逻辑均围绕该模块展开:
- 温度参数调控逻辑:温度参数越高,低概率Token的选中概率提升,生成内容随机性、创意性更强;温度参数越低,模型越倾向选择最高概率Token,生成内容更严谨、规整、贴合标准答案。
- 模块核心定位:Softmax是大模型的最终决策开关,所有输出文字的筛选逻辑均源于此,是整套Transformer架构落地应用的核心收尾模块。
2. 工作逻辑与计算特点
Softmax的计算逻辑深度适配文本生成场景,具备两大核心特性,保障生成结果精准合理:
- 放大最优解优势:对高匹配、高权重的Token,进一步放大其概率占比;对低匹配、低权重的Token,压缩其概率空间,拉大优劣差距,让最优文字的选择更精准。
- 全局联动计算:不单独处理单个Token权重,基于全局所有候选Token数值整体运算,保证概率的相对性与合理性,完全贴合上下文语义预测逻辑。
3. 大模型生成的完整闭环
依托全链路模块协同,大模型单字预测的完整技术闭环完全打通,整体运行逻辑清晰连贯:
- 单次预测链路:原始文本分词→Token向量转换→位置信息注入→编解码语义深加工→Linear权重映射→Softmax概率归一化→输出最优单字。

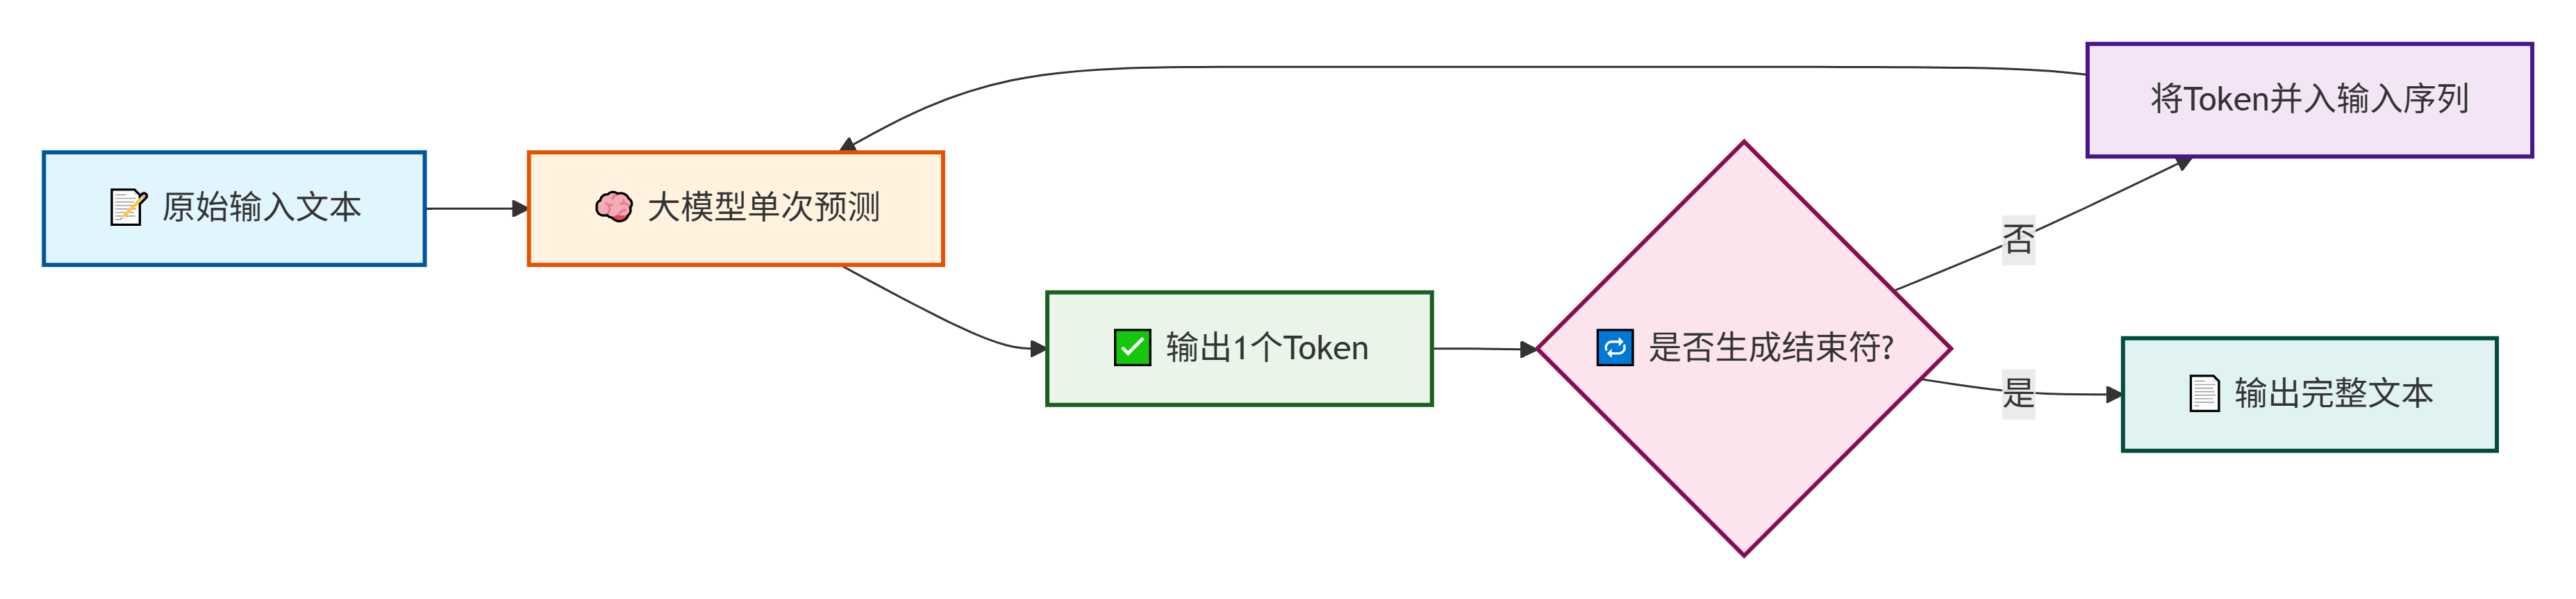
- 完整文本生成逻辑:大模型的完整文本回复,是该闭环的迭代循环结果。每输出一个Token,便将其并入输入序列,重新执行全流程预测下一个字符,循环往复直至生成结束符,最终输出连贯、完整、语义通顺的文本内容。
九. 应用实践分析
该示例从零构建了一个完整的Transformer推理模型:自定义正余弦位置编码注入序列位置信息,6层Encoder通过多头自注意力进行全局语义编码,Linear层将语义特征映射到词表空间,最后经Softmax归一化与Argmax解码输出预测Token,完整串联了Embedding→位置编码→Encoder→映射→解码的端到端推理链路。
import torch
import torch.nn as nn
import math

# --------------------------
# 1. 自定义位置编码(对应前文Positional Encoding原理)
# --------------------------
class PositionalEncoding(nn.Module):
    def __init__(self, embed_dim: int, max_seq_len: int = 512):
        super().__init__()
        # 生成位置编码矩阵,遵循正余弦编码规则
        position = torch.arange(max_seq_len).unsqueeze(1)
        div_term = torch.exp(torch.arange(0, embed_dim, 2) * (-math.log(10000.0) / embed_dim))

        pe = torch.zeros(max_seq_len, 1, embed_dim)
        pe[:, 0, 0::2] = torch.sin(position * div_term)  # 偶数维度正弦
        pe[:, 0, 1::2] = torch.cos(position * div_term)  # 奇数维度余弦
        self.register_buffer('pe', pe)

    def forward(self, x):
        # 叠加位置编码,不覆盖原始语义向量
        x = x + self.pe[:x.size(0)]
        return x

# --------------------------
# 2. 完整极简Transformer模型(复现论文基础架构)
# --------------------------
class SimpleTransformer(nn.Module):
    def __init__(
        self,
        vocab_size: int,    # 词表大小
        embed_dim: int = 512,# 向量维度
        num_heads: int = 8,  # 多头注意力数
        hidden_dim: int = 2048, # FFN隐藏层维度
        num_layers: int = 6, # 编解码堆叠层数
        dropout: float = 0.1
    ):
        super().__init__()
        # 1. Embedding层:Token ID转语义向量
        self.embedding = nn.Embedding(vocab_size, embed_dim)
        # 2. 位置编码层
        self.pos_encoder = PositionalEncoding(embed_dim)
        # 3. Transformer核心编解码层
        transformer_layer = nn.TransformerEncoderLayer(
            d_model=embed_dim, nhead=num_heads, dim_feedforward=hidden_dim, dropout=dropout, batch_first=True
        )
        self.encoder = nn.TransformerEncoder(transformer_layer, num_layers=num_layers)
        # 4. Linear权重映射层:特征映射词表权重
        self.fc = nn.Linear(embed_dim, vocab_size)
        # 5. Dropout正则化
        self.dropout = nn.Dropout(dropout)

    def forward(self, x):
        # 输入x: [batch_size, seq_len]  Token ID序列
        print(f"  [Stage1] Embedding:   Token ID {list(x.shape)} → 语义向量 {list(x.shape) + [self.embedding.embedding_dim]}")

        # Step1: Embedding语义转换
        embed_x = self.embedding(x)  # [batch, seq_len, embed_dim]
        embed_x = self.dropout(embed_x)

        # Step2: 注入位置信息
        pos_x = self.pos_encoder(embed_x)
        print(f"  [Stage2] Positional Encoding: 注入位置信息,形状不变 → {list(pos_x.shape)}")

        # Step3: Encoder全局语义编码
        encode_x = self.encoder(pos_x)
        print(f"  [Stage3] Encoder({self.encoder.num_layers}层): 多头注意力全局编码 → {list(encode_x.shape)}")

        # Step4: Linear权重映射,输出词表原始权重
        logits = self.fc(encode_x)  # [batch, seq_len, vocab_size]
        print(f"  [Stage4] Linear 映射:   语义特征 → 词表权重空间 → {list(logits.shape)}")

        return logits

# --------------------------
# 3. 完整推理Demo(模拟大模型单步预测)
# --------------------------
if __name__ == "__main__":
    # 超参数配置
    BATCH_SIZE = 1
    VOCAB_SIZE = 10000  # 模拟词表大小
    SEQ_LEN = 16        # 输入序列长度

    # 初始化模型
    model = SimpleTransformer(vocab_size=VOCAB_SIZE)
    model.eval()  # 推理模式

    # 模拟输入:随机生成Token ID序列(对应文本分词结果)
    input_tokens = torch.randint(0, VOCAB_SIZE, (BATCH_SIZE, SEQ_LEN))

    # 推理预测
    print("=" * 60)
    print(f"模型参数: vocab_size={VOCAB_SIZE}, embed_dim=512, num_heads=8, num_layers=6")
    print(f"输入: 随机Token序列 (batch={BATCH_SIZE}, seq_len={SEQ_LEN})")
    print(f"  Token IDs: {input_tokens.squeeze().tolist()[:8]}... (仅展示前8个)")
    print("-" * 60)
    print("[前向传播流程]")

    with torch.no_grad():
        # 1. 模型前向传播:完成Embedding+位置编码+编码+Linear映射
        logits = model(input_tokens)

        print("-" * 60)
        print("[后处理流程]")
        # 2. Softmax概率归一化(最终决策输出)
        probs = torch.softmax(logits, dim=-1)
        print(f"  [Step1] Softmax 归一化: 将logits转为概率分布 → {list(probs.shape)}")
        # 3. 选取最优Token(概率最大值)
        pred_tokens = torch.argmax(probs, dim=-1)
        print(f"  [Step2] Argmax 解码:    取每个位置概率最大的Token ID → {list(pred_tokens.shape)}")
        max_prob = torch.max(probs).item()
        print(f"  [Step3] 置信度评估:    最高预测概率 = {max_prob:.4f}")

    # 输出结果
    print("=" * 60)
    print(f"预测Token序列: {pred_tokens.squeeze().tolist()[:8]}... (仅展示前8个)")
    print(f"最高置信度: {max_prob:.4f}")
    print("=" * 60)
    print("代码执行链路: 分词输入→Embedding向量化→位置编码注入→Encoder语义编码→Linear映射→Softmax归一化→Argmax解码")
重点说明:
- Tokenization分词:代码以整数Token ID序列作为模型输入,模拟真实文本分词后的标准化数据格式,是模型运算的入口。
- Embedding词向量转换:通过nn.Embedding层完成离散Token ID到高维语义向量的转换,赋予文本语义特征。
- Positional Encoding位置注入:自定义正余弦位置编码类,实现向量叠加融合,补充文本序列语序信息。
- Encoder语义编码:多层Transformer编码层堆叠,依托多头注意力机制完成全局上下文语义特征提取。
- Linear层权重映射:全连接层将高维语义特征映射为词表维度的原始预测权重,完成特征到候选Token的转换。
- Softmax概率归一化:对原始权重做概率转换,筛选最优预测Token,完成最终文本决策输出。
输出结果:
============================================================ 模型参数: vocab_size=10000, embed_dim=512, num_heads=8, num_layers=6 输入: 随机Token序列 (batch=1, seq_len=16) Token IDs: [2282, 7783, 8405, 4870, 6873, 9029, 1004, 3438]... (仅展示前8个) ------------------------------------------------------------ [前向传播流程] [Stage1] Embedding: Token ID [1, 16] → 语义向量 [1, 16, 512] [Stage2] Positional Encoding: 注入位置信息,形状不变 → [1, 16, 512] [Stage3] Encoder(6层): 多头注意力全局编码 → [1, 16, 512] [Stage4] Linear 映射: 语义特征 → 词表权重空间 → [1, 16, 10000] ------------------------------------------------------------ [后处理流程] [Step1] Softmax 归一化: 将logits转为概率分布 → [1, 16, 10000] [Step2] Argmax 解码: 取每个位置概率最大的Token ID → [1, 16] [Step3] 置信度评估: 最高预测概率 = 0.0011 ============================================================ 预测Token序列: [6439, 943, 943, 6439, 3519, 943, 6439, 6439]... (仅展示前8个) 最高置信度: 0.0011 ============================================================ 代码执行链路: 分词输入→Embedding向量化→位置编码注入→Encoder语义编码→Linear映射→Softmax归一化→Argmax解码
十、总结
总的来说,Transformer架构与大模型文本生成的底层逻辑并不复杂,其本质是一套层层递进、逻辑闭环的标准化文本处理流水线,七大核心模块各司其职、相互配合,构成完整的AI文本智能体系。
整套架构核心逻辑:
- Tokenization完成文本标准化拆分,搭建人机交互的基础入口;
- Embedding为文本赋予语义数字特征,实现语义可计算、可解析;
- Positional Encoding补充序列位置信息,解决并行计算带来的语序缺失问题;
- Encoder&Decoder完成文本语义的深度解析与内容创作;
- Linear层实现抽象特征到文字权重的映射;
- Softmax完成概率归一化,实现最终文字的智能决策输出。
所有大模型的迭代升级,包括参数扩容、语义精度提升、场景适配优化、生成效果优化等,本质都是在这套基础架构上的细化与优化,无额外复杂逻辑,全部依托标准化工程架构与严谨数学逻辑实现。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号