JMT-YOLO:分割引导一致性学习,让 YOLO 在陌生域里也"看得清"
原创
JMT-YOLO:分割引导一致性学习,让 YOLO 在陌生域里也"看得清"
原创
AI小怪兽
修改于 2026-10-29 16:38:11
修改于 2026-10-29 16:38:11
论文解读 | JMT-YOLO:分割引导一致性学习,让 YOLO 在陌生域里也"看得清"
论文:《JMT-YOLO:基于分割引导一致性学习的多任务域自适应方法》
作者:Zhenhua Yu, Jiahao Zhang, Wenchao Zhang, Ou Ye, Hengxiang Zhao(西安科技大学 人工智能与计算机学院 系统安全与控制研究所)
博主简介
AI小怪兽 | 计算机视觉布道者 | 视觉检测领域创新者
深耕计算机视觉与深度学习领域,专注于目标检测前沿技术的探索与突破。长期致力于YOLO系列算法的结构性创新、性能极限优化与工业级落地实践,旨在打通从学术研究到产业应用的最后一公里。
🚀 核心专长与技术创新
- YOLO算法结构性创新:于CSDN平台原创发布《YOLOv13魔术师》、《YOLOv12魔术师》等全系列深度专栏。系统性提出并开源了多项原创自研模块,在模型轻量化设计、多维度注意力机制融合、特征金字塔重构等关键方向完成了一系列突破性实践,为行业提供了具备高参考价值的技术路径与完整解决方案。
- 技术生态建设与知识传播:独立运营 “计算机视觉大作战” 公众号(粉丝1.6万),成功构建高质量的技术交流社群。致力于将复杂算法转化为通俗易懂的解读与可复现的工程代码,显著降低了计算机视觉的技术入门门槛。
🏆 行业影响力与商业实践
- 荣获腾讯云年度影响力作者与创作之星奖项,内容质量与专业性获行业权威平台认证。
- 全网累计拥有 7万+ 垂直领域技术受众,专栏文章总阅读量突破百万,在目标检测领域形成了广泛的学术与工业影响力。
- 具备丰富的企业级项目交付经验,曾为工业视觉检测、智慧城市安防等多个关键领域提供定制化的算法模型与解决方案,驱动业务智能化升级。
💡 未来方向与使命
秉持 “让每一行代码都有温度” 的技术理念,未来将持续聚焦于实时检测、语义分割及工业缺陷检测的商业化闭环等核心方向。愿与业界同仁协同创新,共同推动技术边界,以坚实的技术能力赋能实体经济与行业变革。
一、摘要
域自适应目标检测(DAOD)旨在缓解训练(源域)与测试(目标域)数据分布偏移带来的性能退化。现有方法在细粒度特征建模不足、实例级对齐受限的情况下,遇到极端天气、目标遮挡等复杂环境时效果明显下降。
论文提出 JMT-YOLO——一个面向 DAOD 的联合多任务学习框架。它以 Mean Teacher 架构为底座,引入辅助语义分割任务与掩码机制来强化目标域前景-背景语义边界的建模:一方面用带稠密连接结构的多尺度上下文感知分割头(DenseRFB)捕获局部与全局上下文特征,降低细粒度特征退化;另一方面对目标域图像施加随机掩码并构造掩码一致性损失,引导网络学习结构上下文、改善实例级特征对齐。
在三个基准域自适应任务上:Pascal VOC → Clipart1k 达 46.9%、Cityscapes → Foggy Cityscapes 达 57.3%、KITTI → Cityscapes 达 61.0% mAP@0.5,全面超过现有 SOTA 与基线方法。
二、研究背景和意义
问题从哪来:目标检测器在 A 域训练、到 B 域测试时精度往往"腰斩"——晴天训练的模型遇到雾天、真实街景训练的模型遇到卡通风格,特征分布完全对不上。逐域标注成本高昂,DAOD 的目标就是不标注目标域也能把检测器迁移过去。
现有方法的两大短板:
- 细粒度特征退化:风格抽象、雾气衰减会抹掉目标的轮廓与纹理细节,仅靠全局特征对齐撑不住;
- 实例级对齐受限:对抗对齐、一致性正则多停留在图像/特征分布层面,单个实例在遮挡、退化下的对齐依然薄弱。
意义:JMT-YOLO 把"分割"这个像素级任务当免费的"结构监督器"接进检测框架,用掩码一致性逼着模型理解前景-背景边界——对雾天驾驶、跨风格数据这些工业痛点场景,是实打实的落地增益。
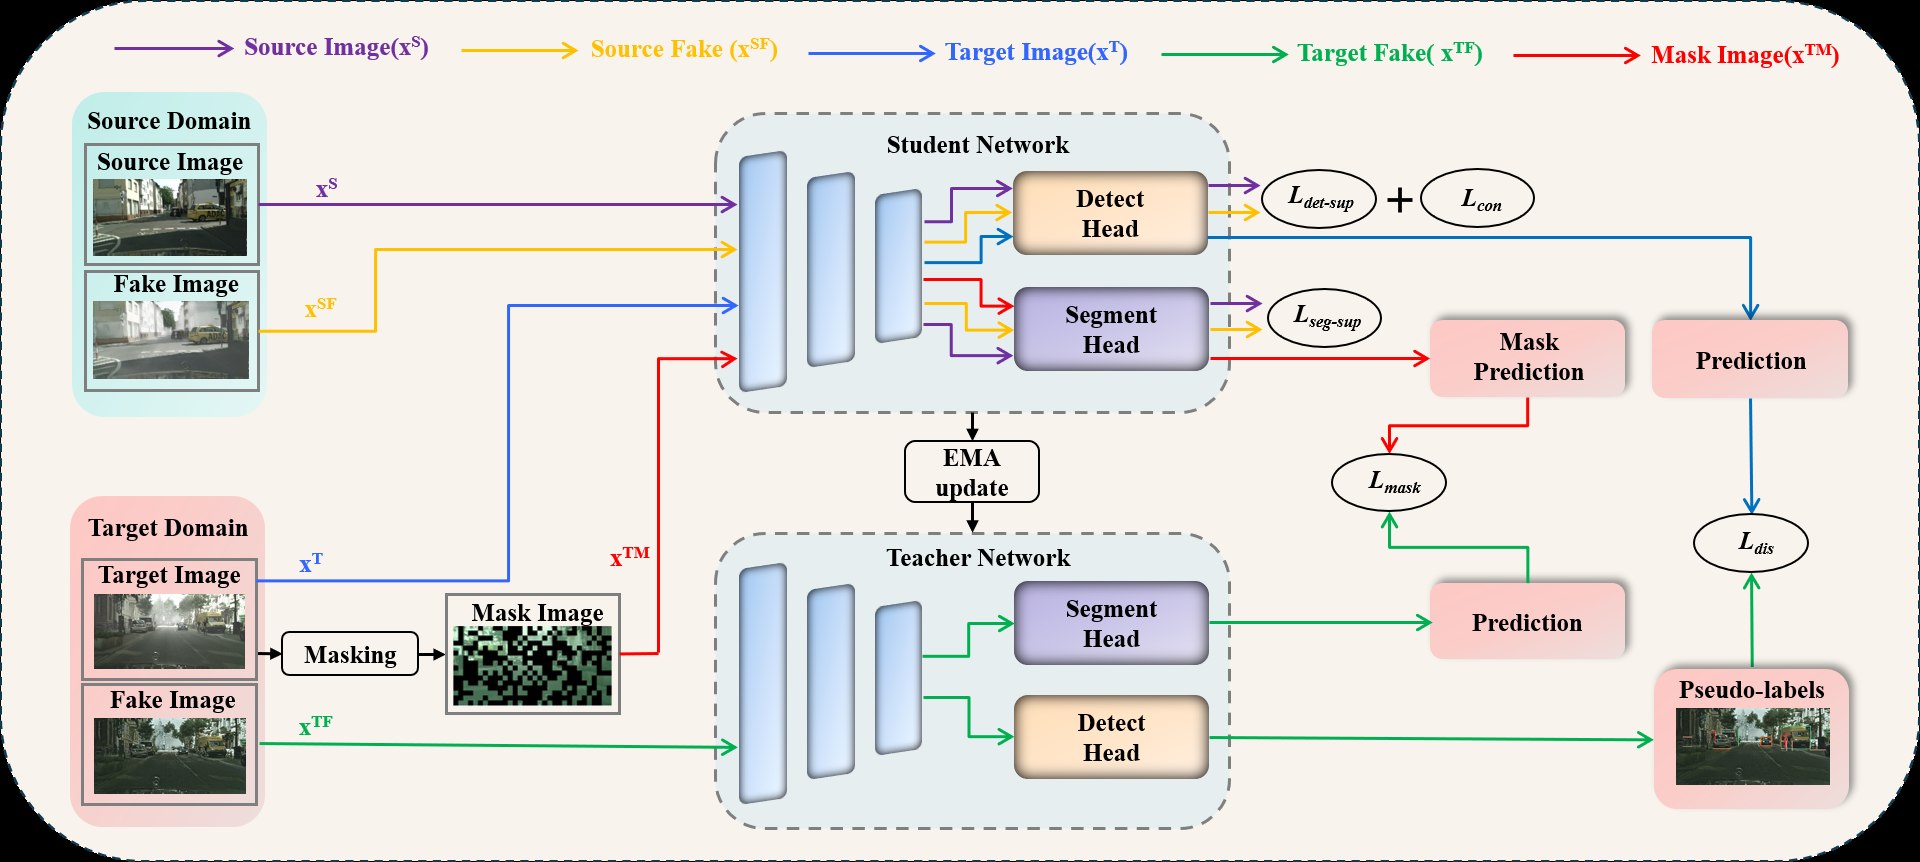
图1:JMT-YOLO 总体框架(Mean Teacher 双分支 + 辅助分割 + 掩码一致性)
图 1 是全文的"地图":学生网络同时吃源域真图/风格迁移图与目标域掩码图,Detect Head 与 Segment Head 并联出检测、分割两路损失;教师网络由 EMA 更新,产生伪标签并参与掩码一致性损失 L_mask 与蒸馏损失 L_dis。
三、创新点
- 联合多任务 DAOD 框架:在 Mean Teacher 检测框架中并行接入辅助语义分割分支,检测与分割共享 backbone/neck 联合优化,增强结构化特征表示与域对齐;
- 掩码一致性机制:对目标域图像做随机掩码,构造掩码一致性损失 L_mask,用上下文结构学习提升复杂环境下的鲁棒性与实例级对齐;
- DenseRFB 分割头:针对传统 RFB 分支间交互不足、缺乏层级融合的问题,引入稠密连接 + 层级特征融合策略,捕获多尺度局部细节与全局上下文。
核心源代码:
# jmt_yolo_core_improvements.py
# JMT-YOLO (https://github.com/25043221/JMT-YOLO) 核心改进整理
# 主要包含: DenseRFB (分割头核心) 与 Mask-Consistency (掩码一致性机制)
# 说明: 以下代码基于论文描述、官方仓库结构及公开技术资料整理,
#       旨在展示核心设计逻辑,具体实现请以官方仓库代码为准。

import torch
import torch.nn as nn
import torch.nn.functional as F


# ============================================================
# 1. DenseRFB: 密集感受野模块 (分割头核心)
# ============================================================
class DenseRFB(nn.Module):
    """
    Dense Receptive Field Block.
    作为辅助分割头的核心,通过密集连接和空洞卷积捕获多尺度上下文信息,
    缓解风格抽象导致的细粒度特征退化。
    参考: 论文指出 DenseRFB 使用密集连接 (dense connection) 和
          空洞卷积 (dilated convolution),膨胀率分别为 d1=2, d2=3。
    """
    def __init__(self, in_channels, out_channels):
        super().__init__()
        # 主分支: 1x1 卷积 + 3x3 标准卷积,得到初始特征
        self.main_branch = nn.Sequential(
            nn.Conv2d(in_channels, out_channels, kernel_size=1, bias=False),
            nn.BatchNorm2d(out_channels),
            nn.SiLU(inplace=True),
            nn.Conv2d(out_channels, out_channels, kernel_size=3, padding=1, bias=False),
            nn.BatchNorm2d(out_channels),
            nn.SiLU(inplace=True),
        )

        # 密集连接分支: 两个不同膨胀率的空洞卷积分支
        # 膨胀率 d1=2, d2=3 (来自论文描述)
        self.dilated_branch1 = nn.Sequential(
            nn.Conv2d(out_channels, out_channels, kernel_size=3,
                      padding=2, dilation=2, bias=False),
            nn.BatchNorm2d(out_channels),
            nn.SiLU(inplace=True),
        )
        self.dilated_branch2 = nn.Sequential(
            nn.Conv2d(out_channels, out_channels, kernel_size=3,
                      padding=3, dilation=3, bias=False),
            nn.BatchNorm2d(out_channels),
            nn.SiLU(inplace=True),
        )

        # 融合层: 将主分支、两个空洞分支以及可能的残差连接进行拼接
        # 密集连接: 后续分支的输入包含前序分支的输出
        # 这里简化演示融合逻辑,实际实现可能包含更多密集连接细节
        self.fuse = nn.Sequential(
            nn.Conv2d(out_channels * 3, out_channels, kernel_size=1, bias=False),
            nn.BatchNorm2d(out_channels),
            nn.SiLU(inplace=True),
        )

    def forward(self, x):
        # 主分支特征
        main_feat = self.main_branch(x)

        # 第一个空洞分支 (d1=2),输入为主分支特征
        d1_feat = self.dilated_branch1(main_feat)

        # 第二个空洞分支 (d2=3),输入为第一个分支的输出 (密集连接)
        d2_feat = self.dilated_branch2(d1_feat)

        # 拼接融合: 主分支 + 两个空洞分支
        fused = torch.cat([main_feat, d1_feat, d2_feat], dim=1)
        out = self.fuse(fused)
        return out


# ============================================================
# 2. 辅助分割头 (Segment Head)
# ============================================================
class SegmentHead(nn.Module):
    """
    辅助语义分割头。
    接收融合特征,通过 DenseRFB 模块进行多尺度上下文增强,
    然后输出像素级分割预测。
    """
    def __init__(self, in_channels, num_classes):
        super().__init__()
        # 特征融合后的通道压缩 (可选)
        self.reduce = nn.Sequential(
            nn.Conv2d(in_channels, in_channels // 2, kernel_size=1, bias=False),
            nn.BatchNorm2d(in_channels // 2),
            nn.SiLU(inplace=True),
        )
        # DenseRFB 核心模块
        self.dense_rfb = DenseRFB(in_channels // 2, in_channels // 2)
        # 最终分割预测层
        self.seg_conv = nn.Conv2d(in_channels // 2, num_classes, kernel_size=1)

    def forward(self, x):
        x = self.reduce(x)
        x = self.dense_rfb(x)
        seg_logits = self.seg_conv(x)
        return seg_logits


# ============================================================
# 3. 掩码一致性机制 (Mask-Consistency)
# ============================================================
def generate_random_mask(x, mask_ratio=0.5, patch_size=16):
    """
    对目标图像或特征图应用随机掩码。
    论文中描述为对目标图像应用随机掩码操作。
    这里提供一个基于 patch 的随机掩码生成器。
    """
    B, C, H, W = x.shape
    num_patches_h = H // patch_size
    num_patches_w = W // patch_size
    num_patches = num_patches_h * num_patches_w

    # 随机选择要掩码的 patch
    mask = torch.rand(B, num_patches, device=x.device) > mask_ratio
    mask = mask.float().reshape(B, 1, num_patches_h, num_patches_w)
    # 上采样到原始尺寸
    mask = F.interpolate(mask, size=(H, W), mode='nearest')
    return mask


class MaskConsistencyLoss(nn.Module):
    """
    掩码一致性损失。
    对学生模型在掩码输入上的预测和教师模型在原始输入上的预测
    计算交叉熵损失,引导网络学习结构上下文。
    参考: 论文指出通过随机掩码操作构建掩码一致性损失 (mask-consistency loss)。
    """
    def __init__(self, ignore_index=255):
        super().__init__()
        self.ce = nn.CrossEntropyLoss(ignore_index=ignore_index)

    def forward(self, student_logits, teacher_logits, mask):
        """
        student_logits: 学生模型对掩码图像的预测 (B, C, H, W)
        teacher_logits: 教师模型对原始图像的预测 (B, C, H, W)
        mask: 掩码图,1 表示保留,0 表示掩码 (B, 1, H, W)
        """
        # 教师预测作为伪标签 (stop-gradient)
        teacher_probs = teacher_logits.softmax(dim=1)
        # 在掩码区域计算一致性损失 (或全局一致性,视实现而定)
        # 这里演示在掩码区域进行加权的交叉熵
        # 将教师概率转换为硬标签或使用软标签
        loss = F.cross_entropy(student_logits, teacher_probs.argmax(dim=1),
                                reduction='none')
        # 仅在掩码区域 (mask == 0) 或非掩码区域加权,具体策略需参考原文
        # 示例: 在掩码区域给予更高权重
        weight = (1.0 - mask.squeeze(1))  # 掩码区域权重为 1
        loss = (loss * weight).sum() / (weight.sum() + 1e-6)
        return loss


# ============================================================
# 4. 整合示例: JMT-YOLO 核心组件
# ============================================================
if __name__ == "__main__":
    # 模拟设置
    B, C, H, W = 2, 256, 64, 64
    num_seg_classes = 19  # 例如 Cityscapes

    # 模拟融合特征 (来自检测主干和颈部)
    fused_feature = torch.randn(B, C, H, W)

    # 1. 辅助分割头
    seg_head = SegmentHead(in_channels=C, num_classes=num_seg_classes)
    seg_logits = seg_head(fused_feature)
    print(f"Segment Head 输入: {fused_feature.shape}, 输出: {seg_logits.shape}")

    # 2. 随机掩码
    mask = generate_random_mask(fused_feature, mask_ratio=0.5, patch_size=16)
    masked_feature = fused_feature * mask
    print(f"掩码形状: {mask.shape}, 保留比例: {mask.mean().item():.2f}")

    # 3. 掩码一致性损失 (模拟学生和教师输出)
    student_logits = seg_head(masked_feature)  # 学生模型对掩码输入的预测
    teacher_logits = seg_head(fused_feature).detach()  # 教师模型对原始输入的预测 (停止梯度)
    consistency_loss = MaskConsistencyLoss()
    loss = consistency_loss(student_logits, teacher_logits, mask)
    print(f"掩码一致性损失: {loss.item():.4f}")
四、创新点解读
4.1 魔术师式拆解一:伪训练图像生成(数据侧)
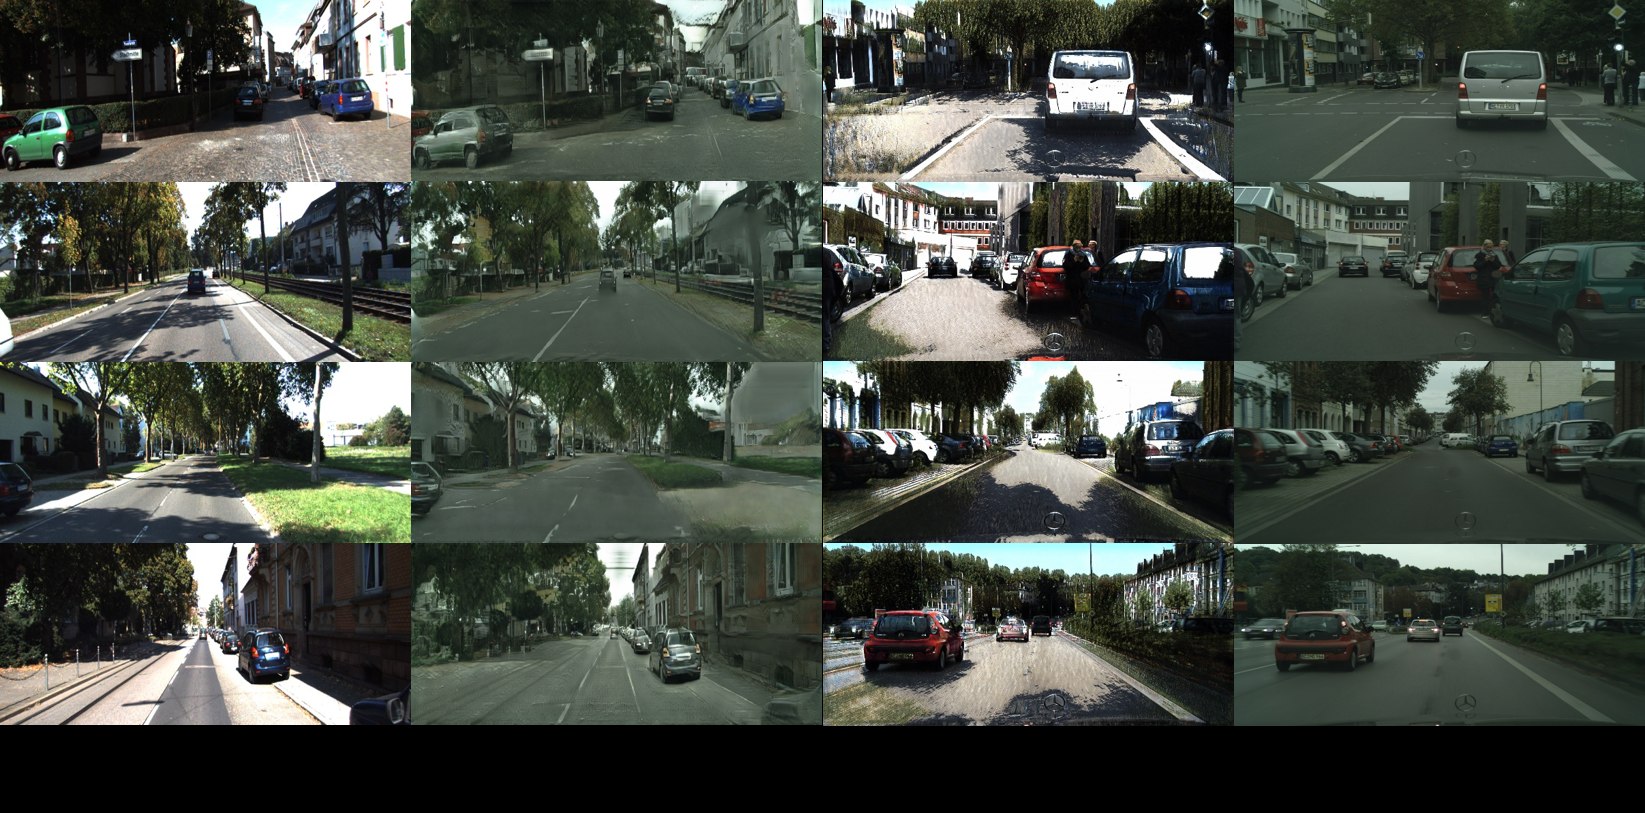
图2:KITTI 与 Cityscapes 双向风格迁移生成的伪训练图像
图 2:KITTI 原图(a)迁移成 Cityscapes 风格(b),Cityscapes 原图(d)迁移回 KITTI 风格(c)。风格大变、结构保留。
域自适应的第一道坎是"风格沟"。论文用图像翻译生成 Source Fake(x^SF)与 Target Fake(x^TF),让每个源域样本都带一个"目标域皮肤"的孪生兄弟——标签照用、风格换装,训练样本多样性直接翻倍。这一步和 Mean Teacher 的半监督一致性天然互补:真伪两路输入喂进同一个学生网络,风格不变性被"喂"出来。
4.2 魔术师式拆解二:DenseRFB 分割头(模型侧)
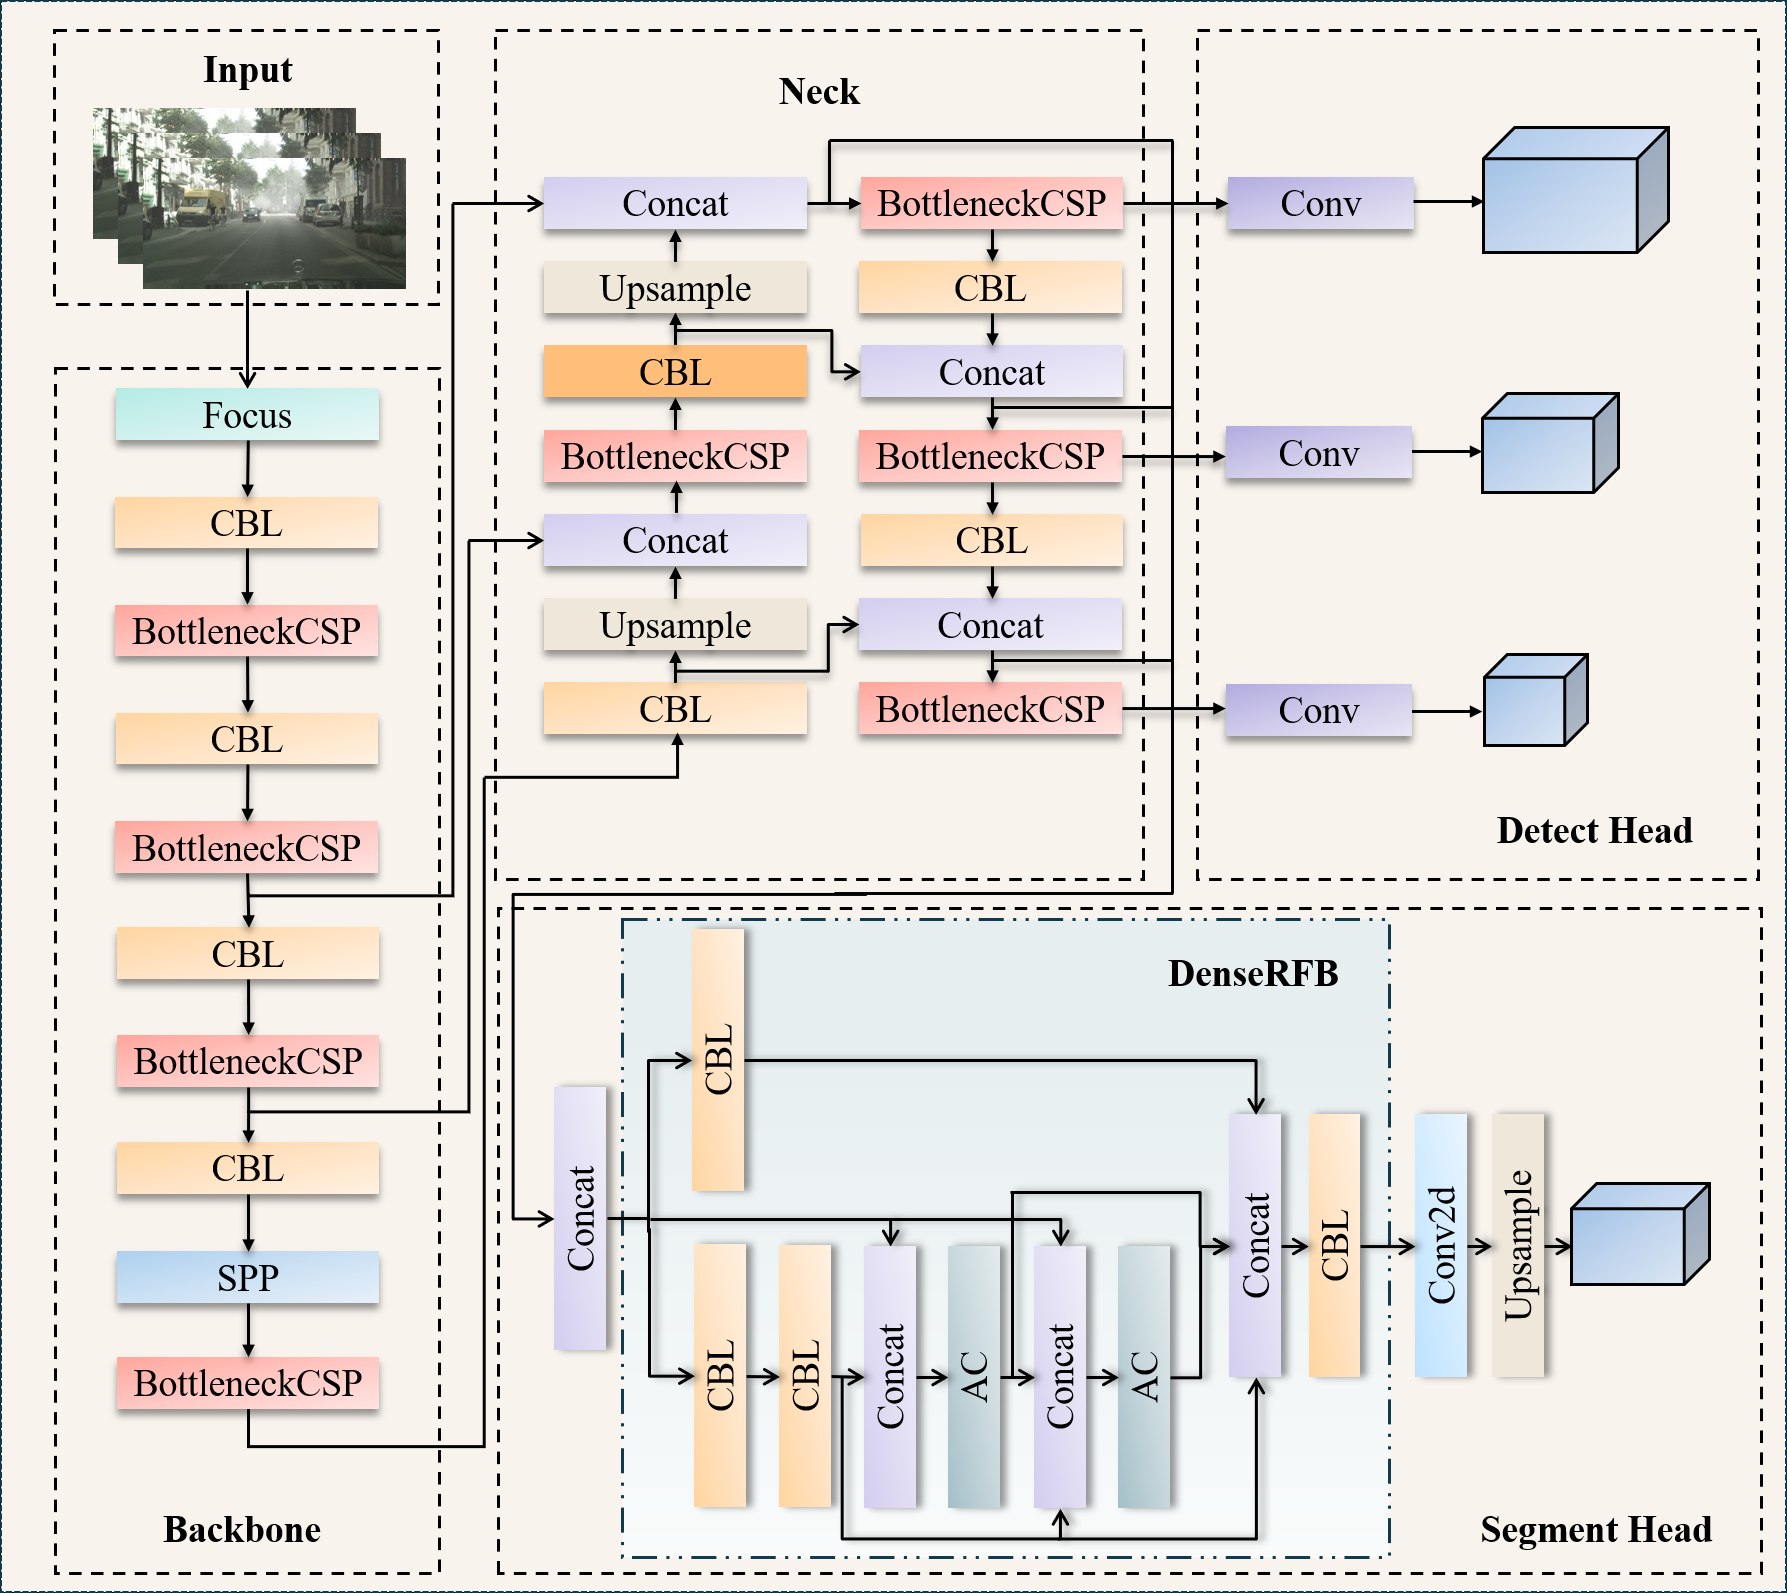
图3:基于 YOLOv5 的教师-学生网络总体结构,Segment Head 内嵌 DenseRFB
图 3:Backbone(Focus + CBL + BottleneckCSP + SPP)→ FPN+PAN Neck → 并联 Detect Head 与 Segment Head;DenseRFB 内部多分支卷积稠密连接,末端 AC(空洞卷积)扩感受野。
传统 RFB 用并行分支抓多尺度特征,但分支之间几乎不交互,局部细节与全局上下文融合不到位。DenseRFB 的改法很"魔术师":
- 稠密连接:每层输出都接到后续所有层的输入,特征复用拉满,跨域场景下信息不丢;
- 层级融合:浅层细节特征与深层语义特征显式拼接,配合空洞卷积(AC)扩大感受野——这正是检测小目标、远目标最需要的组合。
4.3 魔术师式拆解三:掩码一致性(训练侧)
对目标域图像随机挖掉一块(掩码图 x^TM),学生网络要同时预测完整图与掩码图的检测结果,并与教师预测做一致性约束。直觉上这是"遮住一部分,逼模型靠结构上下文脑补"——被雾糊住、被遮挡的目标,其语义边界只能靠前景-背景结构推断,而辅助分割分支恰好提供了像素级的结构监督。两者叠加,实例级对齐不再悬空。
五、实验结果
5.1 三个基准任务主结果
域自适应任务 | Source Only | SSDA-YOLO | 此前 SOTA | JMT-YOLO |
|---|---|---|---|---|
Pascal VOC → Clipart1k | 27.5 | 44.3 | 46.3(TIA) | 46.9 |
Cityscapes → Foggy Cityscapes | 35.9 | 55.9 | 51.1(VT) | 57.3 |
KITTI → Cityscapes | — | — | — | 61.0 |
- 跨风格(VOC→Clipart1k):Source Only 仅 27.5%,风格沟巨大;辅助分割为 backbone 提供空间监督,DenseRFB 补回风格抽象丢失的细节;
- 恶劣天气(→Foggy Cityscapes):掩码机制强制检测/分割分支一致,让模型在能见度退化下仍聚焦目标区域;
- 跨场景(KITTI→Cityscapes):街景风格与相机参数双重偏移,61.0% 的结果验证了框架在真实→真实域偏移下的泛化性。
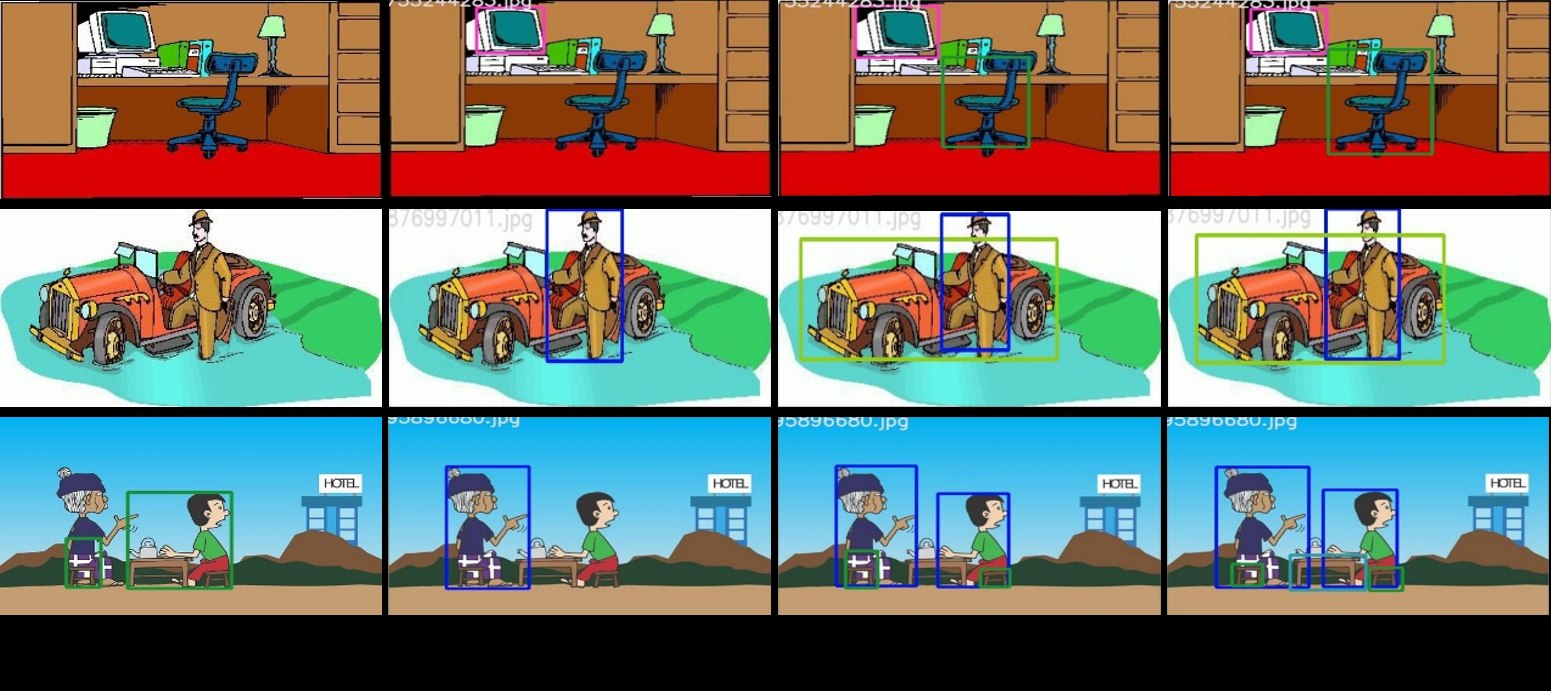
图4:VOC→Clipart1k 定性对比,JMT-YOLO 边界更清晰、误检更少
图 4:与 SSDA-YOLO 相比,chair、person、TV 等纹理稀疏类别的检测置信度与边界质量明显更好。
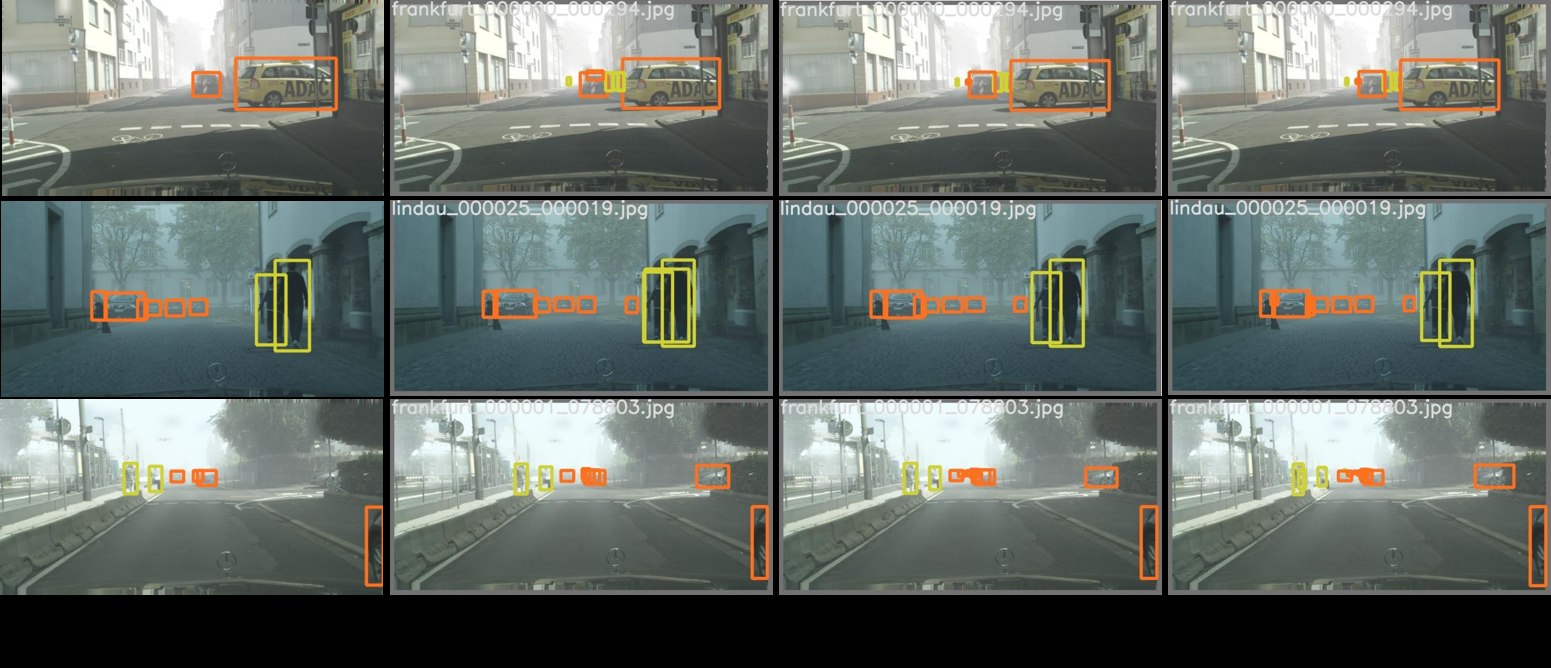
图5:Cityscapes→Foggy Cityscapes 定性对比,远处与部分遮挡目标检出更准
图 5:雾天场景下,JMT-YOLO 能检出更远、被部分遮挡的目标。
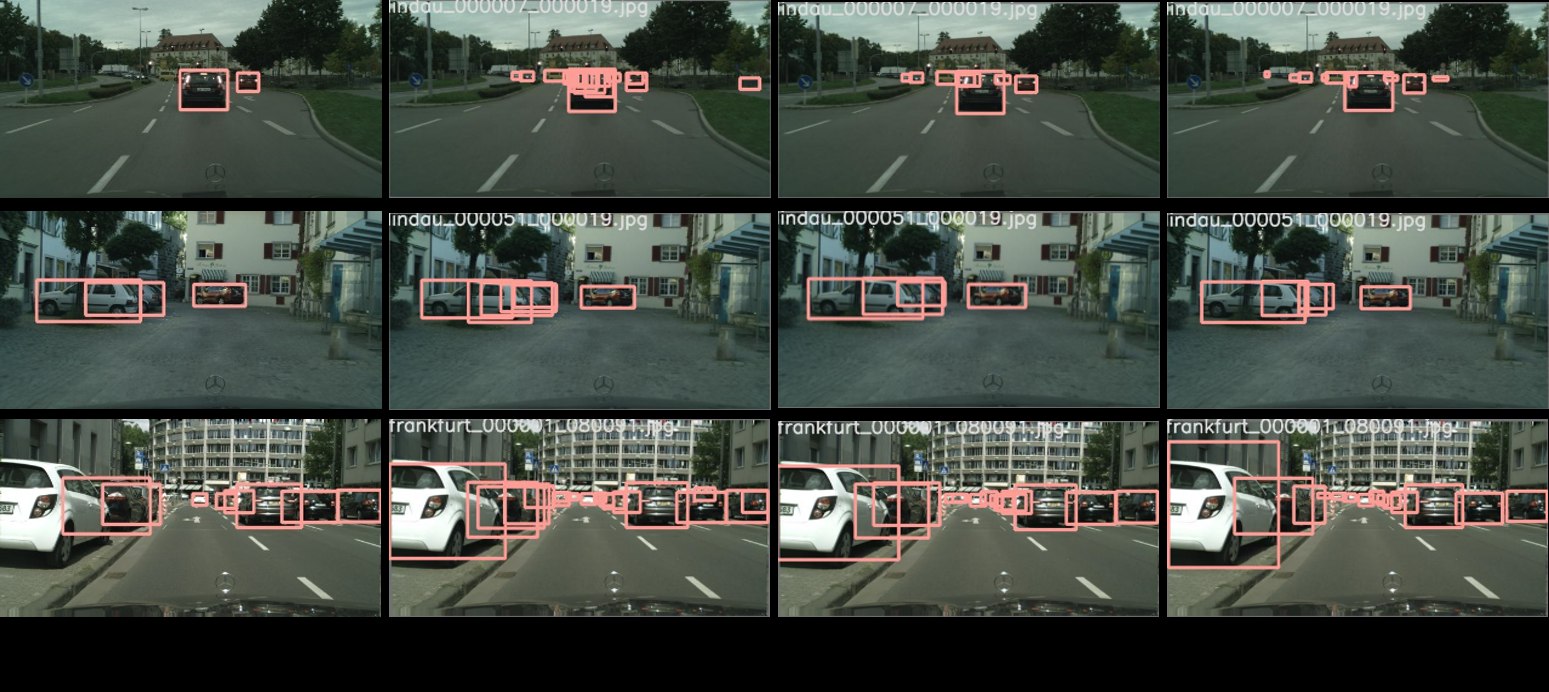
图6:KITTI→Cityscapes 定性检测结果网格
图 6:真实街景域偏移下的检测效果,车辆目标定位稳定。
5.2 消融:模块逐个加
论文 Table 4(Cityscapes → Foggy Cityscapes)逐模块累加:
Source Only | +Baseline(SSDA-YOLO) | +Masking | +DenseRFB |
|---|---|---|---|
35.9 | 55.9 | ↑ | 最优 |
掩码比实验(图 7)显示 0.6 是最优默认值:适度掩码提升鲁棒性,≥0.7 后语义完整性被破坏,0.8 时 mAP 跌到最低。
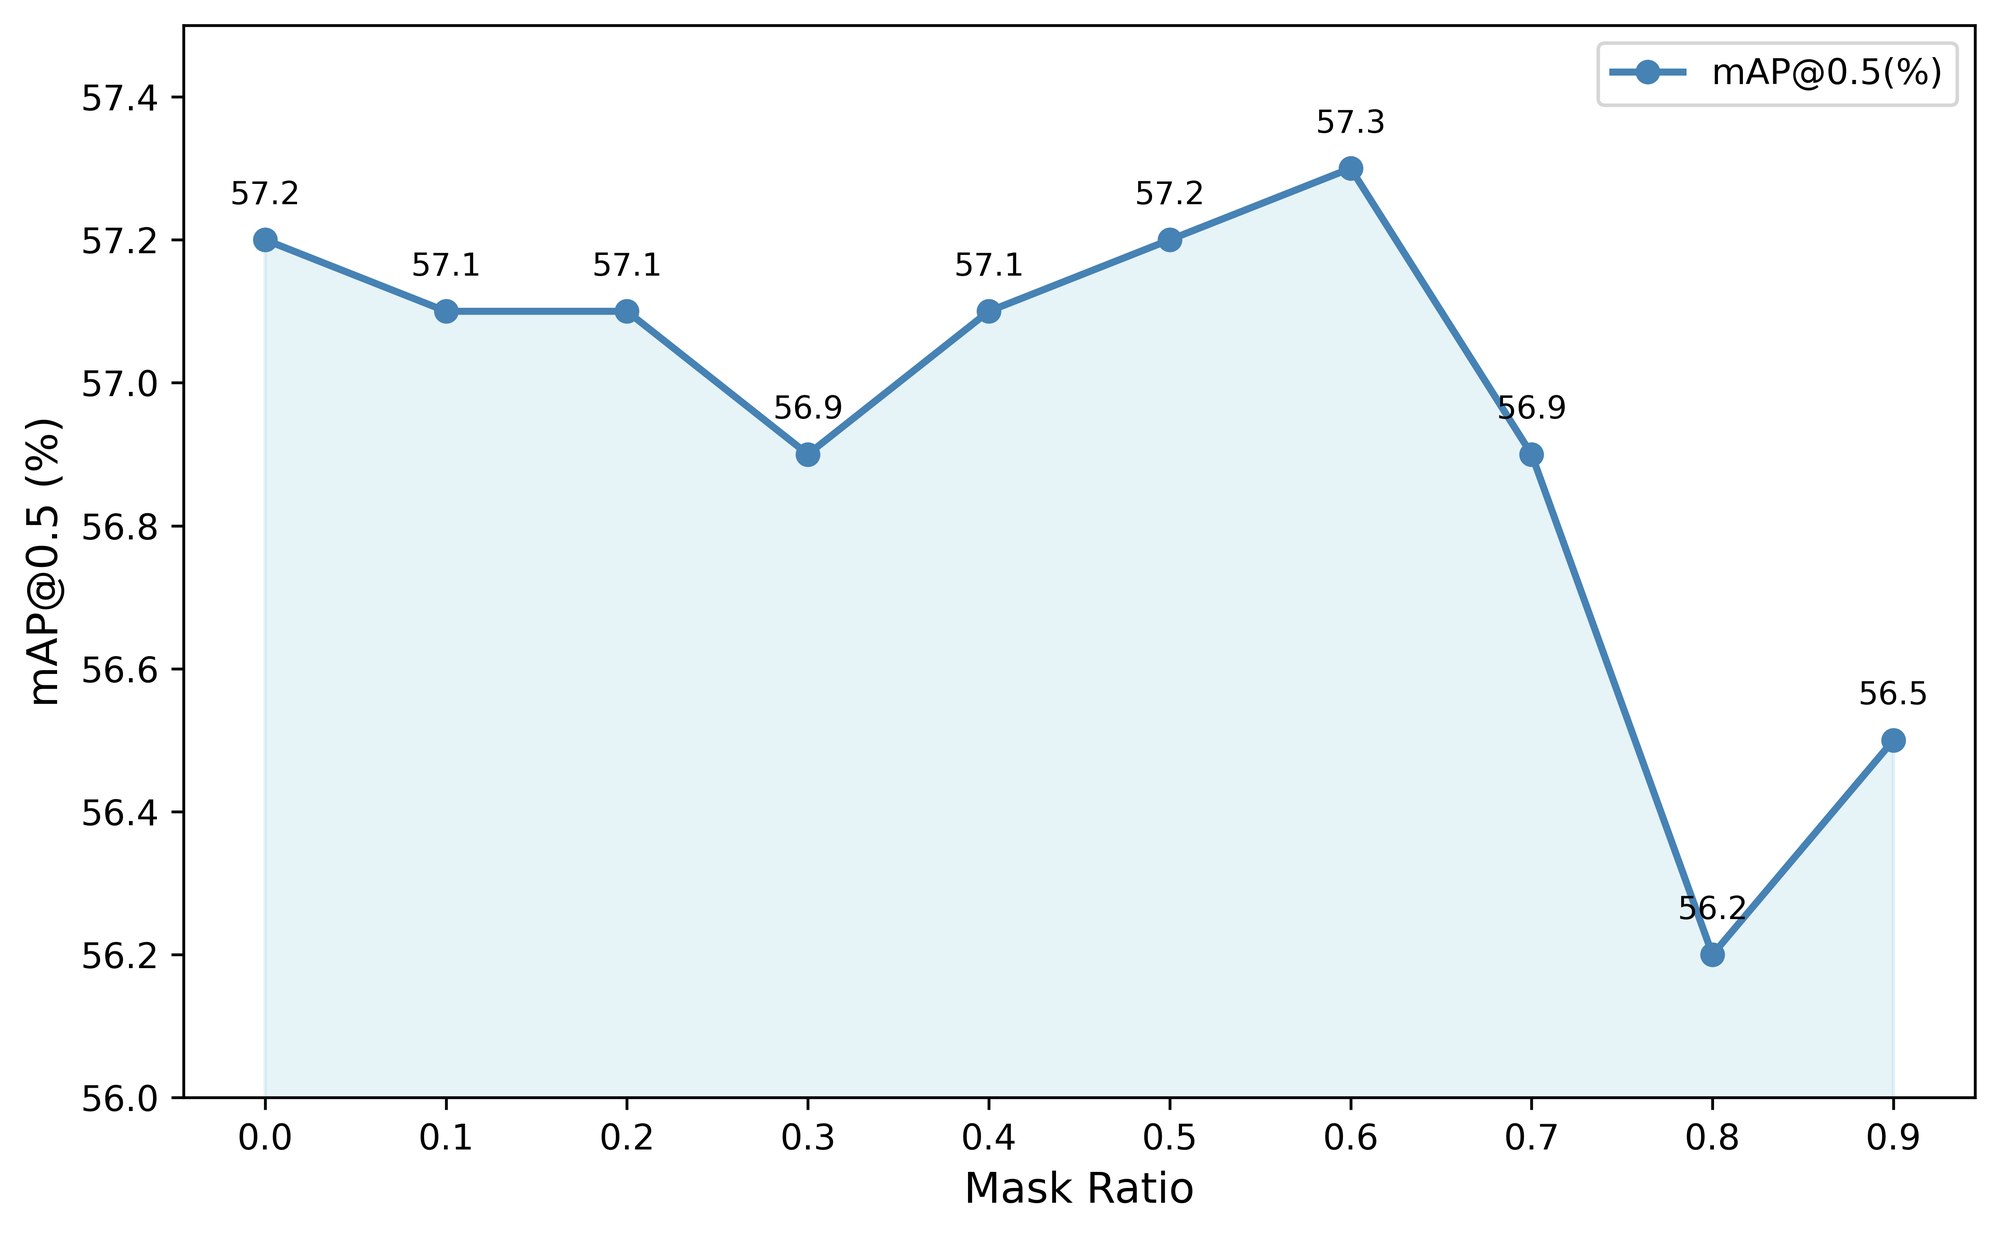
图7:掩码比消融曲线,0.6 处取得最优 57.3%,0.8 跌至谷底 56.2%
图 7:适度掩码是"优化器",过度掩码破坏语义完整性——0.6 是鲁棒性与语义保留的平衡点。
损失权重消融(图 8)显示检测/分割损失权重对 λ_det=0.6、λ_seg=0.4 最优(57.3%),分割权重过高(0.8)会挤压检测主任务、跌至 50.2%——辅助任务要"辅"而不"抢"。
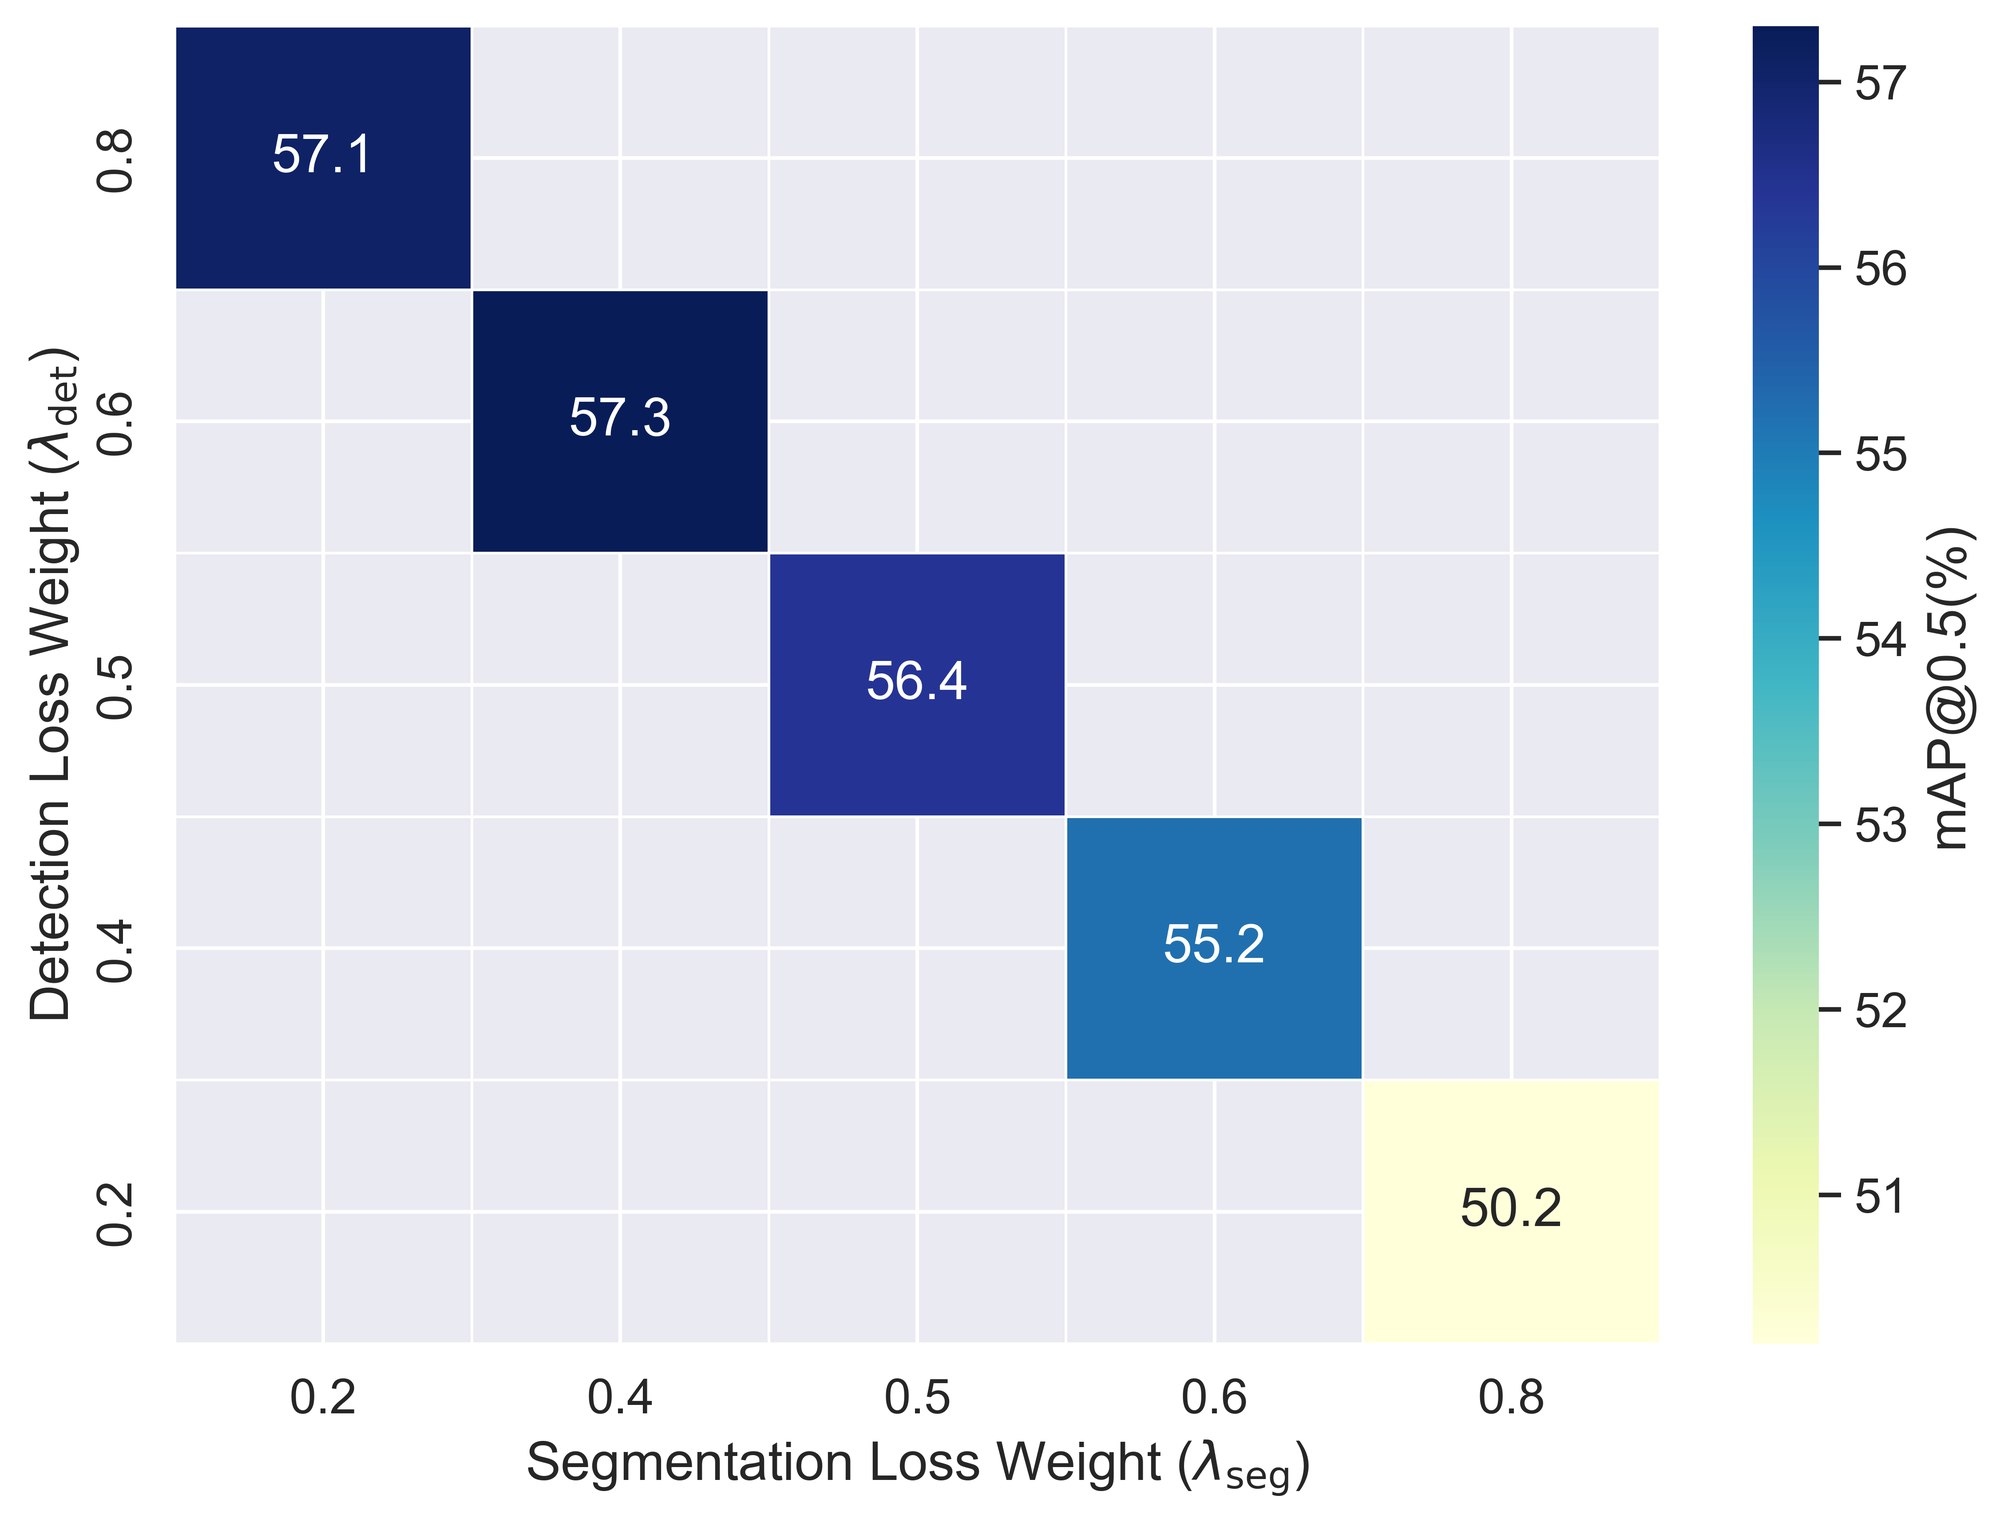
图8:检测/分割损失权重热图,λ_det=0.6、λ_seg=0.4 组合最优
图 8:多任务权重配比的敏感性一目了然,蓝色越深性能越高。
5.3 可视化证据链
Grad-CAM(图 9):加掩码后激活更紧凑、与目标区域对齐——浓雾中卡车与背景楼融合时,无掩码模型激活发散,有掩码模型清晰分离目标并增强远处小车响应。
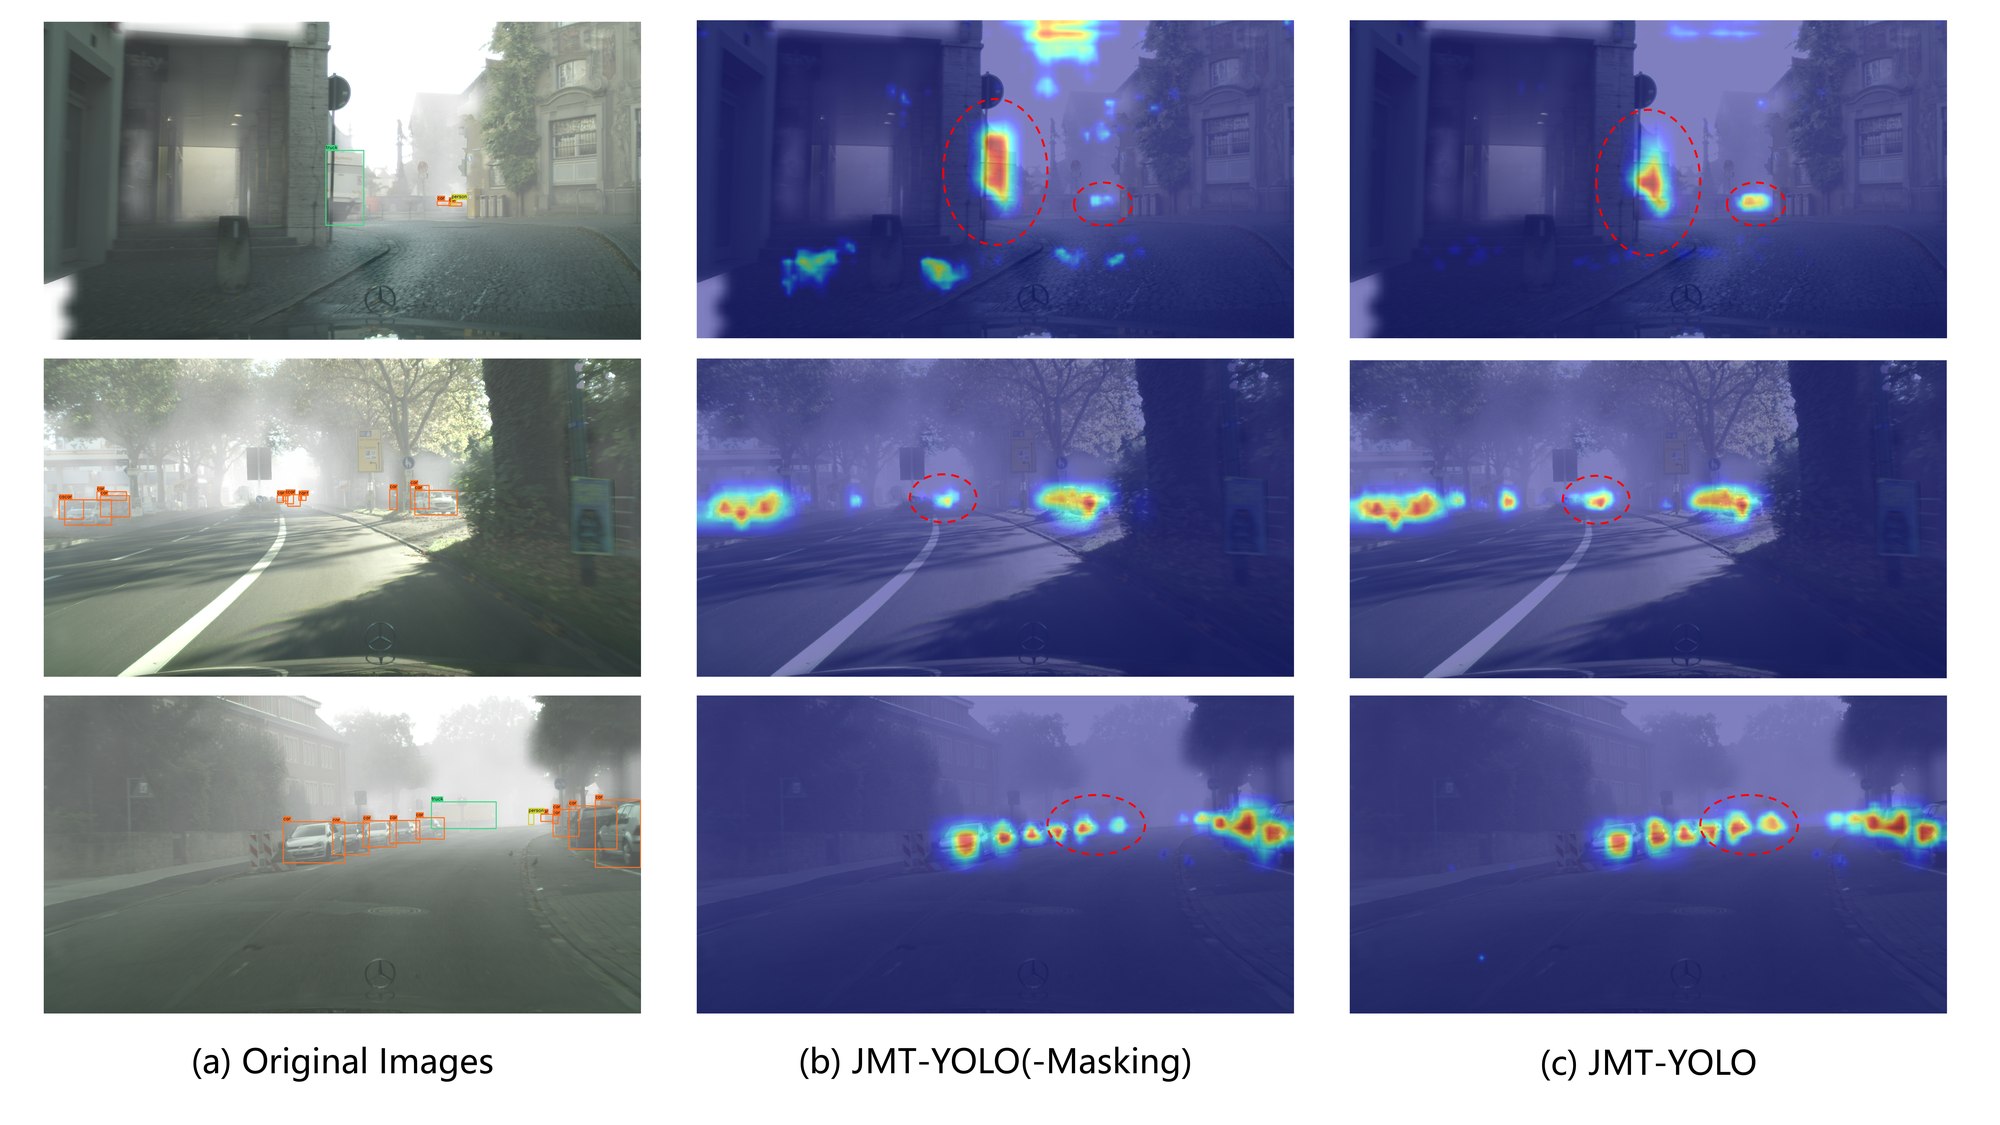
图9:Foggy Cityscapes 上的 Grad-CAM 对比,加掩码后激活紧凑且贴合目标
图 9:三行场景均显示 masked 模型的热图更完整、更聚焦目标。
SAM 伪掩码提示策略(图 11):GT 框、自动框、文本三种提示下 SAM 生成质量对比——auto box+SAM 已接近 GT+SAM,说明即使没有高质量 GT 框,结构监督依然可得。
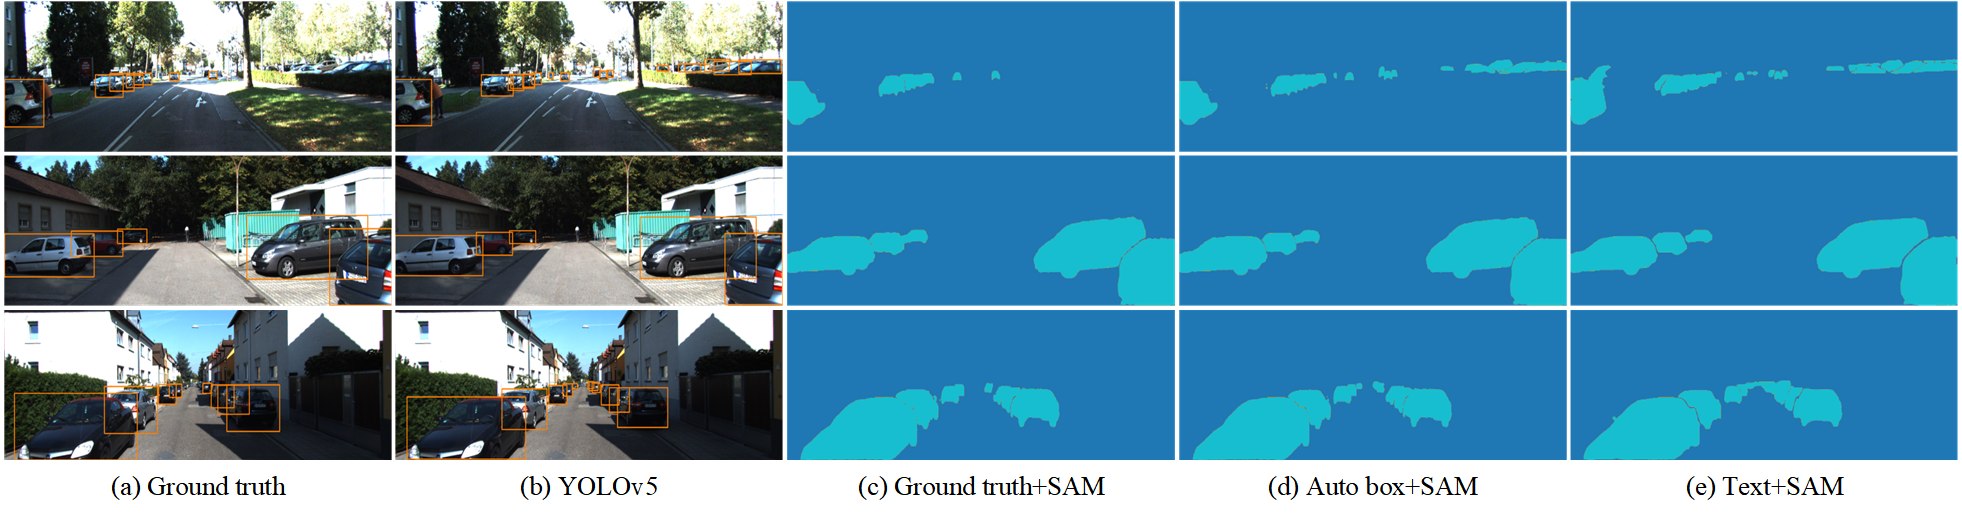
图11:SAM 伪掩码提示策略对比(GT / YOLOv5 / GT+SAM / Auto box+SAM / Text+SAM)
图 11:KITTI 源域上不同提示策略生成的伪掩码,(d) 自动框提示质量与 (c) GT 提示接近。
t-SNE(图 12):Source Only 源/目标特征完全分离 → SSDA-YOLO 开始混合仍有偏移 → JMT-YOLO 高度融合、边界模糊,域对齐能力最强。
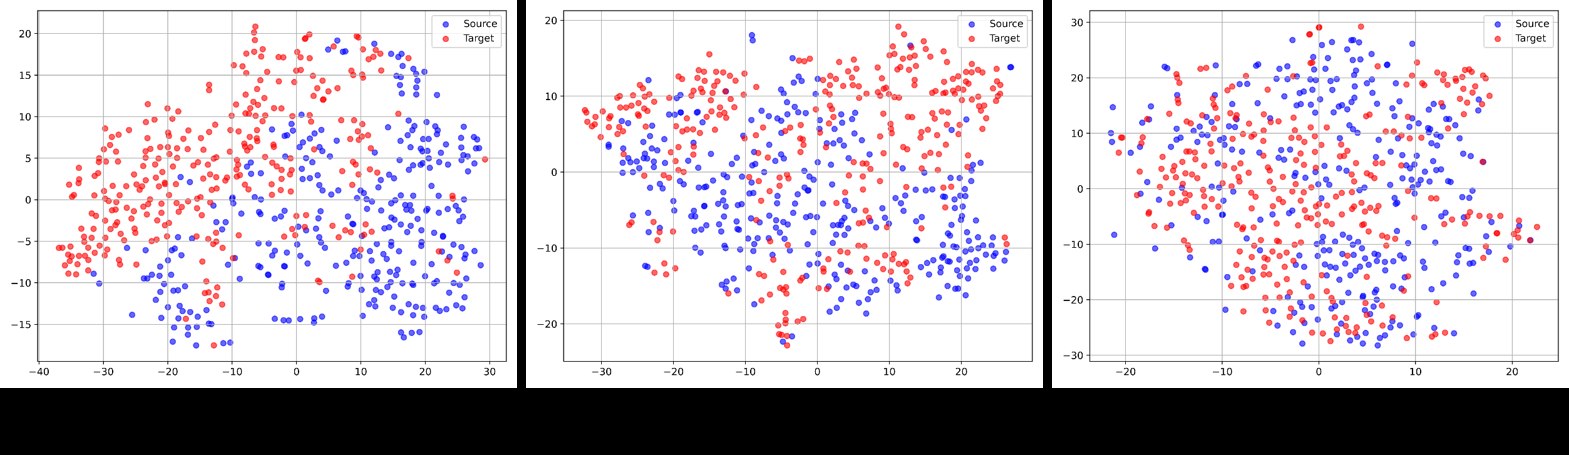
图12:t-SNE 特征分布对比:(a) Source Only 分离 (b) SSDA-YOLO 部分混合 (c) JMT-YOLO 高度融合
图 12:蓝=源域、红=目标域,融合度直观反映域对齐能力。
SAM 伪掩码消融(Table 5,KITTI→Cityscapes car):基线 59.6/29.8(mAP@0.5 / mAP@[.5:.95]),用 200 张 GT 掩码的部分监督升至 61.0/30.6——有限像素级监督即可引入有效结构约束。
六、展望
论文在消融里埋了几条未来线:掩码比与损失权重的精细调配、SAM 自动伪掩码在无 GT 框提示时的提示策略优化、以及噪声框提示下的鲁棒性验证,说明"用分割当结构监督"这条路还有很大挖潜空间。
延伸判断(非论文原文):
- 对 YOLO 玩家:DenseRFB 是挂在 Segment Head 下的即插即用模块,思路可平移到任何带辅助分支的 YOLO 变体——检测+分割双任务在域偏移场景下互为正则;
- 对工业落地:雾天驾驶、跨风格数据(艺术图/扫描件)这类"域沟大、标注贵"的场景是天然适用区,掩码机制零标注成本;
- 与既有工作的关系:它不卷检测头结构,而是卷训练范式(Mean Teacher + 掩码一致性 + 辅助分割),这条路线与 YOLO 系的"结构创新"互补,值得跟踪后续在更新架构(YOLO11/26)上的复现表现。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号