腾讯开源"全知视觉"模型 WeVisOne-VL:一个模型干翻 9 大 CV 任务,2B 参数吊打 9B 巨头
原创
腾讯开源"全知视觉"模型 WeVisOne-VL:一个模型干翻 9 大 CV 任务,2B 参数吊打 9B 巨头
原创
AI小怪兽
发布于 2026-11-04 09:15:06
发布于 2026-11-04 09:15:06
炸了!腾讯开源"全知视觉"模型 WeVisOne-VL:一个模型干翻 9 大 CV 任务,2B 参数吊打 9B 巨头
作者 | AI小怪兽(计算机视觉布道者 · 视觉检测领域创新者) 公众号「计算机视觉大作战」主理人 · 腾讯云年度影响力作者
博主简介
AI小怪兽 | 计算机视觉布道者 | 视觉检测领域创新者
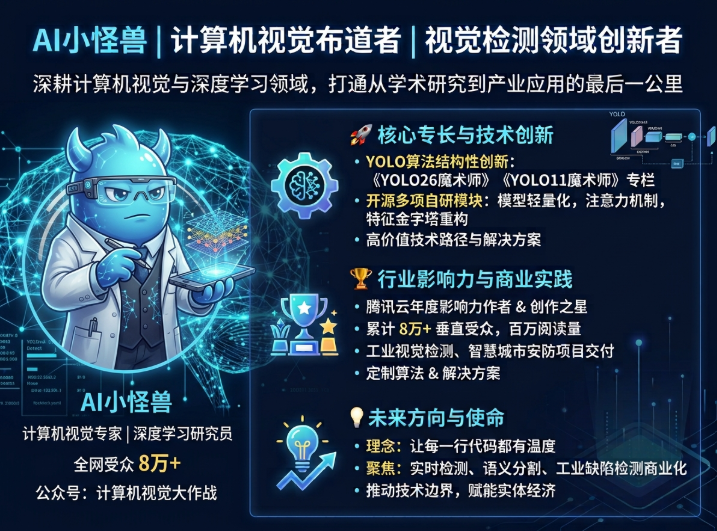
深耕计算机视觉与深度学习领域,专注于目标检测前沿技术的探索与突破。长期致力于YOLO系列算法的结构性创新、性能极限优化与工业级落地实践,旨在打通从学术研究到产业应用的最后一公里。
🚀 核心专长与技术创新
- YOLO算法结构性创新:于CSDN平台原创发布《YOLO26魔术师》、《YOLO11魔术师》等全系列深度专栏。系统性提出并开源了多项原创自研模块,在模型轻量化设计、多维度注意力机制融合、特征金字塔重构等关键方向完成了一系列突破性实践,为行业提供了具备高参考价值的技术路径与完整解决方案。
- 技术生态建设与知识传播:独立运营 “计算机视觉大作战” 公众号(粉丝2.3万),成功构建高质量的技术交流社群。致力于将复杂算法转化为通俗易懂的解读与可复现的工程代码,显著降低了计算机视觉的技术入门门槛。
🏆 行业影响力与商业实践
- 荣获腾讯云年度影响力作者与创作之星奖项,内容质量与专业性获行业权威平台认证。
- 全网累计拥有 8万+ 垂直领域技术受众,专栏文章总阅读量突破百万,在目标检测领域形成了广泛的学术与工业影响力。
- 具备丰富的企业级项目交付经验,曾为工业视觉检测、智慧城市安防等多个关键领域提供定制化的算法模型与解决方案,驱动业务智能化升级。
💡 未来方向与使命
秉持 “让每一行代码都有温度” 的技术理念,未来将持续聚焦于实时检测、语义分割及工业缺陷检测的商业化闭环等核心方向。愿与业界同仁协同创新,共同推动技术边界,以坚实的技术能力赋能实体经济与行业变革。
兄弟们,我又来给大家"递刀"了。
做目标检测的兄弟都知道一个痛点:检测归检测,分割归分割,抠图又是一套。工业现场往往是"YOLO 出框 → SAM 出掩码 → 再接一个 matting 模型抠图",三四个模型串成一条流水线,显存吃满、延迟拉爆、部署头秃。
而就在最近,腾讯默默甩出了一个"王炸"——WeVisOne-VL(WeChat Vision All-in-One)。
一句话总结它的野心:从"目标"到"像素",一个模型全包了。 检测、指代、计数、指点、OCR、分割、抠图——7 类任务、9 个 benchmark,它一个模型全干,而且在多数任务上把 8B~9B 的专用/通用大模型按在地上摩擦。
这篇文章,小怪兽带你从原理 → 技术创新 → 应用案例+性能对标三层扒干净。建议收藏,慢慢啃。
下面这张总览图,先感受一下它的"全知"能力👇
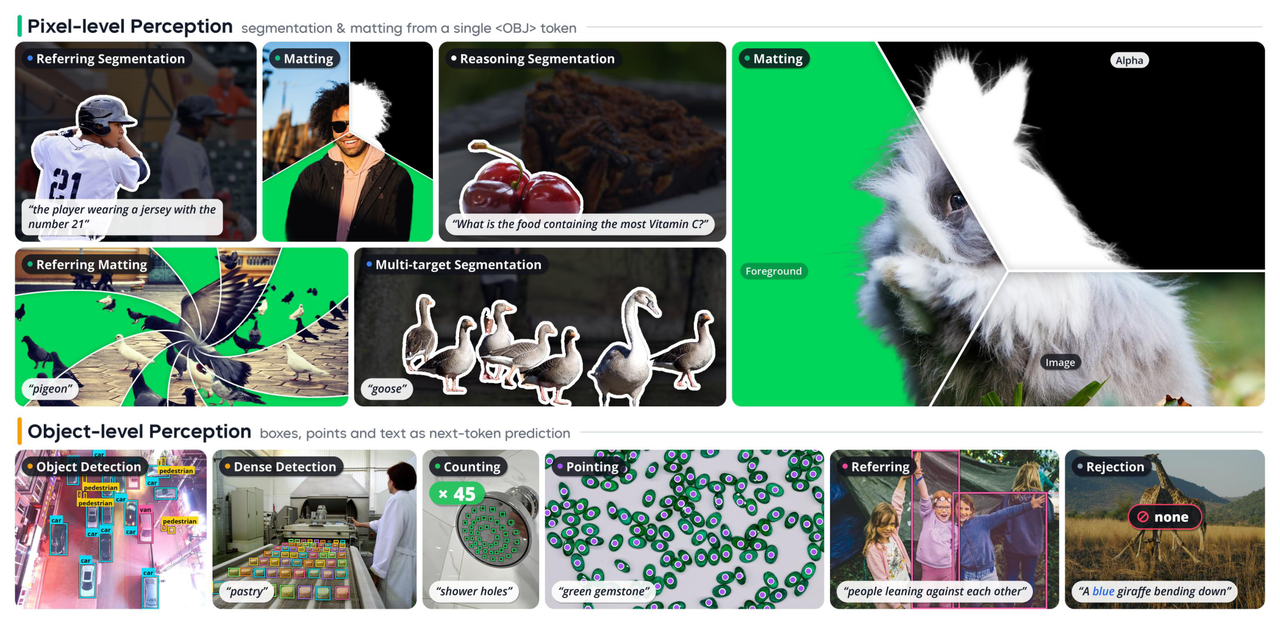
WeVisOne-VL 能力总览
核心源码:
# wevisone_vl_core.py
"""
WeVisOne-VL 核心架构骨架(基于公开资料整理)
核心思想:VLM 主干输出 <OBJ> token 的隐藏状态 → 像素解码器 → 实例级像素输出
"""

import torch
import torch.nn as nn
import torch.nn.functional as F

# ============================================================
# 0. 特殊 Token 定义
# ============================================================
OBJ_TOKEN_ID = 152678          # <OBJ> token ID
COORD_TOKEN_RANGE = (0, 1000)  # 坐标 token <0>...<1000> 表示归一化框/点


# ============================================================
# 1. Visual Feature Adapter
#    作用:将 Qwen3-VL 多层级 ViT 特征适配到解码器输入空间
# ============================================================
class VisualFeatureAdapter(nn.Module):
    """
    对 Qwen3-VL 多层级 ViT 特征进行投影/融合,
    输出统一通道数的视觉特征,供后续可变形注意力采样使用。
    """
    def __init__(self, in_channels_list, hidden_dim=256):
        super().__init__()
        self.proj_layers = nn.ModuleList([
            nn.Conv2d(in_c, hidden_dim, kernel_size=1)
            for in_c in in_channels_list
        ])
        self.fusion = nn.Sequential(
            nn.Conv2d(hidden_dim * len(in_channels_list), hidden_dim, 1),
            nn.GroupNorm(32, hidden_dim),
            nn.GELU(),
        )

    def forward(self, multi_level_feats):
        """
        multi_level_feats: List[Tensor],每个 Tensor 形状 (B, C_i, H_i, W_i)
        返回: (B, hidden_dim, H, W) 的统一特征图(以最高分辨率层为基准插值对齐)
        """
        target_size = multi_level_feats[0].shape[-2:]
        proj_feats = []
        for feat, proj in zip(multi_level_feats, self.proj_layers):
            x = proj(feat)
            if x.shape[-2:] != target_size:
                x = F.interpolate(x, size=target_size, mode="bilinear", align_corners=False)
            proj_feats.append(x)
        return self.fusion(torch.cat(proj_feats, dim=1))


# ============================================================
# 2. Box-Guided Query Decoder(核心)
#    6 层可变形交叉注意力,query 由 <OBJ> 隐藏状态初始化,
#    并结合 Fourier 编码的 box prior 进行空间引导
# ============================================================
class DeformableCrossAttentionBlock(nn.Module):
    """
    简化版可变形交叉注意力块。
    实际实现中应包含 offset / attention weight 预测分支与 grid_sample。
    此处保留核心结构语义,省略底层采样细节。
    """
    def __init__(self, dim=256, num_heads=8):
        super().__init__()
        self.self_attn = nn.MultiheadAttention(dim, num_heads, batch_first=True)
        self.cross_attn = nn.MultiheadAttention(dim, num_heads, batch_first=True)
        self.norm1 = nn.LayerNorm(dim)
        self.norm2 = nn.LayerNorm(dim)
        self.norm3 = nn.LayerNorm(dim)
        self.ffn = nn.Sequential(
            nn.Linear(dim, dim * 4),
            nn.GELU(),
            nn.Linear(dim * 4, dim),
        )

    def forward(self, query, visual_feat_flat, box_prior=None):
        """
        query: (B, N_q, dim)  —— N_q 为 <OBJ> 数量
        visual_feat_flat: (B, H*W, dim)
        box_prior: (B, N_q, dim) 或 None,Fourier 编码后的 box 先验
        """
        # 自注意力:让同一答案内的多个 <OBJ> 互相感知
        q = self.norm1(query)
        query = query + self.self_attn(q, q, q)[0]

        # 交叉注意力:query 从视觉特征中采样
        q = self.norm2(query)
        if box_prior is not None:
            q = q + box_prior
        query = query + self.cross_attn(q, visual_feat_flat, visual_feat_flat)[0]

        # FFN
        query = query + self.ffn(self.norm3(query))
        return query


class BoxGuidedQueryDecoder(nn.Module):
    def __init__(self, dim=256, num_layers=6, num_heads=8):
        super().__init__()
        self.layers = nn.ModuleList([
            DeformableCrossAttentionBlock(dim, num_heads)
            for _ in range(num_layers)
        ])
        self.box_prior_proj = nn.Linear(dim, dim)  # Fourier 编码 → 模型维度

    def forward(self, obj_hidden, visual_feat, boxes_fourier):
        """
        obj_hidden: (B, N_obj, D_vlm)  —— 来自 VLM 的 <OBJ> 隐藏状态
        visual_feat: (B, H*W, D)       —— Adapter 输出展平
        boxes_fourier: (B, N_obj, D)   —— 每个 <OBJ> 对应框的 Fourier 编码
        """
        query = obj_hidden
        box_prior = self.box_prior_proj(boxes_fourier)
        for layer in self.layers:
            query = layer(query, visual_feat, box_prior)
        return query


# ============================================================
# 3. Instance-Conditioned Dense Prediction Head
#    FullCanvasAlphaCascadeHead:在 S/4 → S/2 → S/1 上逐级细化
# ============================================================
class FullCanvasAlphaCascadeHead(nn.Module):
    """
    从解码后的实例 query 生成全分辨率 alpha matte / mask。
    级联结构:低分辨率粗预测 → 上采样 + 特征融合 → 高分辨率精修。
    """
    def __init__(self, dim=256, num_classes=1):
        super().__init__()
        # S/4 阶段
        self.stage_s4 = nn.Sequential(
            nn.Conv2d(dim, dim, 3, padding=1),
            nn.GroupNorm(32, dim),
            nn.GELU(),
            nn.Conv2d(dim, num_classes, 1),
        )
        # S/2 阶段:融合 S/4 上采样结果与图像特征
        self.stage_s2 = nn.Sequential(
            nn.Conv2d(dim + num_classes, dim, 3, padding=1),
            nn.GroupNorm(32, dim),
            nn.GELU(),
            nn.Conv2d(dim, num_classes, 1),
        )
        # S/1 阶段
        self.stage_s1 = nn.Sequential(
            nn.Conv2d(dim + num_classes, dim, 3, padding=1),
            nn.GroupNorm(32, dim),
            nn.GELU(),
            nn.Conv2d(dim, num_classes, 1),
        )

    def forward(self, instance_feat, image_feat_pyramid):
        """
        instance_feat: (B*N, dim, H/4, W/4) —— 解码器 query 重塑为空间形式
        image_feat_pyramid: Dict[str, Tensor],包含 "s4", "s2", "s1" 的图像特征
        """
        # S/4
        pred_s4 = self.stage_s4(instance_feat)

        # S/2:上采样 S/4 预测 + 融合
        pred_s4_up = F.interpolate(pred_s4, scale_factor=2, mode="bilinear", align_corners=False)
        feat_s2 = torch.cat([image_feat_pyramid["s2"], pred_s4_up], dim=1)
        pred_s2 = self.stage_s2(feat_s2)

        # S/1:再上采样 + 融合,输出全分辨率
        pred_s2_up = F.interpolate(pred_s2, scale_factor=2, mode="bilinear", align_corners=False)
        feat_s1 = torch.cat([image_feat_pyramid["s1"], pred_s2_up], dim=1)
        pred_s1 = self.stage_s1(feat_s1)

        return pred_s1  # (B*N, 1, H, W),stride 1


# ============================================================
# 4. 完整像素解码器:组合以上三个模块
# ============================================================
class WeVisOneMaskDecoder(nn.Module):
    """
    约 9.6M 参数的核心解码器(实际参数量取决于各层通道配置)。
    输入:VLM 的 <OBJ> 隐藏状态 + 多级 ViT 特征 + 框的 Fourier 编码
    输出:每个 <OBJ> 对应的全分辨率 alpha matte / mask
    """
    def __init__(self, vlm_dim, vit_channels_list, hidden_dim=256, num_queries_per_obj=1):
        super().__init__()
        self.num_queries_per_obj = num_queries_per_obj

        # <OBJ> 隐藏状态投影到解码器维度
        self.obj_proj = nn.Linear(vlm_dim, hidden_dim)

        # 1) 视觉特征适配器
        self.visual_adapter = VisualFeatureAdapter(vit_channels_list, hidden_dim)

        # 2) 框引导的 Query 解码器(6 层)
        self.query_decoder = BoxGuidedQueryDecoder(hidden_dim, num_layers=6)

        # 3) 实例条件密集预测头(级联)
        self.dense_head = FullCanvasAlphaCascadeHead(hidden_dim)

        # 将解码后的 query 重塑为空间特征的小型卷积
        self.query_to_spatial = nn.Sequential(
            nn.Linear(hidden_dim, hidden_dim * 4 * 4),
            nn.GELU(),
        )

    def forward(self, obj_hidden_states, multi_level_vit_feats, boxes, image_feat_pyramid):
        """
        obj_hidden_states: (B, N_obj, D_vlm)  —— 从 VLM 中提取的 <OBJ> 最后层隐藏状态
        multi_level_vit_feats: List[Tensor]  —— Qwen3-VL 多层级 pre-merging ViT 特征
        boxes: (B, N_obj, 4)  —— 归一化 xyxy
        image_feat_pyramid: Dict[str, Tensor]  —— "s4", "s2", "s1" 分辨率特征,用于级联头融合
        """
        B, N_obj, _ = obj_hidden_states.shape

        # 1) 视觉特征适配
        visual_feat = self.visual_adapter(multi_level_vit_feats)   # (B, C, H, W)
        Bv, Cv, Hv, Wv = visual_feat.shape
        visual_feat_flat = visual_feat.flatten(2).transpose(1, 2)  # (B, H*W, C)

        # 2) <OBJ> 隐藏状态投影
        query = self.obj_proj(obj_hidden_states)                   # (B, N_obj, hidden_dim)

        # 3) 框的 Fourier 编码
        boxes_fourier = fourier_encode_boxes(boxes)                # (B, N_obj, D_fourier)
        # 实际中 D_fourier 可能与 hidden_dim 不同,此处假设已对齐或通过 proj 处理

        # 4) 框引导的 Query 解码(6 层可变形交叉注意力)
        decoded_queries = self.query_decoder(query, visual_feat_flat, boxes_fourier)

        # 5) 将每个 <OBJ> 的 query 重塑为 4×4 的空间特征图
        spatial_feat = self.query_to_spatial(decoded_queries)      # (B, N_obj, C*16)
        spatial_feat = spatial_feat.view(B * N_obj, -1, 4, 4)      # (B*N, C, 4, 4)
        # 上采样到 S/4 尺度,与视觉特征图对齐
        spatial_feat = F.interpolate(spatial_feat, size=(Hv, Wv), mode="bilinear", align_corners=False)

        # 6) 级联密集预测头:输出全分辨率 alpha matte
        masks = self.dense_head(spatial_feat, image_feat_pyramid)  # (B*N, 1, H, W)

        return masks.view(B, N_obj, *masks.shape[1:])


def fourier_encode_boxes(boxes, num_bands=32):
    """
    对归一化框 (xyxy) 做 Fourier 特征编码,作为解码器的空间先验。
    简化实现:对 4 个坐标分别做 sin/cos 多频编码后拼接。
    """
    # boxes: (B, N, 4)
    B, N, _ = boxes.shape
    freqs = 2.0 ** torch.arange(num_bands, device=boxes.device).float() * torch.pi
    coords = boxes.unsqueeze(-1)                       # (B, N, 4, 1)
    encoded = torch.cat([torch.sin(coords * freqs), torch.cos(coords * freqs)], dim=-1)
    return encoded.view(B, N, -1)                      # (B, N, 4 * num_bands * 2)


# ============================================================
# 5. 与 VLM 主干的衔接(示意)
# ============================================================
def extract_obj_hidden_states(vlm_outputs, input_ids):
    """
    从 Qwen3-VL 的输出中提取所有 <OBJ> token 位置的隐藏状态。
    vlm_outputs.last_hidden_state: (B, L, D_vlm)
    """
    obj_positions = (input_ids == OBJ_TOKEN_ID)        # (B, L)
    # 实际实现需处理 batch 内不同数量的 <OBJ>,此处假设可 gather 出 (B, N_obj, D)
    obj_hidden = vlm_outputs.last_hidden_state[obj_positions].view(
        input_ids.shape[0], -1, vlm_outputs.last_hidden_state.shape[-1]
    )
    return obj_hidden
一、原理:它不是"又一个小模型",而是"范式升级"
WeVisOne-VL 是一个视觉-语言基础模型(VLM)。要读懂它的巧思,得先抓住一个根本转变:传统 CV 把"看"拆成一个个独立工程问题——检测归检测、分割归分割,每个任务训一个专用网络、输出一种固定结构(框 / 掩码 / 点)。而 WeVisOne-VL 反其道而行,把所有视觉感知任务都当成"生成文本"来解决。
一句话核心——用"结构化 next-token prediction(下一个 token 预测)"统一一切视觉感知任务,再配一个仅 9.6M 参数的轻量像素解码器输出掩码和 Alpha 抠图。
拆开讲更清楚:
- "生成文本"怎么做感知? 大模型最擅长的事,就是根据上下文一个 token 一个 token 地"续写"。WeVisOne-VL 把"图里有什么、在哪儿"也变成一串可生成的 token 序列——用
<0>~<1000>的坐标 token 表示框和点,用<OBJ>token 标记"接下来要出像素"。它本质上不是在跑卷积回归,而是在"写字",只是写出来的字恰好是物体的位置与形状。 - 重活儿交给谁? 视觉理解(看懂图里是什么、语义为何)由底层的 Qwen3-VL ViT 骨干完成,它已在海量图文对上预训练,常识与泛化能力是现成的,不必从零训。
- 像素级输出靠什么? 关键就在那个仅 9.6M 的轻量像素解码器——它不重新"看图",而是直接拿 ViT 的多层特征 +
<OBJ>token 的隐状态 + 预测框,一键"解码"出全分辨率掩码或 Alpha Matte。9.6M 是什么概念? 相对动辄几百 M、上 B 的专用分割 / 抠图模型,它轻到几乎可以忽略,却补齐了"从目标到像素"的最后一环。
所以叫它"范式升级"毫不夸张:过去是"一任务一模型",现在是"一套生成逻辑通吃所有粒度"——从点、框,到二值掩码、连续 Alpha Matte,全在一个模型里闭环完成。
它具体靠三件事落地,我们一个个拆:
1️⃣ 数据引擎:1 亿+ 图像的暴力美学
由知识图谱驱动发现概念,用多个互补的专家模型定位目标、由 VLM 校验,再把校验过的框"扩展"为掩码和 Alpha Matte。整套流程标注了超过 1 亿张图像——这是它能泛化到开放词汇的根本底气。
💡 原理点拨:这是一套由易到难、逐级精化的课程式流水线——先让专家模型把最易标的"框"打准,再让 VLM 当"质检员"滤掉噪声,最后才把框"长大"成掩码和 Alpha Matte。规模(1 亿+)与质量(多专家 + VLM 校验)同时拿捏,才撑起了后面统一模型的泛化底气。
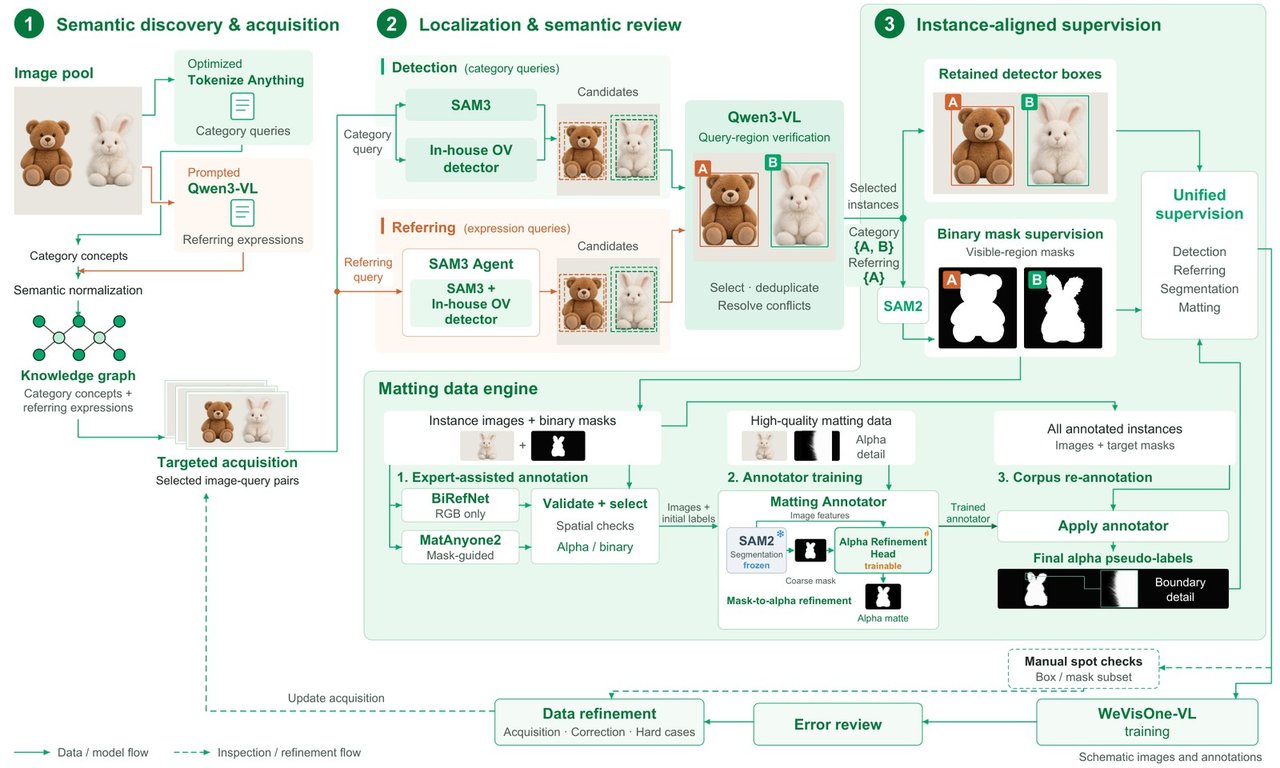
WeVisOne-VL 数据引擎 WDE 总览
2️⃣ 统一任务格式:所有任务都写成"结构化文本"
这是最妙的工程巧思:
- 框和点 → 用坐标 token
<0>…<1000>表示; - 目标不存在 → 直接输出
None(而不是瞎编); - 像素级任务 → 在每个框后输出一个
<OBJ>token。
所有任务都被翻译成同一种"语言",模型学的是一套统一逻辑,不是 nine 套各做各的 head。
💡 原理点拨:正因为所有任务都塌缩成"同一个 next-token 目标",模型只需学一套统一的表征,而非为每个任务单独接一个 head。
None和<OBJ>也不是后加的补丁,而是被当成一等公民的 token——前者让"拒识"成为模型天生能力,后者让像素输出自然衔接到目标级结果之后。
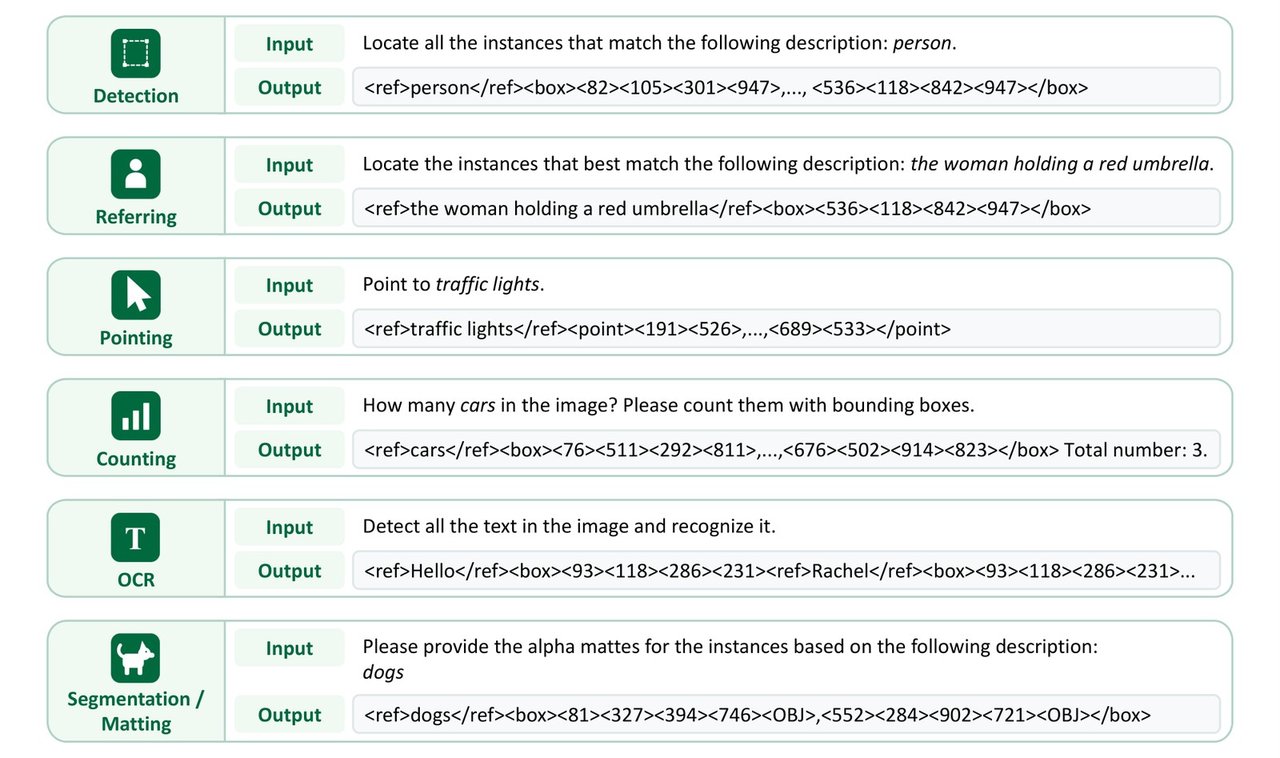
统一任务格式输入输出示例
3️⃣ 模型架构:9.6M 像素解码器"点石成金"
这个 9.6M 的解码器,会结合:① <OBJ> token 的隐状态、② 对应的预测框、③ Qwen3-VL ViT 的多层特征,直接预测全分辨率的掩码或 Alpha Matte。
💡 原理点拨:三个输入各司其职——
<OBJ>隐状态携带"这是哪个物体"的语义,预测框提供空间位置先验,ViT 多层特征补足细粒度纹理。三者一融合,解码器根本不需要重新编码整张图,于是 9.6M 这样的"小身板"也能产出高质量掩码与发丝级 Alpha Matte。
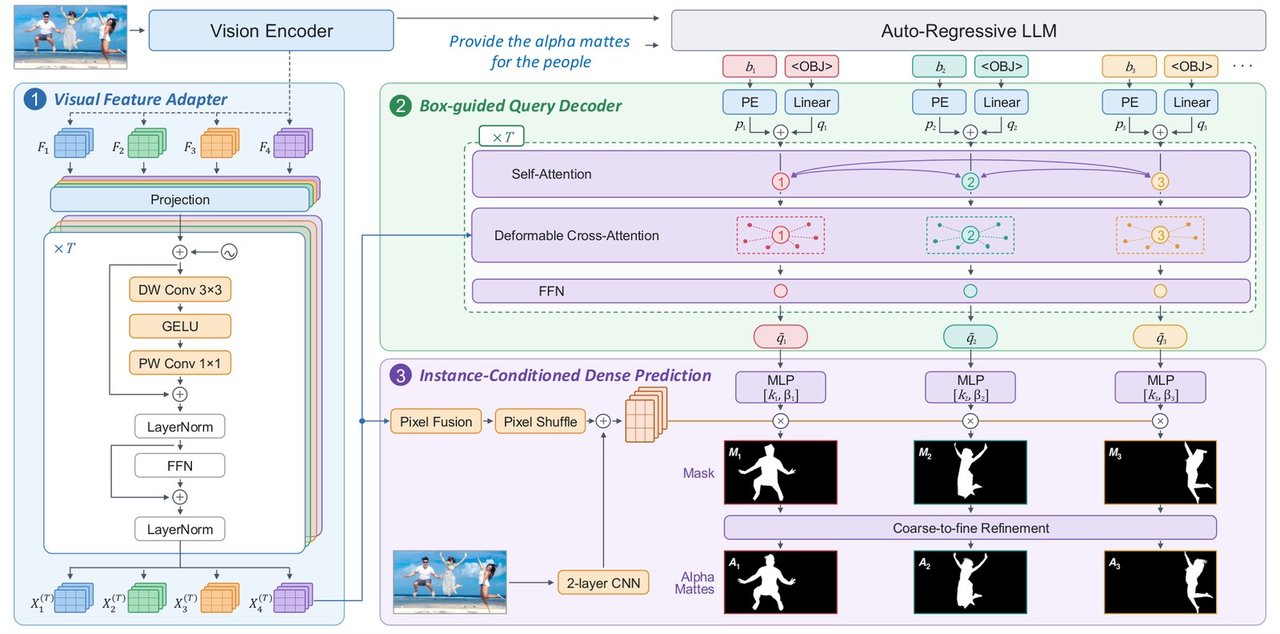
轻量像素解码器架构
小怪兽划重点:它不需要 SAM。 一个 9.6M 的轻量头,就替代了过去"检测+SAM+Matting"的流水线。这对工业部署意味着什么?意味着显存和延迟直接砍掉一大截。
二、技术创新点:三个"反常识"的突破
✨ 创新点 1:All-in-One,真·一个模型通吃
检测、指代、计数、指点、OCR、分割、抠图——过去要 5~7 个模型干的事,现在一个 WeVisOne-VL 全包。用户还能任意指定粒度:从"点"到"框"到"二值掩码"到"连续 Alpha Matte",一句话切换。
🪶 创新点 2:9.6M 像素解码器,轻到离谱
专用分割/抠图模型动辄几百 M 甚至上 B 参数。WeVisOne-VL 只用一个 9.6M 的解码器就输出掩码和 Alpha Matte,无需 SAM、无需额外大模型。这是把"精度"和"轻量"同时拿捏的硬核设计。
下面这组官方抠图 Demo,直观感受"输入图 → 预测的 Alpha Matte → 抠图结果"的一体化输出:
输入图 | 预测的 Alpha Matte | 抠图结果 |
|---|---|---|
query="person",一个模型直接输出发丝级 Alpha Matte,无需任何额外抠图模型。
🚫 创新点 3:可靠拒识,告别"幻觉"
这是小怪兽最想吹的一点。当查询目标不存在时,它返回 None,而不是硬凑一个框。在 WeRef-Bench 拒识率上达到 96.4%,而最强基线仅 73.0%。在安防、质检这类"漏检比误检更致命"的工业场景,这个能力值千金。
三、应用案例 + 性能对标(重点,数据来自官方)
WeVisOne-VL 提供 2B 和 4B 两个版本。下面直接上官方 benchmark——4B 版本在 9 个任务上全部击败最强开源基线(基线含 9B 以内的 Qwen3-VL / Qwen3.5、Rex-Omni、LocateAnything,以及专用分割/抠图模型)。
🏆 性能速览(WeVisOne-VL-4B vs 最强基线)
任务 | Benchmark | 指标 | 最强基线 | WeVisOne-VL-4B |
|---|---|---|---|---|
📦 目标检测 | LVIS | F1 Mean ↑ | 50.7 | 55.3 |
📦 密集检测 | Dense200 | F1 Mean ↑ | 58.7 | 71.3 |
💬 指代检测 | RefCOCOg test | F1 Mean ↑ | 77.6 | 81.8 |
🚫 拒识 | WeRef-Bench | 拒识率 ↑ | 73.0 | 96.4 |
🔢 计数 | PixMo-Count test | Acc ↑ | 82.8 | 89.6 |
📍 指点 | PointBench | Acc ↑ | 69.9 | 71.9 |
🔤 OCR | TotalText | F1 Mean ↑ | 43.3 | 52.0 |
🎭 指代分割 | ReasonSeg val | gIoU ↑ | 65.0 | 71.2 |
✂️ 框提示抠图 | P3M-500-NP | MAD ↓ | 15.4 | 7.3 |
✂️ 文本提示抠图 | WeRefMat | MAD ↓ | 22.4 | 9.8 |
注意:MAD 是越低越好(↓),其余指标越高越好(↑)。
📦 目标检测(F1 Mean)——2B 就反杀一众大模型
方法 | COCO | LVIS | Dense200 | VisDrone |
|---|---|---|---|---|
Qwen3-VL-8B | 47.8 | 42.9 | 13.8 | 29.5 |
Rex-Omni-3B | 52.9 | 46.9 | 58.3 | 35.8 |
LocateAnything-3B | 54.7 | 50.7 | 58.7 | 39.9 |
WeVisOne-VL-2B | 55.2 | 53.3 | 61.4 | 40.4 |
WeVisOne-VL-4B | 57.1 | 55.3 | 71.3 | 44.7 |
看懂没?2B 参数已经干翻 8B 的 Qwen3-VL 和 3B 的专用模型,4B 在密集检测 Dense200 上把基线从 58.7 拉到 71.3——断层式领先。
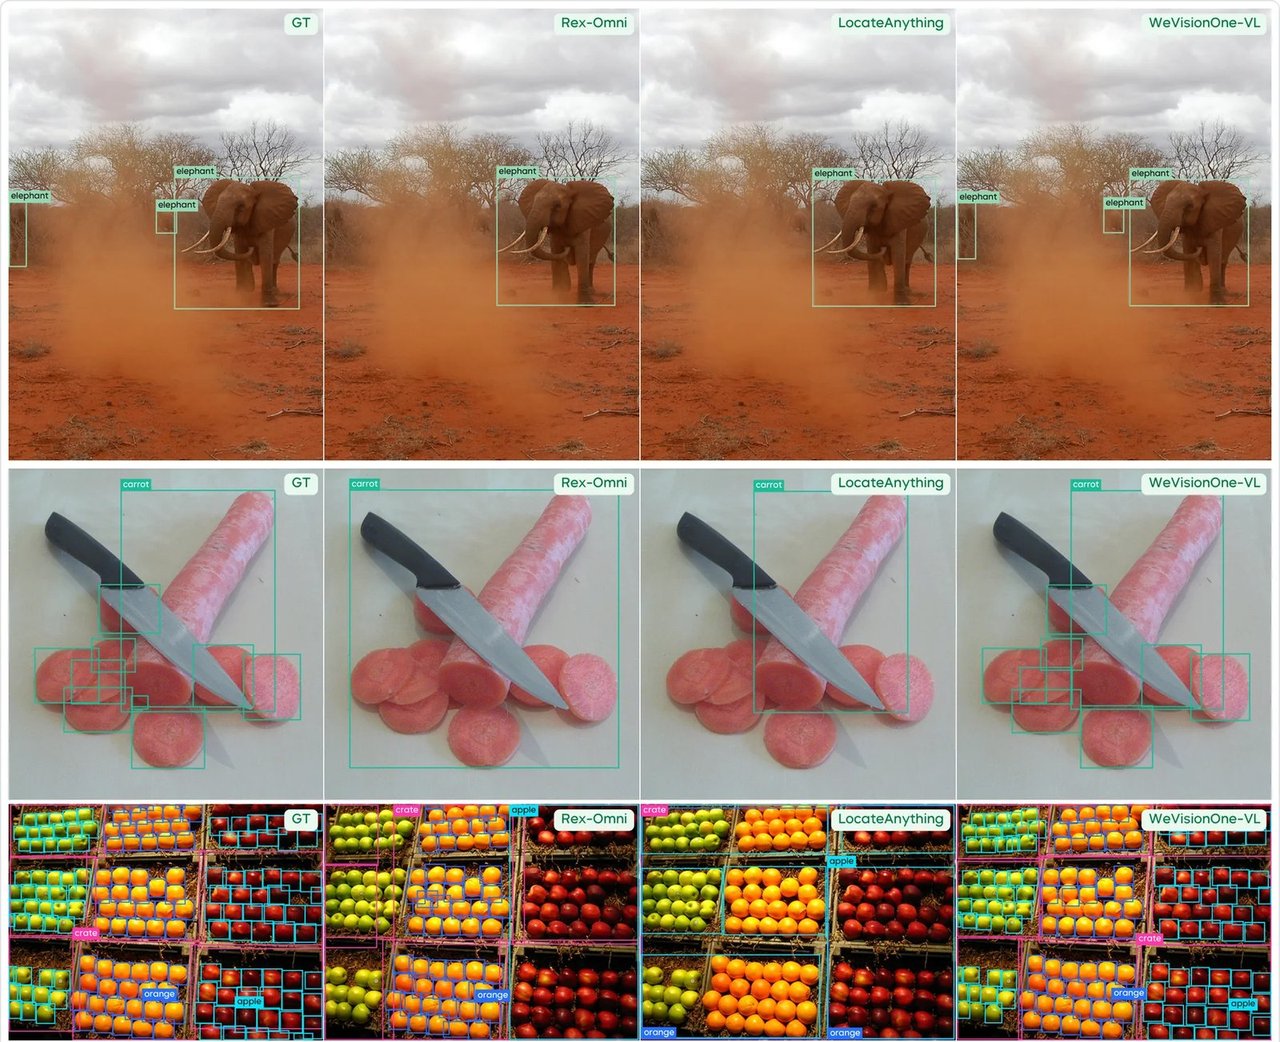
目标检测定性对比
💬 指代检测(RefCOCOg / WeRef-Bench)——还能"拒绝瞎编"
方法 | RefCOCOg test | RefCOCOg Rej | WeRef Mean | WeRef Rej |
|---|---|---|---|---|
Qwen3.5-9B | 74.6 | 15.2 | 50.7 | 70.7 |
Rex-Omni-3B | 74.3 | 0.5 | 50.3 | 43.3 |
LocateAnything-3B | 77.6 | 0.6 | 51.7 | 73.0 |
WeVisOne-VL-2B | 78.2 | 50.2 | 73.2 | 92.9 |
WeVisOne-VL-4B | 81.8 | 67.4 | 78.7 | 96.4 |
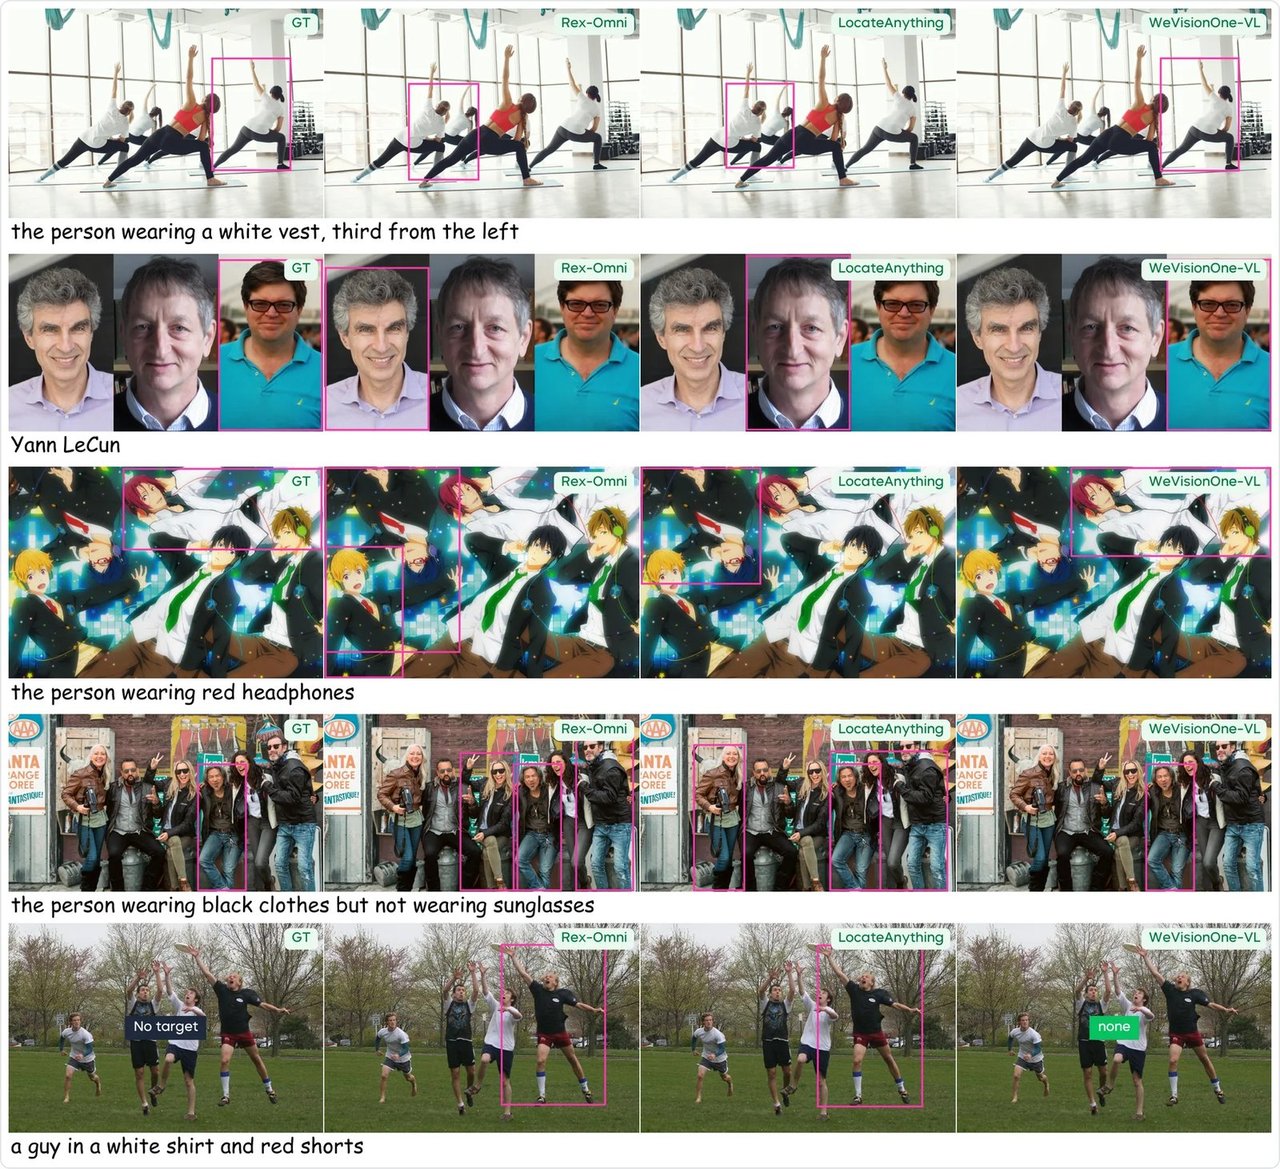
指代检测定性对比
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号