PageSift 1.2:给爬虫加了一个「被拦之后怎么办」的引擎
原创
PageSift 1.2:给爬虫加了一个「被拦之后怎么办」的引擎
原创
用户12863179
发布于 2026-11-07 10:28:16
发布于 2026-11-07 10:28:16
我的开源项目 PageSift 更新到 1.2 了。
从最初追求极限性能的 Rust 爬虫,到现在支持网页采集、文档解析、结构化提取和 AI Agent,我又给它加了一个新引擎。
项目地址:https://github.com/YOLOW92/pagesift
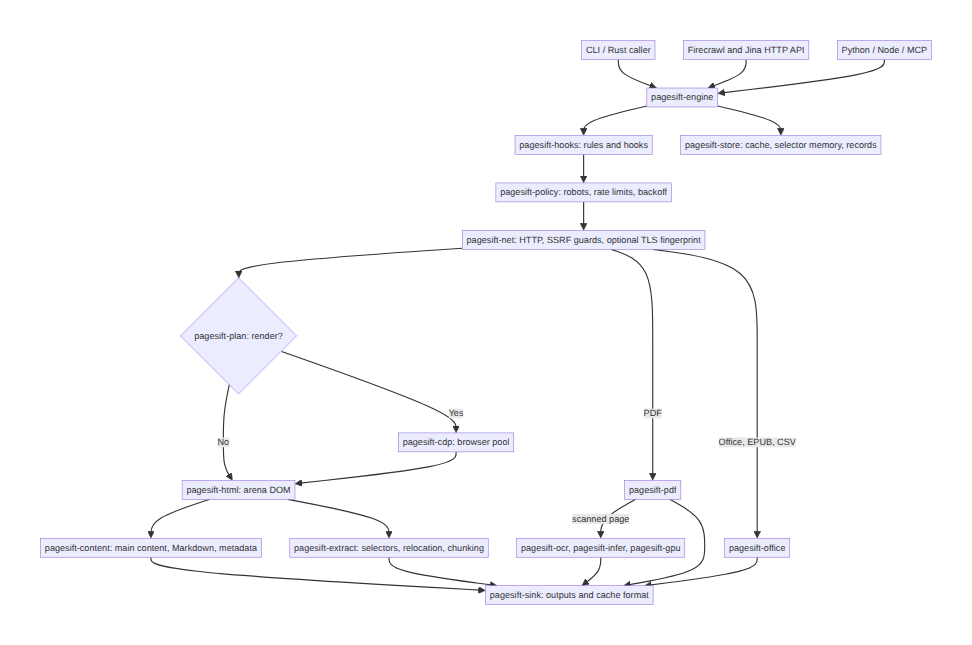
1.2:全新 ITNA 访问障碍恢复引擎
- HTTP 请求遭遇拦截时,智能判断是否升级浏览器重试
- TLS/HTTP2 浏览器指纹支持 HTTP、HTTPS、SOCKS5 代理
- Session 身份池:Cookie、出口、指纹关联管理,隔离不同用户
- HTTP → Browser 安全交接会话状态
- 优化浏览器自动化标记,支持等待非交互式 JS 挑战
- 共享请求预算,限制重试次数、超时与资源消耗
默认关闭,按需启用。不会破解交互式验证码,也不保证绕过所有风控。
顺带补上 1.1:文档解析与多语言生态大扩张
之前没来得及分享的 1.1 系列也一起说说:
新增大量文件格式:旧版 Office、ODF、WordPerfect、电子书、邮件、压缩包、数据库等。
支持识别 373 种源码语言,并为多种主流语言提取函数、类等结构。
新增 Go、Java、C#、Ruby、PHP、Lua、Swift、Zig 等语言绑定,以及 LangChain、LlamaIndex 集成。
1.1 实测数据
- PDF 转 Markdown:2.4ms/页
- HTML 转 Markdown:0.24ms/页
- 正文提取:1.0ms/页
- Office 解析:91.7 文件/秒,约为 xberg 的 3.40 倍
1.1.1~1.1.3:继续死磕 Rust 底层
自己实现了纯 Rust Zstandard 压缩/解压:FSE、Huffman、LZ 匹配、缓存感知哈希链,全部自己写。
写在最后
目前已经突破 200 Stars,整个项目仍然由我一个人独立开发维护。
我想做的不只是一个快爬虫,而是一套真正高性能、低资源开销、可自托管的 AI 数据基础设施。
项目完全开源,GitHub 搜索 YOLOW92 / PageSift 就能找到。欢迎大家测试、提 Issue,也欢迎技术交流!
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号