电商图片生成服务的可观测性:日志、失败率与告警怎么设计
原创

把 AI 作图接进业务流程之后,会很快遇到一个问题:出图变慢了,或者失败了,但不知道卡在哪。
界面上的「生成中」转圈让人无从下手。这篇写这类服务该怎么设计可观测性。
一、先定义什么叫「失败」
图像生成的失败跟普通接口不一样,它有四层。
请求失败:网络、鉴权、限流,请求根本没到生成环节。
任务失败:任务提交成功,但执行阶段报错,比如内容审核不通过、参数不合规。
结果不可用:任务成功返回了图,但图糊了、主体变形了、尺寸不对。技术上成功,业务上失败。
体验失败:图没问题,但耗时太长,用户等不下去就走了。
前两层能靠日志抓到,第三层要靠业务侧反馈,第四层要看端到端的耗时分布。
大多数团队只监控前两层,所以总感觉「监控指标很好,用户还在抱怨」。
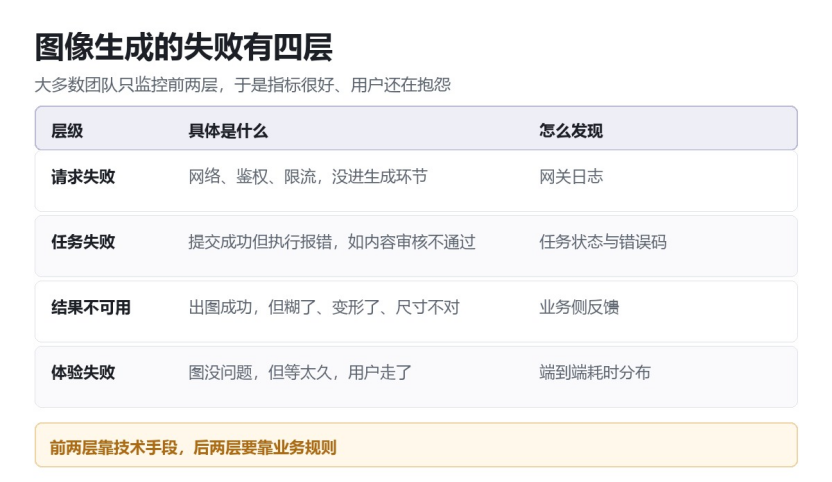
示意图:图像生成的失败分四层,前两层靠日志,后两层靠业务规则(本文绘制)
二、日志要记什么
一条任务日志,建议包含这些字段:
任务 ID、调用方标识、模型标识、参数摘要(尺寸、比例、质量选项)、提交时间、开始执行时间、完成时间、状态、失败原因码、结果地址、调用量。
三个细节值得强调。
参数摘要而不是全量参数。 提示词文本可能很长,存全量会让日志表膨胀。建议存哈希加前若干字符。
失败原因要归一化。 上游返回的错误五花八门,要映射成有限的枚举值,否则没法统计。
记录调用量。 这是核对产出的基础,缺了它,月底算不清账。
三、指标怎么设
四组核心指标。
成功率:按模型、按调用方、按任务类型分别统计。只看全局成功率会掩盖单点问题。
耗时分布:不是看平均值,看 P50 和 P95。生成类任务的分布很偏,平均值没有意义。
队列深度:排队中的任务数。这个指标比耗时更早预警,深度一涨,说明产能跟不上。
不可用率:业务侧标记为「不可用」的比例。这个需要人工或规则反馈,是最接近真实体验的指标。
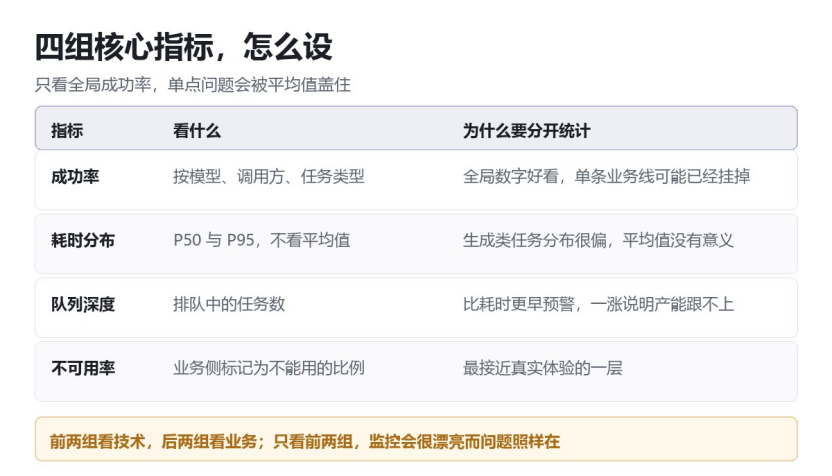
示意图:四组核心指标,成功率要按模型与调用方分开统计(本文绘制)
四、告警阈值怎么定
不要用固定数值,用变化率。
成功率下降:对比最近一小时和过去七天的同一时段,下降超过一定幅度就告警。生成类服务受上游影响大,固定阈值容易误报。
耗时上移:P95 连续三个采集周期高于基线,就告警。单次抖动不用管。
队列深度持续增长:连续十分钟只增不减,说明消费能力出问题了。
单模型失败集中:如果某个模型的失败率明显高于其他模型,多半是上游问题,这时候自动降级到备用模型比告警更有效。
五、三个常见故障模式
限流雪崩。 撞限流之后,重试策略把请求又推上去,越重试越糟。解法是退避加抖动,并且给重试设总量上限。
单模型依赖。 所有任务都走一个模型,上游一抖动,全线停摆。解法是准备备用模型,并在参数上做成可切换的。多模型平台在这一层省事:以 Flux Art 为例,50+ 图像与视频模型在同一个账号里,换模型只改一个参数,代码不用动。
素材引发的连锁失败。 一张格式异常的大图上传失败,客户端反复重试,把队列堵住。解法是提交前做素材校验,不合规的直接拒绝,不进队列。
六、给业务侧看什么
技术人员看指标,业务人员只想看三件事:今天做了多少张、有多少不能用、卡在谁那里。
所以建议单独做一个业务看板:按商品维度列出任务状态,失败的标红并给出原因,可用的直接给链接。Flux Art 的任务记录本身就是按任务一条条列的,业务侧看到的是同一份清单,省掉一次转述。
这个看板的价值是减少沟通。业务方不用来问「我的图好了吗」,自己看就行。
七、产出效率的两个指标
单张可用消耗:总生成量除以可用图片数。这个指标比「单张平均」真实,因为它把失败和重试都算进去了。
白跑率:被丢弃的结果占总生成量的比例。这个比例高,说明提示词模板或者验收标准有问题。
我见过白跑率到四成的场景,排查下来是模板里的场景描述和商品不匹配,导致生成的图全都不对。这种问题不靠指标发现,只能靠人翻。
八、小结
可观测性不是加几个监控面板,是先想清楚「什么叫失败」。
四层失败里,前两层靠技术手段,后两层要靠业务规则。只做前两层,监控会很漂亮,问题照样存在。
最后一条建议:把业务侧的「这张图不能用」也做成一个可上报的动作。这条数据比任何技术指标都接近真相。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号