Prometheus 是一个功能强大、灵活且扩展性强的开源可观测平台,提供了多维数据模型、丰富的采集能力,以及强大的查询语言。作为 CNCF(Cloud Native Computing Foundation)旗下最重要的开源项目之一,Prometheus 在云原生时代被广泛使用,构建了繁荣的开源生态。特别是在指标(Metric)监控领域,Prometheus 已经成为了事实的标准。
腾讯云应用性能监控(APM)已实现与 Prometheus 的数据集成:对于通过 OpenTelemetry 方案接入 APM 的应用,可以通过自定义配置将特定的指标同步到腾讯云 Prometheus 监控服务,用户无需自行部署 OpenTelemetry Collector 进行中转。
前置准备
1. 应用已通过 OpenTelemetry 方案接入 APM,具体接入方式请参考 应用接入概述。
2. 已创建与 APM 业务系统同地域的 Prometheus 监控服务实例,并具备访问权限,具体操作方式请参考 Prometheus 监控服务。
操作步骤
步骤1:关联 Prometheus 实例
在应用上报自定义指标之前,需要先建立 APM 业务系统和 Prometheus 实例之间的关联,并配置需要从 APM 服务端同步到 Prometheus 实例的指标。
1. 登录 APM 控制台,进入 系统配置 > Prometheus 集成 页面。
2. 在关联配置中,开启 Prometheus 关联,并选择当前地域的任何一个 Prometheus 实例。每个 APM 业务系统只能关联同一地域最多一个 Prometheus 实例。在当前账号第一次做关联操作的时候,需要授予 APM 访问 Prometheus 资源的权限,根据控制台的提示完成服务授权即可,系统会在访问管理(CAM)中自动创建名为
APM_QCSLinkedRoleInPromInstance 的角色。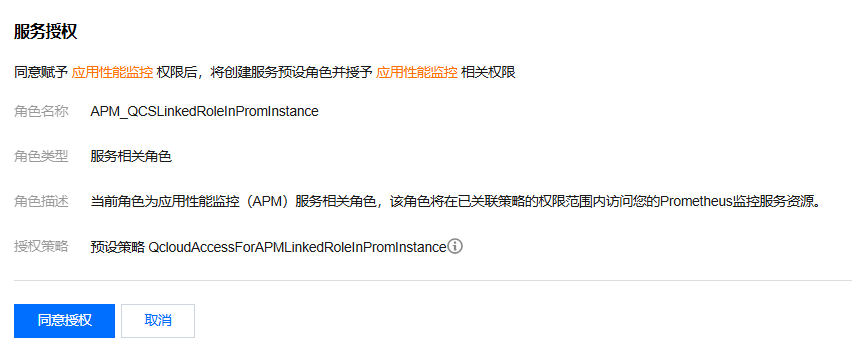
3. 单击新增指标同步规则,指定需要同步到 Prometheus 实例的指标。
对于每一条同步规则,您可以基于精确匹配、前缀匹配以及后缀匹配这三种匹配方式来匹配指标名,也可以指定该规则的生效范围(可以是该业务系统的全部应用,或某一个具体的应用)。当 APM 服务端收到应用上报的自定义指标后,匹配同步规则的指标将被写入到关联的 Prometheus 实例中,不匹配同步规则的指标将被丢弃。
说明:
步骤2:应用接入
步骤3:通过 Grafana 查阅指标
说明:
APM 同步到 Prometheus 的指标,统计粒度为 1 分钟:每条时间序列每分钟写入一个样本,样本值为该分钟内的统计结果。
APM 固有指标的 PromQL 查询实践
对于数据类型为 Sum 和 Histogram 指标, 整个 APM 体系都使用 Delta 聚合时间性。同步到 Prometheus 后,每个样本表示一个统计周期内的增量,而不是从进程启动以来的累计值。因此,
rate()、increase() 等面向 Cumulative 聚合时间性的常规 PromQL 写法不适用于这些指标。以基础性能指标中的请求数量、累计耗时,和耗时分布为例,当指标同步到 Prometheus 后,对应的数据类型和含义如下表所示:
指标名称 | APM 中的指标类型 | 同步到 Prometheus 之后的指标类型 | 每个样本的含义 |
service_request_count | Sum | Gauge | 一个统计周期内的请求数 |
service_duration_total | Sum | Gauge | 一个统计周期内的请求耗时总和 |
service_range_count_duration_bucket service_range_count_duration_count service_range_count_duration_sum | Histogram | Histogram(Delta 语义) | 一个统计周期内耗时小于等于 le 的请求数分布 |
这和常规的 Prometheus 指标存在语义上的差别,以请求数量为例:
时间 | 10:01 | 10:02 | 10:03 |
常规 Prometheus Counter 指标(累计值) | 100 | 220 | 300 |
从 APM 同步到 Prometheus 的指标(增量) | 100 | 120 | 80 |
对于 Histogram,同一时刻的各个
le 桶仍遵循 Prometheus 的“小于等于”语义;但在时间维度上,每个桶的值都只代表当前统计周期内的增量。核心原则
对于数据类型为 Sum 和 Histogram 指标, 按照如下顺序编写 PromQL:
1. 先用
sum_over_time() 在时间维度累加增量。2. 再用
sum by (...) 跨序列聚合。3. 最后计算比值或分位数。
常用查询示例
请求数量:统计最近5分钟各服务的请求数。
sum by (apm_service_name) (sum_over_time(service_request_count[5m]))
QPS:最近5分钟各服务的平均 QPS。
sum by (apm_service_name) (sum_over_time(service_request_count[5m])) / 300
说明:
不要使用
avg_over_time(service_request_count[5m]) / 60。如果某些周期没有请求且没有产生样本,avg_over_time() 只会对有样本的周期求平均,从而高估 QPS。平均耗时:最近5分钟各服务的平均耗时。
sum by (apm_service_name) (sum_over_time(service_duration_total[5m]))/sum by (apm_service_name) (sum_over_time(service_request_count[5m]))
分位数:最近5分钟各服务的 P99 耗时分位数。
histogram_quantile(0.99,sum by (apm_service_name, le) (sum_over_time(service_range_count_duration_bucket[5m])))
在 Grafana 中使用
场景 | 推荐写法 |
查询时间范围内的总请求量 | sum(sum_over_time(service_request_count[$__range])),并使用 Instant 查询 |
每个统计周期的请求量趋势 | sum(sum_over_time(service_request_count[$__interval])),并将面板的 Min interval 设为 60s |
QPS 趋势 | sum(sum_over_time(service_request_count[$__interval])) / ($__interval_ms / 1000) |
趋势图的窗口应不小于统计周期,并尽量与查询步长保持一致。若窗口小于统计周期,部分时间点可能取不到样本;若窗口大于步长,相邻数据点会包含重叠周期,曲线更平滑,但不代表单个周期的值。
常见错误写法
错误写法 | 问题 | 正确思路 |
rate(service_request_count[5m]) | 将增量当作累计值,计算出的是增量值的变化率 | sum_over_time(...) / 窗口秒数 |
increase(service_request_count[5m]) | 计算的是增量值之间的差,不是请求总数 | sum_over_time(service_request_count[5m]) |
sum(service_request_count) | 每条序列只取最近一个样本,只能反映某个周期;回溯期内还可能混入已停止上报序列的旧样本 | 明确时间窗口,使用 sum_over_time() |
avg(service_duration_total / service_request_count) | 各序列权重相同,结果不是真正的平均耗时 | 先分别求和,再相除 |
histogram_quantile(0.99, rate(..._bucket[5m])) | 将桶的增量当作累计值处理 | 使用 sum_over_time(..._bucket[5m]) |
sum by (apm_service_name) (...bucket...) 后计算分位数 | 丢失 le 标签,无法计算分位数 | 在 by 中保留 le |
对多个服务的 P99 求平均值 | 分位数不能直接平均 | 先合并桶数据,再计算分位数 |
其他注意事项
查询窗口应为统计周期的整数倍。 APM 同步到 Prometheus 的指标,统计粒度为 1 分钟,可以使用
[1m]、[5m]、[1h]。注意窗口边界。 Prometheus 2.x 的范围选择器包含左右两端,样本时间戳恰好落在边界时可能多计一个周期;Prometheus 3.x 改为左开右闭。如数据需要精确对账,请先确认 Prometheus 版本和样本时间戳。
最新周期可能尚未同步完成。 用于告警时,可使用
offset 1m 等方式避开最近一个周期,减少数据不完整导致的误报。高频查询可沉淀为 Recording Rule。 例如,预先计算
sum by (apm_service_name) (sum_over_time(service_request_count[1m])),供大盘和告警复用。速查表
目标 | PromQL 模板 |
请求量 | sum by (...) (sum_over_time(service_request_count[W])) |
QPS | sum by (...) (sum_over_time(service_request_count[W])) / W 的秒数 |
平均耗时 | sum by (...) (sum_over_time(service_duration_total[W])) / sum by (...) (sum_over_time(service_request_count[W])) |
分位数 | histogram_quantile(φ, sum by (..., le) (sum_over_time(service_range_count_duration_bucket[W]))) |


