支持引擎类型
标准 Spark 引擎
环境准备
依赖:JDK 1.8
JDBC 下载:点击下载 hive-jdbc-3.1.2-standalone.jar
连接标准 Spark 引擎
创建服务访问链接
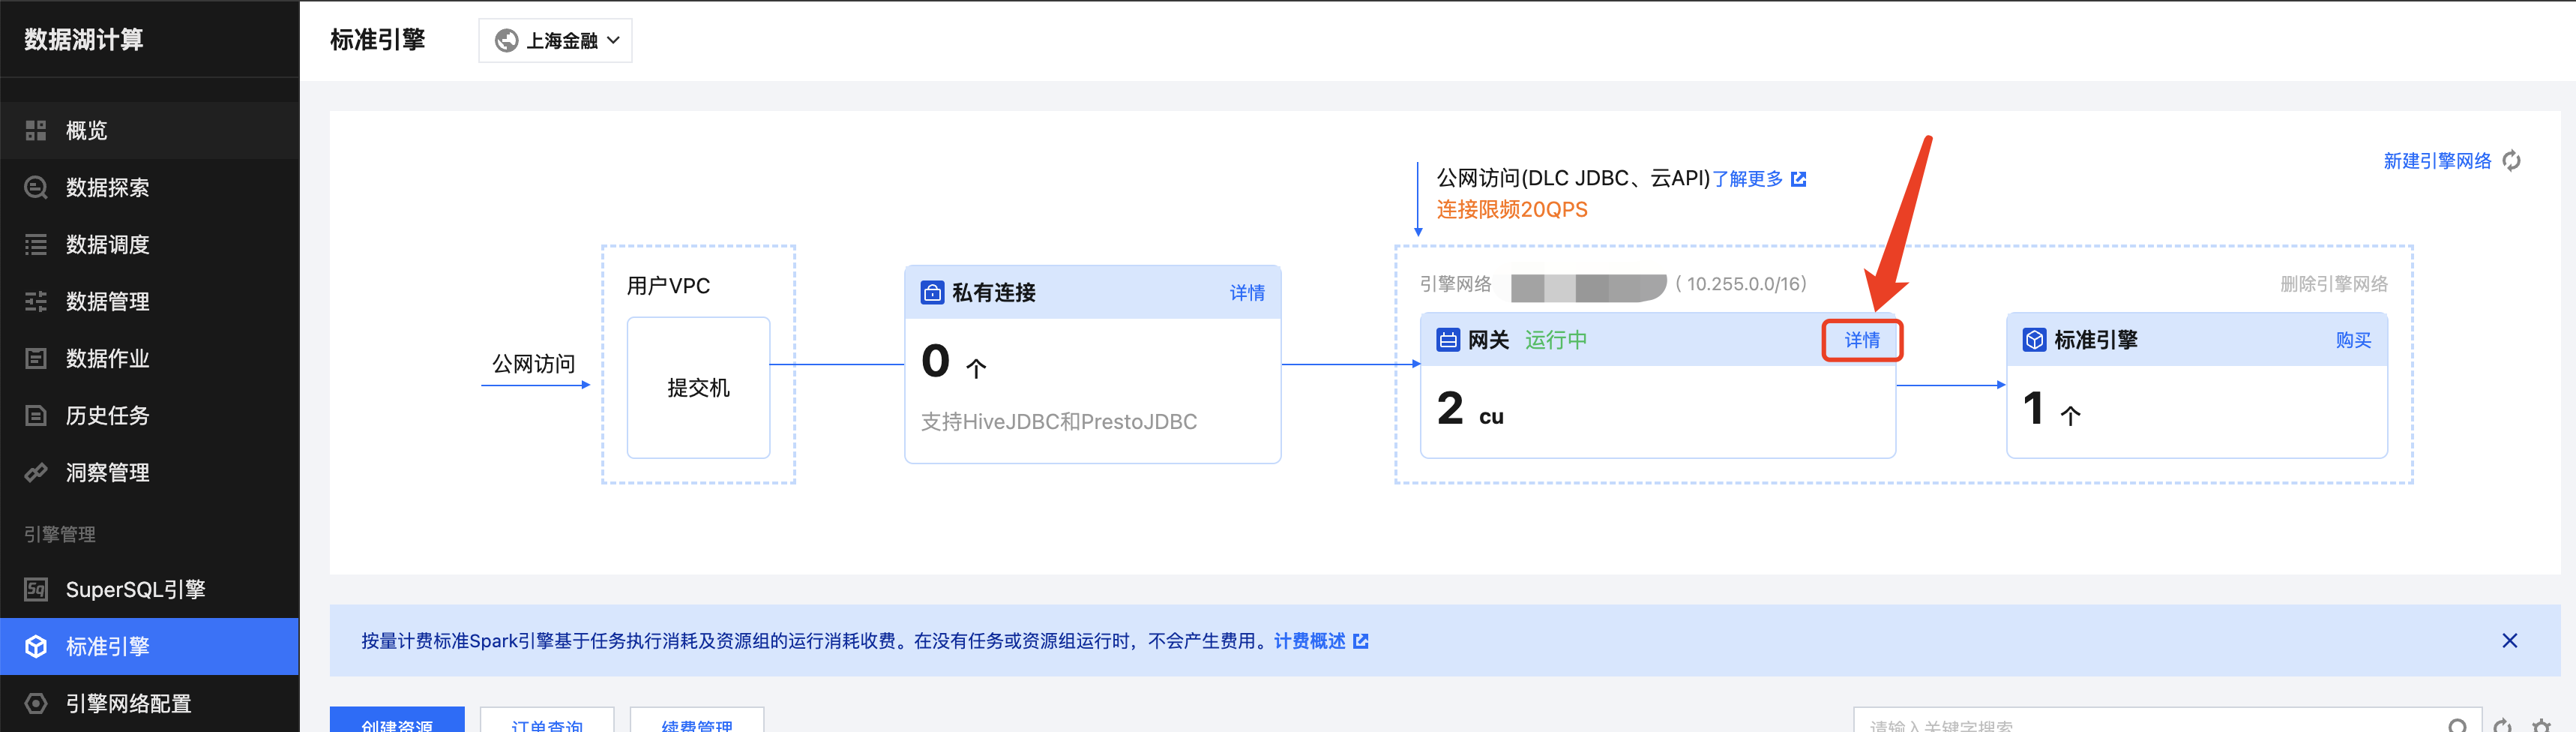
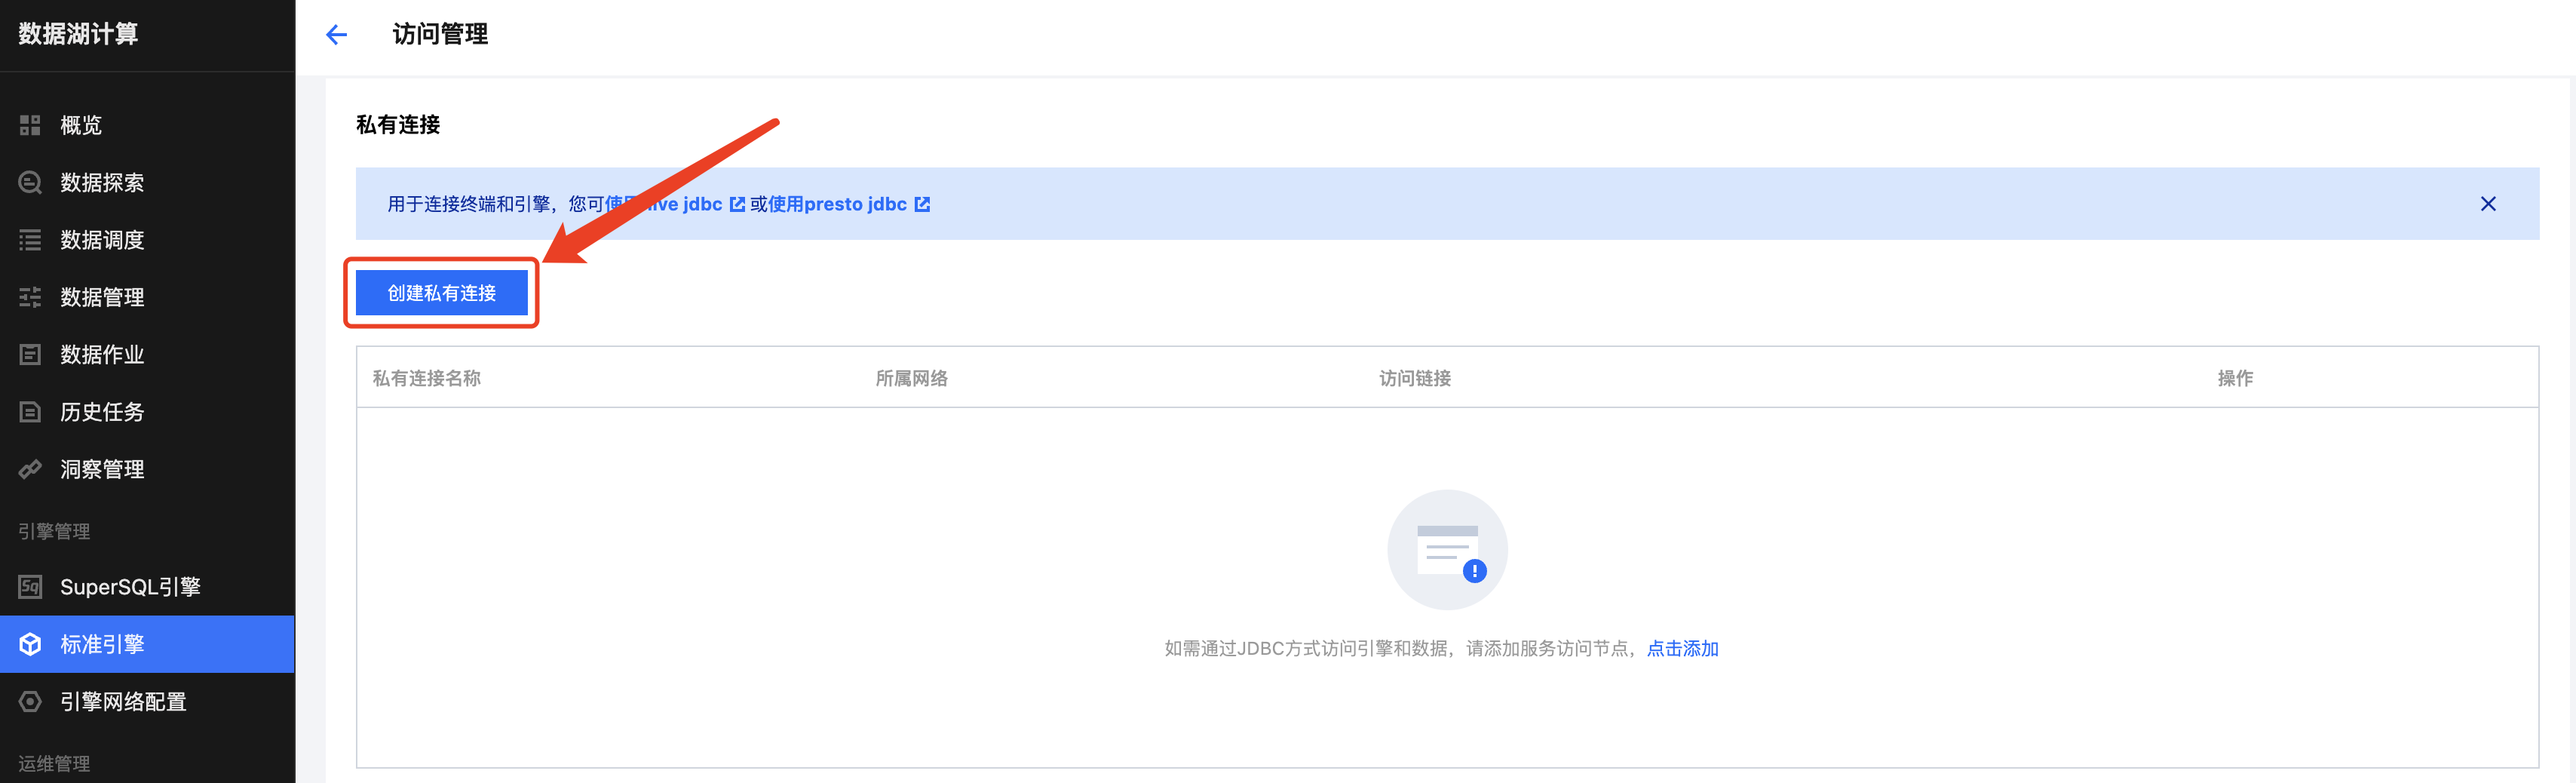
点击创建私有连接,选择提交机所在的 VPC 和子网,单击创建后生成两个访问链接,分别为 Hive2 和 Presto 协议,链接标准 Spark 引擎使用 Hive2 协议,如下图所示。
注意:
创建私有连接会打通引擎网络和所选 VPC 之间的网络。提交机可以是所选 VPC 下任意可以登录使用的服务器,仅用于任务提交使用。如果所选的 VPC 下没有提交机,可以新建一个服务器作为提交机。
jdbc:hive2://{endpoint}:10009/?spark.engine={DataEngineName};spark.resourcegroup={ResourceGroupName};secretkey={SecretKey};secretid={SecretId};region={Region};kyuubi.engine.type=SPARK_SQL;kyuubi.engine.share.level=ENGINE
加载 JDBC 驱动
Class.forName("org.apache.hive.jdbc.HiveDriver");
通过 DriverManager 创建 Connection
jdbc:hive2://{endpoint}:10009/?spark.engine={DataEngineName};spark.resourcegroup={ResourceGroupName};secretkey={SecretKey};secretid={SecretId};region={Region};kyuubi.engine.type=SPARK_SQL;kyuubi.engine.share.level=ENGINEProperties properties = new Properties();properties.setProperty("user", {AppId});Connection cnct = DriverManager.getConnection(url, properties);
JDBC 连接串参数说明
参数 | 必填 | 说明 |
spark.engine | 是 | 标准 Spark 引擎名称 |
spark.resourcegroup | 否 | 标准 Spark 引擎资源组名称,不指定则创建临时资源 |
secretkey | 是 | 腾讯云 API 密钥管理中的 SecretKey |
secretid | 是 | 腾讯云 API 密钥管理中的 SecretId |
region | 是 | 地域,目前 DLC 服务支持 ap-nanjing, ap-beijing, ap-beijing-fsi, ap-guangzhou,ap-shanghai, ap-chengdu,ap-chongqing, na-siliconvalley, ap-singapore, ap-hongkong, na-ashburn, eu-frankfurt, ap-shanghai-fsi |
kyuubi.engine.type | 是 | 固定填:SPARK_SQL |
kyuubi.engine.share.level | 是 | 固定填:ENGINE |
user | 是 | 用户 APPID |
数据查询完整示例
import org.apache.hive.jdbc.HiveStatement;import java.sql.*;import java.util.Properties;public class TestStandardSpark {public static void main(String[] args) throws SQLException {try {Class.forName("org.apache.hive.jdbc.HiveDriver");} catch (ClassNotFoundException e) {e.printStackTrace();return;}String url = "jdbc:hive2://{endpoint}:10009/?spark.engine={DataEngineName};spark.resourcegroup={ResourceGroupName};secretkey={SecretKey};secretid={SecretId};region={Region};kyuubi.engine.type=SPARK_SQL;kyuubi.engine.share.level=ENGINE";Properties properties = new Properties();properties.setProperty("user", {AppId});Connection connection = DriverManager.getConnection(url, properties);HiveStatement statement = (HiveStatement) connection.createStatement();String sql = "SELECT * FROM dlc_test LIMIT 100";statement.execute(sql);ResultSet rs = statement.getResultSet();while (rs.next()) {System.out.println(rs.getInt(1) + ":" + rs.getString(2));}rs.close();statement.close();connection.close();}}
编译完成后,您可以将 jar 包提交到提交机上执行。
通过临时密钥连接标准 Spark 引擎
步骤 1:申请临时密钥
返回信息 | 说明 |
TmpSecretId | 临时 SecretId |
TmpSecretKey | 临时 SecretKey |
Token | 临时 Token |
步骤 2:创建私有连接
1. 登录 DLC 控制台,点击进入目标引擎网关详情页;
2. 单击创建私有连接,选择提交机所在的 VPC 和子网,单击创建后生成两个访问链接,分别为 Hive2 和 Presto 协议,链接标准 Spark 引擎使用 Hive2 协议。
注意:
创建私有连接会打通引擎网络和所选 VPC 之间的网络。提交机可以是所选 VPC 下任意可以登录使用的服务器,仅用于任务提交使用。如果所选的 VPC 下没有提交机,可以新建一个服务器作为提交机。
3. 在私有网络 > 终端节点 页面确认终端节点状态为 可用。
步骤3:连接引擎并查询
认证规则定义:
user :引擎名称&资源组名称&TAKSK,以 & 拼接。
password:TmpSecretId&TmpSecretKey&Token,以 & 拼接。
连接方式一:JAVA Demo
1. 安装 JDK8。
yum install -y java-1.8.0-openjdk-devel
2. 下载 JDBC 驱动,连接见 环境准备。
curl -sL -o hive-jdbc-3.1.2-standalone.jar \\https://repo1.maven.org/maven2/org/apache/hive/hive-jdbc/3.1.2/hive-jdbc-3.1.2-standalone.jar
3. 创建 Demo 文件,示例命名为 DlcHiveJdbcTokenDemo.java。
import java.sql.Connection;import java.sql.DriverManager;import java.sql.ResultSet;import java.sql.Statement;public class DlcHiveJdbcTokenDemo {public static void main(String[] args) throws Exception {Class.forName("org.apache.hive.jdbc.HiveDriver");String url = "jdbc:hive2://xxxxxxx/default"; // 改为对应的 endpointString user = "引擎名&t资源组名&TAKSK"; // 改为对应的引擎名&资源组名&TAKSKString password = "AKIDxxxxxxxx"+ "&xxxxxxxx"+ "&xxxxxxxx"; // 改为 TmpSecretId&TmpSecretKey&TokenConnection connection = DriverManager.getConnection(url, user, password);System.out.println("连接成功");Statement statement = connection.createStatement();ResultSet rs = statement.executeQuery("select 1"); //待运行的任务命令while (rs.next()) {System.out.println("查询结果: " + rs.getString(1));}rs.close();statement.close();connection.close();}}
4. 编辑代码并运行。
javac -cp .:hive-jdbc-3.1.2-standalone.jar DlcHiveJdbcTokenDemo.javajava -cp .:hive-jdbc-3.1.2-standalone.jar DlcHiveJdbcTokenDemo
连接方式二:beeline 命令行
1. 安装 JDK8,并下载 Hive 与 Hadoop(beeline 依赖 Hadoop 环境)。
yum install -y java-1.8.0-openjdk-develcurl -sL -o /opt/hive.tar.gz https://mirrors.huaweicloud.com/apache/hive/hive-3.1.2/apache-hive-3.1.2-bin.tar.gzcurl -sL -o /opt/hadoop.tar.gz https://mirrors.huaweicloud.com/apache/hadoop/common/hadoop-3.1.4/hadoop-3.1.4.tar.gzcd /opt && tar -xzf hive.tar.gz && mv apache-hive-3.1.2-bin hive && tar -xzf hadoop.tar.gz && mv hadoop-3.1.4 hadoop
2. 配置环境变量。
echo 'export JAVA_HOME=$(dirname $(dirname $(readlink -f $(which java))))' >> ~/.bashrcecho 'export HADOOP_HOME=/opt/hadoop' >> ~/.bashrcecho 'export PATH=$PATH:/opt/hive/bin' >> ~/.bashrcsource ~/.bashrc
3. 连接引擎。
# -u: JDBC 连接串,endpoint 改为你的 Hive2 地址# -n: 引擎名&资源组名&TAKSK# -p: TmpSecretId&TmpSecretKey&Tokenbeeline \\-u "jdbc:hive2://xxxxxxxx/default" \\-n "引擎名&t资源组名&TAKSK" \\-p "<TmpSecretId>&<TmpSecretKey>&<Token>"
4. 出现`Connected to: Spark SQL` 和 `0: jdbc:hive2://...>` 提示符即连接成功,之后直接在命令行输入 SQL,例如:
select 1;


