代码执行、自动化评测和强化学习中的批量任务采样(RL Rollout)经常需要批量创建运行环境。本文比较同一节点上启动 50、100、150 个 Pod 的耗时,并展示 AGC 优化对批量启动等待时间的影响,帮助您评估任务开始前需要准备多久。
本次测试使用 BusyBox 运行简单命令,比较 runc、Cube 模板恢复、Cube 冷启动和 Kata 社区版冷启动。测试未执行模型调用或真实 Agent 任务,Pod 就绪时间不等于业务可用时间。
测试环境与方法
测试日期为2026年10月15日。测试在同一目标节点上依次切换运行时及启动方式,各组使用相同的业务镜像、启动命令和业务容器资源配置。运行时自身需要的额外预留资源见后文。
项目 | 本次配置 |
目标节点 | 64 核 CPU、128 GiB 内存,使用 TencentOS Server 4(TS4)及 PVM 虚拟化支持。 |
工作负载 | 使用轻量 Linux 工具镜像 BusyBox 1.36.1,执行 sleep 3600 保持容器运行;不配置初始化容器、存储卷或健康检查,也不挂载 Kubernetes 服务账号令牌。 |
业务容器资源 | 每个容器 request 为 100m CPU / 1Mi,limit 为 2 CPU / 128Mi。 |
镜像准备 | 提前将镜像下载到节点;本地已有镜像时直接使用( IfNotPresent),不计首次下载时间。 |
批次 | 每轮创建 50、100 或 150 个 Pod;每种规模、每条测试路径各测 1 轮。Cube 模板恢复未开启 AGC 优化的对照组也各测 1 轮。 |
测试工具 | 使用项目中的 pod-perf 批量提交创建请求并记录启动时间。目标提交速率为每秒 1000 次请求,最多 150 个并发提交任务,超时 300 秒;全部就绪后继续观察 10 秒。工具分配 8 核 CPU、4 GiB 内存。 |
每轮完成条件 | 全部 Pod 达到 Ready=True,发生器检查结果为 accepted=true,无容器重启和 Ready 回退;同时保留沙箱创建失败事件数量。 |
节点软件 | cgroup v1;kubelet v1.34.1-tke.8,150 Pod 组标记为 v1.34.1-tke.8-six-gates;containerd v1.7.28-tke.3。 |
Cube 运行制品 | CubeContainer 提交 c894757d15c;CubeSandbox 提交 bfb91c5ef64。 |
Guest 内核 | 虚拟机均使用 release 配置构建的 6.6.117 PVM Guest 内核。 |
调度方式 | 由 Kubernetes 默认调度器调度到同一目标节点,通过 runtimeClassName 切换运行时。 |
Cube 启动方式 | 使用 agc.cloud.tencent.com/cube-template-mode: auto 测试模板恢复,使用 cold 测试显式冷启动。 |
工具最多并发提交 150 个创建请求,实际启动还需经过调度和节点处理,并非所有沙箱同时开始启动。
单 Pod 启动耗时:从发生器发出该 Pod 的创建请求,到首次观察到其
Ready=True,包括 API 请求处理、调度、kubelet、运行时及状态回传。整批就绪时间:从发生器开始提交本轮创建请求,到观察到整批 Pod 全部就绪。
分位数采用 nearest-rank 方法。本次每组仅测一轮,表中数据为该轮结果,不是多轮测试的中位数。
测试说明
本文结果仅供性能评估参考,不作为服务级别协议(SLA)或固定性能承诺。启动耗时会受到机型、地域、可用区、网络、软件版本和节点负载等因素影响,实际表现请以业务所在环境的测试结果为准。
本次已提前拉取镜像,未包含工作区挂载、依赖安装、模型加载和外部服务调用。测试未配置应用健康检查,因此 Pod 达到 Ready 不表示真实 Agent 已完成初始化或能够处理业务任务。
Cube 模板恢复的数据来自成功复用已准备模板的测试。新节点或规格变化后,可能需要从头初始化沙箱,即冷启动。
本次每种规模、每条路径各测一轮,尚不能据此描述多轮波动范围。零失败、零重启也只反映本次测试期间的情况。用于容量规划前,应在目标环境多轮复测,保留超时、慢请求和失败记录。
整批就绪时间
下表展示 runc、Kata 的基准结果,以及 Cube 开启 AGC 优化后的整批就绪时间,单位为秒。数值越小表示等待时间越短;跨运行时结果反映各自测试配置组合的表现。
启动方式 | 50 个 Pod 全部就绪 | 100 个 Pod 全部就绪 | 150 个 Pod 全部就绪 |
runc | 2.260 秒 | 4.119 秒 | 5.659 秒 |
Cube 模板恢复(开启 AGC 优化) | 1.100 秒 | 1.926 秒 | 2.844 秒 |
Cube 冷启动(开启 AGC 优化) | 1.565 秒 | 2.828 秒 | 4.232 秒 |
Kata 3.32.0 社区版冷启动 | 2.994 秒 | 4.960 秒 | 6.911 秒 |
与本次 runc 基准相比,开启 AGC 优化的 Cube 模板恢复在 50、100、150 Pod 三种规模下,整批就绪耗时分别降低约 51.3%、53.2%、49.7%。其中,150 Pod 规模下节省 2.815 秒。这些降幅反映运行时、启动方式及 AGC 优化共同作用后的配置组合差异。
耗时降低比例按以下方式计算:
(对照组耗时 − Cube 模板恢复耗时)÷ 对照组耗时 × 100%需要等待整批环境就绪后再执行的任务,可以重点参考这一指标。能够逐个开始的任务,还应结合单 Pod 延迟和真实任务耗时评估。上述比例不能直接换算成业务吞吐量或成本收益。
95% 的 Pod 在多久内就绪(P95)
下表与整批就绪时间表采用相同配置:runc、Kata 为基准结果,Cube 为开启 AGC 优化后的结果。P95 启动延迟单位为秒。
启动方式 | 50 Pod P95 | 100 Pod P95 | 150 Pod P95 |
runc | 2.019 | 3.931 | 5.397 |
Cube 模板恢复(开启 AGC 优化) | 1.038 | 1.833 | 2.678 |
Cube 冷启动(开启 AGC 优化) | 1.513 | 2.720 | 4.097 |
Kata 3.32.0 社区版冷启动 | 2.921 | 4.814 | 6.679 |
将一轮中所有 Pod 的启动耗时从短到长排列,P95 表示至少 95% 的 Pod 的启动耗时不超过这个值。它用于观察较慢一部分实例的等待情况,不是平均耗时。
150 Pod 规模下,开启 AGC 优化的 Cube 模板恢复 P95 为 2.678 秒,runc 基准为 5.397 秒,本次 P95 耗时降低约 50.4%。这一对比同样包含运行时、启动方式和节点优化配置的差异。
P95 关注较慢一部分实例的等待情况;整批就绪时间关注最后一个实例,两者应结合查看。
本次表中各组均全部 Ready,无容器重启、Ready 回退或沙箱创建失败事件。
AGC 优化效果
AGC 优化针对批量 Pod 启动过程中的节点处理开销,配合 Cube 模板恢复减少整批环境就绪前的等待时间。本节区分 AGC 优化后的整体表现,以及同一 Cube 启动方式下的优化收益。
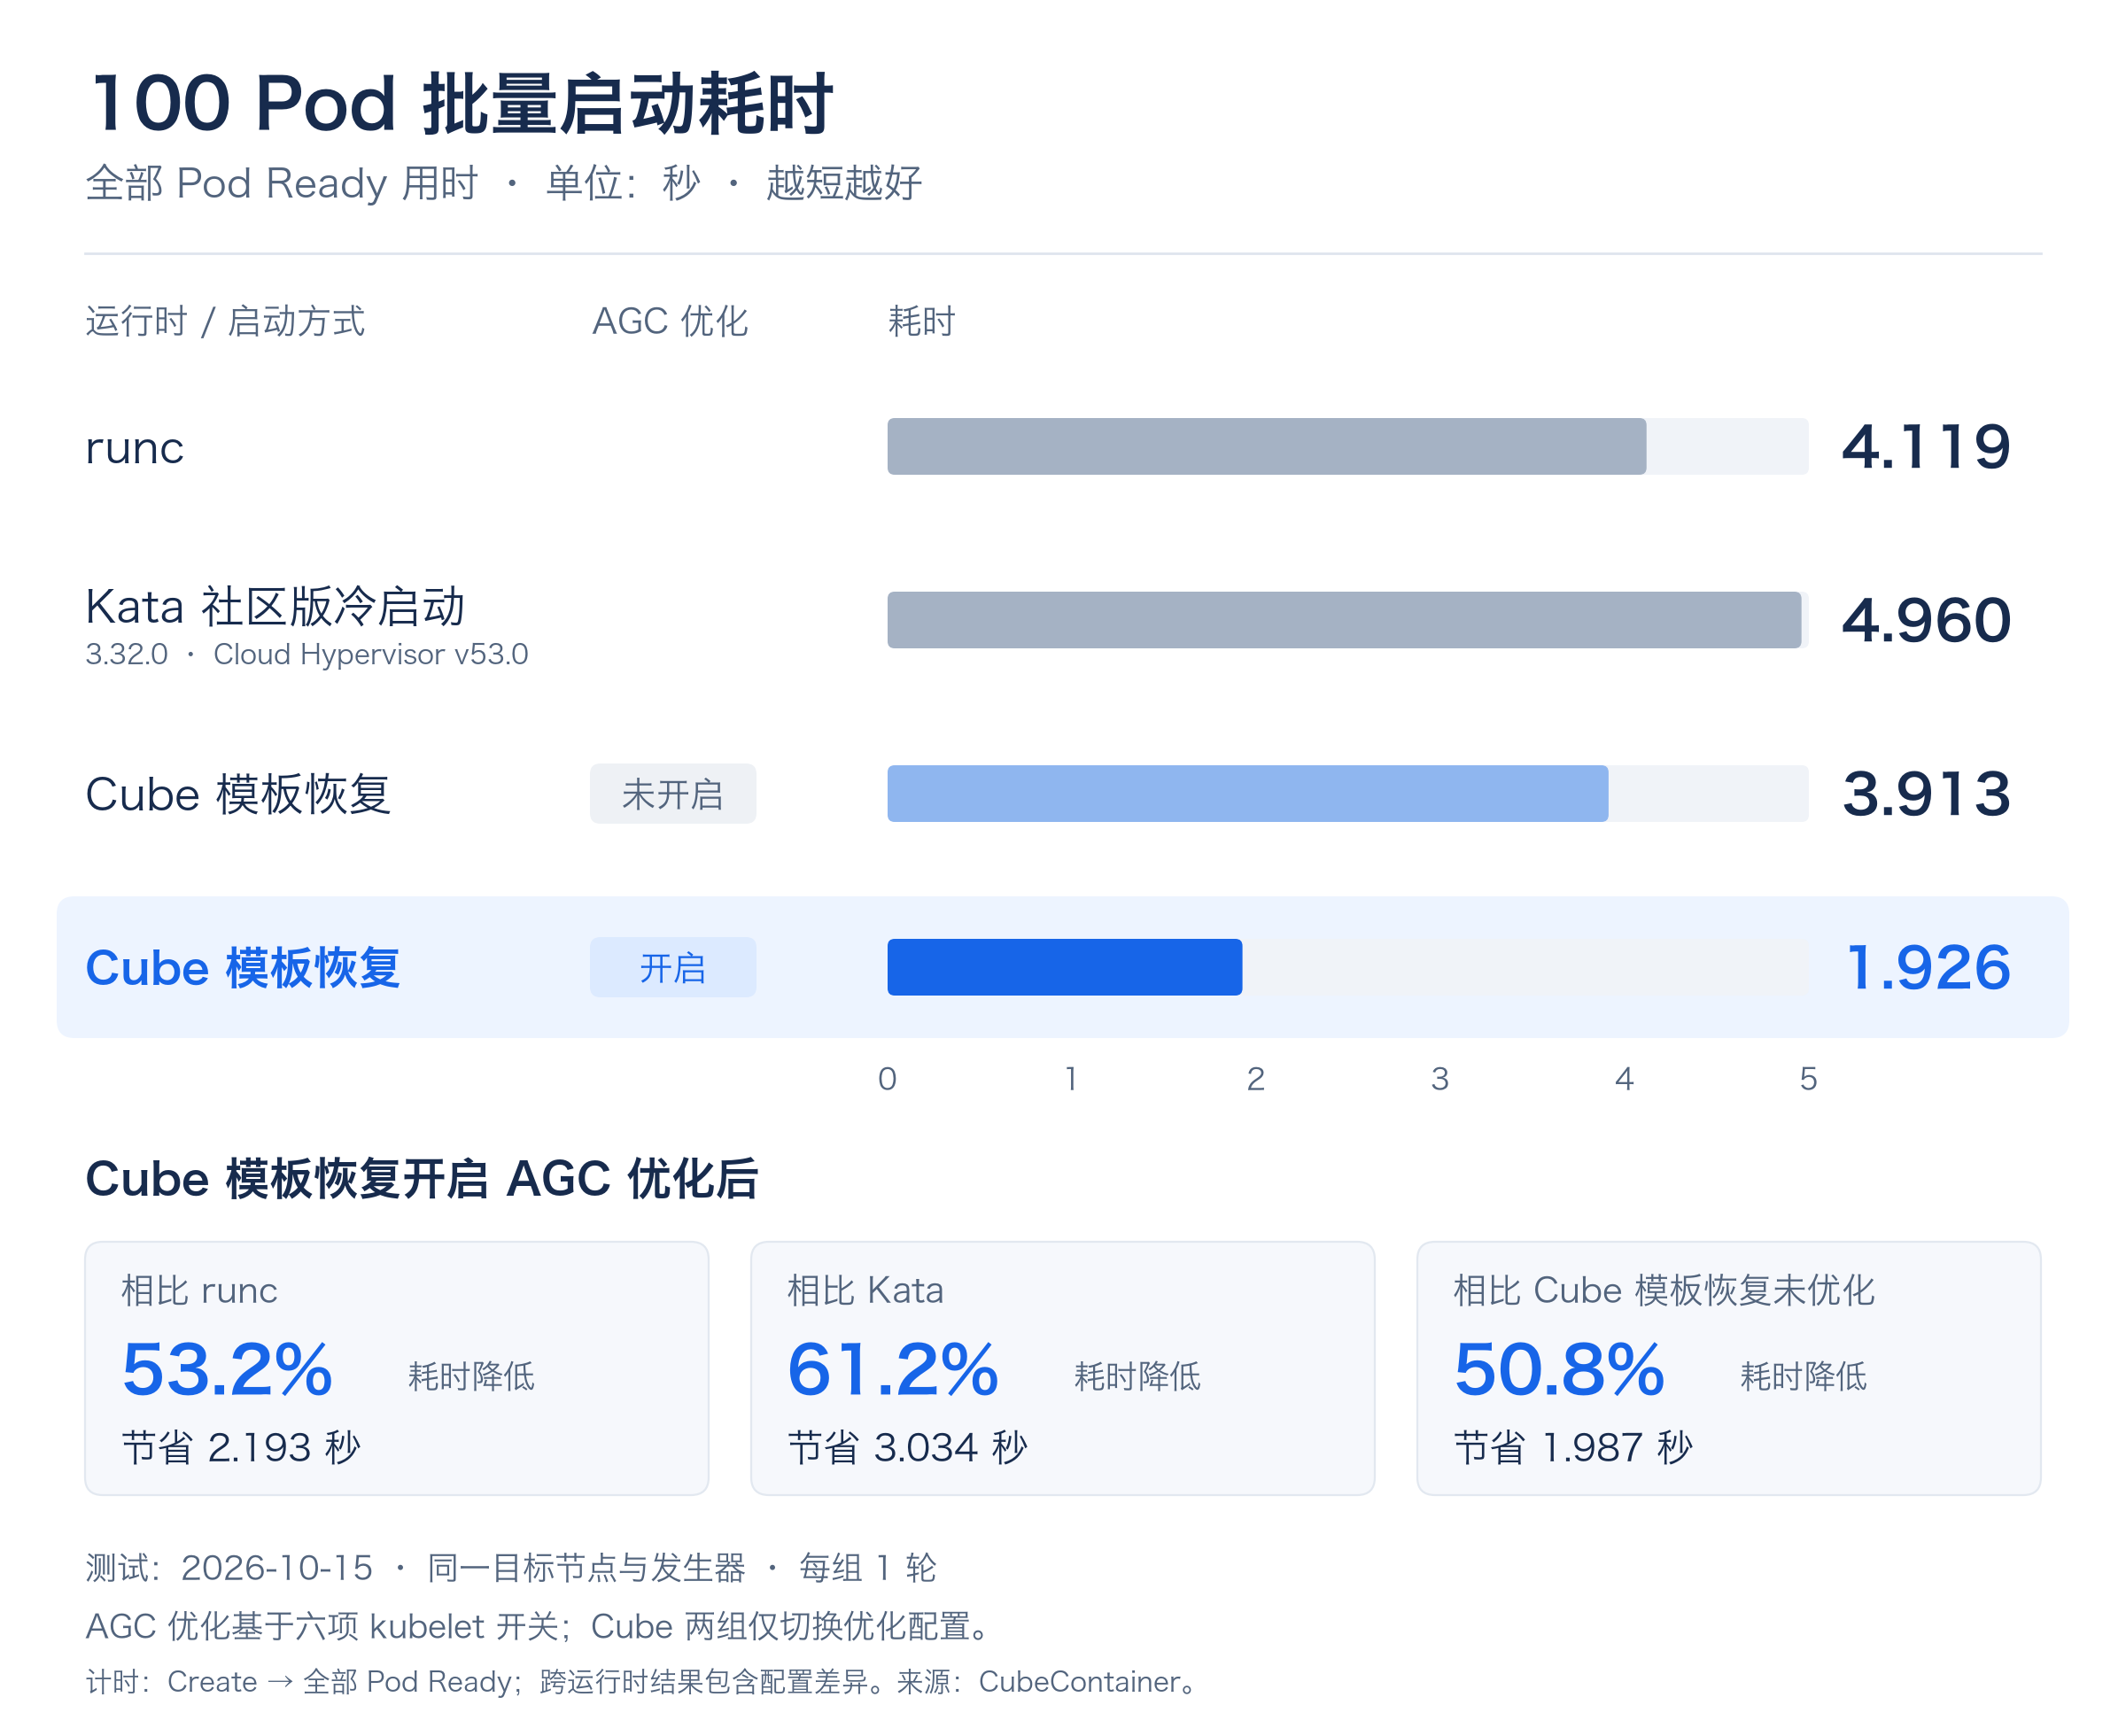
下图展示 100 Pod 规模下的 runc、Kata 基准结果,以及 Cube 模板恢复未开启和开启 AGC 优化的结果。
AGC 优化配置
AGC 优化通过改进 kubelet 对批量 Pod 的处理,减少节点处理和状态回传的等待时间。本次测试启用了以下六项优化:
优化开关 |
KubeletQOSCgroupUpdateCoalescing |
KubeletParallelPodStatusSync |
KubeletPodStatusRetry |
KubeletSystemdCgroupCreateWithResources |
KubeletCgroupControllerReuse |
PLEGOnDemandRelist(自 Kubernetes 1.36 版本移植) |
测试在同一目标节点上完成。runc、Kata 采用基准配置;Cube 分别记录开启 AGC 优化后的结果,以及模板恢复未开启优化的对照结果。
运行时及启动方式 | AGC 优化 | 100 Pod 全部就绪 |
runc | - | 4.119 秒 |
Kata 3.32.0 社区版冷启动 | - | 4.960 秒 |
Cube 模板恢复 | 未开启 | 3.913 秒 |
Cube 模板恢复 | 开启 | 1.926 秒 |
Cube 模板恢复开启 AGC 优化后:
对照配置 | 节省时间 | 耗时降低 |
runc | 2.193 秒 | 53.2% |
Kata 社区版冷启动 | 3.034 秒 | 61.2% |
Cube 模板恢复,未开启 AGC 优化 | 1.987 秒 | 50.8% |
保持相同 Cube 版本和模板恢复方式,开启 AGC 优化后,整批就绪耗时从 3.913 秒降至 1.926 秒,节省 1.987 秒,降低约 50.8%。该结果为六项优化共同开启后的收益。
相比 runc 和 Kata,53.2% 和 61.2% 的耗时降幅反映 Cube 模板恢复与 AGC 优化共同作用后的整体表现。
模板恢复的作用
Cube 为每个 Pod 创建独立虚拟机。模板保存了虚拟机内操作系统及基础服务已完成初始化的状态。创建新 Pod 时,从这个状态恢复,可以减少重复启动操作系统和基础服务的时间;随后再配置该 Pod 的网络和业务容器。
本次通过节点启动路径计数确认,模板恢复组实际使用了模板,显式冷启动组则从头初始化沙箱。
在同样开启 AGC 优化的条件下,150 Pod 规模的 Cube 模板恢复与冷启动结果如下:
Cube 启动方式 | 150 Pod 全部就绪 |
冷启动 | 4.232 秒 |
模板恢复 | 2.844 秒 |
模板恢复相对 Cube 冷启动节省 1.388 秒,整批就绪耗时降低约 32.8%。
这一比较保持相同 Cube 版本和 AGC 优化状态,展示模板恢复对完整 Pod 启动耗时的改善。计时包含 API、调度、kubelet、运行时及状态回传。
模板不包含本次业务镜像、工作区和应用初始化状态。镜像下载、Python 包导入、模型加载或工作区恢复较重时,应分别测量这些阶段,结合镜像加速和工作区复用优化。
运行环境与额外资源
启动方式 | 每个 Pod 额外预留的资源 | 配置说明 |
runc | 0 | 普通容器使用的运行程序,与宿主机共享内核。 |
Cube 模板恢复 / 冷启动 | 0.25 核 CPU / 256 MiB 内存 | 同一 Cube 版本,分别使用模板恢复和从头初始化。 |
Kata 3.32.0 社区版冷启动 | 0.25 核 CPU / 512 MiB 内存 | 使用社区 3.32.0 官方软件包和 Cloud Hypervisor v53.0 虚拟机监控程序;完整部署参数见原始报告。 |
表中资源通过 Kubernetes 的 RuntimeClass overhead 额外预留,不是实际测得的 CPU 或内存占用。
例如,150 个 Cube Pod 的业务容器申请资源与额外预留资源合计约为 52.5 核 CPU、37.6 GiB 内存,还需给节点系统和其他任务留出资源。比较启动速度时,也应同时评估资源需求。
Kata 测试采用官方静态包中的 runtime-rs shim、Guest 镜像和 virtiofsd,使用与 Cube 相同的 PVM Guest 内核,并配置
default_memory=512、sandbox_cgroup_only=true。本次仅列出 Kata 冷启动结果;Kata 模板补测未通过标准 Pod 预检,未纳入性能结果。Kata 结果只对应报告中的版本和部署配置,不能外推为所有 Kata 或云上沙箱产品的表现。选型应同时考虑隔离要求、兼容性、资源成本和实际业务延迟。
业务复测建议
1. 先确定业务目标。记录期望的并发规模、整批环境准备时间,以及首次业务结果返回时间。
2. 固定测试条件。使用独立测试环境,记录节点规格、软件版本、镜像状态、RuntimeClass overhead、AGC 优化状态及发生器参数。同配置比较时只改变本次需要验证的因素。
3. 先测简单任务,再替换真实任务。可参考 测试 Agent 工作负载启动性能 准备测试;该教程的默认规模和资源配置可能与本文不同,不能直接当作本次基准的复现。之后加入实际工作区、初始化逻辑和应用健康检查,记录从提交到任务真正可执行的耗时,并执行真实任务校验结果。
4. 分别记录不同缓存和启动条件。区分镜像已缓存与首次拉取、模板恢复与冷启动、工作区本地缓存可用与换节点后重新恢复,不要将不同条件的结果混合统计。
5. 保存每轮证据。至少保留运行配置、成功数量、P50/P95/P99、整批就绪时间、重启、Ready 回退及失败事件。清理本轮资源、确认节点恢复测试前状态后再进行下一轮。
6. 通过多轮测试评估波动。本文每组仅测一轮。用于容量规划或客户业务评估时,应增加轮次,保留慢请求、超时和失败记录,并为业务高峰预留资源。


