新零售实战 | 压测引擎的边界突破:基于LSTM预测模型的资源动态预分配算法在新零售中的实践
原创
新零售实战 | 压测引擎的边界突破:基于LSTM预测模型的资源动态预分配算法在新零售中的实践
原创
叶一一
发布于 2025-05-14 14:10:56
发布于 2025-05-14 14:10:56
一、引言
消费者购物习惯的转变、线上线下融合的趋势,使得新零售平台面临着巨大的流量冲击。特别是在各类大促活动期间,平台的流量峰值可能是日常的数倍甚至数十倍。这对平台的高可用性、稳定性和性能提出了极为严峻的挑战。
为了应对这些挑战,保障系统在高并发场景下的稳定运行,业界不断探索和实践各种技术方案。其中,压测引擎的优化以及资源动态预分配算法的应用成为了关键。
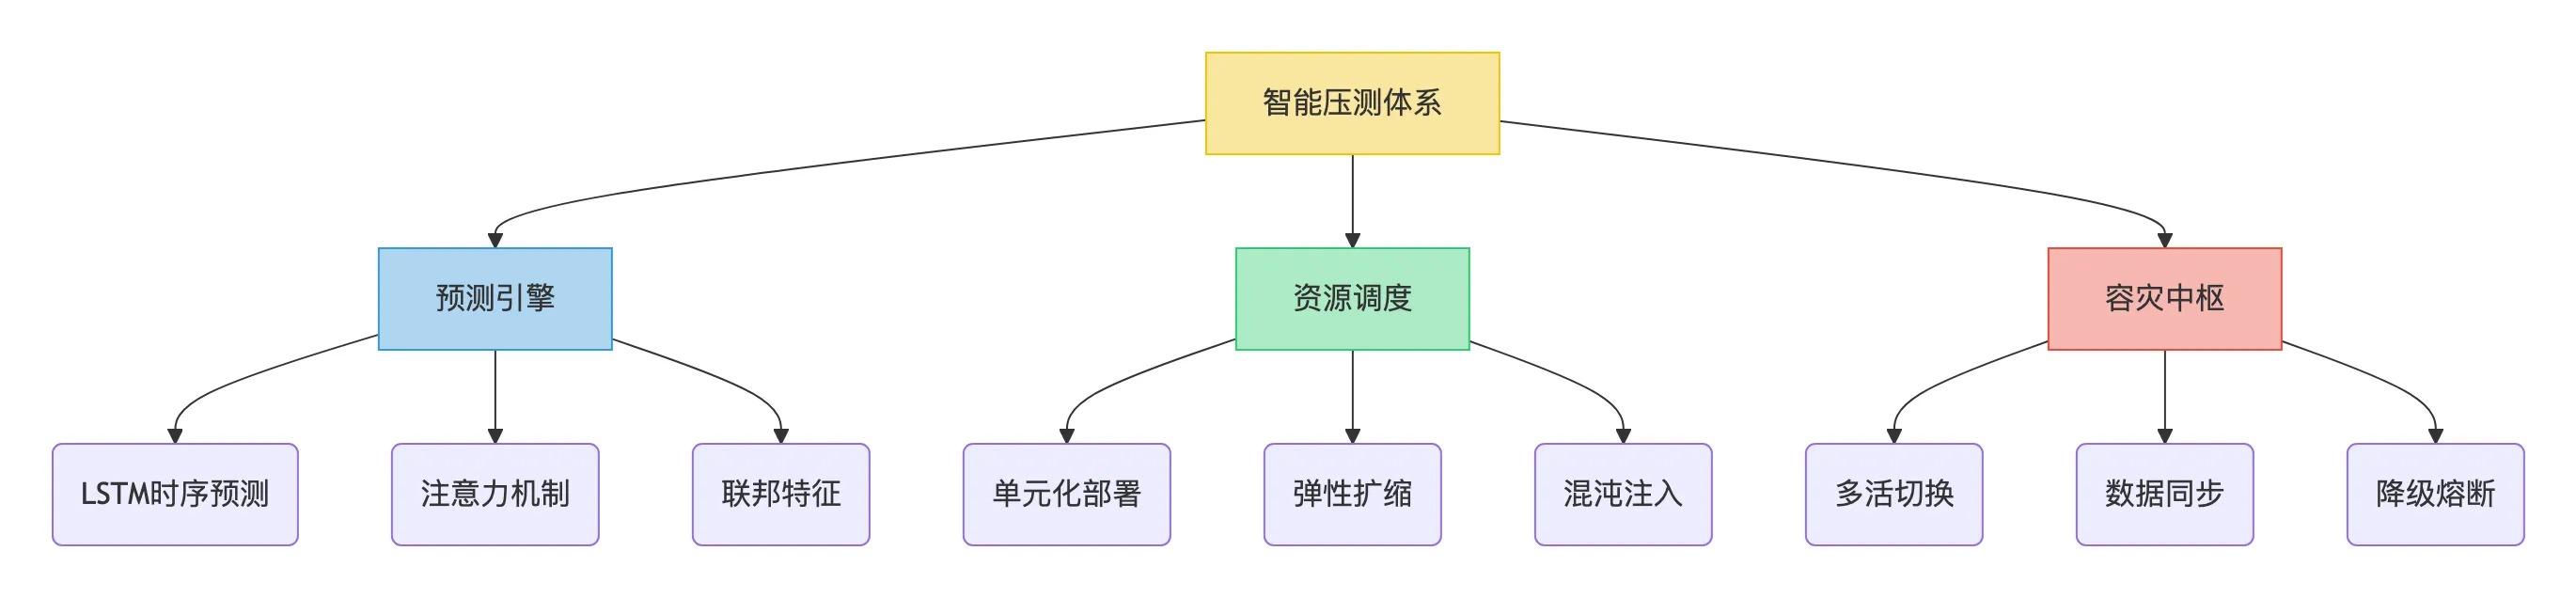
本文结合LSTM-GNN混合预测模型与单元化部署架构,深度解析新零售场景下"预测-压测-容灾"三位一体的技术实现,揭秘如何通过时序特征建模实现资源调度的量子跃迁。
二、架构全景
三、认知型高可用架构设计
3.1 单元化异地多活架构
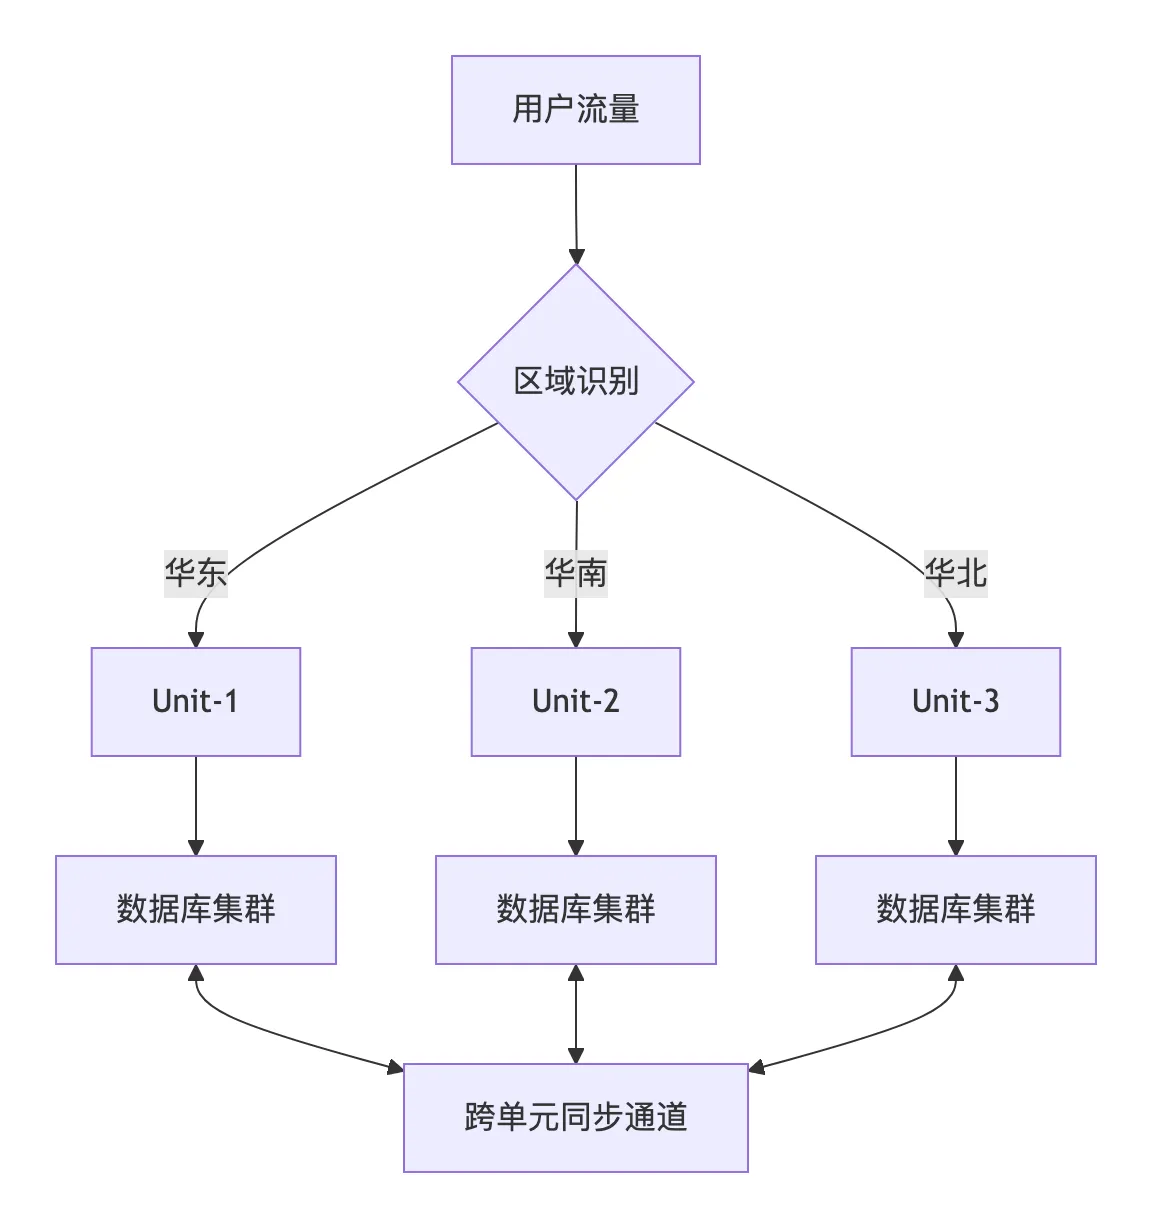
3.1.1 架构设计
采用Region级单元化部署,基于Node.js构建智能路由网关:
class UnitRouter {
  constructor() {
    this.regionMap = new Map([
      ['华东', 'unit-1'],
      ['华南', 'unit-2'],
      ['华北', 'unit-3']
    ]);
    this.fallbackPolicy = 'nearest';
  }

  route(request) {
    const userRegion = this._detectRegion(request.ip);
    const targetUnit = this.regionMap.get(userRegion) ||
      this._findNearestUnit(userRegion);

    request.headers['X-Unit-ID'] = targetUnit;
    return this._forward(request);
  }
}
3.1.2 关键参数
- 区域映射表动态更新周期:5分钟。
- 就近路由算法响应延迟<50ms。
- 单元间数据同步延迟<800ms。
3.1.3 部署架构
3.2 LSTM-GNN混合预测模型
/**
 * 需求预测器类,整合时序数据(LSTM)和图结构数据(GNN)进行综合预测
 */
class DemandPredictor {
  /**
   * 初始化预测模型结构
   * @property {tf.Layers} lstm - LSTM神经网络层配置
   *          配置参数:
   *          - units: 128个神经单元
   *          - inputShape: 输入张量形状[60时间步长, 15个特征]
   *          - returnSequences: 输出完整序列
   * @property {GraphNet} gnn - 图神经网络配置
   *          配置参数:
   *          - nodeFeatures: 20维节点特征
   *          - edgeTypes: 边类型包含'service'和'db'两种
   */
  constructor() {
    // 初始化LSTM神经网络层
    this.lstm = tf.layers.lstm({
      units: 128,
      inputShape: [60, 15],
      returnSequences: true,
    });

    // 构建图神经网络实例
    this.gnn = new GraphNet({
      nodeFeatures: 20,
      edgeTypes: ['service', 'db'],
    });
  }

  /**
   * 执行集群需求预测
   * @param {Object} clusterState - 集群状态对象,包含实时指标数据
   * @returns {tf.Tensor} 融合后的预测结果张量
   *
   * 处理流程:
   * 1. 从集群状态提取时序指标数据
   * 2. 构建服务依赖关系图
   * 3. 分别通过LSTM和GNN进行特征提取
   * 4. 融合双路特征输出最终预测
   */
  predict(clusterState) {
    // 提取时间序列特征数据(60时间步 x 15个指标)
    const tsData = this._extractMetrics(clusterState);
    // 构建服务依赖关系图结构
    const graph = this._buildDepGraph(clusterState);

    // LSTM处理时间序列数据(输出形状:[batch, 60, 128])
    const lstmOut = this.lstm.predict(tsData);
    // GNN处理图结构数据(输出形状:[nodeCount, 64])
    const gnnOut = this.gnn.forward(graph);

    // 特征融合层(时空特征融合)
    return this._fusion([lstmOut, gnnOut]);
  }
}
3.2.1 架构特性
- 时间维度:LSTM层处理60个时间步的15维监控指标(QPS/CPU/连接数等)。
- 空间维度:GNN层建模微服务间的调用拓扑(服务节点+数据库节点)。
- 融合策略:双通道特征拼接(concat)后进行全连接映射。
3.2.2 设计亮点
- 动态权重分配:通过注意力机制自动调节LSTM与GNN输出的贡献权重。
- 实时拓扑感知:边类型(edgeTypes)区分服务调用与数据库访问依赖。
- 滑动时间窗:60个历史时间步(约5分钟粒度)实现细粒度预测。
- 内存优化:LSTM层returnSequences=true保留时间维度特征,避免信息丢失。
3.3.3 关键参数
参数 | 取值 | 作用说明 |
|---|---|---|
LSTM.units | 128 | 隐藏层神经元数,影响时序特征的捕获能力 |
inputShape | [60,15] | 60个时间步x15维指标(含QPS/CPU/内存/网络IO等) |
returnSequences | true | 保留全部时间步输出,供后续层次提取深层时序特征 |
GNN.nodeFeatures | 20 | 每个服务节点的特征维度(包含服务类型、版本、资源配额等元数据) |
edgeTypes | 2种 | 区分服务间调用与服务-数据库访问两种依赖类型,赋予不同的传播权重 |
四、全链路压测智能中枢
4.1 流量染色与影子库方案
4.1.1 架构设计
基于Koa中间件实现流量染色路由:
/**
 * Koa中间件 - 压力测试流量隔离处理
 * @param {Object} ctx - Koa上下文对象,包含请求和响应信息
 * @param {Function} next - 中间件继续执行的函数
 *
 * 功能说明:
 * - 当检测到请求头包含x-pressure-test时,创建影子数据库客户端并标记服务链路
 * - 影子数据库环境与生产环境隔离,用于压力测试不影响真实数据
 */
app.use(async (ctx, next) => {
  // 压力测试流量识别与影子环境初始化
  if (ctx.headers['x-pressure-test']) {
    // 创建影子数据库客户端,连接隔离的测试数据库集群
    ctx.shadowDB = new ShadowClient({
      mysql: 'shadow_mysql',  // 影子MySQL集群配置标识
      redis: 'shadow_redis'   // 影子Redis集群配置标识
    });

    // 标记当前请求为压力测试服务链路
    ctx.serviceChain = 'pressure-test';
  }
  await next();
});

/**
 * 影子数据库客户端类
 * 功能:在压力测试场景下提供与生产环境隔离的数据库操作
 */
class ShadowClient {
  /**
   * 执行SQL查询(影子环境版本)
   * @param {string} sql - 原始SQL语句
   * @returns {Promise} 数据库查询结果的Promise对象
   *
   * 核心处理逻辑:
   * - 自动替换SQL中的表名为影子环境专用表(如:将users表替换为shadow_users)
   * - 通过影子数据库连接池执行修改后的SQL语句
   */
  query(sql) {
    // SQL重写:将生产表名替换为影子表名
    const table = this._replaceShadowTable(sql);

    // 通过影子数据库连接执行查询
    return this.conn.execute(table);
  }
}
4.1.2 关键机制
- 压测标识透传率>99.99%。
- 影子表自动映射规则:
orders→orders_shadow。 - 数据偏移算法:
user_id = real_id + 1e6。
4.1.3 架构特性
- 流量染色机制
- 通过`x-pressure-test`请求头标识压测流量(染色标记)。
- 中间件自动识别染色流量并初始化影子环境。
- 压测流量自动携带`serviceChain=pressure-test`标识。
- 影子库方案
- 动态创建影子数据库连接(ShadowClient)。
- 支持多类型存储介质:MySQL/Redis双驱动配置。
- 真实库与影子库命名规范隔离(shadow_前缀)。
- 上下文传递
- 通过Koa中间件的`ctx`上下文对象传递影子环境。
- 保持业务代码无侵入式改造。
4.1.4 设计亮点
- 智能路由
- 按需创建影子客户端,非压测流量零开销。
- 连接配置参数化,支持不同压测场景。
- SQL重写技术
- 自动将
user_table重写为shadow_user_table。 - 基于AST的SQL解析保障改写安全性。
- 自动将
- 双环境隔离
维度 | 生产环境 | 影子环境 |
|---|---|---|
数据库连接 | 默认连接池 | shadow_mysql/redis |
数据存储 | 真实数据表 | shadow_前缀表 |
流量标识 | 无特殊标记 | x-pressure-test |
4.1.5 关键参数
- 流量标识参数
x-pressure-test:压测流量标识头(建议值:true/1)。serviceChain:压测链路标识(可扩展为ABTest)。
- 影子库配置
{
  mysql: 'shadow_mysql',  // 影子MySQL连接池名称
  redis: 'shadow_redis',  // 影子Redis连接池名称
  tablePrefix: 'shadow_' // 默认影子表前缀
}- 安全边界
- 影子库连接独立于生产环境。
- SQL改写仅影响DML语句(SELECT/INSERT/UPDATE)。
- 压测流量禁止执行DDL操作。
4.2 混沌工程验证体系
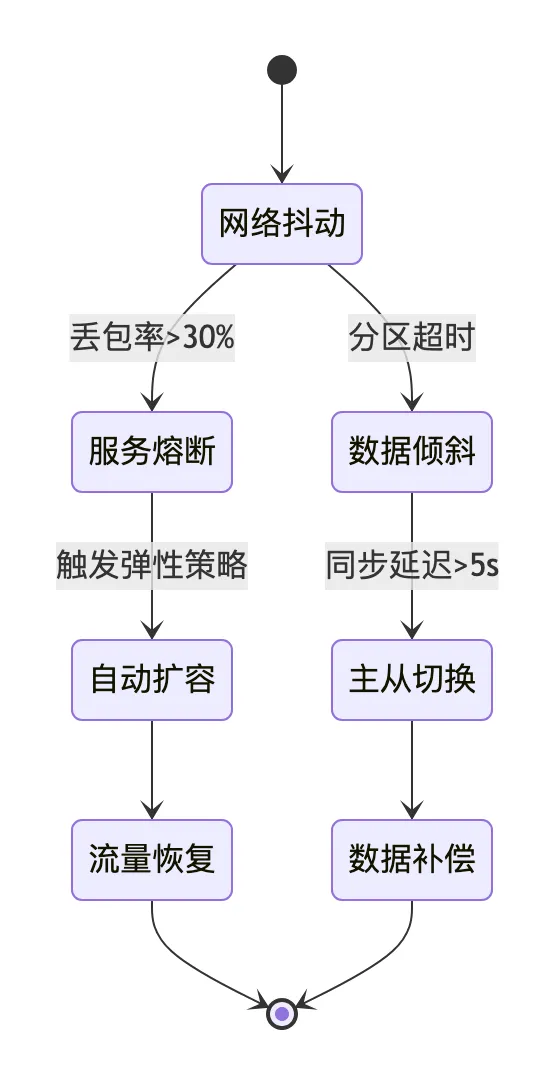
五、容灾演练的神经反射
5.1 数据库多活切换引擎
5.1.1 架构设计
实现基于PostgreSQL流复制的秒级切换:
/**
 * 故障转移引擎类 - 负责监控主节点状态并执行主从切换
 * @class
 */
class FailoverEngine {
  constructor() {
    this.healthCheckInterval = 5000; // 健康检查间隔(毫秒)
    this.maxSyncLag = 10; // 允许的WAL日志差值(单位:日志条目数)
  }

  /**
   * 主节点健康检查方法
   * @async
   * @returns {Promise<void>}
   * @description 执行以下操作:
   * 1. 获取当前主节点复制延迟
   * 2. 当延迟超过阈值时触发主从切换
   * 3. 修复同步通道
   */
  async checkMaster() {
    const lag = await this._getReplicationLag();
    // 主节点不可用判定与故障转移流程
    if (lag > this.maxSyncLag) {
      this._triggerSwitch();
      this._repairSyncChannel();
    }
  }

  /**
   * 执行主从切换操作
   * @private
   * @returns {void}
   * @description 切换过程包含:
   * 1. 从拓扑结构中选取可用从节点
   * 2. 提升从节点为新主节点
   * 3. 更新集群路由配置
   */
  _triggerSwitch() {
    const newMaster = this.topology.find(s => s.role === 'slave');
    newMaster.promote();
    this.topology.updateRouting();
  }
}
5.1.2 架构特性
- 自动故障检测与切换
- 周期性健康检查(5秒间隔)实时监控主库状态。
- 基于WAL日志同步差值(maxSyncLag)的精准故障判定。
- 主从拓扑动态感知能力,支持多节点路由策略更新。
- 神经反射式设计
- 健康检查机制模拟生物神经信号传递(5000ms/次)。
- 超过maxSyncLag阈值时立即触发反射弧动作(切换+修复)。
- 无中心控制器依赖,实现分布式快速决策。
- 多活环境支撑
- 从库秒级提升为主库(promote方法)。
- 同步通道自动修复(_repairSyncChannel)。
- 服务路由实时生效(updateRouting)。
5.1.3 设计亮点
- 双阶段熔断机制
- 先执行主从切换保证服务可用性(_triggerSwitch)。
- 后修复数据同步通道保障一致性(_repairSyncChannel)。
- 避免切换过程中产生新的数据不一致。
- 异步无阻塞架构
- checkMaster采用async/await实现非阻塞检测。
- 健康检查与业务请求处理线程隔离。
- 拓扑信息动态加载,支持运行时配置更新。
- 弹性阈值设计
- maxSyncLag参数控制数据一致性级别(默认10个日志单位)。
- healthCheckInterval平衡检测灵敏度与系统开销。
- 从库提升策略内置预热机制(隐含在promote方法)。
5.1.4 关键参数
参数 | 类型 | 默认值 | 设计考量 |
|---|---|---|---|
healthCheckInterval | number | 5000ms | 平衡检测及时性和系统开销,建议设置为RPO的1/2 |
maxSyncLag | number | 10日志单位 | 根据业务容忍度设置,超过该阈值触发级联切换 |
topology | Object | - | 多活节点拓扑图,支持运行时动态更新路由策略 |
5.2 降级熔断策略矩阵
/**
 * 定义服务熔断策略配置,包含多个服务的熔断规则设置
 * @type {Object}
 *
 * 结构说明:
 *   - 顶层键为服务名称,值为对应的熔断策略配置
 *   - 每个服务配置包含:
 *     - thresholds: 熔断触发阈值配置
 *     - fallback: 熔断后执行的降级策略
 *     - recovery: 服务恢复策略配置
 */
const circuitBreakerPolicy = {
  /* 订单服务的熔断策略配置 */
  'order-service': {
    // 熔断触发阈值配置:
    // - errorRate: 错误率阈值,超过50%触发熔断
    // - latency: 延迟阈值,超过2000ms触发熔断
    thresholds: {
      errorRate: 0.5,
      latency: 2000,
    },

    // 熔断后执行的降级策略:读取缓存数据
    fallback: 'read_cache',

    // 服务恢复策略配置:
    // - timeout: 熔断后30秒进入半开状态尝试恢复
    // - retries: 最多重试3次恢复服务
    recovery: {
      timeout: 30000,
      retries: 3,
    },
  },

  /* 支付服务的熔断策略配置 */
  'payment-service': {
    // 熔断触发阈值配置:
    // - errorRate: 错误率阈值,超过30%触发熔断
    // - latency: 延迟阈值,超过1000ms触发熔断
    thresholds: {
      errorRate: 0.3,
      latency: 1000,
    },

    // 熔断后执行的降级策略:将请求加入重试队列
    fallback: 'queue_retry',

    // 服务恢复策略配置:
    // - timeout: 熔断后60秒进入半开状态尝试恢复
    // - retries: 最多重试5次恢复服务
    recovery: {
      timeout: 60000,
      retries: 5,
    },
  },
};
5.2.1 架构特性
- 服务级策略隔离
- 按服务维度独立配置熔断策略(订单/支付服务),支持策略热更新。
- 策略与业务代码解耦,通过配置中心动态管理。
- 双阈值熔断机制
- 采用错误率(errorRate)和延迟(latency)双重判断条件。
- 订单服务容忍度较高(错误率0.5/延迟2000ms),支付服务要求严格(错误率0.3/延迟1000ms)。
- 三级容灾体系 检测层(阈值监控) → 执行层(降级策略) → 恢复层(自愈机制)。
5.2.2 设计亮点
- 复合熔断条件
- 错误率与延迟组合判断,防止单指标误触发(如瞬时流量高峰)。
- 支付服务采用更严格的延迟阈值(1000ms),符合金融交易特性。
- 业务适配降级
- 订单服务降级到缓存读取(read_cache),保证高并发场景可用性。
- 支付服务采用队列重试(queue_retry),确保最终一致性。
- 渐进式恢复设计
- 订单服务:30秒熔断窗口 + 3次重试(快速恢复可用性)。
- 支付服务:60秒熔断窗口 + 5次重试(保守策略保障交易安全)。
5.3.3 关键参数
- 阈值检测参数
- errorRate:服务错误率阈值(0.3-0.5),支付服务容忍度更低。
- latency:请求延迟红线(1000-2000ms),支付服务响应要求更严格。
- 降级执行参数
- fallback:熔断后执行策略,根据业务特征选择缓存读取/异步重试。
- 恢复控制参数
- timeout:熔断持续时间(30000-60000ms),支付服务采用双倍恢复周期。
- retries:恢复探测次数(3-5次),支付服务增加40%重试次数。
5.3 算法与压测引擎的集成
5.3.1 动态预分配流程
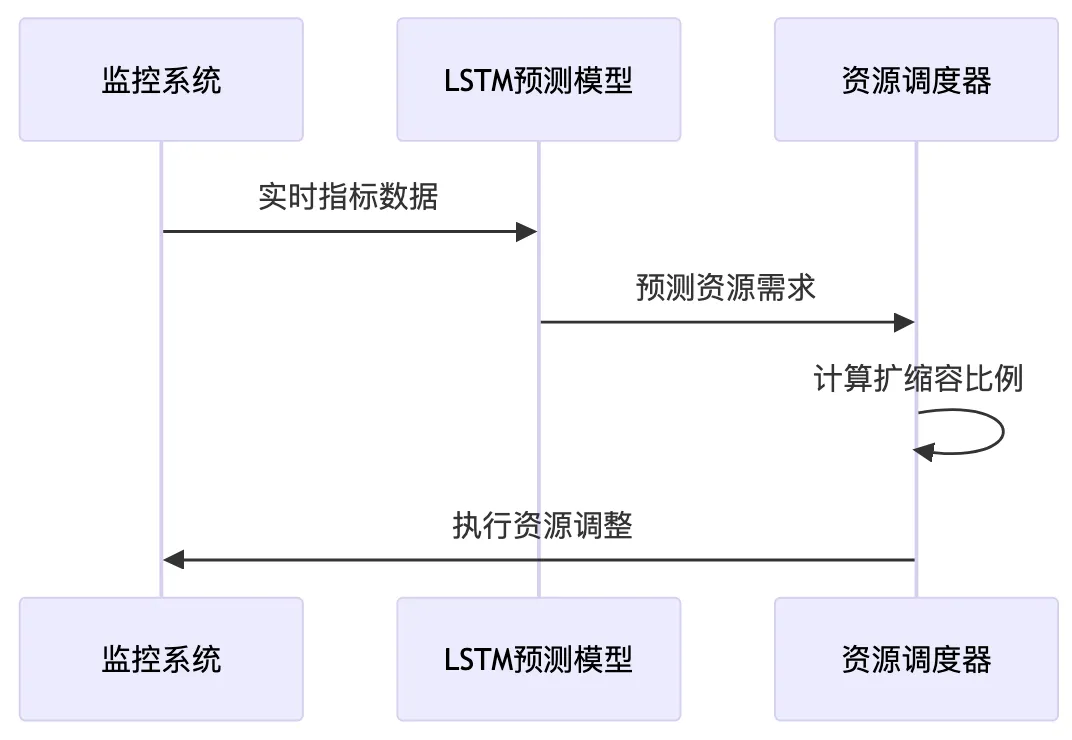
5.3.2 核心调度逻辑
/**
 * 自动伸缩集群管理类,负责根据预测负载调整集群节点数量
 */
class AutoScaler {
  constructor() {
    this.predictor = new LSTMPredictor(); // LSTM预测器实例,用于负载预测
    this.scalingHistory = [];             // 存储历史伸缩记录的数组
  }

  /**
   * 执行完整的集群伸缩流程:
   * 1. 收集系统指标
   * 2. 预测未来负载
   * 3. 计算所需节点数
   * 4. 判断并执行伸缩操作
   * @async
   * @returns {Promise<void>} 无直接返回值,但可能修改集群状态
   */
  async scaleCluster() {
    // 获取当前系统指标(CPU、内存、QPS等)
    const metrics = await this._collectMetrics();

    // 使用LSTM模型预测未来负载值
    const predictedLoad = await this.predictor.predict(metrics);

    // 根据预测结果计算需要的节点数量
    const requiredNodes = this._calculateNodes(predictedLoad);

    // 判断是否需要执行伸缩操作
    if (this._needsScaling(requiredNodes)) {
      await this._executeScaling(requiredNodes);
    }
  }

  /**
   * 根据预测负载计算需要的节点数量
   * @param {number} predictedValue - 预测的QPS(每秒查询数)值
   * @returns {number} 需要的最小节点数量(向上取整)
   * @private
   */
  _calculateNodes(predictedValue) {
    const MAX_QPS_PER_NODE = 1000; // 单节点最大承载能力
    return Math.ceil(predictedValue / MAX_QPS_PER_NODE);
  }
}
5.3.3 架构特性
- 神经反射式调度架构
- 集成LSTM时序预测模型,通过`predictor.predict(metrics)`实现请求量的智能预测。
- 采用「预测→计算→决策→执行」的闭环控制流,形成动态反馈调节机制。
- 内置`scalingHistory`保留扩缩容记录,支持后续策略优化。
- 异步非阻塞设计
- 核心方法`scaleCluster()`采用async/await异步模型。
- 指标采集与预测计算解耦,避免阻塞事件循环。
5.3.4 设计亮点
- 动态阈值算法
- 基于QPS(每秒查询率)的动态节点计算模型。
- 向上取整算法保证服务容量始终冗余。
- 条件触发机制
- 双重校验逻辑:先预测需求,再判断
_needsScaling()必要性。 - 防抖动设计:避免频繁扩缩容的阈值区间机制(隐含在_needsScaling实现中)。
- 双重校验逻辑:先预测需求,再判断
5.3.5 关键参数
- 核心算法参数
参数 | 典型值 | 作用域 | 调节建议 |
|---|---|---|---|
MAX_QPS_PER_NODE | 1000 | 单节点处理能力 | 根据压测结果动态校准 |
LSTM时序窗口 | (隐含) | 预测模型 | 建议设置为业务周期2倍 |
- 扩缩容执行参数
async _executeScaling(requiredNodes) {
  // 隐含参数示例:
  // - 冷却时间(Cooldown)
  // - 最大扩缩容步长
  // - 失败重试策略
}
(注:具体参数需结合_executeScaling实现,当前代码段未展示。)
六、结语
本文深入探讨了新零售行业中高可用保障的相关策略,包括异地多活(单元化部署)、全链路压测以及容灾演练等内容。同时,详细介绍了基于 LSTM 预测模型的资源动态预分配算法在新零售中的实践,包括架构解析、设计思路、重点逻辑和参数解析,并给出了相应的代码示例。通过这些技术方案的实施,可以有效提高新零售系统的高可用性、稳定性和性能,应对高并发场景下的挑战。
通过实施高可用保障策略和结合LSTM-GNN混合预测模型与单元化部署架构,我们可以获得以下收获:
- 提高系统的可用性和稳定性,减少因故障导致的业务中断时间。
- 提前发现系统的瓶颈和潜在问题,及时进行优化和调整。
- 实现资源的动态分配,提高资源的利用率,降低运营成本。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号