maxwell参数不合理导致的运行异常
原创
早上收到告警,提示maxwell在不断重启(使用supervisor守护的)。看了报错如下:
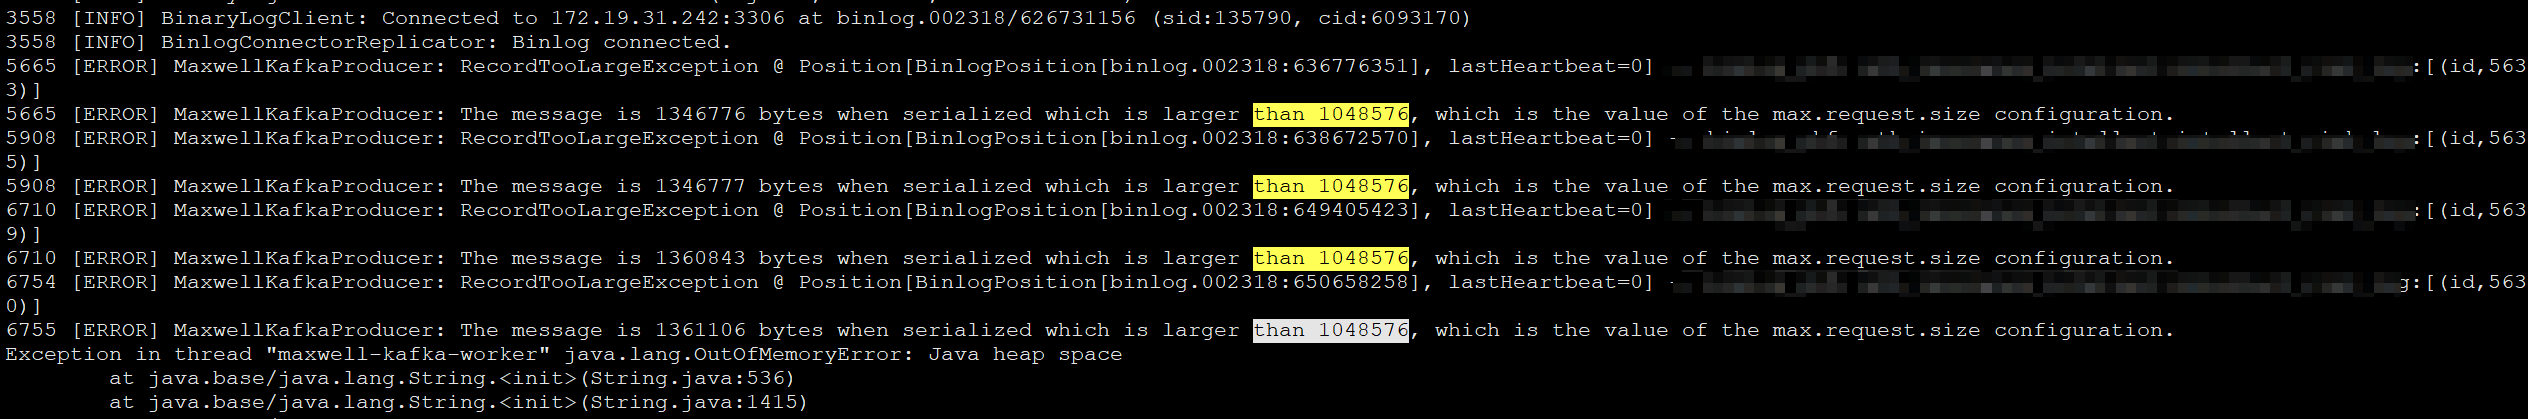
可以看到是因为max.request.size 参数默认值过低导致的。看了下最早的报错时间段,大概知道原因了:最近对生产的一个大的log表加个定时清理的pt-archiver任务,maxwell接收到大量binlog然后因为默认的参数值过低导致无法序列化进而导致maxwell出现OOM。
那么根据提示改下maxwell的参数
kafka.max.request.size=10485760注意:
因为我这是maxwell消费binlog后存到kafka里面的,因此还需要改下kafka的参数,防止出现其他问题
kafka的参数也修改下,默认都是1MB,这里改为10MB
vim /usr/local/kafka/config/server.properties
max.request.size=10485760
message.max.bytes=10485760
然后,重启下kafka和maxwell。
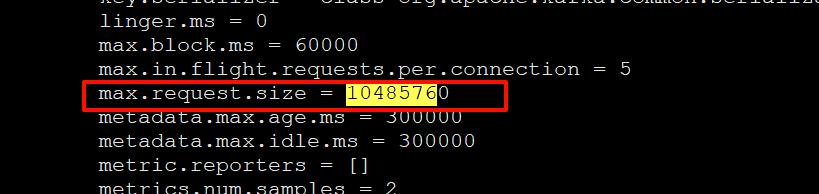
再次查看maxwell的日志(如下图),可以看到maxwell配置文件中的 max.request.size 这个值已经生效了。
但是,从后续的日志看,maxwell还是报错OOM。
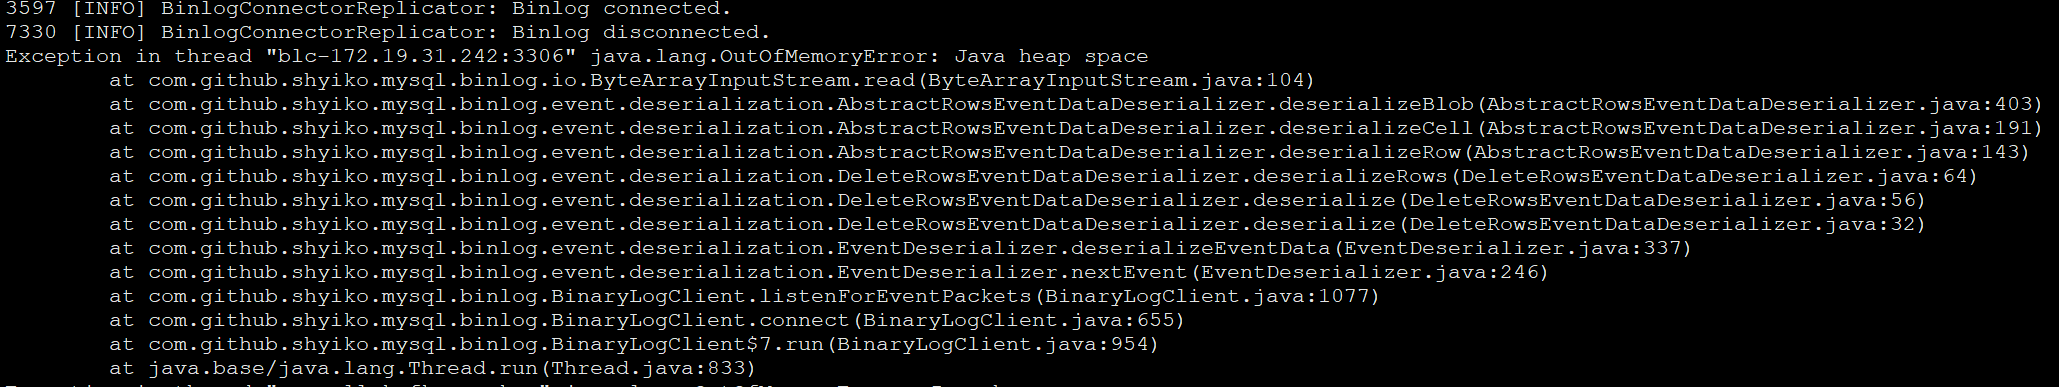
这里的判断过程就是纯经验了,maxwell为啥OOM? 就是暂存的东西太多了。
那么看下日志里面maxwell启动日志中在控制台输出的运行参数,可以看到 max.block.ms =60000 ,这表示如果kafka端写入阻塞(或不可用)则这些序列化后的消息会堆积在maxwell内存中,这样就可能导致maxwell出现OOM的情况。
因此,最终修改后的maxwell配置增加了如下2行:
# 攒批最大报文10MB(这个值需要小于低于kafka broker端的配置值)
kafka.max.request.size=10485760

# 攒批最多等待5秒
kafka.max.block.ms=5000
然后,再重启下maxwell,可以看到参数都生效了,maxwell的日志里也没有oom相关报错了。
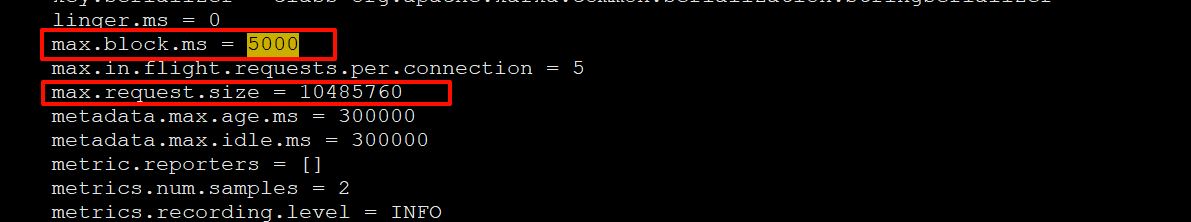
此外,建议将maxwell中的其它几个kafka默认参数也优化下,例如
# 失败重试 3 次
kafka.retries=3

# 每次重试间隔 1 秒
kafka.retry.backoff.ms=1000

# 控制 Producer 缓冲区大小(默认 32MB,如果消息量大可适当调大)
kafka.buffer.memory=67108864

# 设置 linger.ms 和 batch.size 优化批量发送(根据吞吐量权衡延迟)
kafka.linger.ms=100
kafka.batch.size=16384
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号