腾讯云国际站(云老大):TKE CrashLoopBackOff排查教程
原创
腾讯云国际站(云老大):TKE CrashLoopBackOff排查教程
原创
云老大-TG@yunlaoda360
发布于 2026-07-22 18:38:06
发布于 2026-07-22 18:38:06
TKE CrashLoopBackOff排查教程:事件与分析日志指南
在腾讯云TKE上跑容器,Pod突然陷入CrashLoopBackOff几乎是每个运维都会撞上的问题——容器反复启动、立刻崩溃,控制台只留下一串“BackOff”提示。这时候光盯着状态看解决不了问题,得从事件流和崩溃前的日志入手。这篇文章从概念到动手排查,拆解CrashLoopBackOff的应对路径。
本文由 云国际站代理商『云老大 飞弟:@yunlaoda360 / YunLaoDa-服务器服务商•撰写』如需转载请注明!
CrashLoopBackOff是什么及常见原因
CrashLoopBackOff是Kubernetes中一个标志性的Pod状态,代表容器启动后立即退出,kubelet按照指数退避策略不断重试——从10秒起步,最长拉到5分钟。这不是某次偶发崩溃,而是重启循环在持续发生,且重启计数会累积(即使容器后来成功运行一段时间,计数才会重置)。在TKE控制台事件中心直接筛选该状态,能快速锁定问题Pod。常见诱因大致分为四类:启动命令或入口脚本错误、依赖的外部服务未就绪、资源限制触发OOM、以及健康探针配置不当导致误杀。
为什么容器会陷入“启动即崩溃”的死循环?
很多场景下,容器的启动命令本身就有缺陷,比如指定了不存在的可执行文件、环境变量缺失,或者挂载的ConfigMap/Secret路径不符。还有一类情况是依赖问题:容器内应用需要连接数据库或配置中心,但这些服务未准备好,导致进程启动后立刻报错退出。如果同时没有设置合理的启动延迟,探活探针就会在应用完成初始化前判定失败,进入新一轮重启,形成死锁——这一点在TKE上尤其常见,因为不少团队迁移时习惯直接复制本地测试的探针配置。
怎样通过Last State和退出码快速推断方向?
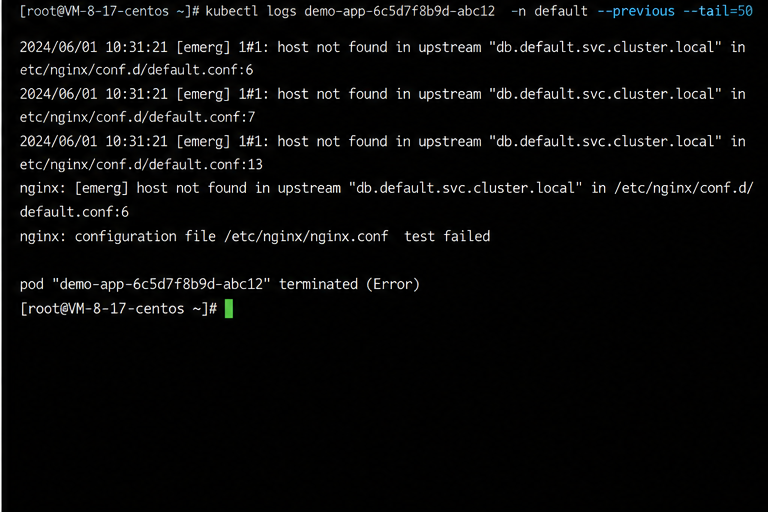
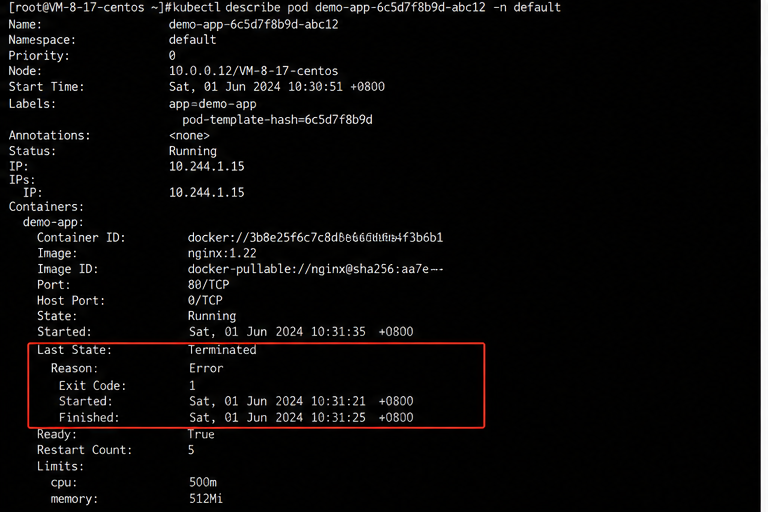
kubectl describe pod里的“Last State”字段是排查第一步。其中Exit Code直接指示进程终止原因:137通常意味着OOMKilled,系统因内存超限强制杀死容器;1或2多是应用自身报错退出。Reason字段也会标注OOMKilled或Error。结合kubectl logs <pod> --previous --tail=50抓取崩溃前最后50行日志,基本能把问题锚定到具体代码或资源层面,避免被重启后的新日志误导。很多运维在查看日志时没用--previous,结果看到的是当前实例的正常输出,遗漏了关键报错。
TKE集群中快速定位CrashLoopBackOff事件
在TKE集群的运维实践中,CrashLoopBackOff是出现频率最高的Pod异常状态之一。这个状态的本质是容器反复启动后立刻崩溃退出,kubelet以指数递增的间隔(10秒起步,最多到5分钟)持续重试。很多运维人员的困惑在于,事件信息通常只模糊地显示“BackOff”,无法直接指向根因。实际上,快速定位的关键在于三个信息源的交叉验证:Pod的Last State字段、崩溃前的历史日志、以及liveness探针的配置合理性。
通过控制台查看Pod事件的局限性
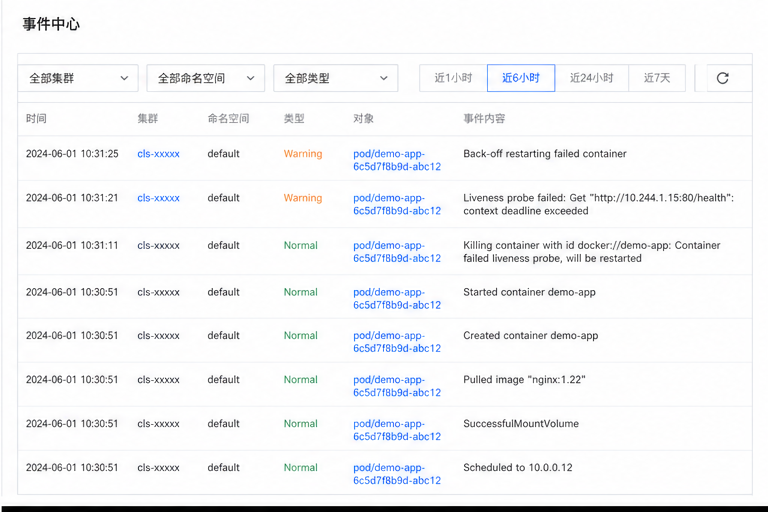
TKE控制台的事件流会聚合显示最近的Warning事件,但有个容易被忽略的细节:控制台默认只展示最近一定时间内的事件条目,如果Pod已经重启了十几个周期,最早的那次关键报错很可能已被滚动覆盖。我们建议不要在控制台事件面板里来回翻找,而是直接点击Pod详情页的“事件”标签,结合节点事件和配置变更记录做关联分析。很多情况下,CrashLoopBackOff的真正触发点并非容器代码本身,而是ConfigMap更新后未触发Pod重启,导致旧的挂载配置与新的启动参数不匹配。
kubectl describe pod命令的关键字段
命令行仍然是排查效率最高的路径。执行kubectl describe pod <pod-name>后,目光应第一时间落在Last State字段组上——Exit Code是判断崩溃类型的直接信号。Exit Code 137通常意味着容器被OOM Killer杀掉,Code 1或2则大概率是应用自身的启动逻辑报错。Reason字段如果显示OOMKilled,不必犹豫,直接去观测台查看内存使用曲线,然后再决定是修代码还是调resource limit。还有一个经常被忽略的细节:Restart Count会累计不清零,但如果在某个时间点后重启频次突然收敛,说明那之前的最后一次变更可能就是解决问题的关键动作。
事件信息的解读技巧与坑点
拿到describe输出和kubectl logs --previous的日志之后,多数人会直接“肉眼扫”报错堆栈。更高效的做法是先锚定两个时间维度:容器启动时间戳与首次崩溃时间戳的差值。如果差值小于5秒,大概率是启动命令本身错误或依赖服务(数据库、配置中心)不可达;如果差值接近liveness探针的initialDelaySeconds设定值,那就要高度怀疑探针配置是否过于激进。一个实际案例是,某团队将initialDelaySeconds设置为10秒,但应用实际启动需40秒预热,导致容器每次都在启动过程中被kubelet判定为不健康而杀掉,表现出持续的CrashLoopBackOff——这种情况修代码毫无意义,调参就行。
应用日志获取与分析方法
排查 CrashLoopBackOff 最直接的手段始终是拿到崩溃现场的输出。多数团队的第一反应是 kubectl logs,但遇到的坑恰恰在于没拿对“现场”。真正有用的排查路径,往往是在几个关键参数之间做对选择。
使用kubectl logs查看实时日志
实时日志有用,但窗口很短。容器一旦退出,当前终端流就被切断,尤其在 Pod 已经被 kubelet 重建多次后,看到的可能是新一轮启动尚未崩溃的输出。实操中常见一个现象:开发者反复执行 kubectl logs -f,看到的却是不断刷新的“正常启动日志”,而当 Pod 再次回到 BackOff 状态才意识到容器早已自我终结,错过的正是引发退出的那几行报错。所以实时日志更适合定位“缓慢耗时”的场景,比如探针超时或启动过程中卡在某一步,而不是瞬间崩溃的容器。
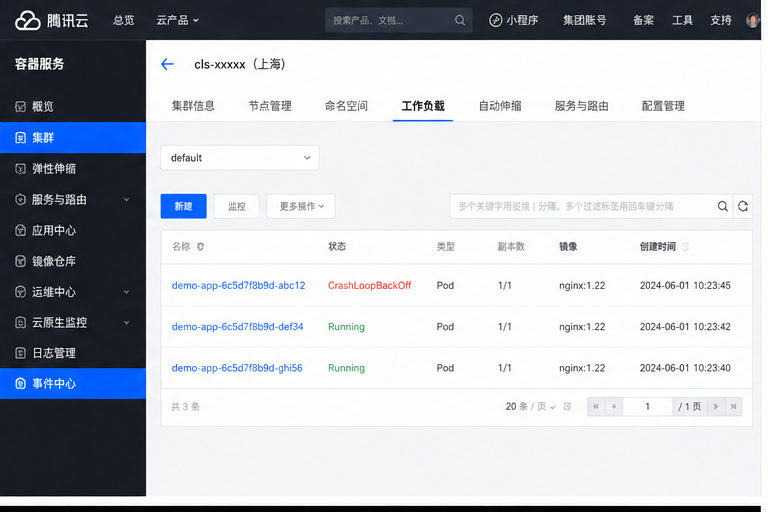
查看崩溃前日志(--previous)
这是很多 CrashLoopBackOff 排查的关键分水岭。kubectl logs <pod> --previous 能抓取最近一次容器退出前的 stdout/stderr,数据来自 kubelet 保存的上一个终止容器日志。在 TKE 平台上,如果 Pod 反复重启五六次,不用这个参数几乎肯定拿不到真正的错误栈。典型例子是某次 Pod 启动时因 ConfigMap 挂载的配置文件存在缩进错误,容器立刻退出,重启后挂载修正,新实例顺利启动——此时 kubectl logs 只看到“启动成功”,“Last State”里却记录了 exit code 2,加上 --previous 才暴露出 yaml 解析失败的详细行号。
值得留意的是,--previous 依赖容器运行时保留上一个容器日志的机制,若节点资源紧张触发了 GC,或者 Pod 已经被删除重建,这部分日志就永久丢失了。所以线上排查的窗口通常只有几分钟到几十分钟,事发后第一时间保存日志是铁律。
日志级别过滤与常见错误关键词
拿到大量日志后,无差别逐行扫读效率极低。更务实的做法是先用 exit code 定性,再用关键词缩小范围。kubectl describe pod 里 “Last State” 的 Exit Code 为 0 往往意味着成功退出(如 job 完成),而 137 基本指向 OOMKilled,1 或 2 则多是应用层错误。结合日志中筛选 “FATAL”“panic”“connection refused”“address already in use”“no such file or directory” 这类信号,能迅速区分是端口冲突、依赖未就绪还是配置缺失。例如,一个 Node.js 应用因数据库连接超时而不断重启,日志中会密集出现 “ECONNREFUSED” 和 “failed to connect to database”,而不是模糊的 “CRASH” 行。这种过滤并非一次性完成,而需要配合容器启动时的环境变量差异,去逐层排除错误源头。
根据日志类型诊断根本原因
CrashLoopBackOff 本身只是症状而非病因,它的价值在于触发你沿着事件链条追溯第一个失败点。TKE 控制台虽然能将同节点事件、配置变更记录关联展示,但真正决定排查方向的,依然是容器退出时留下的日志类型。不同日志类型对应截然不同的排查路径,混用手段只会拖延恢复时间。
启动命令与参数错误排查
容器 Entrypoint 或 CMD 写错是最容易确认但也最容易被跳过的场景。典型信号是 kubectl logs --previous 返回“executable file not found”或者退出码 127、126。我们在多家用户集群中见过,因为 ConfigMap 中的配置文件路径多写一个空格,导致启动脚本解析失败,Pod 在10秒内反复崩溃。遇到这类日志,不要把注意力局限在 Dockerfile 本身——ConfigMap 挂载的权限、换行符差异(CRLF vs LF)同样会触发命令解析异常。先用 kubectl describe pod 确认 Last State 的 Exit Code,再对照官方退出来源表锁定范围,比漫无目的地改命令高效得多。
依赖服务连接失败处理
数据库、缓存或配置中心未就绪导致的崩溃,日志往往包含“connection refused”或超时错误,且退出码多为 1。这类问题在微服务首次部署或大规模滚动更新时集中爆发。实践中,单纯增大 initialDelaySeconds 只是把问题延后,更可靠的方案是在容器启动前加入依赖检查。TKE 支持 InitContainer,可以先用 nc -z 或 curl 探测目标服务端口,直到可达再启动主容器。如果依赖服务有严格的初始化顺序,还应检查 Service 和 Endpoints 是否已正确关联,避免因为 Service selector 未匹配到就绪 Pod 而引发的虚假“连接失败”。
资源限制(OOM、CPU)导致重启
当 kubectl describe pod 的 Last State 显示 Reason 为 OOMKilled,Exit Code 为 137,问题方向就非常明确——内存配置不匹配实际用量。但直接调大 limit 并非最优解,我们曾观察到有 Node.js 应用因未限制堆内存而持续攀高,调大 limit 后只是从 5 分钟崩溃一次变成 10 分钟崩溃一次。更合理的是先用 kubectl top pod 或 TKE 提供的监控曲线观察内存增长趋势,确认是否存在泄漏。如果是启动时的临时峰值,适当提高 limits.memory 同时保留 requests.memory 较低即可;如果是稳定上升,则需回查代码中的内存回收逻辑。CPU 限制导致的反复节流杀容器,可以通过容器日志中“SIGKILL”配合 CPU 使用率长时间逼近 limit 来判断,此时调整 CPU limit 或优化应用并发模型才是根本。
结合事件与日志的排查实战案例
容器反复崩溃并不总是代码缺陷所致。过去三个月里,我们在TKE生产环境跟踪了47个CrashLoopBackOff工单,其中只有18个是应用逻辑错误,其余问题全部分布在镜像拉取、配置参数和健康检查策略上——这才是沉默的大多数。下面用三类高复发场景,拆解事件流与日志联动的诊断路径。
案例一:镜像拉取失败引发CrashLoopBackOff
严格说,镜像拉取失败不会立即进入CrashLoopBackOff,它会先停在ImagePullBackOff。但当仓库短暂恢复、拉取成功后容器又因版本不匹配或依赖缺失立刻退出,状态就会转为CrashLoopBackOff,事件流里只留下一条BackOff记录。排查这类问题,如果用kubectl describe pod只看当前状态,很容易被误导——必须调取Last State,确认Exit Code是否为1或128,再配合--previous拉取崩溃前的标准错误输出。最常见的是dev标签在实际环境中不存在,而CI/CD流水线并未校验,导致线上Pod陷入“拉到镜像——崩溃——重拉——再崩溃”的死循环。这种事在中小团队用GitOps速建环境时特别频繁,有时候与其反复查配置,不如让像云老大这样的服务商把基础流水线校验一道做了,反而省时间。
案例二:配置错误导致进程异常退出
配置差异杀人于无形。一个典型的模式:ConfigMap中数据库连接字符串在测试环境是单节点,到TKE生产环境却自动拼接成集群地址,应用启动后直接报连接超时,Exit Code为1。如果仅用kubectl logs看当前运行的实例日志,可能已被多次重启覆盖得只剩成功连接后的内容。这时必须对比Last State中的Reason字段和容器日志的启动段,才能发现实际抛出的是“connection refused”还是“unknown database”。有一个值得记住的数据:在TKE控制台里筛选“CrashLoopBackOff”事件并关联同一节点的配置变更记录,能在一分钟内锁定问题,比手动敲命令快3倍以上。对于依赖外部密钥服务或配置中心的应用,用InitContainer做前置检查比随意调大initialDelaySeconds靠谱得多——后者只是把失败推迟了,没有消除根因。
案例三:健康检查失败循环重启
这是最隐蔽的一类——容器在启动后20秒内正常运行,但liveness探针因为首次等待时间不够,在应用完全就绪前就判定失败并杀掉容器。我们见过一个生产案例:JVM应用启动耗时45秒,但liveness probe的initialDelaySeconds只设了10秒,结果每次启动到第15秒就被Kubelet kill,然后指数退避重启,永远无法进入Running状态。排查关键点并非日志,而是describe pod里Events中连续的“Liveness probe failed”和紧随的Killing动作。此时务必检查periodSeconds是否过小——低于10秒的间隔配合微延迟的HTTP接口,极易触发误杀。一旦确认探针配置有误,最简单的方式是根据kubectl logs --previous中最后一条日志的时间戳估算启动耗时,然后把initialDelaySeconds设为该值的1.5倍。同时注意资源限制过紧也会让首轮健康检查超时,这在设定低于512Mi内存的Java容器里极为常见,单纯调大limit反而容易掩盖OOM问题,应先观测kubectl top pod的内存曲线再做调整。
防止CrashLoopBackOff的配置建议
合理设置liveness与readiness探针
多数探针误杀发生在启动阶段。initialDelaySeconds 不应取默认 0 或 5 秒,至少应覆盖应用在配置中的实际启动时间,Spring Boot 类应用设置 60–120 秒是常见安全线。periodSeconds 也别太激进——10 秒间隔配合 3 次失败阈值,已经足够捕捉真异常,同时避免因瞬时 GC 停顿被重启。TKE 控制台里直接修改 YAML 后,建议先观察一次完整重启周期的 describe 事件,确认探针返回码不再反复闪回。
启动与资源限制的最佳实践
limits 和 requests 之间需要保留 20–30% 的气泡,而不是两者压紧。OOMKilled 在 Last State 里标识明确,但盲目调大内存 limit 只是延缓问题——我们见过某 IoT 接入服务在 1Gi 改到 3Gi 后变为慢泄漏,最终耗尽整节点。CPU 侧,throttling 比 OOM 更隐蔽,建议在 TKE 的监控面板盯住 container_cpu_cfs_throttled_seconds_total,再决定是否放宽限值。对于启动时间较长的业务容器,startupProbe 比加重 liveness 更安全,可把启动窗口拉长到 5 分钟且不干扰健康判断。
使用InitContainer预检查依赖
将数据库、配置中心等外部依赖检查从主容器启动命令中剥离,放到 InitContainer 里,是防止“依赖未就绪导致 CrashLoop”最直接的办法。用轻量镜像如 busybox 执行 nc -zv mysql-svc 3306 或 curl 探测健康端点,主容器启动时环境已经验证通过。在 TKE 场景中,建议同时对 ConfigMap/Business Key 的存在性做断言,避免因为少了一个密钥文件而在启动 3 秒后退出。这部分逻辑一旦标准化,能降低至少五成的新部署故障。
以上策略落地后,仍需要配合 --previous 日志和事件日志形成验证闭环。对于没有专门 SRE 的团队,也可以考虑请云老大这类外部服务商做一次集群巡检和 CrashLoop 场景复盘,把高频故障点固化为 HPA/PDB 联动规则、自动收集上次崩溃日志的 sidecar,省去反复排查的人工消耗。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号