服务器机房动环开发:POE以太网温湿度传感器UDP报文解析与服务器入库实战
原创
服务器机房动环开发:POE以太网温湿度传感器UDP报文解析与服务器入库实战
原创
盛世宏博科技
发布于 2026-09-24 15:32:04
发布于 2026-09-24 15:32:04
服务器机房动环开发:POE以太网温湿度传感器UDP报文解析与服务器入库实战
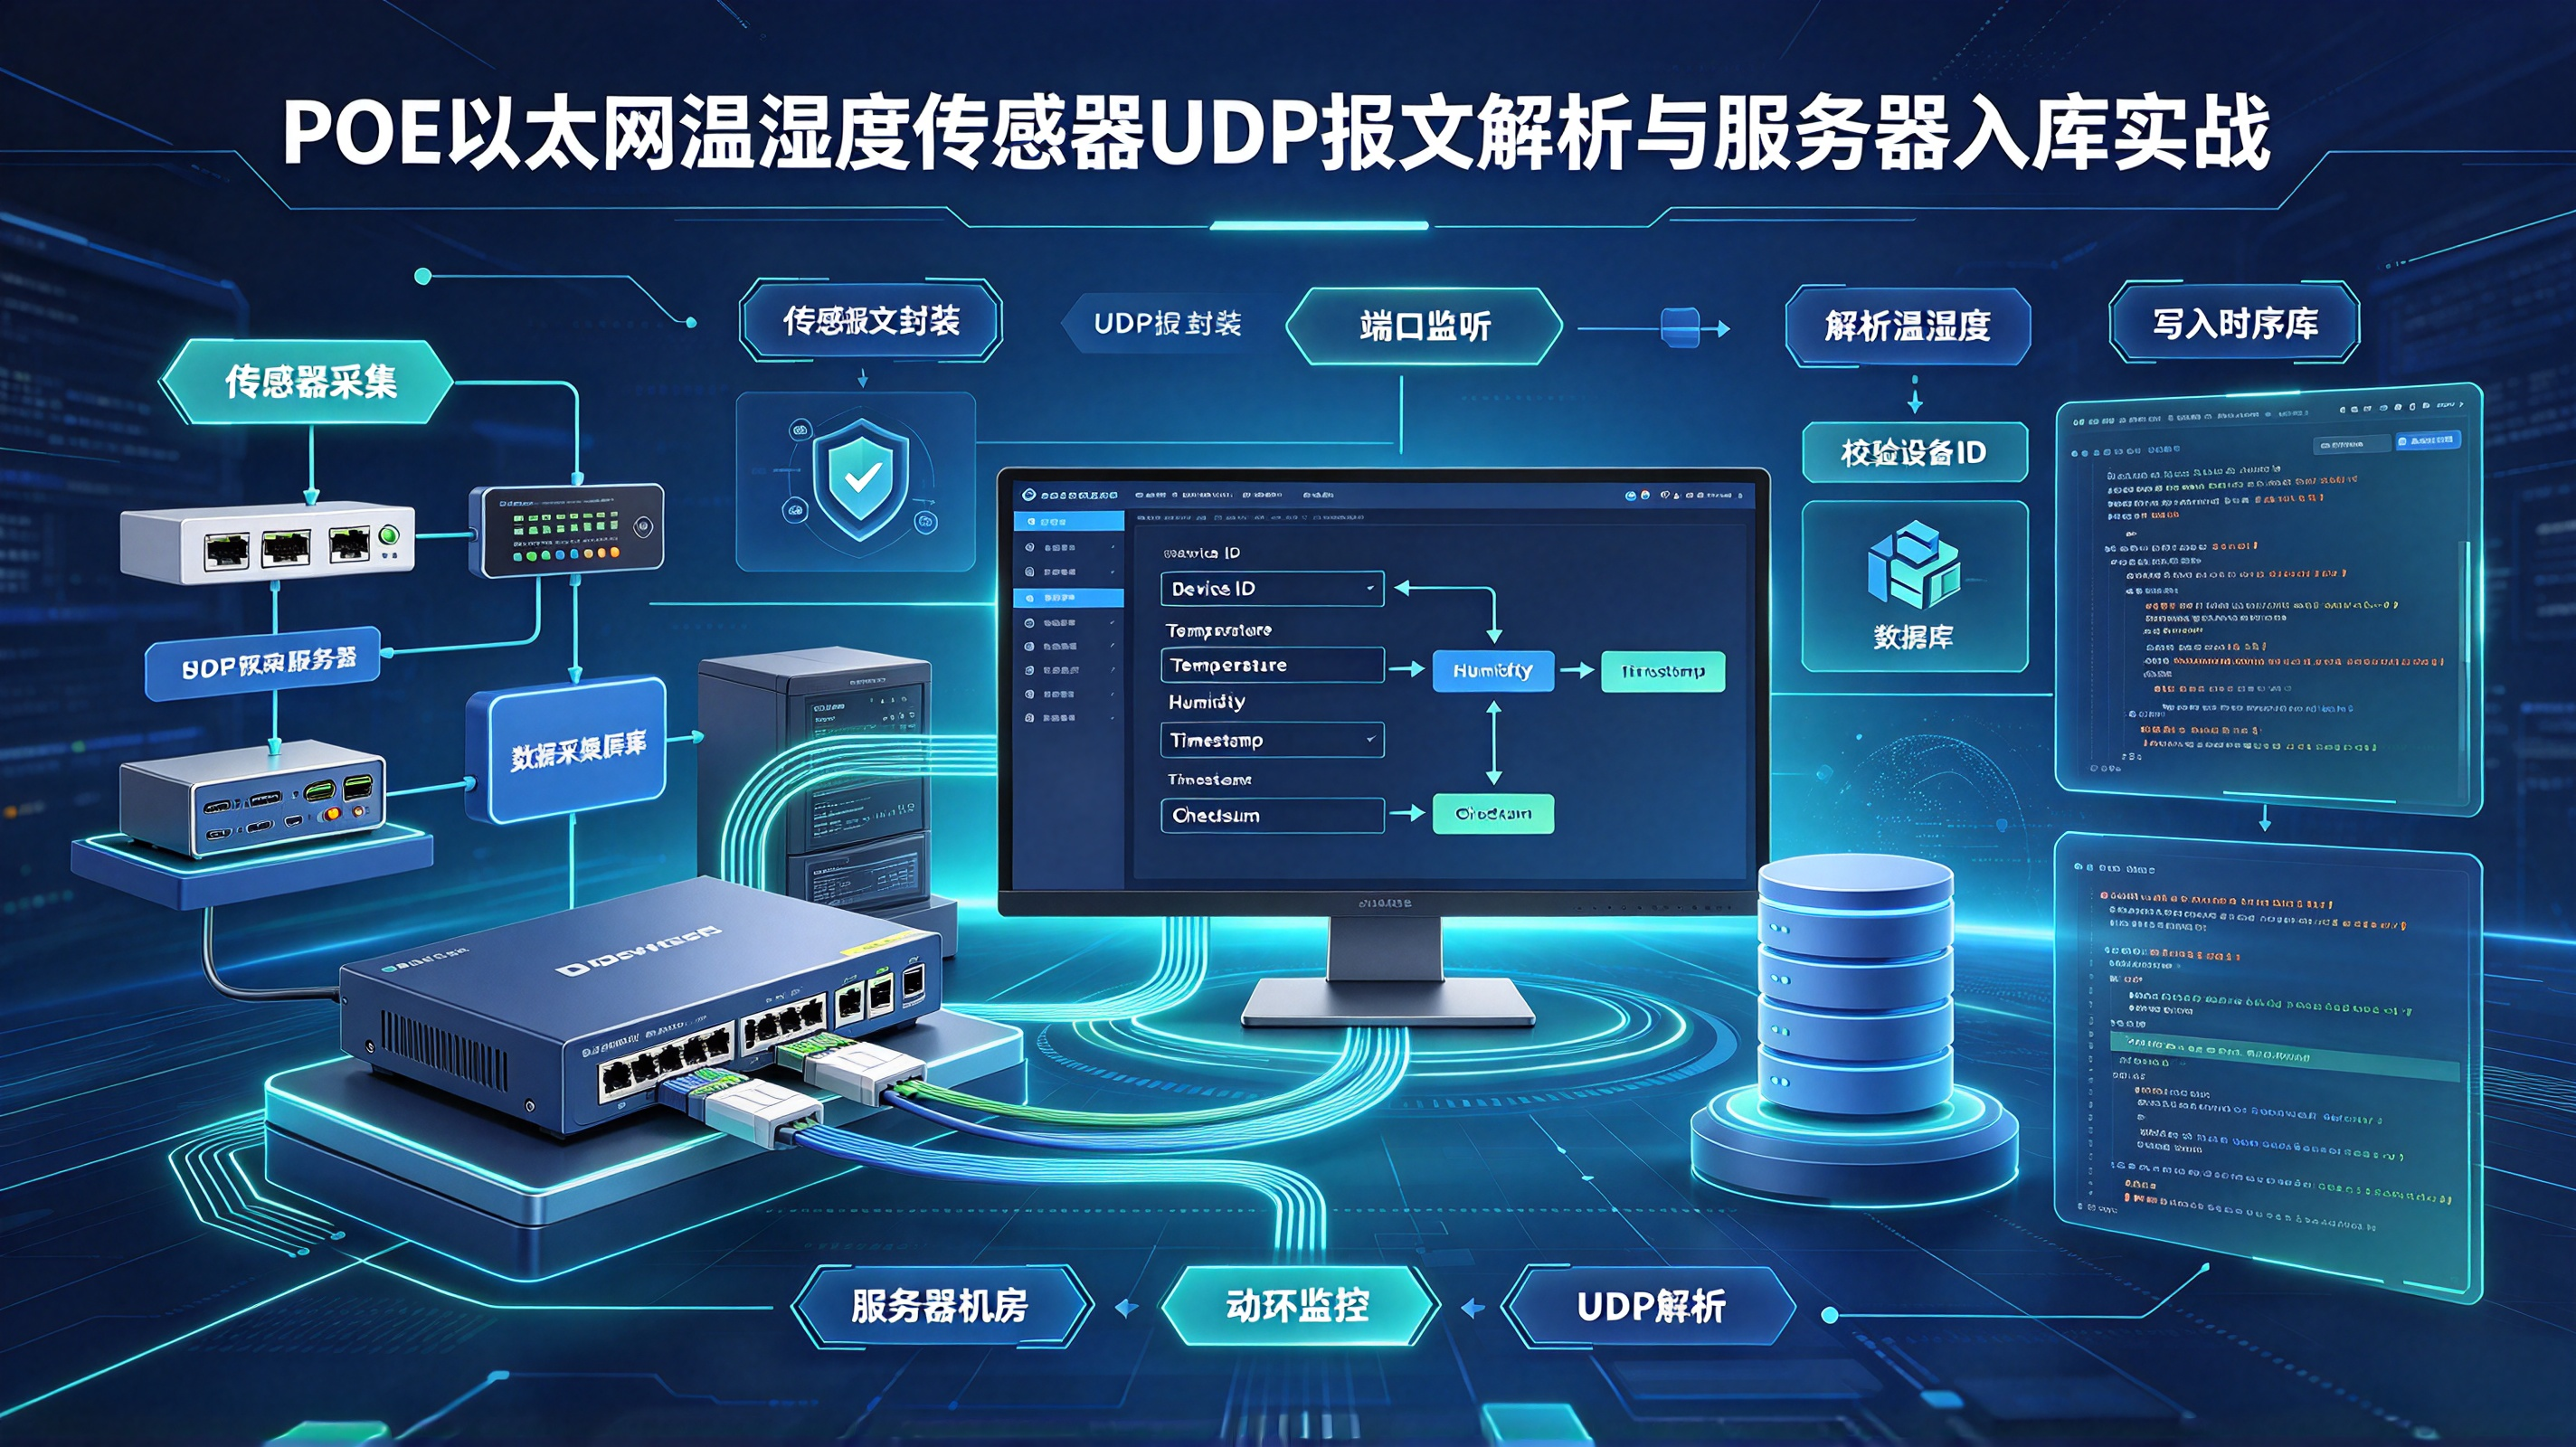
近期在调试一套工业环境监控系统时,遇到了关于Modbus连接保持的问题。现场部署了一批网口温湿度变送器,PoE取电、Modbus TCP上云,同时利旧接入存量RS485探头,并开启了SNMP和UDP Trap服务。服务器机房动环系统开发里,UDP通道常用于高频遥测和事件Trap,但工程落地时最容易被低估的环节是报文解析的健壮性——字节序、对齐、CRC、去重、乱序,任何一环处理不当都会导致入库数据错乱或丢失。这篇从报文定义、解析实现、入库落地到排障完整展开。
一、UDP报文格式定义
1.1 帧结构
与设备侧约定紧凑二进制帧,兼顾解析效率和传输可靠性:
// 设备端UDP上报帧(18字节)
typedef struct __attribute__((packed)) {
    uint16_t  header;        // 0x55AA 帧头
    uint8_t   dev_addr;      // 设备地址(1-247)
    uint8_t   msg_type;      // 0x01=周期遥测 0x02=事件Trap
    uint16_t  seq;           // 序列号,单调递增,用于去重和丢包检测
    uint32_t  timestamp;     // 采集时间戳(Unix epoch,设备RTC)
    int16_t   temperature;   // 温度 ×100,范围 -40.00 ~ +85.00℃
    uint16_t  humidity;      // 湿度 ×10,范围 0.0 ~ 100.0%
    uint16_t  voltage;       // PoE供电电压 ×100,范围 0.00 ~ 60.00V
    uint8_t   status;        // 状态位:bit0=传感器故障 bit1=低电压 bit2=越限
    uint16_t  crc16;         // CRC-16/Modbus,覆盖前16字节
} udp_frame_t; // 总计18字节设计要点:
__attribute__((packed))禁止编译器填充对齐字节,确保内存布局与线上字节流一致- CRC-16/Modbus覆盖从header到status的全部字段,接收端校验不通过直接丢弃
- 序列号采用uint16_t自然回绕,接收端用模运算处理回绕
1.2 字节序约定
设备端(嵌入式小端)发送时用网络字节序(大端)编码多字节字段,服务器端按大端解析:
字段 | 长度 | 字节序 | 说明 |
|---|---|---|---|
header | 2 | 大端 | 固定0x55AA |
dev_addr | 1 | - | 单字节无字节序问题 |
msg_type | 1 | - | 单字节 |
seq | 2 | 大端 | 序列号 |
timestamp | 4 | 大端 | Unix时间戳 |
temperature | 2 | 大端 | 有符号,×100 |
humidity | 2 | 大端 | 无符号,×10 |
voltage | 2 | 大端 | 无符号,×100 |
status | 1 | - | 状态位 |
crc16 | 2 | 小端 | CRC-16/Modbus惯例 |
二、服务器端UDP接收与解析
2.1 异步UDP Server骨架
#!/usr/bin/env python3
"""
动环系统UDP接收服务 - POE以太网温湿度传感器
"""
import asyncio
import struct
import socket
from dataclasses import dataclass, field
from datetime import datetime, timezone
from typing import Dict, Optional
import crc16


@dataclass
class SensorReading:
    dev_addr: int
    msg_type: int
    seq: int
    timestamp: int
    temperature: float
    humidity: float
    voltage: float
    status: int
    source_ip: str
    recv_time: float = field(default_factory=lambda: asyncio.get_event_loop().time())


class UDPFrameParser:
    """UDP报文解析器"""

    FRAME_SIZE = 18
    HEADER_MAGIC = 0x55AA

    @classmethod
    def parse(cls, data: bytes, addr: tuple) -> Optional[SensorReading]:
        """解析UDP帧,失败返回None"""
        if len(data) != cls.FRAME_SIZE:
            return None

        # 解包前16字节(不含CRC)
        try:
            header, dev_addr, msg_type, seq = struct.unpack(">HBBH", data[:6])
        except struct.error:
            return None

        if header != cls.HEADER_MAGIC:
            return None

        # CRC校验
        crc_calc = crc16.modbus(data[:16])
        crc_recv = struct.unpack("<H", data[16:18])[0]
        if crc_calc != crc_recv:
            return None

        # 解包数据字段
        ts, temp_raw, hum_raw, volt_raw, status = struct.unpack(">IhHHH", data[6:16])

        # 缩放转换
        temperature = temp_raw / 100.0
        humidity = hum_raw / 10.0
        voltage = volt_raw / 100.0

        # 合理性校验
        if not (-40.0 <= temperature <= 85.0):
            return None
        if not (0.0 <= humidity <= 100.0):
            return None
        if not (0.0 <= voltage <= 60.0):
            return None

        return SensorReading(
            dev_addr=dev_addr,
            msg_type=msg_type,
            seq=seq,
            timestamp=ts,
            temperature=temperature,
            humidity=humidity,
            voltage=voltage,
            status=status,
            source_ip=addr[0],
        )


class Deduplicator:
    """序列号去重器,处理UDP重复包"""

    def __init__(self, window_size: int = 65536, ttl: float = 300.0):
        self._window: Dict[int, Dict[int, float]] = {}  # dev_addr -> {seq: recv_time}
        self._window_size = window_size
        self._ttl = ttl

    def is_duplicate(self, dev_addr: int, seq: int, now: float) -> bool:
        """检查是否为重复包"""
        # 清理过期条目
        if dev_addr in self._window:
            self._window[dev_addr] = {
                s: t for s, t in self._window[dev_addr].items()
                if now - t < self._ttl
            }
        else:
            self._window[dev_addr] = {}

        dev_window = self._window[dev_addr]

        # 检查重复
        if seq in dev_window:
            return True

        # 检查序列号回绕(uint16_t)
        # 如果当前seq比窗口中最大的小很多,可能是回绕后的新包
        if dev_window:
            max_seq = max(dev_window.keys())
            if seq < max_seq and (max_seq - seq) > 32768:
                # 回绕后新包,清理旧窗口
                dev_window.clear()

        dev_window[seq] = now
        return False


class UDPServerProtocol(asyncio.DatagramProtocol):
    """UDP服务器协议实现"""

    def __init__(self, parser: UDPFrameParser, dedup: Deduplicator,
                 handler: callable):
        self.parser = parser
        self.dedup = dedup
        self.handler = handler
        self._stats = {
            "received": 0,
            "parsed": 0,
            "duplicates": 0,
            "crc_errors": 0,
            "invalid": 0,
        }

    def datagram_received(self, data: bytes, addr: tuple):
        self._stats["received"] += 1

        reading = self.parser.parse(data, addr)
        if reading is None:
            self._stats["invalid"] += 1
            return

        # 去重
        now = asyncio.get_event_loop().time()
        if self.dedup.is_duplicate(reading.dev_addr, reading.seq, now):
            self._stats["duplicates"] += 1
            return

        self._stats["parsed"] += 1
        asyncio.create_task(self.handler(reading))

    def error_received(self, exc: Exception):
        print(f"UDP错误: {exc}")

    def get_stats(self) -> dict:
        return self._stats.copy()


async def start_udp_server(host: str, port: int, handler: callable) -> None:
    """启动UDP服务器"""
    parser = UDPFrameParser()
    dedup = Deduplicator()
    protocol = UDPServerProtocol(parser, dedup, handler)

    loop = asyncio.get_running_loop()
    transport, _ = await loop.create_datagram_endpoint(
        lambda: protocol,
        local_addr=(host, port),
    )

    print(f"UDP Server 监听 {host}:{port}")
    try:
        await asyncio.Event().wait()
    finally:
        transport.close()
2.2 报文解析关键点
1. 帧长度校验
UDP数据报可能包含多余字节(如代理转发时附加的元数据),必须先校验长度是否为18字节。
2. CRC校验
CRC-16/Modbus计算范围是从header到status(前16字节),CRC字段本身不参与计算。注意字节序:CRC字段用小端存储。
# CRC-16/Modbus实现
def crc16_modbus(data: bytes) -> int:
    crc = 0xFFFF
    for byte in data:
        crc ^= byte
        for _ in range(8):
            if crc & 0x0001:
                crc = (crc >> 1) ^ 0xA001
            else:
                crc >>= 1
    return crc & 0xFFFF
3. 合理性校验
即使CRC通过,也要对解析后的值做范围校验。网络中存在伪造包或内存损坏的可能。
4. 去重窗口
UDP无连接,设备侧事件Trap可能重发(如前文所述连续发3次),接收端必须去重。去重窗口按设备地址隔离,避免不同设备的序列号冲突。
三、数据入库实战
3.1 InfluxDB写入
from influxdb_client import InfluxDBClient, Point, WritePrecision
from influxdb_client.client.write_api import SYNCHRONOUS, ASYNCHRONOUS
import asyncio
from datetime import datetime, timezone


class InfluxDBWriter:
    """InfluxDB异步写入器"""

    def __init__(self, url: str, token: str, org: str, bucket: str):
        self.client = InfluxDBClient(url=url, token=token, org=org)
        self.write_api = self.client.write_api(write_options=ASYNCHRONOUS)
        self.bucket = bucket
        self.org = org
        self._queue = asyncio.Queue(maxsize=50000)
        self._running = False
        self._batch_size = 500
        self._flush_interval = 5.0  # 秒

    async def start(self):
        """启动后台写入任务"""
        self._running = True
        asyncio.create_task(self._batch_writer())

    async def stop(self):
        """停止写入任务"""
        self._running = False
        # 刷出剩余数据
        await self._flush()
        self.write_api.close()
        self.client.close()

    async def write(self, reading: SensorReading):
        """写入单条数据"""
        try:
            self._queue.put_nowait(reading)
        except asyncio.QueueFull:
            # 队列满时丢弃最旧数据,记录告警
            print(f"警告: 写入队列满,丢弃设备{reading.dev_addr}的数据")
            # 可选:写入本地文件兜底

    async def _batch_writer(self):
        """后台批量写入"""
        batch = []
        last_flush = asyncio.get_event_loop().time()

        while self._running:
            try:
                # 等待数据,超时则检查是否需要flush
                timeout = self._flush_interval - (asyncio.get_event_loop().time() - last_flush)
                if timeout > 0:
                    reading = await asyncio.wait_for(self._queue.get(), timeout=timeout)
                    batch.append(reading)

                # 达到批量大小或超时,执行flush
                now = asyncio.get_event_loop().time()
                if len(batch) >= self._batch_size or (now - last_flush) >= self._flush_interval:
                    if batch:
                        await self._flush_batch(batch)
                        batch.clear()
                        last_flush = now

            except asyncio.TimeoutError:
                # 超时,flush当前批次
                if batch:
                    await self._flush_batch(batch)
                    batch.clear()
                    last_flush = asyncio.get_event_loop().time()
            except Exception as e:
                print(f"批量写入异常: {e}")
                await asyncio.sleep(1)

    async def _flush_batch(self, batch: list):
        """刷出一批数据到InfluxDB"""
        points = []
        for r in batch:
            # 主测量值
            point = Point("env_sensor") \
                .tag("device", f"sensor_{r.dev_addr:03d}") \
                .tag("msg_type", "trap" if r.msg_type == 0x02 else "telemetry") \
                .tag("source_ip", r.source_ip) \
                .field("temperature", r.temperature) \
                .field("humidity", r.humidity) \
                .field("voltage", r.voltage) \
                .field("status", r.status) \
                .time(datetime.fromtimestamp(r.timestamp, tz=timezone.utc),
                      WritePrecision.S)
            points.append(point)

        try:
            self.write_api.write(bucket=self.bucket, org=self.org, record=points)
        except Exception as e:
            print(f"InfluxDB写入失败: {e}")
            # 写入失败,重新入队或落本地文件
            await self._fallback(batch)

    async def _fallback(self, batch: list):
        """写入失败时的本地兜底"""
        import json
        try:
            with open("influx_fallback.jsonl", "a") as f:
                for r in batch:
                    f.write(json.dumps({
                        "dev_addr": r.dev_addr,
                        "timestamp": r.timestamp,
                        "temperature": r.temperature,
                        "humidity": r.humidity,
                        "voltage": r.voltage,
                        "status": r.status,
                    }) + "\n")
        except Exception as e:
            print(f"兜底文件写入失败: {e}")
3.2 数据模型设计
InfluxDB中推荐的数据模型:
元素 | 值 | 说明 |
|---|---|---|
Measurement | env_sensor | 环境传感器测量值 |
Tag: device | sensor_001 | 设备标识,用于分组和查询 |
Tag: msg_type | telemetry / trap | 消息类型 |
Tag: source_ip | 10.10.21.11 | 数据源IP |
Field: temperature | float | 温度(℃) |
Field: humidity | float | 湿度(%) |
Field: voltage | float | 供电电压(V) |
Field: status | int | 状态位 |
Timestamp | Unix epoch | 采集时间(设备RTC) |
查询示例:
-- 查询某设备最近1小时的温度
SELECT mean(temperature) FROM env_sensor
WHERE device='sensor_001' AND time > now() - 1h
GROUP BY time(1m)

-- 查询所有设备当前电压状态
SELECT last(voltage) FROM env_sensor
WHERE time > now() - 5m
GROUP BY device

-- 查询Trap事件
SELECT * FROM env_sensor
WHERE msg_type='trap' AND time > now() - 1h
3.3 主程序集成
#!/usr/bin/env python3
"""
动环系统主程序 - UDP接收 + 解析 + 入库
"""
import asyncio
import signal
import sys


async def handle_reading(reading: SensorReading, writer: InfluxDBWriter):
    """处理解析后的数据"""
    # 打印日志
    msg_type_str = "Trap" if reading.msg_type == 0x02 else "遥测"
    print(f"[{datetime.now().strftime('%H:%M:%S')}] {msg_type_str} "
          f"设备{reading.dev_addr:03d} "
          f"T={reading.temperature:.1f}℃ "
          f"H={reading.humidity:.1f}% "
          f"V={reading.voltage:.2f}V "
          f"Status=0x{reading.status:02X}")

    # 写入InfluxDB
    await writer.write(reading)


async def main():
    # InfluxDB配置
    influx_url = "http://localhost:8086"
    influx_token = "your-token"
    influx_org = "your-org"
    influx_bucket = "env_monitor"

    # 创建写入器
    writer = InfluxDBWriter(influx_url, influx_token, influx_org, influx_bucket)
    await writer.start()

    # 启动UDP服务器
    udp_task = asyncio.create_task(
        start_udp_server("0.0.0.0", 9000,
                         lambda r: handle_reading(r, writer))
    )

    # 优雅退出
    loop = asyncio.get_running_loop()
    stop_event = asyncio.Event()

    for sig in (signal.SIGINT, signal.SIGTERM):
        loop.add_signal_handler(sig, stop_event.set)

    await stop_event.wait()

    print("正在关闭...")
    udp_task.cancel()
    await writer.stop()
    print("已关闭")


if __name__ == "__main__":
    asyncio.run(main())
四、排障与监控
4.1 常见解析失败原因
现象 | 原因 | 排查方法 |
|---|---|---|
CRC校验失败率高 | 网络比特翻转、设备端CRC计算错误 | Wireshark抓包对比 |
温度值异常(如-327.68℃) | 字节序错误,未做缩放或缩放倍数不对 | 打印原始hex对比 |
湿度>100% | 寄存器映射版本不匹配 | 核对固件版本与映射表 |
序列号跳跃大 | 设备重启后seq重置 | 去重窗口应处理重启 |
重复包多 | 设备侧重发机制或网络层重传 | 检查去重逻辑是否生效 |
部分设备无数据 | 防火墙拦截、IP冲突、PoE供电不足 | 从物理层逐段排查 |
4.2 监控指标
# 暴露Prometheus指标
from prometheus_client import Counter, Gauge, Histogram

UDP_RECEIVED = Counter('udp_received_total', 'UDP数据报接收总数', ['device'])
UDP_PARSED = Counter('udp_parsed_total', 'UDP解析成功数', ['device'])
UDP_DUPLICATES = Counter('udp_duplicates_total', 'UDP重复包数', ['device'])
UDP_CRC_ERRORS = Counter('udp_crc_errors_total', 'UDP CRC错误数', ['device'])
INFLUX_WRITE_LATENCY = Histogram('influx_write_latency_seconds', 'InfluxDB写入延迟')
INFLUX_QUEUE_SIZE = Gauge('influx_queue_size', 'InfluxDB写入队列长度')
4.3 Wireshark过滤表达式
# 过滤特定设备的UDP包
udp.port == 9000 && ip.src == 10.10.21.11

# 查看UDP重传
udp.analysis.retransmission

# 导出原始字节
Follow → UDP Stream → Show data as Hex Dump
五、性能优化
5.1 解析性能
- 零拷贝解析:使用
struct.unpack_from直接从bytes对象解析,避免中间拷贝 - 批量处理:UDP Server的
datagram_received中不要做重IO操作,快速解析后放入队列 - 连接池:InfluxDB写入使用异步连接池,避免每次写入都建立连接
5.2 内存优化
- 对象复用:
SensorReading使用__slots__减少内存开销 - 队列限流:有界队列防止内存无限增长
- 去重窗口清理:定期清理过期条目,防止内存泄漏
5.3 网络优化
- SO_RCVBUF:增大UDP接收缓冲区
sock.setsockopt(socket.SOL_SOCKET, socket.SO_RCVBUF, 1024 * 1024) # 1MB- CPU亲和性:多核服务器上绑定UDP接收进程到特定CPU
- RSS:网卡接收端缩放,多队列分发
六、工程交付检查表
- [ ] UDP端口防火墙放通(入站+回程)
- [ ] 设备端IP地址规划表(IP-MAC-位置-供电域)
- [ ] 报文格式文档(帧结构、字节序、CRC算法)
- [ ] 解析服务部署脚本(systemd unit文件)
- [ ] InfluxDB数据库初始化(bucket、retention policy、token)
- [ ] 监控面板(Grafana仪表盘:采集率、丢包率、温度趋势)
- [ ] 告警规则(温度越限、电压异常、设备离线)
- [ ] 日志轮转配置(logrotate)
- [ ] 兜底文件清理策略(定期导入后删除)
- [ ] 文档交付(部署手册、排障手册、API说明)
七、关键词
服务器机房、动环系统、POE以太网温湿度传感器、UDP报文解析、二进制帧、CRC校验、序列号去重、InfluxDB入库、异步写入、数据模型、性能优化、工程交付
八、一句话总结
UDP报文解析的工程核心在于健壮性:严格校验帧长度、CRC、数值合理性,用序列号去重窗口处理重复包,解析后的数据异步批量写入InfluxDB并保留采集时间戳,写入失败时本地兜底防止数据丢失。解析服务本身要暴露监控指标,从接收计数到入库延迟全链路可观测,确保动环系统的数据质量和稳定性。
物联网 #Modbus #TCP/IP #UDP #POE供电 #腾讯云 #Wireshark #Python #InfluxDB #以太网温湿度传感器 #网口温湿度变送器 #机房监控 #动环系统 #UDP解析 #InfluxDB #工业物联网
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号