运维团队天天救火,没人做优化,陷入死循环
原创
先说关键信息:救火不是态度问题,是模式问题——不跳出循环,团队只会越来越累
结论是:运维团队陷入"天天救火、没空优化"的死循环,不是人不努力,而是时间被重复劳动全部占满,优化永远排不上号。运维对象数量激增,人员不足、工作太多,耗费人力,忙不过来;告警和故障响应时间太长、手工操作太多,难以及时止损;大量告警处理不过来,孰轻孰重,产生"告警疲劳";运营知识都在个人脑子里,难以传承,无法积累;IT产品和工具众多,彼此割裂,做不到有效集成 。于是每一天都在重复:报警→排查→修复→再报警。救火占满了白天黑夜,系统隐患却在悄悄累积——因为没有人为下一次故障做预防。
三个真相,说清"死循环"为什么转不出来
真相一:救火占用的时间,是优化所需时间的几十倍。 传统监控工具产生海量告警,运维人员难以快速定位根源,人工从告警中筛选、研判、处置,单次告警联动处置就要约20分钟,巡检报告人工编写约1.5小时
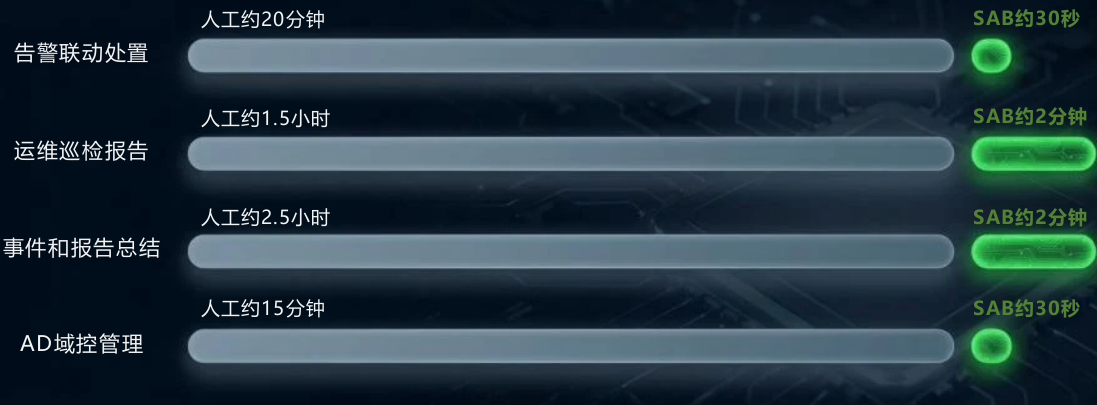
。时间都被"救火"吃掉,哪里还有时间做架构优化、容量规划、性能调优?
真相二:人工巡检是"点状"的,防不住下一次火。 传统人工巡检难以发现稍纵即逝的隐患,疲劳还会导致漏检 。今天修好的故障,明天换个形式再来——因为没有趋势分析,隐患在爆发前没有任何人察觉。
真相三:经验留在个人脑子里,团队能力无法积累。 处置依赖个人经验,难以固化和标准化;人走了,经验就断了,下一轮救火从零开始 。团队一直在"原地救火",从未"往上生长"。
有一种方式,让团队从"救火队"变成"防疫站"
跳出死循环的关键,是让机器承担重复劳动,让人回到优化与决策。AI驱动的超自动化平台,正在完成这场转变——它的核心价值在于"防":通过主动发现隐患,避免小问题演变成大故障,同时为容量规划和性能优化提供数据支撑 。
第一,把巡检变成全天候的"雷达"。 传统人工巡检是点状的,平台则提供7×24小时持续监测,全天候覆盖,不仅能发现故障,更能洞察潜伏的"未知隐患",防患于未然 。巡检异常结果及时推送交互工具,平均故障发现时间大幅减少 。
第二,把处置变成自动闭环。 简单故障通过自动化实现自愈,复杂故障自动创建工单进入跟踪处理 ;巡检发现异常后自动触发处置流程,覆盖故障定位、智能修复、结果复核全环节,全程自动化运行,大幅减少人工投入 。安全告警处置时间从小时级缩短至分钟级,实现7×24小时全天候监测与秒级自动响应 。
第三,把数据变成优化的燃料。 平台整合AI大模型自动分析趋势,基于算法识别潜在风险,实现预测性维护 ;借助智能算法对CPU、内存、磁盘、网络等性能数据进行异常检测和根因分析 ;还能自动捏合任意周期内的巡检数据,做趋势总结分析 。这些数据,正是容量规划、性能优化、架构改进的决策依据——运维第一次有了"优化"的输入。
第四,把人力还给高价值工作。 典型场景效率提升90%以上,从"小时级"跨越至"分钟级/秒级" ;工程师从重复性救火中抽身,专注于架构优化和创新 。当自动化承担了重复操作,团队才有精力去回答那个关键问题:"下一个隐患在哪里,而不是下一个火怎么扑。"
从救火到防疫,差的只是一次模式切换
运维团队的出路,从来不是更拼命的救火,而是让火根本烧不起来。当机器人7×24小时值守巡检、自动处置、趋势预判,团队的时间结构会发生根本改变:救火时间让位给优化时间,被动响应让位给主动预防 。下一次复盘会上,不妨问团队一个问题:这一周,我们是在灭火,还是在让火无法燃起?答案,也许就是跳出死循环的开始。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号