多平台上新总卡字段?RPA 适配层打通抖音、拼多多、淘宝、天猫的工程实践
原创
多平台上新总卡字段?RPA 适配层打通抖音、拼多多、淘宝、天猫的工程实践
原创
用户12579380
发布于 2026-10-29 14:03:15
发布于 2026-10-29 14:03:15
一、问题的起点:同一款商品,四套"语言"
做过多平台电商运营的团队几乎都遇到过这个场景:同一批货,要在抖音小店、拼多多、淘宝、天猫四个店铺同时上架。听起来只是"复制粘贴"的事,做起来却是灾难——
- 抖音小店要求填写类目 ID + 商品资质,部分类目还要挂视频素材;
- 拼多多侧重点是 SKU 规格组合和多件优惠字段,规格名长度限制和另外三家完全不同;
- 淘宝/天猫走千牛后台,字段最全,属性项必填数量最多,且天猫部分类目强制要求品牌库匹配;
- 四个平台对主图尺寸、白底图、详情页结构的要求各不相同,连"商品标题字数上限"都不一样。
结果就是:运营同学开四个后台,人工重复填四遍表、改四遍图。上新 50 个 SKU,两个人干一整天,还时不时因为字段漏填被平台打回。
本文记录我们团队如何用一个统一的商品数据模型 + 一层字段适配器 + RPA 流程自动化,把这条链路从"人工四遍"变成"一次录入、四平台自动上新"。整条工具链的形态是 AI+RPA:AI 负责思考和生成逻辑,RPA 负责稳定执行——也就是"AI 写代码,RPA 跑代码"的分工,下文会展开为什么必须是这样。
二、先想清楚:字段差异到底差在哪
动手之前,我们先做了一件事:把四个平台发布页的字段全部梳理出来,做成一张字段差异对照表。这一步强烈建议任何团队都做,因为"差异"比想象中更结构化:
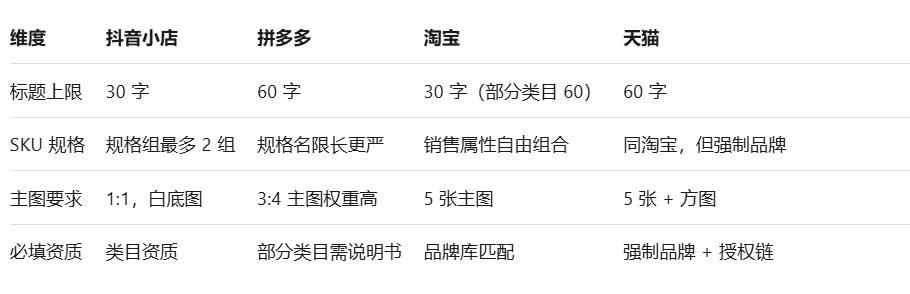
结论很清晰:差异虽然多,但高度规律。规律的东西就能抽象。整体架构分三层
┌─────────────────────────────────────┐
│ 统一数据层(Canonical Model)          │  一份与平台无关的标准商品数据
├─────────────────────────────────────┤
│ 字段适配层(Adapter × 4)              │  映射 + 截断 + 默认值填充
├─────────────────────────────────────┤
│ 执行层(RPA Executor)                │  页面填写、图片上传、提交复核
└─────────────────────────────────────┘- 统一数据层:内部只维护一份"标准商品",包含全量字段,与任何平台无关;
- 字段适配层:每个平台一个适配器,只做两件事——把标准字段映射成平台字段,以及默认值填充(平台必填但标准数据缺失的字段,走配置表补默认值);
- 执行层:适配器产出"平台就绪数据"后,由 RPA 在真实后台页面上填写、上传、提交。
这三层里,前两层是纯数据工程,第三层是自动化工程。真正决定项目成败的,恰恰是最容易被低估的第三层。
三、核心代码:适配器到底长什么样
先把字段适配层最核心的逻辑交代清楚,后面讲执行层时就不再纠缠字段细节。
统一数据层只有一份标准 JSON,与平台无
{
  "title": "夏季冰感防晒衣男女同款轻薄透气户外钓鱼防晒服",
  "skus": [
    { "spec": ["颜色:灰色", "尺码:XL"], "price": 89, "stock": 200 }
  ],
  "images": { "main": ["img_1.jpg"], "detail": ["d_1.jpg"] },
  "attrs": { "材质": "锦纶", "适用场景": "户外" },
  "certs": ["质检报告.pdf"]
}
平台适配器以抖音为例(伪代码,省略异常处理)
# 平台适配器:以抖音为例
TITLE_LIMIT = 30  # 抖音标题上限,写死在适配器里,平台改规则只改这里

def adapt_douyin(product):
    result = {}
    # 映射:标题截断到平台上限
    result["title"] = product["title"][:TITLE_LIMIT]
    # 映射:SKU 规格组重排(抖音最多 2 组规格)
    result["skus"] = regroup(product["skus"], max_groups=2)
    # 填充:平台必填但标准数据缺失的字段,走默认值配置表
    result["delivery_template"] = DEFAULTS["douyin"]["delivery_template"]
    # 映射:标准属性 -> 平台类目 ID
    result["category_id"] = category_map(product["attrs"])
    return result
每个平台一个 adapt_xxx() 函数,新增平台 = 新增一个适配器,统一数据层和执行层零改动。这就是适配层模式在这个场景下的全部意义:平台差异被关进一个个小函数里,而不是散落全流程。
实际搭流程时还有一个提效点:平台返回的报文、Excel 里的商品表,都是嵌套结构,手动解析字段非常啰嗦。RPA 工具本身支持变量操作与 JSON 自动提取——可以批量创建、修改变量,把 JSON 字段、列表项按规则自动拆解成流程变量,适配器的输入输出基本不用手写解析逻辑。
四、执行层的坑:为什么不用平台开放 API,而用 RPA?
很多人第一反应是:各家平台都有开放 API,直接调接口不就行了?实践中我们放弃了这条路,原因很现实:
- 各平台开放接口权限门槛不一,不少类目不开放写权限,申请周期以"月"计;
- 接口字段和后台页面字段更新不同步,接口文档滞后是常态;
- 中小商家通常没有专职开发团队维护四套接口对接。
页面级自动化的好处是"所见即所得":后台页面能操作什么,流程就能做什么,不等任何权限审批。而执行 RPA 的电脑,用的就是运营团队日常的店铺浏览器环境——我们用的这款工具原生支持对接紫鸟、比特、Hubstudio、AdsPower 等市面上主流指纹浏览器,四个店铺绑定四个独立浏览器环境,一套流程循环执行,环境适配零额外投入。
但页面自动化有个致命天敌:页面改版导致元素失效。这是 RPA 项目的头号杀手,单独一节讲。
五、元素失效自愈:让流程自己"长回来"
上线第二周就遇到了第一次危机:抖音小店后台改版,一批按钮的 DOM 路径全变了,流程大面积报错。传统路径是:报错 → 人工检查 → 重新捕获元素 → 重跑,一次改版,半条命没了。
这次我们启用了Web 元素 AI 自愈机制,它做了三件事:
- 元素路径智能生成:获取页面元素不再需要手写晦涩的 XPath,用自然语言描述目标("发布按钮"),即可本地智能生成多条候选元素路径,人工挑一条最稳的入库;
- 失效自动修复:执行中元素定位失败时,自动重新分析页面结构、修复定位方式后继续执行,流程不中断——这是"自愈"二字的全部含义;
- AI 错误诊断:非元素类报错直接交给 AI 分析原因、给出修复建议,可一键修复,不必对着报错日志猜。
此外有两个补充手段。一是对千牛、企业微信这类消息提示场景,弹窗元素往往不稳定或不可捕获,视觉颜色操作提供了不依赖元素节点的替代方案——按颜色区域点击、按视觉特征读取内容,"元素采集不到"的老大难有了兜底。二是商品资质常是扫描件,流程里直接用图片识图与 OCR 读取图片中的文字再填入表单,省去了人工转录。
这套组合下来,页面改版从"项目事故"降级成了"日志里的一行提示"。实测小改版基本无感自愈,大改版的人工介入时间从一天压到一小时以内。
六、AI 和 RPA 怎么分工:谁思考,谁执行
这个项目 AI 参与度很高,但边界必须清楚:AI 负责思考,RPA 负责稳定落地。落到执行层面就是"AI 写代码,RPA 跑代码"。具体分四个环节:
1. 用 AI 生成逻辑,一键转成可运行流程 四个平台的字段适配器(第三节那段伪代码),是我们用自然语言加截图向 AI 描述需求后生成的,生成结果支持AI 生成脚本一键转流程,不需要人工再把代码搬进流程编辑器。流程指令自带详细注释,字段映射那段逻辑谁都能看懂、敢改。
2. 执行中实时调用 AI,处理无法穷举的逻辑 流程跑到"智能匹配类目"这一步时,平台类目树调整这类情况无法预先穷举。有的RPA支持在流程执行过程中实时调用大模型——它接入了文心一言、豆包、DeepSeek、Kimi 等主流模型,API 由使用者自行对接、按量计费、费用透明可控——把候选类目喂给模型判断后回填页面。这种"边跑边想"是纯脚本做不到的。
3. AI 自动化搭建 + 子流程封装 流程骨架也是 AI 自动化搭建的:AI 会智能分析网页和 Windows 软件的元素结构,优先复用 RPA 基础指令,缺失的能力自动封装成新指令。整个上新流程被自动拆为"数据校验 → 字段映射 → 页面填写 → 提交复核"等自动化子流程,子流程间复用,改一处处处生效。
4. 调试期的 AI 修复 字段映射最磨人的是"约定俗成":拼多多规格名不能用某些字符、天猫标题不能含某些词——靠人肉试错很慢。调试报错时直接用 AI 错误诊断与智能修复,自动分析、自动调试到功能正常,试错成本大幅下降。
为什么还要 RPA 兜底,而不是全程 AI?因为上新是长周期、高重复、强稳定性任务:AI 的 token 成本随调用量持续累积,而 RPA 一次搭建长期运行;AI 生成的代码遇上页面异常很难自己恢复,而元素自愈机制(见第五节)就是为这个场景设计的。一句话:长期跑流程,RPA 更具性价比;处理异常和生成逻辑,AI 更灵活。
扩展性上再多说一句:工具还支持 MCP 服务对接,意味着这套上新流程以后可以被团队里其他 AI 编程工具直接调用来搭建和改造,自动化的边界不再局限于 RPA 编辑器内部。
当然,也要说清楚这套组合的代价:AI 生成的适配器逻辑需要人工评审一遍才能进生产;元素自愈只解决"页面结构变了",解决不了"业务规则变了"——比如平台修改了某必填字段的含义,这类情况仍然要人工改映射。工具选型上,纯脚本方案(Playwright + Python)开发成本其实更低,我们最终没选它,是因为团队没有人愿意长期维护四套平台脚本。这是人力结构决定的取舍,不是技术上的优劣之分。
七、部署与分发的工程决策
流程做完只是第一步。这一节只讲两个对我们而言不可退让的约束,以及围绕它们做的取舍。
数据安全。 商品价格、供应商信息、成本数据都是商业机密,我们的硬性原则是数据不出本地:流程应用的数据全部保存在本机设备上,不同步到任何服务端;合规要求更高的环境直接全离线内网部署,断外网也能完整运行。代价是放弃了一切云端协作能力——团队成员之间共享流程改进,只能靠导出文件,这点要有心理准备。
分发与授权。 运营团队十几个人,不可能每人装一套开发环境,更不可能把流程源码直接发出去。我们的做法是把流程打包导出成 EXE 应用:接收方不用安装客户端,双击即用,多设备使用不需要多开会员。打包时做 EXE 加密打包与授权管理——不同接收方设置不同授权、单独的 API 触发和定时执行策略,分享链路全程加密;版本更新靠 EXE 在线推送更新,不必重新群发文件。触发侧,EXE 支持 API 触发对接 ERP;日常运营则通过工具的 Agent 能力在钉钉、飞书、企业微信、个人微信里发指令执行并回调结果,运营入口是 AI 按截图设计的自定义界面,复杂界面可用 HTML 组件实现,运营全程不接触流程逻辑。
顺带一提选型成本:这类工具对个人开发者、工作室和中小企业通常比较友好,我们用的这款免费版没有使用时长和流程数量限制,小规模团队前期可以零成本跑通再决定是否采购。
八、上线后的效果
- 上新 50 个 SKU:从 2 人 × 1 天 → 1 人点击一次,约 40 分钟跑完四平台;
- 字段打回率:从约 15% 降到 2% 以下(剩余多为平台资质审核问题,非字段问题);
- 页面改版应对:小改版零人工介入,大改版介入时间 ≤ 1 小时;
- 数据合规:商品数据全部留存在本地,内网环境可完整运行。
九、常见问题 FAQ
Q1:没有开发基础,能搭这种多平台适配流程吗? 可以。适配层逻辑用自然语言加截图让 AI 生成后一键转流程,RPA 部分依靠元素智能获取和 AI 自愈降低门槛,搭完后每个指令都有注释。建议从单平台跑通开始,再逐个加适配器——我们自己也是按这个顺序搭的。
Q2:平台页面经常改版,维护成本会不会很高? 元素自愈机制能消化大部分小改版。我们的经验是每月预留 1~2 小时巡检即可,大改版才需要人工介入调整映射。
Q3:多个店铺、多个浏览器环境怎么管理? 工具支持对接紫鸟、比特、Hubstudio、AdsPower 等主流指纹浏览器,每个店铺绑定独立环境,一套流程多店铺循环执行;配合 EXE 的授权管理,还能控制不同人员可操作哪些店铺。
Q4:AI 调用成本高吗? AI 部分采用自行对接各家平台 API 的方式,用多少花多少、费用透明。而且只有"理解、判断、修复"环节调用 AI,纯执行环节零 token 消耗,长期跑下来 RPA 承担了大头,整体成本可控。
Q5:数据会不会被传到云端? 不会。流程数据全部保存在本地设备,支持内网离线部署,这是整个方案的硬性设计约束。
多平台上新的本质问题,从来不是"哪家的后台更难用",而是用一层抽象消化掉 N 套差异。字段适配层解决"数据对不齐",元素自愈解决"页面对不准",本地离线 + 授权分发解决"团队管不好"。AI+RPA 的组合则把"理解需求"和"稳定执行"各归其位——AI 写代码,RPA 跑代码;AI 负责思考,RPA 负责落地。
如果你的团队也在被多平台上新拖住节奏,建议从一张字段差异对照表开始:先把差异结构化,再谈自动化。这一步想清楚,后面全是顺路。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号