#WorkBuddy# 朱雀AI检测每天卡5次,我把网页版换成了官方API
原创
#WorkBuddy# 朱雀AI检测每天卡5次,我把网页版换成了官方API
原创
用户12862492
发布于 2026-10-31 11:52:22
发布于 2026-10-31 11:52:22
第五次用完之后,页面只给我两个字:已达上限。
没有剩余次数,没有恢复时间,什么解释都没有。那天我手上压着十篇稿要轮着改,每改一版就得知道它现在到底什么分数。五次不够用,差得很远。
我先怀疑是自己这边的问题。页面确实会在浏览器里存一个指纹串,三十二位十六进制,看着就像配额的钥匙。我改过它,同一个浏览器同一分钟改完刷新,验证码照样过,服务端照样拒绝。换浏览器,清缓存,开隐私模式,都不行。我又去翻本机的网卡,确认只有一块以太网适配器,没有可用的 IPv6 地址——想换个出口这条路也堵着。半天时间全花在这些地方。
现在回头看,那时候其实已经可以得出结论了,但我不想承认,总觉得再试一种办法就能通。
转机是从文档来的。腾讯把朱雀做成了一个叫 EdgeOne Makers 服务的内置模型,模型名 @makers/zhuque-text,官方文档里给了 HTTP 地址,也写了怎么用 Key 鉴权。这条路是不走网页版那套 WebSocket 的,自然也就不占用它那个每天的额度。
在控制台里点创建 API Key 的时候,我犹豫了一下,怕它会让我绑卡。没有。复制出来那串 Key,填进请求头,第一次调用两百七十毫秒返回。那天我把十篇稿一次性全发了出去。
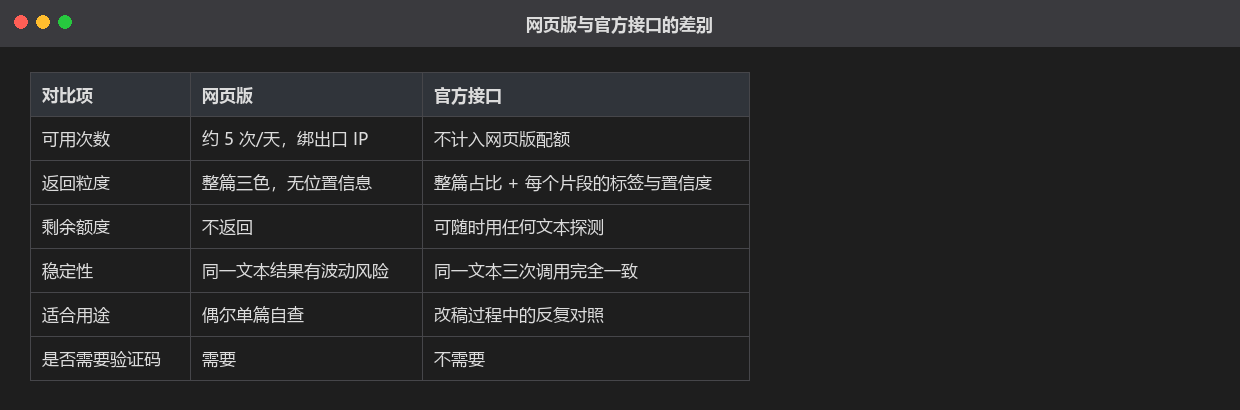
网页版与 API 的差别:额度绑定方式、返回字段、是否支持批量
返回值里有两块东西值得看。一块是整篇的三类占比,人工、AI、疑似各占多少。另一块更有用:它会把正文切成若干片段,每一段都带上标签、置信度和起始位置。也就是说它不只告诉你这篇行不行,还告诉你是哪一段拖了后腿。改稿的时候这个差别非常大——以前对着一个总分猜,现在是定点改。
还有件事是反复调用之后才发现的:这个接口的结果是稳定的。同一段文本连续发三次,返回的三个百分比一模一样。这看着不起眼,实际上决定了整套工作流能不能成立。如果不稳定,改完再测看到的差异就分不清是文本变了还是运气变了。
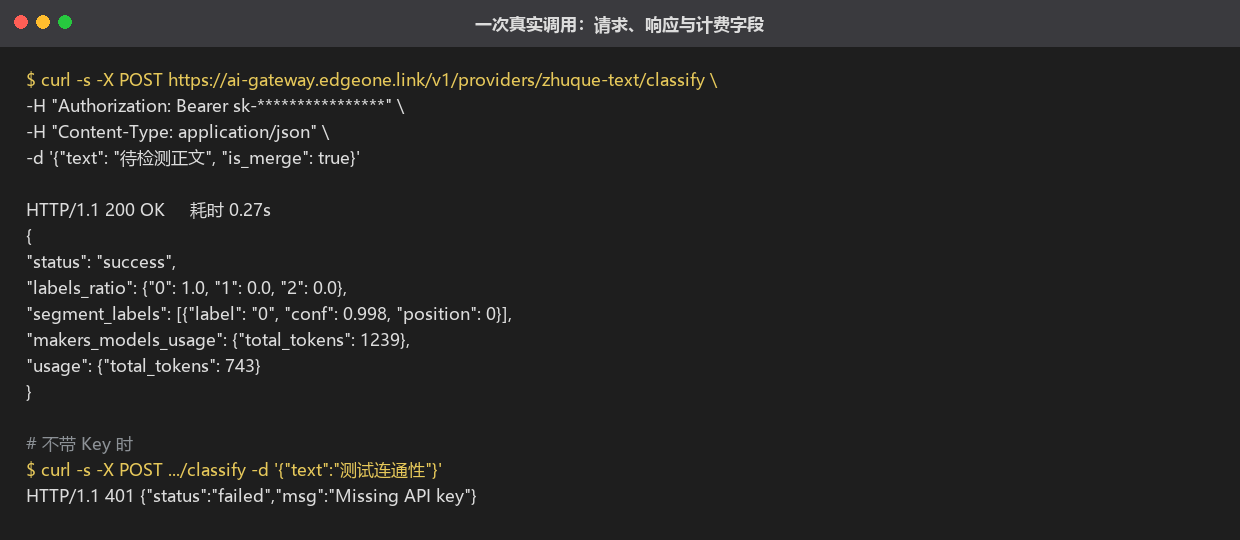
一次真实调用的请求与响应片段,密钥已做遮蔽
计费这块我栽过一次,说出来对自己也有好处。响应里有两个 token 字段,一个叫 makers_models_usage,一个就叫 usage。我第一版记录写的是前者等于正文字符数,理由是三行数据看着都对得上。后来重跑了一次单篇核对,才发现我把这两个弄反了:真正扣费的是 makers_models_usage,实测是正文字符数的约一点六七倍,七百四十三字的一次调用扣掉一千二百三十九;另一个 usage 字段刚好等于字符数本身,它不是扣费口径。
这个错很值得记一笔。当时我有三行数据摆在面前,看着自洽,我就没往下问了。真正推翻它的是一次单独拎出来复核的调用,而不是再多看几行同样的数据。按正确的口径算,每月五十万的免费额度大约够七百字的稿子测四百多篇。这个量足够每天改几十版。
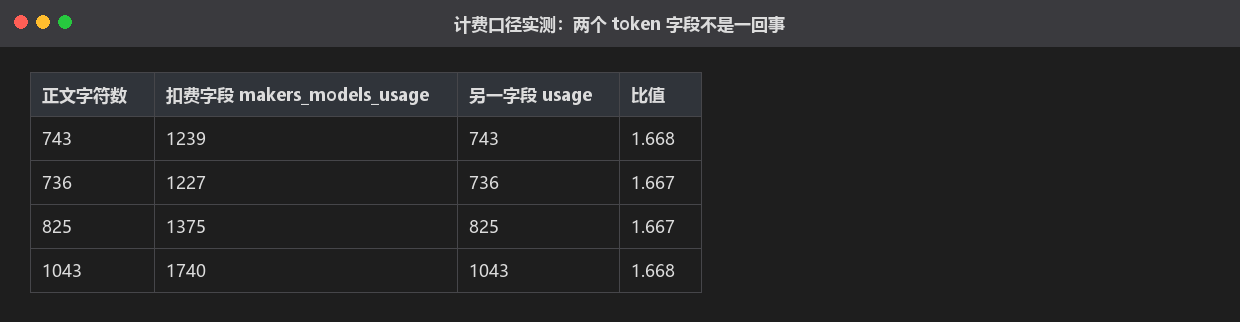
两个 token 计费字段的实测差异
最后说一下这条路的边界,我认为这个比怎么调用更重要。网上能搜到不少绕过方案,我大致分成两类看过。一类是改文本本身的,这在后面几篇里我会单独讲。另一类是冲着服务端的,比如伪造 X-Forwarded-For 请求头冒充别的 IP,或者挂一层代理池把请求分散出去,再比如用打码平台批量过验证码。这些都是实打实能绕过限流的做法,我一个都没用。
理由很直接:它们绕过的是访问控制,不是让我的文章更像人写的。前者是在占服务方的便宜,而且做得越成功,服务方越可能收紧,最后受害的是所有正常用它自查的人。我想要的只是把自己写的东西测一测、改一改,这个目的用官方接口已经完全够了,没必要越线。
打通之后我立刻把十篇稿重测了一遍,结果把我自己前几天攒下来的一套经验全打翻了。那部分是下一篇的内容。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号