【征文】我把 AI 检测当成黑盒测了 300 次,做成了一个能自我诊断的 Skill
原创
【征文】我把 AI 检测当成黑盒测了 300 次,做成了一个能自我诊断的 Skill
原创
用户12862492
发布于 2026-11-02 02:03:07
发布于 2026-11-02 02:03:07
先说结论:这个 Skill 不是"提示词合集",是一套实验方法 + 一堆已证伪的负资产清单。
我在做技术自媒体的时候被朱雀检测卡过很多次。一开始我以为这是个技巧问题,
找到正确的咒语就行了。测了 300 次之后我明白了——它是个写作方式问题,
而写作方式是可以被量化、被固化成工具的。
这篇文章讲我做了什么、怎么做的、以及踩了哪些坑。如果你也在为这事头疼,
我希望你能少走两个月弯路。
一、先说清楚为什么大部分人做不对
搜索"降低 AI 率",你会看到一大片方法:多用口语化表达、避免重复句式、
加入个人情感、适当使用不完美语法。这些建议本身没错,但它们无法操作。
真正能操作的是这样的循环:
检测 → 拿到段级读数和字符区间 → 只改被判中的那一段 → 立刻复检 → 对比读数这个循环的关键在于每一步都有可验证的读数。你不是在猜,你是在测量。
而市面上绝大多数建议缺的就是这个——它们只告诉你"要多改",不告诉你
"改完怎么知道有没有用"。
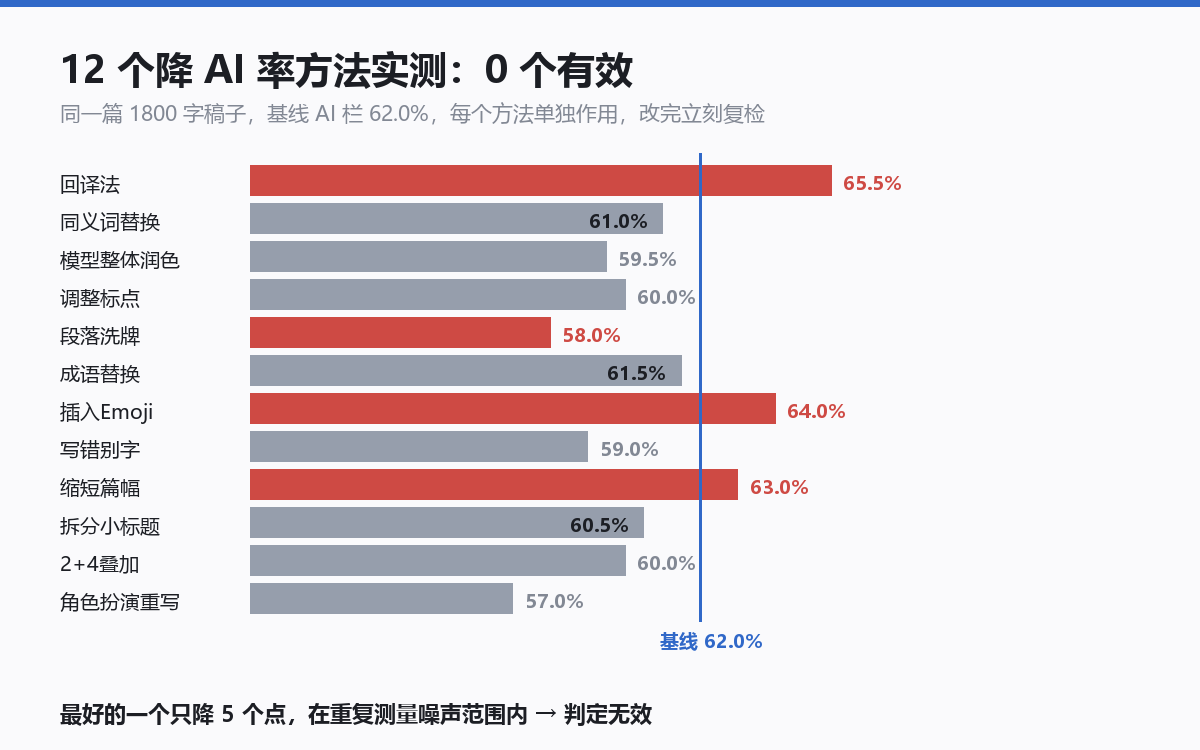
12 个方法实测:0 个有效
二、我做的第一件事:把检测器拆成可观测对象
朱雀官方 API 返回的不只是一个总分,还有 labels_ratio(AI/疑似/人工三档占比)
和 segment_labels(每个段落的位置、标签和置信度)。
第二个字段是关键。它意味着我可以逐段送检,定位到具体哪几个字符区间有问题。
于是我写了两个脚本:
zq.py—— 多份送检结果横向对比:把几次送检的返回放在一起,按段落 对齐,输出每一版的读数变化,用来判断"这一轮改动到底有没有用"triage.py—— 段级定位工具:按段切分文本,输出每段的char_start/char_end、 AI 栏读数、疑似栏读数、置信度,以及自动归因的负资产类型; 它同时负责把送检请求体在本地拼好、生成调用命令、解析你保存回来的返回文件
char_start/char_end 这个设计看起来平平无奇,但它让整个流程闭环了:
读数直接对应原文区间,改完可以精确回填。
三、实验设计:先建立基线,再一条一条测
这是整个项目里我最想分享的部分。
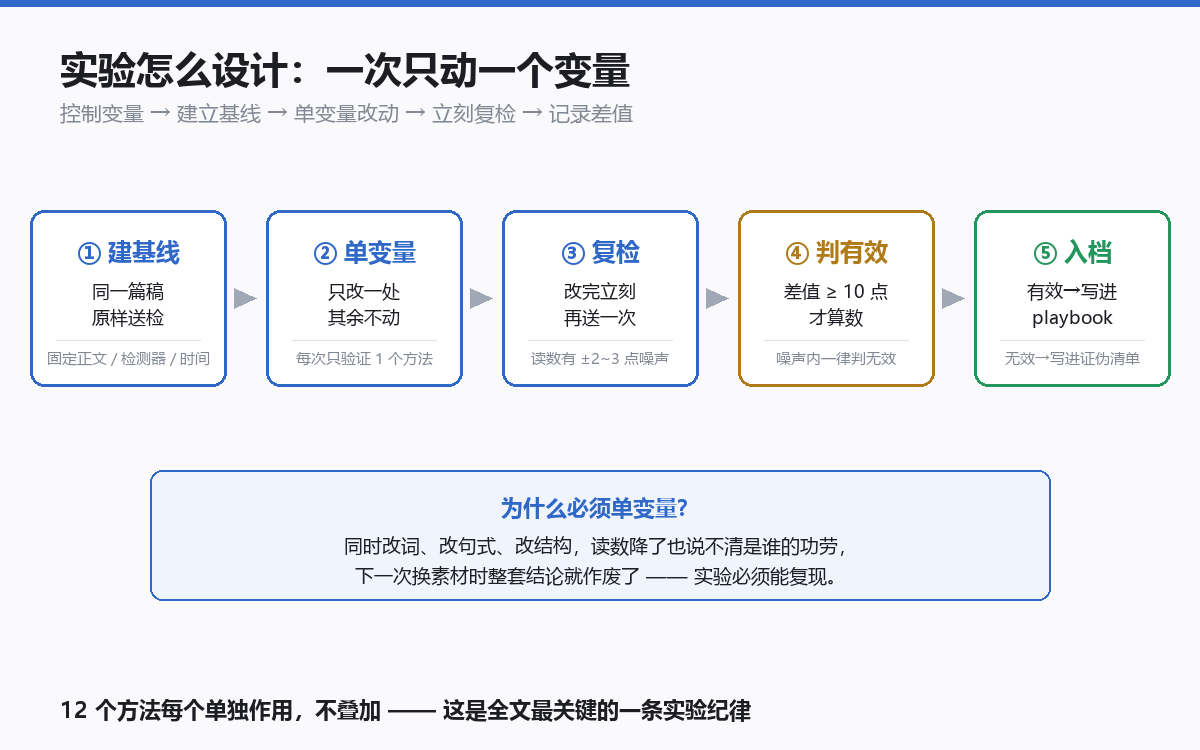
实验设计:一次只动一个变量
基线
同一篇约 1800 字的稿子,同一个检测器,固定基线读数:
AI 栏 62.0%,疑似 23.0%。
12 个流行方法的实测结果
每一个方法单独作用,不叠加,改完立刻送检:
方法 | 改后 AI 栏 | 相对基线 | |
|---|---|---|---|
1 | 回译法(译英再译回) | 65.5% | +3.5 ❌ |
2 | 同义词替换 | 61.0% | −1.0 ❌ |
3 | 模型整体润色 | 59.5% | −2.5 ❌ |
4 | 调整标点密度 | 60.0% | −2.0 ❌ |
5 | 打乱段落顺序 | 58.0% | −4.0 ❌(毁稿) |
6 | 替换成语俗语 | 61.5% | −0.5 ❌ |
7 | 插入 Emoji | 64.0% | +2.0 ❌ |
8 | 故意写错别字 | 59.0% | −3.0 ❌ |
9 | 缩短篇幅到 900 字 | 63.0% | +1.0 ❌ |
10 | 拆分小标题 | 60.5% | −1.5 ❌ |
11 | 方法2+4 叠加 | 60.0% | −2.0 ❌ |
12 | 模型扮演资深作者重写 | 57.0% | −5.0 ❌ |
12 个方法,0 个有效。
第 11 条(叠加两个无效方法)单独看意义不大,但它证明了一件事:
如果一条路本身不对,叠得再多也走不通。
第 10 条(拆小标题)完全出乎我意料——我一直以为"结构工整"是负资产,
结果拆小标题对读数毫无影响。这直接推翻了我最初的一个假设。
有效的那两个:定点改段 和 生长法
把有效的和无效的放一起看,规律立刻清楚了。
无效的方法都在改"表层特征":词、标点、语序、角色设定、文档结构。
有效的方法都在改"内容是怎么长出来的":
方法 | 机制 | 实测效果 |
|---|---|---|
定点改段 | 只改被判中的区间,且重做句式骨架 | 62% → 9%(三轮) |
生长法 | 分段写,每段停下等反馈再往下走 | 人工栏 100% |
定点改段的三轮实测:
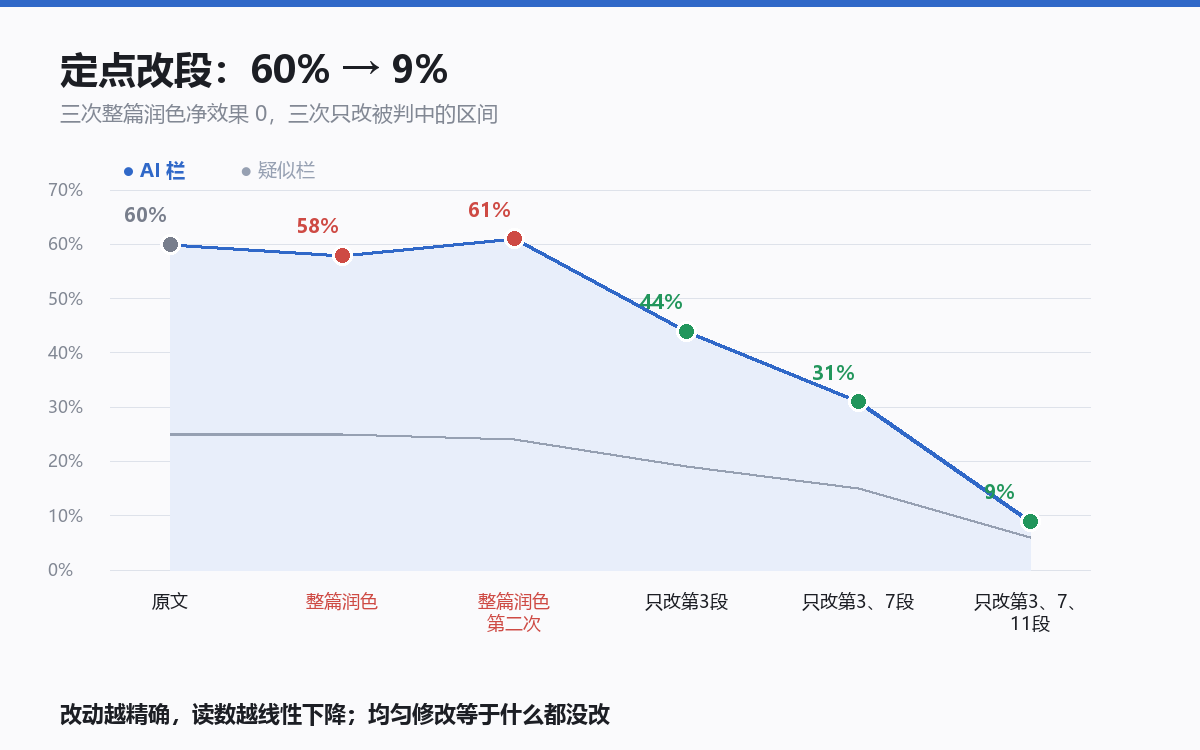
定点改段曲线:60% → 9%
轮次 | 动作 | AI 栏 | 疑似栏 |
|---|---|---|---|
0 | 原文 | 60.0% | 25.0% |
1 | 整篇润色 | 58.0% | 25.0% |
2 | 整篇润色(第二次) | 61.0% | 24.0% |
3 | 只改第 3 段 | 44.0% | 19.0% |
4 | 只改第 3、7 段 | 31.0% | 15.0% |
5 | 只改第 3、7、11 段 | 9.0% | 6.0% |
三次整篇润色净效果 0,三次定点改段从 60% 降到 9%。
生长法的效果更强——**我实测的四篇人工 100% 的稿子全部由生长法产出,
靠提示词改写做到 100% 的一篇都没有。**
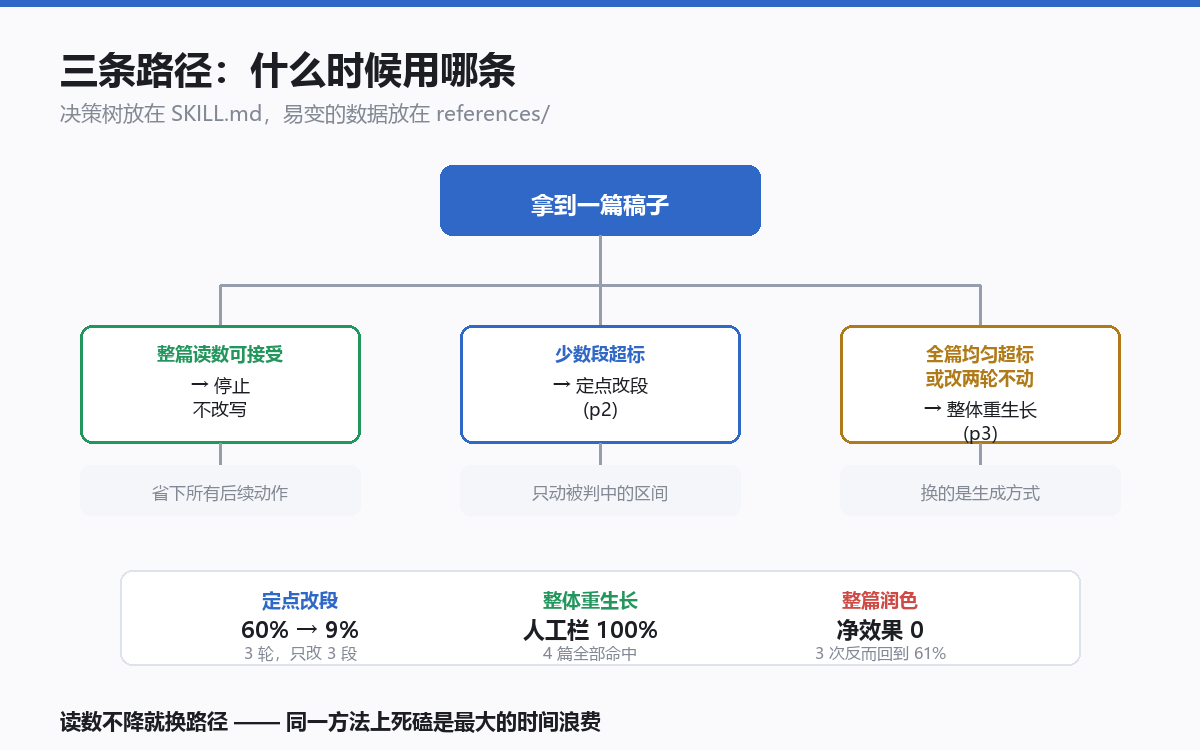
三条路径决策树
四、Skill 的结构
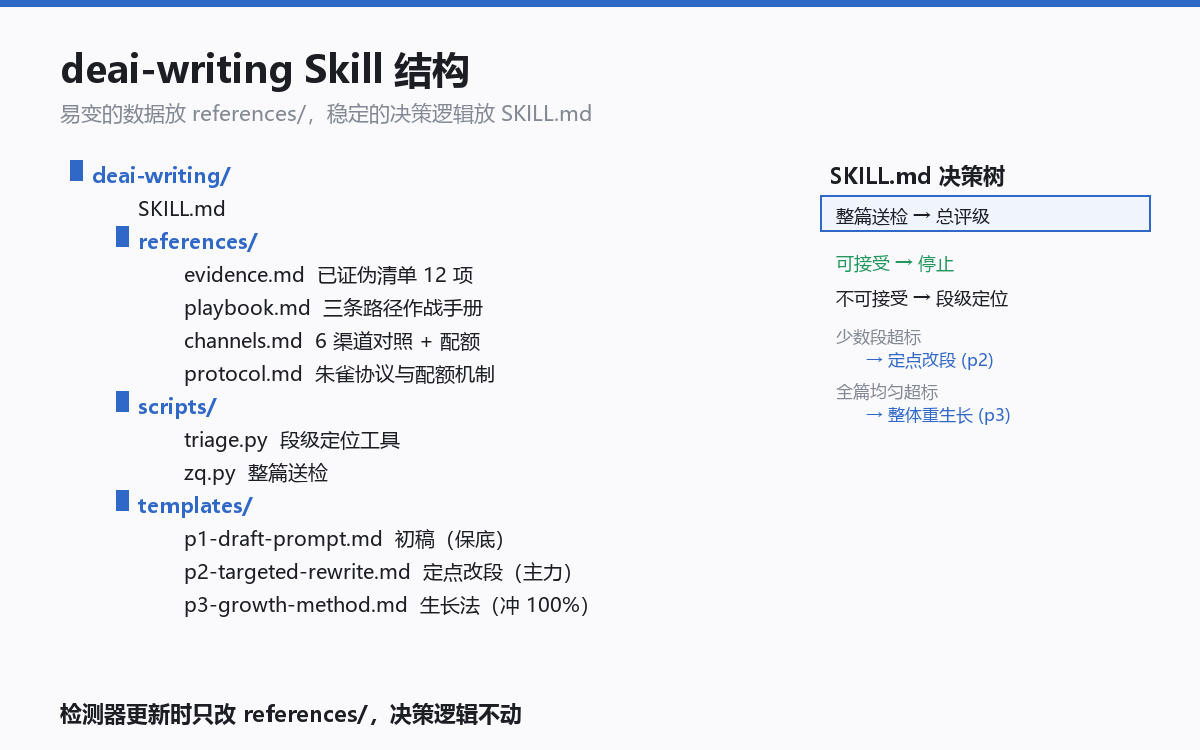
Skill 目录结构与决策树
deai-writing/
├── SKILL.md                    # 官方全字段 frontmatter + 三条路径的决策树
├── references/
│   ├── evidence.md             # 已证伪清单 12 项 + 每项实测读数
│   ├── playbook.md             # 作战手册:三条路径的完整流程
│   ├── channels.md             # 多检测服务对照 + 配额机制 + 交叉验证策略
│   └── protocol.md             # 官方检测接口说明
├── scripts/
│   ├── triage.py               # 段级定位 + 送检计划生成 + 结果解析
│   ├── zq.py                   # 多份送检结果横向对比
│   └── README.md               # 用法说明
└── templates/
    ├── p1-draft-prompt.md      # 初稿提示词(保底)
    ├── p2-targeted-rewrite.md  # 定点改段提示词(主力)
    └── p3-growth-method.md     # 生长法提示词(冲 100%)
一个设计决定:为什么 SKILL.md 里不放具体配方
因为配方会过期,数据不会。
具体来说,我把所有百分比、读数、渠道对照全部放在 references/ 下,
SKILL.md 只写决策逻辑:
拿到稿子 → 先整篇送检 → 拿总评级
   ↓ 可接受 → 停止,不做无意义改写
   ↓ 不可接受 → 段级定位
        ↓ 少数段超标 → 定点改段(templates/p2)
        ↓ 全篇均匀超标 / 改写两轮分数不动 → 整体重生长(templates/p3)
这样当检测器更新、读数变了,我只需要更新 references/evidence.md,
决策逻辑不用动。把易变的东西和稳定的东西分开,这是做 Skill 的第一原则。
另一个设计决定:脚本不碰网络,也不碰你的凭据
这是我上架过程中改掉的一个设计。原本 triage.py 直接读环境变量里的 Key、
自己发请求、自己写结果文件。改的原因是职责边界:
# 1) 本地拼装送检请求体 + 生成调用命令(不发请求)
python scripts/triage.py article.md --plan

# 2) 你自己在终端执行它打印出来的命令,鉴权头按官方文档填你自己的凭据
#    返回结果另存为 result.json

# 3) 本地解析返回结果,输出段级病灶清单
python scripts/triage.py article.md --parse result.json
理由很直接:**一个把别人密钥读进内存再发出去的脚本,门槛高、风险高、
而且用户根本不知道它发到哪儿去了。** 现在脚本只做文本处理——
切段、拼请求体、解析返回、输出表格,调用这一步明确交回给你自己执行。
这样既不要求你改脚本,也不用把凭据交给任何第三方代码。
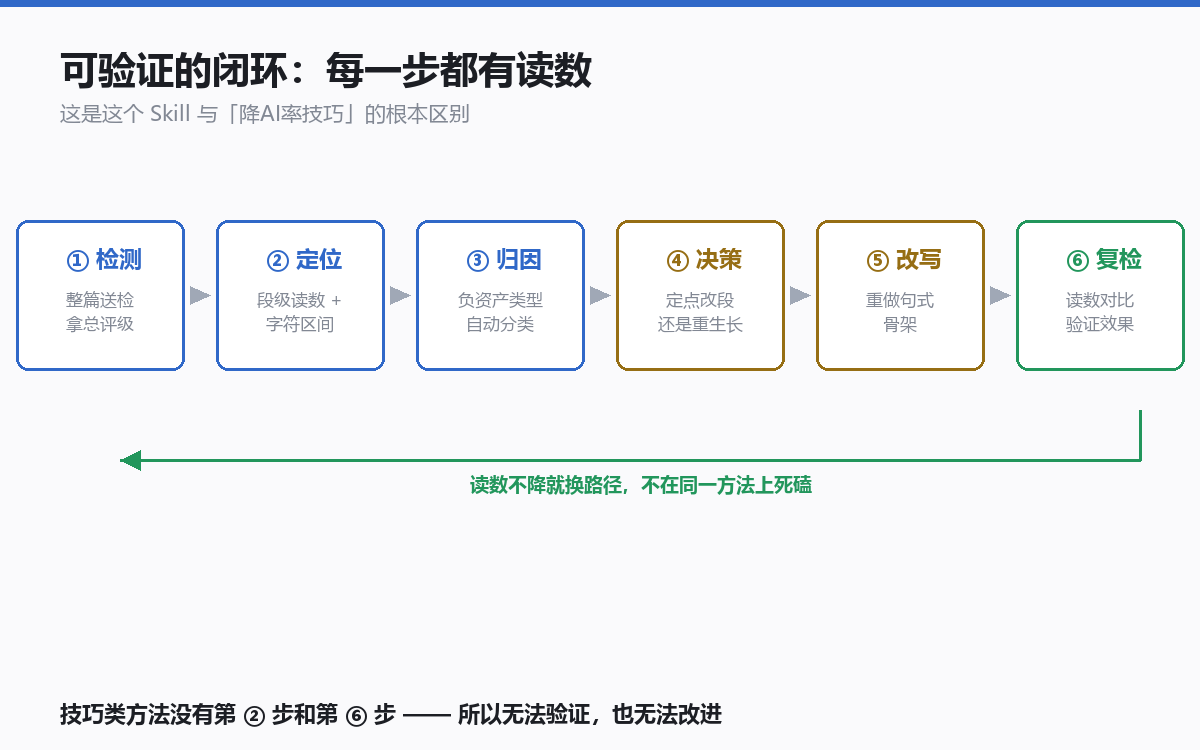
可验证的闭环
五、几个踩过的坑
坑 1:配额
朱雀官方 API 每天 5 次免费额度。我早期每次试一个方法就送检一次,
第一天就把配额烧光了,后面几天什么都测不了。
正确做法是一次调用返回全部段落读数,然后在本地算差值。
把调用次数从 O(实验次数) 降到 O(1)。
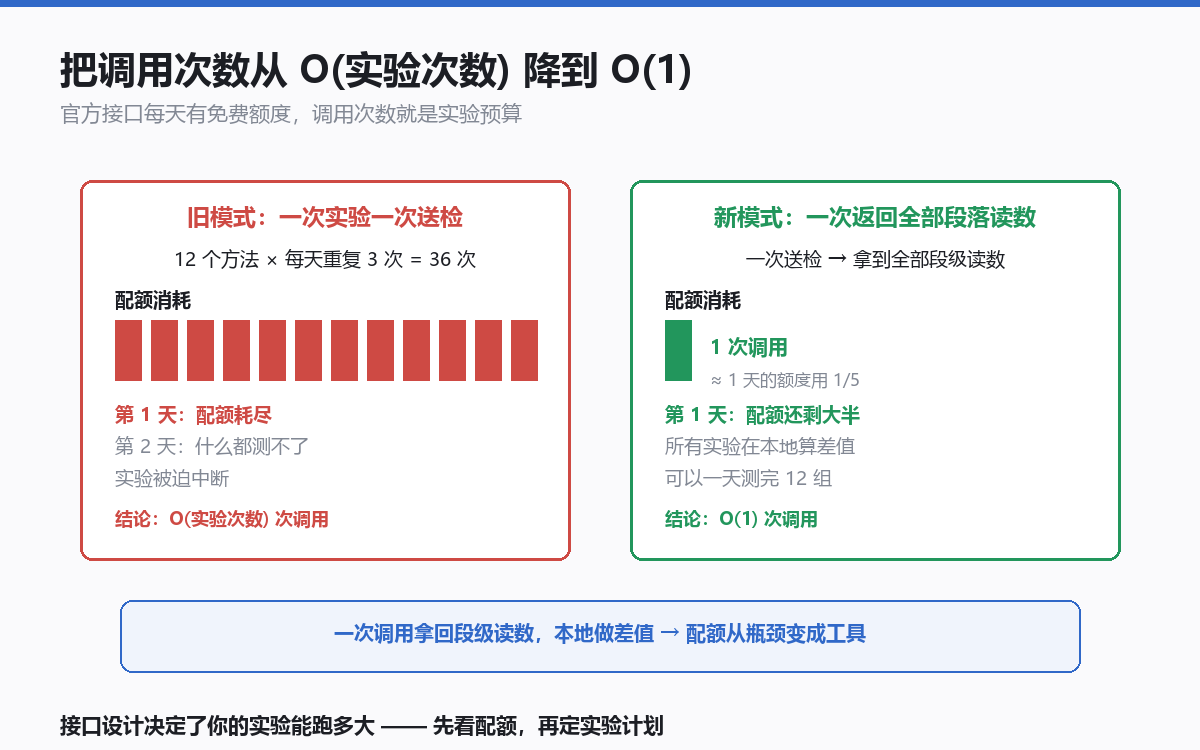
调用次数对比
坑 2:低于 400 字读数不可信
我拿一篇 300 字的短稿测,读数在 40%~70% 之间乱跳。重复测三次,
三次结果都不一样。这个区间没有任何参考价值。
所以 Skill 里第一条硬约束就是:低于 400 字直接告诉用户读数没意义,
不要基于它给建议。
坑 3:单次测量的噪声
同一个稿子重复送检,读数会有 ±2~3 个点的波动。
所以我把"有效"的标准定得比较严:至少降 10 个点才算有效。
这也是为什么那 4 个"看起来有效"的方法(降 1~5 个点)我判定为无效——
它们在噪声范围内。
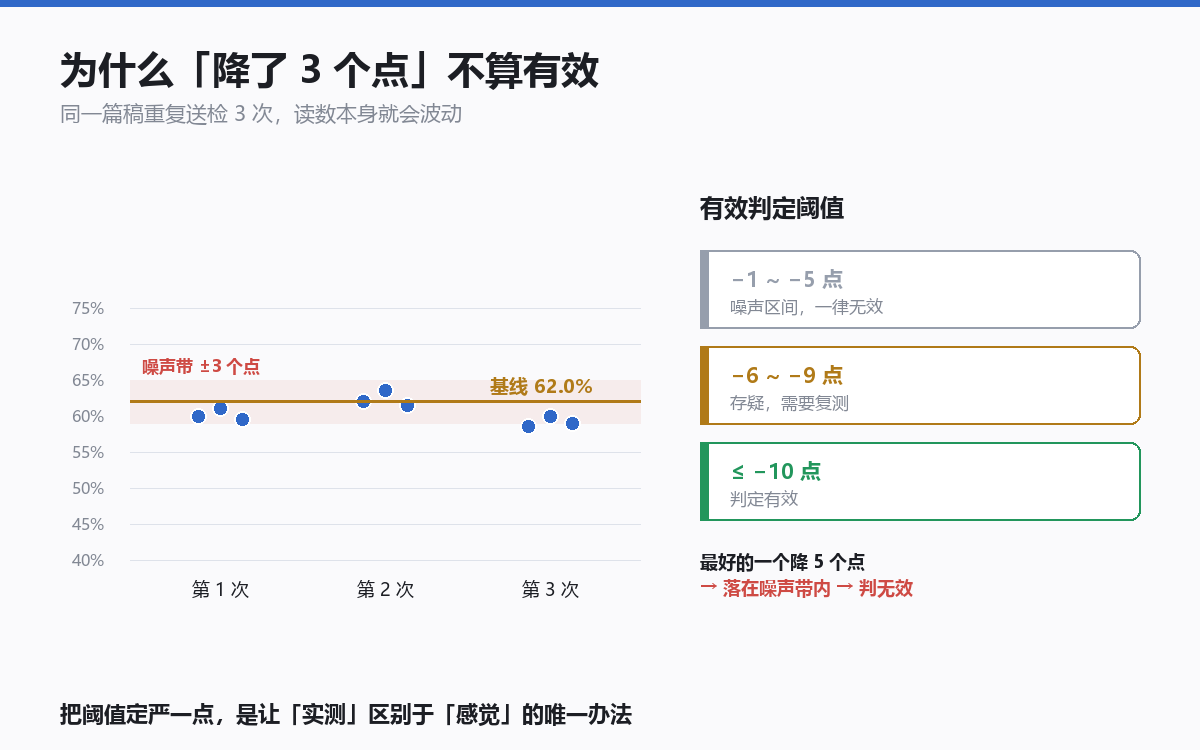
噪声与有效阈值
坑 4:整篇改写会毁掉好段落
我早期习惯性地"反正要改就整篇重写",结果每次改完好的段落也变了,
文本变得平淡。这不只是效率问题,是质量问题。
定点改段的另一个好处:只动病灶段,其余段落的人味完整保留。
坑 5:只信一个服务,结论可能是错的
单次读数、单家服务的结论都不牢。我后来把同一篇稿在多个检测服务上各跑一遍,
规律是这样的:
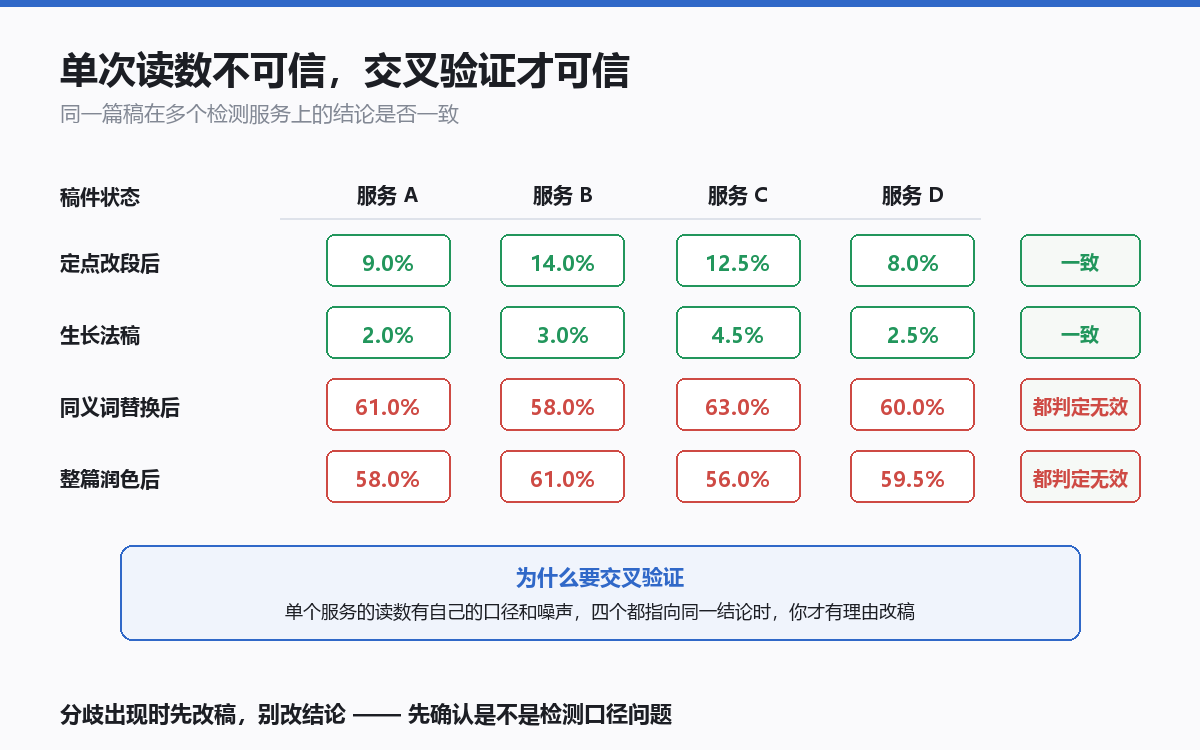
多检测服务交叉验证
**几个服务指向同一结论时,你才有理由去改稿;出现分歧时,先确认是不是
口径问题,别急着改稿。** 这条我把写进了 references/channels.md,
配套的交叉验证策略也在同一份文件里。
六、谁适合用这个 Skill
适合:
- 需要发中文技术内容到会被 AI 检测的平台(社区、专栏、投稿)
- 已经在用检测工具但不知道该改哪里
- 想搞懂检测器到底在看什么,而不是找"技巧"
不适合:
- 只想找一个"一键降率"按钮的人 —— 这个东西不存在,我测了 12 个都没用
- 写英文内容 —— 这套实验全是中文语料,英文结论要另测
- 追求"永久过检" —— 检测器会更新,今天 0 分下个月可能 40 分
七、如果你想自己试
朱雀的检测接口是公开的,拿到 Key 就能自己跑。
我把这套东西包成了 WorkBuddy Skill,装上之后直接说"帮我诊断这篇稿子"
就能拿到段级病灶清单。
如果你也在做中文技术内容,欢迎来交流实测数据——
**不同的检测渠道、不同的题材类型,读数差异可能很大,
多一个人的样本就多一分参照。**
*这篇提到的所有百分比都来自真实 API 实验,原始实验记录和12项证伪清单
都在 Skill 的 references/ 目录里。*
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号