高密度机柜场景:以太网温湿度变送器采样频率设置误区
原创
高密度机柜场景:以太网温湿度变送器采样频率设置误区
原创
HONSOR盛世宏博
修改于 2026-11-03 09:25:58
修改于 2026-11-03 09:25:58
高密度机柜 · 以太网温湿度变送器 · 采样频率 · 动环监控 · 盛世宏博
高密度机柜场景:以太网温湿度变送器采样频率设置误区
一、前言
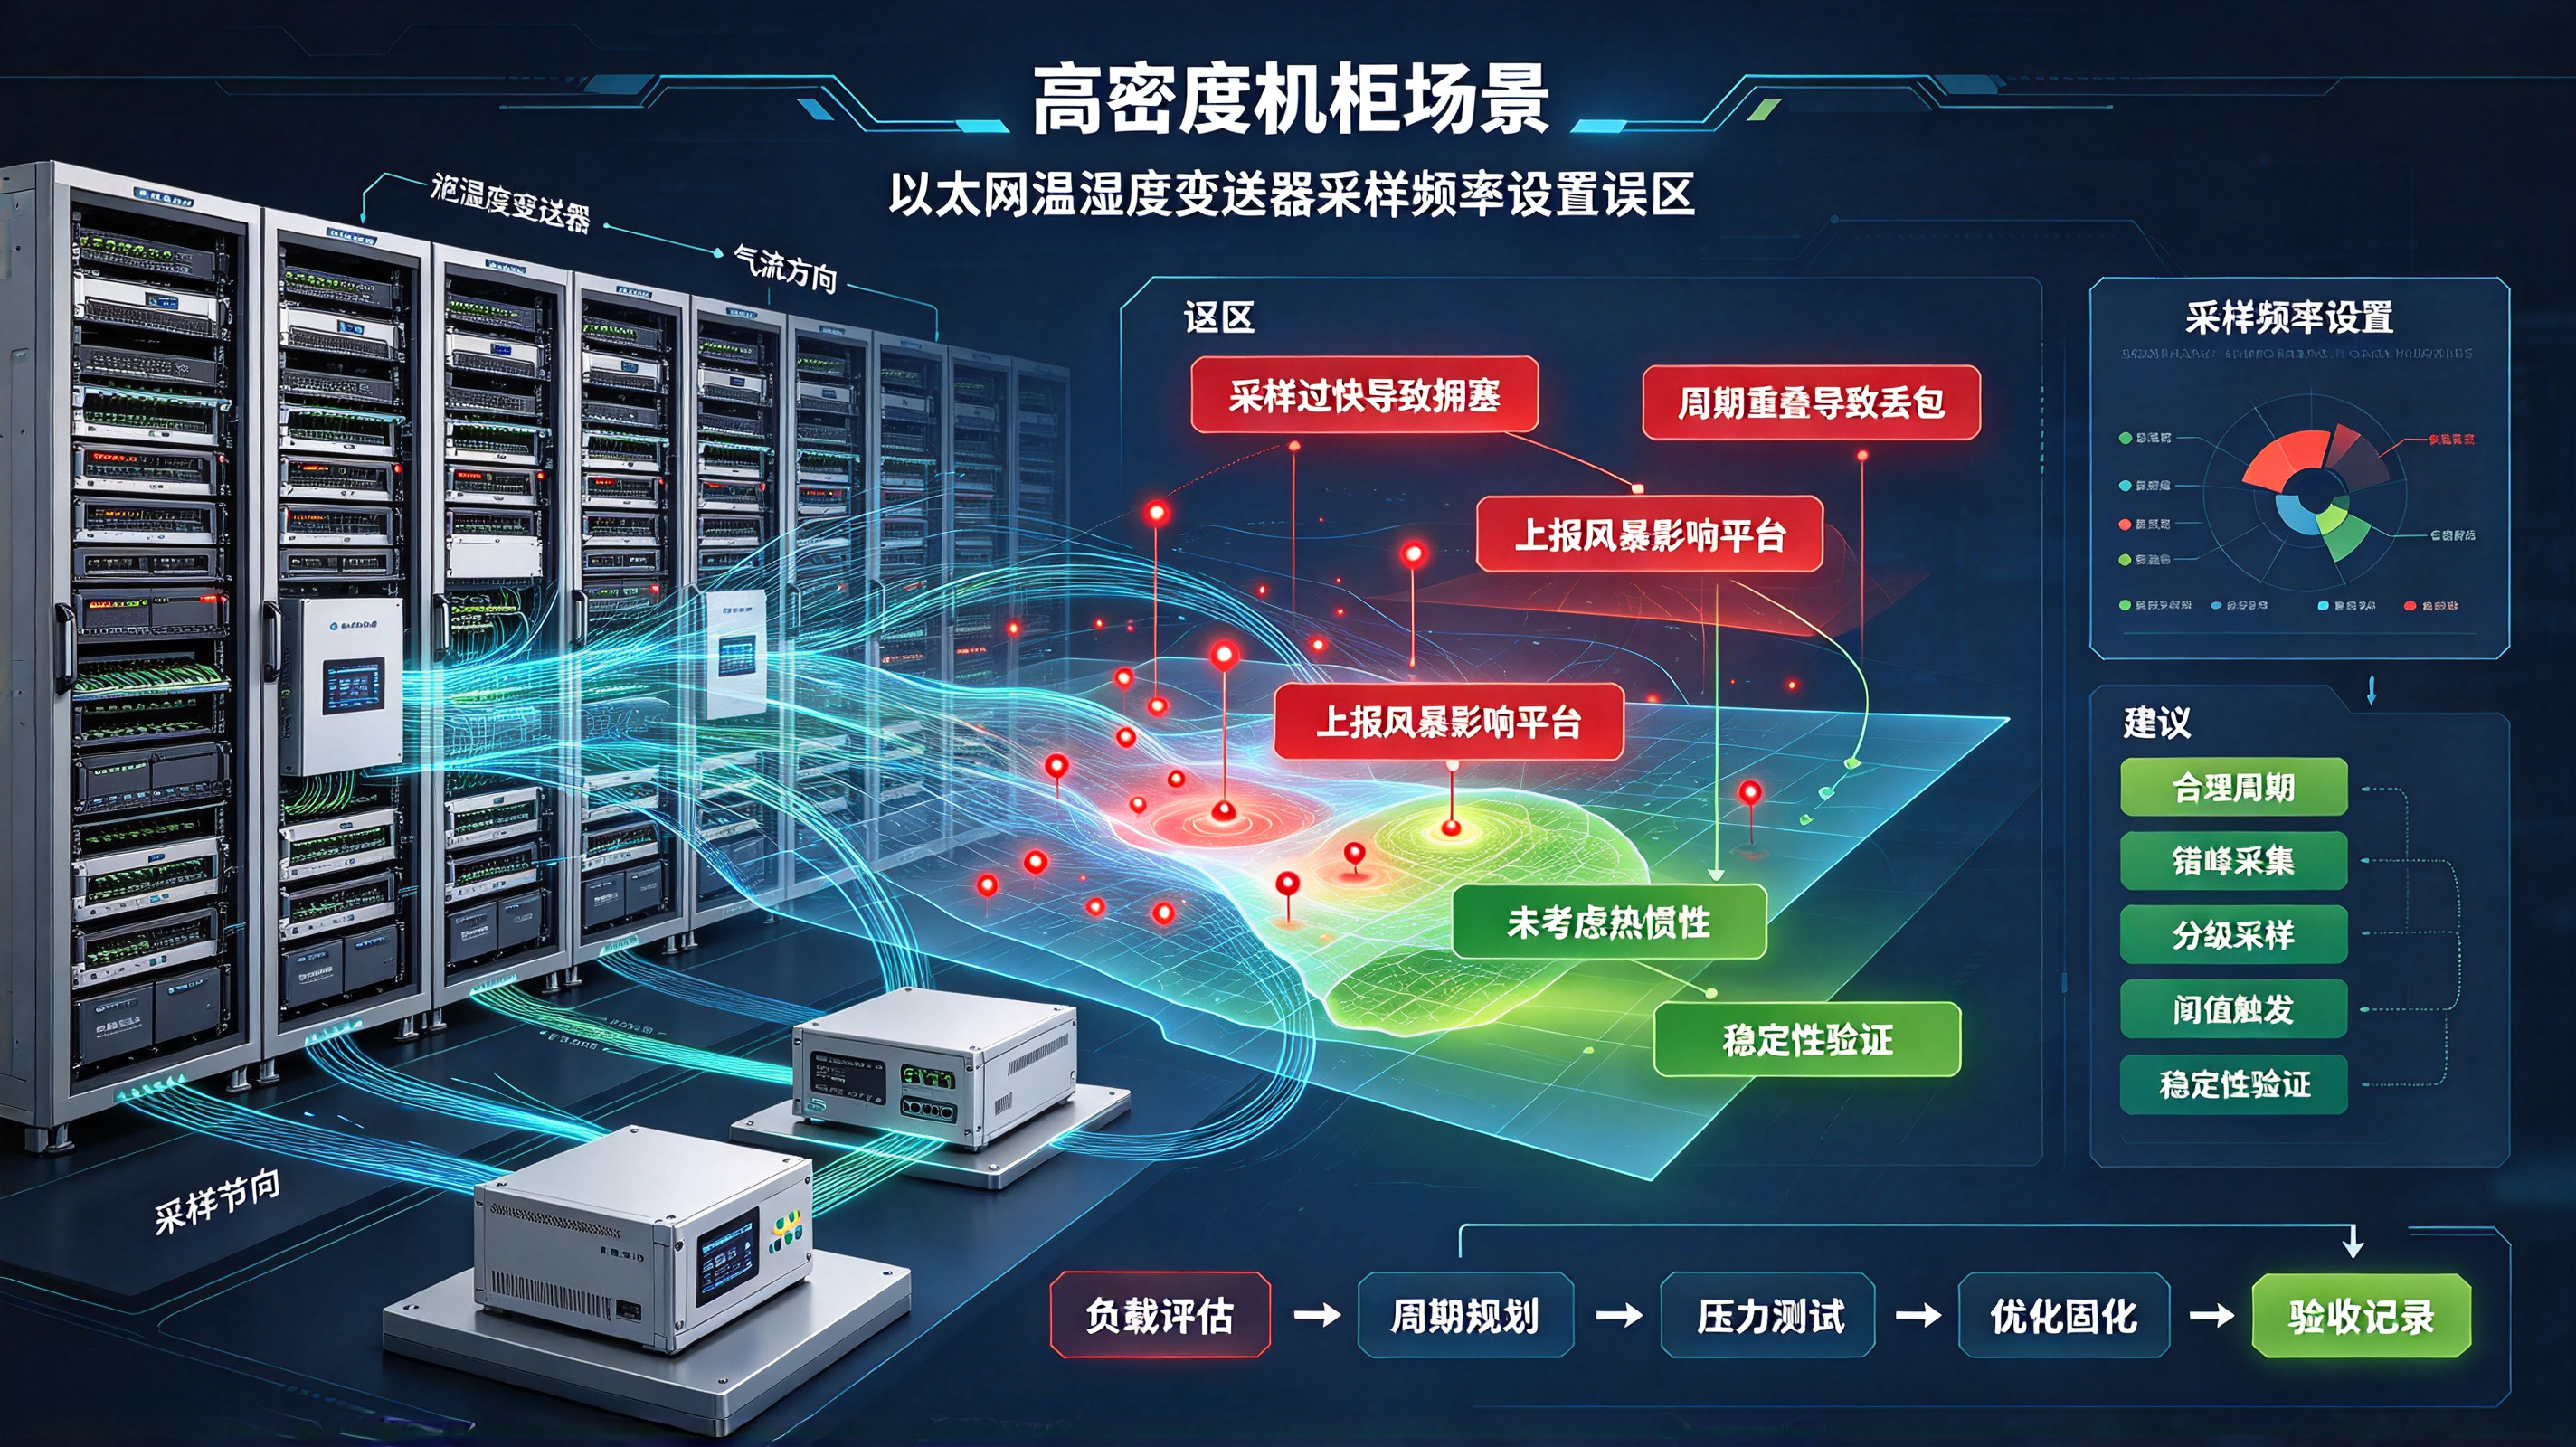
高密度机柜集群是算力中心、通信机房、配电室、服务器机房的典型部署形态,42U标准机柜内部高密度部署服务器、存储、UPS、交直流配电单元,机柜内部热流场复杂,局部热点、风道短路、机柜进回风压差失衡、单点热堆积等隐患隐蔽性强,温升速率快,是动环监控的重点管控对象。RJ45以太网温湿度变送器凭借PoE供电、布线简洁、支持Modbus TCP、UDP主动上报、可直接接入动环网关的优势,被大量应用于机柜进风口、出风口、机柜中部、背板、电池仓等微环境点位,实现机柜分层测温。
在项目实施、方案设计、现场调试阶段,技术人员普遍存在一个惯性认知:采样频率越高,监测越灵敏、告警越及时、数据越可靠。很多集成商、运维工程师在高密度机柜场景下,直接将变送器采样周期设置为1s、500ms甚至200ms,盲目追求高频采样,随之引发一系列连锁问题:交换机端口队列溢出、UDP报文大量丢包、网关采集线程阻塞、时序数据库写入压力陡增、报文风暴、误告警泛滥、设备固件异常重启。而高密度机柜温湿度本身属于慢变化物理量,除热失控故障场景外,稳态工况下机柜内部温湿度变化速率很低,高频采样并不能带来预期收益,反而会挤占网络资源、抬高系统故障率。
本文面向机房动环设计、嵌入式固件开发、弱电集成调试人员,围绕高密度机柜场景,从温湿度物理变化特性、采样频率理论边界、高频采样带来的次生风险、工程上最常见的采样频率误区、不同业务场景的采样频率推荐、配套的滤波、上报策略、网络优化手段展开论述,厘清“采样频率”和“告警响应速度”两个独立概念,建立一套适配高密度机柜集群的采样、上报、告警判定体系,规避因采样参数配置不当造成的动环系统稳定性缺陷。
二、高密度机柜温湿度变化的物理特性分析
在开展采样频率选型之前,首先要明确机柜内部温湿度的变化规律,这是参数设置的底层依据,脱离物理特性的参数配置都是主观经验配置。
2.1 稳态工况
机房空调、精密空调正常运行,机柜负载稳定,服务器功耗无大幅度波动,机柜进风温度、回风温度、机柜中层温度变化速率极低。常规高密度服务器机柜稳态下,温度变化速率一般小于0.2℃/min,湿度变化速率小于1%RH/min。在这种工况下,温湿度在数分钟内都只会产生微小漂移,不存在快速突变。 从奈奎斯特采样定理角度,若信号最高变化频率很低,过高采样频率属于过采样,只会采集到传感器噪声、电磁干扰带来的随机抖动,无法采集到有效变化信息。
2.2 故障动态工况
故障工况分为两类:一类是缓慢故障,空调送风量衰减、滤网堵塞、风机降速,机柜内部温度缓慢爬升,温升速率大多在0.31℃/min;另一类是快速热故障,服务器电源短路、CPU散热失效、电池热失控,局部测点温升速率可以达到25℃/min甚至更高,这类场景才是对监测响应速度有硬性要求的场景。
这里有一个核心结论:快速温升不是依靠提高采样频率捕捉,而是依靠变化率告警算法,而不是单纯依靠缩小采样周期。很多工程师混淆了两个概念:采样频率是传感器多久采集一次AD值;告警判定是网关连续多组采样数据计算变化斜率。哪怕采样周期5s,只要连续3个采样点持续抬升,依然可以精准识别快速温升;反之采样周期1s,不做斜率判断,只做固定阈值比对,依然会漏判热失控风险。
2.3 机柜微环境的干扰特征
高密度机柜内部电源、主板、变频器、风扇、接触器会产生持续电磁干扰,网线和机柜强电线缆同槽敷设、交换机端口PHY芯片噪声、变送器本身ADC采样噪声,都会让原始采样数据自带随机噪声。采样频率越高,单位时间内采集到的噪声样本越多,曲线毛刺、尖刺、跳变越频繁,直接带来大量误告警。高频采样会放大噪声,而不是提升真实环境感知能力。
三、以太网温湿度变送器采样与上报的两个独立概念
大量误区的根源,是把ADC采样频率和网络上报频率混为一谈,在以太网变送器的固件设计中,这是两个独立参数,控制逻辑完全不同。
- ADC采样频率:变送器MCU读取温湿度探头芯片的AD转换频率,是传感器本地采集频率。高精度SHT系列、铂电阻探头,芯片本身有固定的转换周期,SHT35单次转换时间大概13ms,铂电阻PT100高精度转换一次耗时几十ms。ADC采样频率上限受探头芯片本身约束,无限拉高ADC采样没有意义,探头还没有完成一次转换,多次读取只会拿到重复值。
- 网络上报频率:变送器通过UDP/Modbus TCP向边缘网关发送报文的周期,也就是报文对外推送的间隔,这是影响交换机、网关负载的核心参数,也是项目调试最常修改的参数。
很多现场调试人员直接把上报周期等同于ADC采样周期,设置1s上报,同时ADC也1s采集一次;还有一种错误做法:ADC高频采样(100ms一次),然后直接全部上报,造成报文爆炸。 工程正确做法:ADC可以适度高频采样,做本地滑动平均滤波,滤波之后,再按照固定周期打包上报给网关。也就是“本地高频采样降噪,低频上报,网关做二次滤波与告警计算”,这是高密度机柜的标准处理范式。
举例:变送器ADC每500ms采集一次,连续采集6组数据,做滑动均值滤波,剔除跳变极值,每3s打包一组均值报文上报网关。本地ADC高频用来抑制噪声,对外上报周期保持合理水平,不会冲击网络。
四、高密度机柜场景采样频率设置典型误区拆解
误区1:采样频率越高,告警响应越快,热点不会漏报
这是行业内最普遍的误区。 假设某机柜测点发生热失控,温升速率3℃/min,也就是每20s上升1℃。 方案A:上报周期1s,阈值告警,必须温度超过阈值才告警; 方案B:上报周期5s,网关开启温升速率告警(斜率告警),连续3个采样点计算斜率,当斜率>1℃/min触发告警。 对比可以发现:方案B虽然采样间隔更长,但是依靠变化率算法,在温度还没有达到固定阈值的时候,就提前识别升温趋势,告警更早;方案A只是单纯高频上报,只做阈值比对,温度没有越线就不会告警,反而容易漏判缓慢升温故障。
高频采样只能提升“拿到数据的频次”,告警响应速度由告警判定逻辑决定,不是由采样频率决定。盲目缩短上报周期,只会增加报文数量,不会天然提升告警灵敏度,反而噪声变多,误告警数量成倍上涨。
误区2:高密度机柜测点多,必须全部高频采样,保证每个机柜状态实时可见
高密度机房动辄上百、上千个机柜测点,一个接入交换机下挂载几十台以太网变送器。如果全部设置1s上报,单台变送器每分钟60条报文,50台变送器每分钟3000条UDP报文,交换机端口队列持续高负载。 UDP报文无流量控制,报文持续涌入,交换机缓存耗尽之后尾部丢弃,出现随机丢包;网关UDP接收缓冲区占满,应用层来不及消费报文,同样丢包。最后出现一个矛盾现象:越想要高频看数据,丢包越严重,曲线断点越多,告警反而不稳定。 很多项目现场出现“平台页面刷新很快,但是曲线经常断、告警时有时无”,根源就是批量测点上报周期设置过小,超出接入交换机和网关的处理能力。
误区3:稳态和故障场景共用同一套采样上报周期,不做动态切换
部分变送器固件不支持动态周期,只能固定一个上报频率。稳态工况下持续高频上报,浪费带宽和算力;故障发生之后,又因为固定周期上限,无法进一步提升监测密度。 错误做法:全程固定1s上报; 优化思路:采用动态上报机制,网关或者变送器本地判断环境状态:温湿度平稳、变化率低于阈值,进入稳态模式,拉长上报周期;当连续采样发现温升速率超标,自动切换为短时高频上报,故障恢复之后自动切回低频稳态周期。兼顾常态带宽压力和故障阶段监测密度。
误区4:为了追求曲线顺滑,用极高采样频率,依赖后端平台滤波
部分运维人员习惯在平台上看平滑曲线,认为采样点越多,曲线越好看。于是把上报周期设置1s,在平台端配置大窗口滑动滤波。 这个方案的缺陷:滤波窗口大,带来数据滞后;高频报文先经过网络传输,再到平台滤波,噪声已经在链路上产生丢包、抖动,滤波只能掩盖问题,不能消除源头干扰。正确逻辑是前端变送器本地滤波优先,减少无效报文输出,而不是把降噪压力全部交给后端平台。
误区5:Modbus TCP轮询模式,把轮询间隔设置极小,轮询并发无节制
除UDP主动上报之外,很多项目采用Modbus TCP轮询采集。部分工程师把轮询间隔设置为1s,网关多线程并发轮询大量变送器。 Modbus TCP每次轮询都需要建立连接、收发报文、关闭连接,频繁创建TCP连接会带来握手开销、端口资源占用。高密度测点下,短间隔轮询会造成网关TCP句柄耗尽、内核负载飙升、连接超时。 很多人忽略Modbus轮询本身有最小轮询间隔约束,单条链路的轮询间隔不能小于设备响应时间+传输时延,高密度集群下,轮询间隔过小,大量轮询请求堆积,出现大量timeout。
误区6:采样频率和存储周期绑定,高频采样=高频入库
时序数据库写入有IO开销,上千测点1s上报入库,数据库写入QPS暴涨,磁盘IO、索引压力急剧上升,数据库容易出现写入延迟、数据落盘失败、查询卡顿。 很多项目后期历史曲线查询缓慢、报表导出超时,就是前期盲目高频采样,日积月累存储了海量冗余数据,大部分数据都是稳态下重复、无变化的无效样本。 机房动环时序存储有成熟的压缩策略,稳态下可以采用抽稀存储,只有变化超过阈值的样本才持久入库,固定周期的样本作为基线,不需要全部高频入库。
误区7:不分测点类型,统一一套采样频率
机柜进风口、出风口、电池仓、机柜中部、机房环境基准测点,风险等级完全不一样,但是很多项目全部统一设置相同上报周期。 电池仓属于高风险点位,热失控风险高,可以适当提高采样密度;普通机柜进风口稳态变化缓慢,适合低频上报;机房公共基准测点,只需要长期基线监测,不需要高频。一刀切配置,要么资源浪费,要么高风险点位监测不足。
五、高密度机柜场景采样与上报参数工程推荐区间
区分ADC本地采样、网络上报周期,区分UDP主动上报、Modbus TCP轮询两种模式,区分测点风险等级,给出工程落地推荐值。
前提说明:所有数值为高密度机柜集群(单交换机下≥20个测点)推荐参数;少量测点、单机柜测试场景可以适当缩小周期,但是不建议长期业务运行。
5.1 ADC本地采样(变送器内部)
- 普通温湿度探头:ADC 300ms
500ms采样一次,连续48次采样做滑动平均、剔除极值; - 电池仓、高风险测点:ADC 200ms采样,滤波窗口缩小;
- 禁止ADC采样间隔小于100ms,超出探头转换速率,只会重复读取相同数值,无意义。
5.2 UDP主动上报模式(高密度集群主流)
- 普通机柜进风、回风、架内常规测点:上报周期 4~5s;
- 电池舱、UPS电池柜、储能机柜等高风险测点:上报周期2~3s;
- 机房公共基准环境测点:上报周期10~15s;
- 告警触发后的动态短时上报:故障识别后,临时切换为1
2s上报,持续510min,故障恢复自动回落。
禁止长期业务运行下,大批量测点统一1s上报,只有单点调试、故障排查阶段临时使用。
5.3 Modbus TCP轮询模式
- 单设备轮询最小间隔:≥1.5s;
- 网关并发轮询数量控制:单网关同时并发轮询连接数不超过30路;
- 轮询调度策略:错峰轮询,轮询时间加入随机偏移,避免同一时刻大量请求并发。
5.4 告警判定配套参数(和采样频率配套使用)
- 阈值告警延时:连续2~3个采样周期持续超标,才判定告警,过滤瞬时噪声;
- 温升速率告警:推荐计算窗口3个采样点,斜率阈值0.5~1℃/min,优先于单纯阈值告警;
- 去抖策略:单点采样跳变,不触发告警,依靠连续多帧校验。
六、配套优化手段,在合理采样频率下保障监测可靠性
在不盲目拉高采样频率的前提下,通过固件、网络、算法层面优化,实现高密度机柜稳定监测。
6.1 变送器本地预处理
在变送器固件内部完成一阶滤波、滑动平均、极值剔除,只把滤波后的有效数据向外上报;增加变化阈值上报:当本次滤波值和上一次上报值差值小于设定阈值(温度0.3℃,湿度2%RH),不主动上报,维持原有上报周期,只有变化超过阈值才即时上报,也就是变化触发上报+定时基线上报结合机制,是UDP变送器在高密度场景最优方案。
6.2 网络侧优化
- 传感器独立划分物联网VLAN,和业务网、办公网隔离,广播报文隔离;
- 交换机端口调整队列缓存,开启QoS,动环UDP报文设置较高优先级;
- 所有变送器开启上电随机上报偏移,0~3s随机延时,规避上电同步报文风暴;
- 网线优先屏蔽双绞线,强电弱电分开走线,降低EMI带来的随机噪声,减少异常跳变。
6.3 网关侧优化
- 网关UDP接收缓冲区调大,开启报文去重、序号校验、CRC校验,脏报文直接丢弃;
- 区分稳态数据和告警数据,告警报文设置高优先级队列;
- 开启丢包率统计,测点丢包率持续大于5%推送网络质量告警,而不是依靠重传掩盖链路问题;
- 时序入库策略:稳态数据抽稀存储,变化超阈值全量入库,平衡存储容量与追溯能力。
6.4 平台侧告警体系优化
放弃单纯依赖固定阈值告警的模式,建立多维度告警体系:阈值告警、变化率告警、离线告警、探头故障告警、丢包率告警,多维度交叉判断,提前识别机柜热隐患,弥补采样周期带来的时间间隔。
七、压力测试验证方案
参数配置完成之后,需要做集群压力测试,验证参数合理性,测试指标:
- 交换机端口带宽、CPU利用率,稳态下交换机CPU负载低于60%;
- 测点平均丢包率<1%,无持续性报文丢弃;
- 网关采集线程CPU占用稳定,无周期性峰值阻塞;
- 温湿度曲线毛刺少,无频繁误告警;
- 模拟热故障,验证温升速率告警可以在设定时间内触发。
如果测试中出现丢包率飙升、网关负载高,优先拉长上报周期,而不是增加交换机、网关性能。很多时候不是硬件性能不足,是采样上报参数过载。
八、总结
高密度机柜场景下以太网温湿度变送器采样频率的误区,本质是把“采样频次”等同于“监控可靠性”。机柜温湿度属于慢变量,稳态工况下高频采样只会采集噪声、制造网络压力、增加存储开销,并不会提升监控价值;热失控这类快速故障,依靠变化率告警算法、动态上报机制就可以实现提前预警,不需要长期维持毫秒级、1s级高频上报。
工程落地的正确思路是:区分ADC本地采样和网络上报两个独立参数,变送器本地适度高频采样做滤波降噪,对外采用差异化上报周期,普通测点低频稳态上报、高风险电池机柜适度加密,同时配置变化率告警、变化触发上报、故障动态提速机制,搭配网络VLAN隔离、QoS、错峰上报等配套策略。在满足机房动环安全管控、热点告警识别的前提下,控制报文总量,保障整个高密度机柜集群动环系统长期稳定运行,避免因参数配置不当引发隐性网络故障、误告警、数据空洞等问题。采样频率没有统一的“越高越好”标准,适合机柜热流特征、网络负载、业务风险等级的参数,才是最优参数。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号