#WorkBuddy# 120 页"扫描件"版面还原:不去斜的 XY-cut 只有 0.64,校正 0.07° 斜角后冲到 0.92
原创
#WorkBuddy# 120 页"扫描件"版面还原:不去斜的 XY-cut 只有 0.64,校正 0.07° 斜角后冲到 0.92
原创
用户12784192
发布于 2026-11-07 11:14:18
发布于 2026-11-07 11:14:18
#WorkBuddy# 120 页"扫描件"版面还原:不去斜的 XY-cut 只有 0.64,校正 0.07° 斜角后冲到 0.92
痛点开场
把一批 PDF 扫描页交给 OCR 之前,有一道经常被跳过的工序:版面还原——把页面切成"标题 / 段落 / 表格 / 插图 / 图注"这些逻辑块,再按人类阅读顺序排好。这一步做不好,OCR 出来的文字就是乱的:双栏排版的左右栏被逐行穿插,表格被拆成碎片,图注跑到下一页的开头。
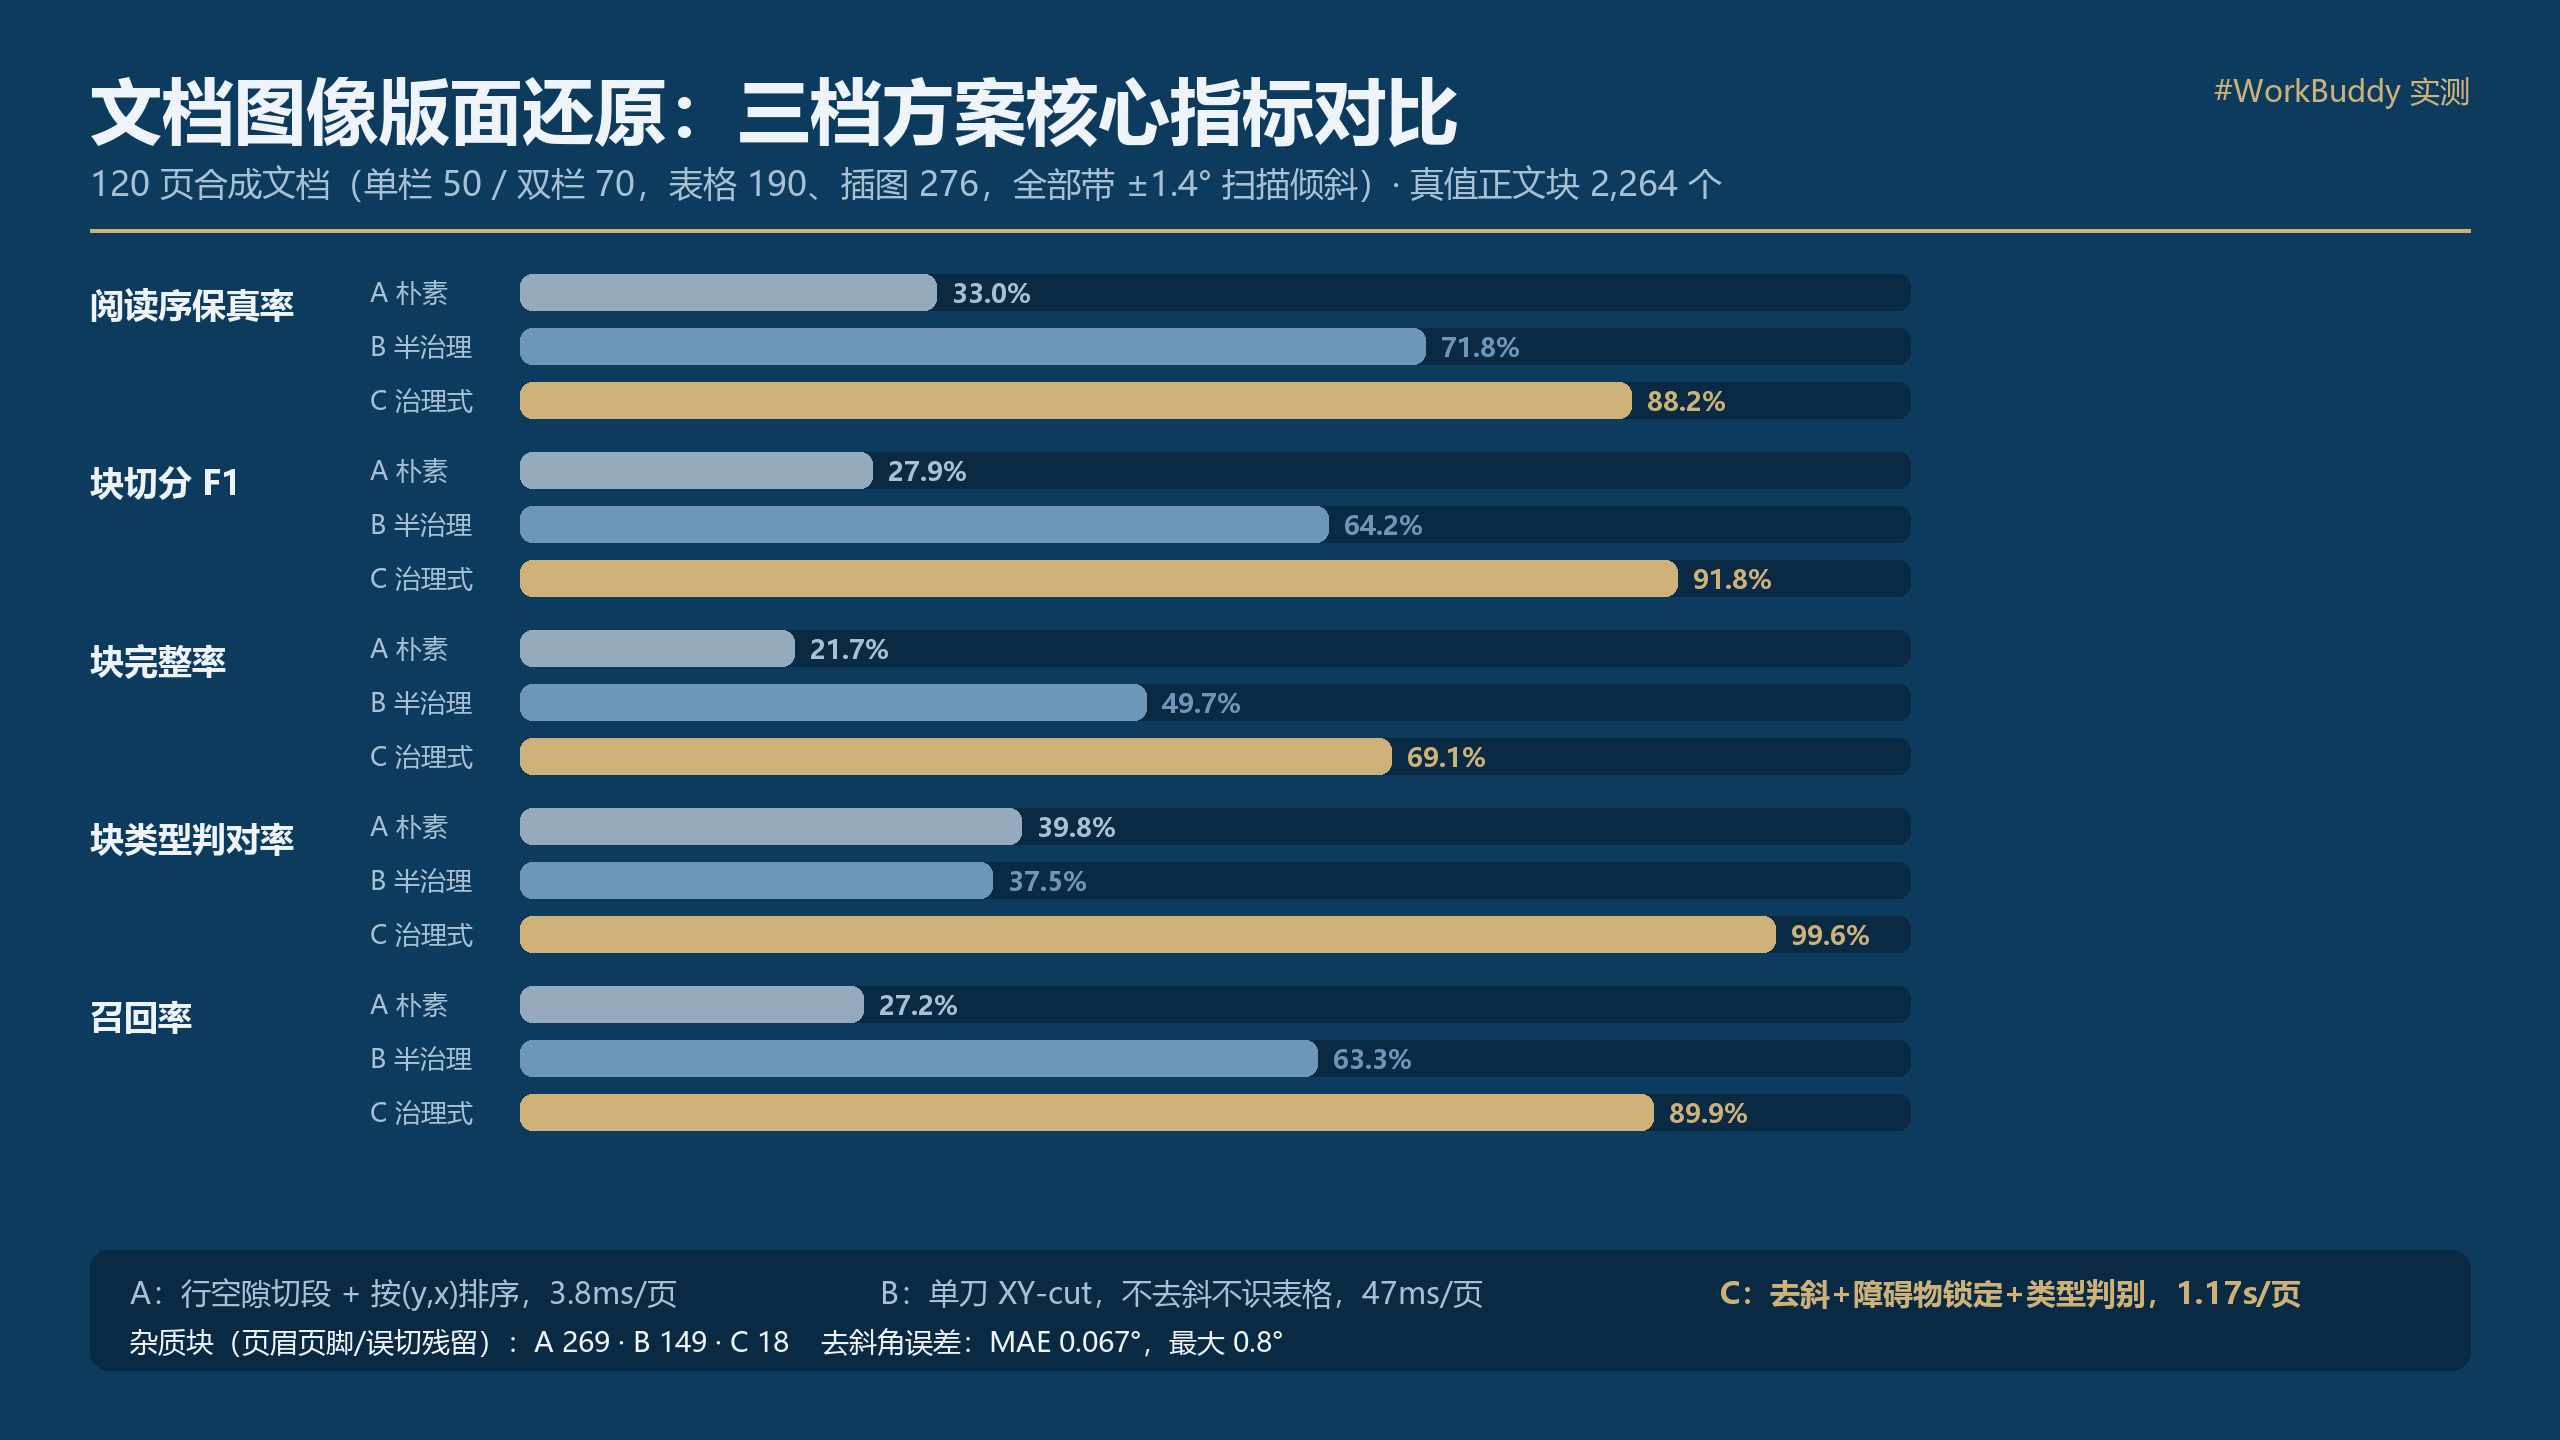
我在 WorkBuddy 里搭了一条版面还原流水线并做了三档对照实验:120 页合成文档(单栏 50 页、双栏 70 页,含 190 张表格、276 幅插图、33 个跨栏标题),每页再随机旋转 ±1.4° 模拟扫描件,真值标注 2,264 个正文块。结果:
- 朴素方案(按行空隙切段 + 按 y 坐标排序)阅读序保真率只有 33.0%;
- 半治理方案(递归 XY-cut 切分)恢复到 71.8%,但块切分 F1 只有 0.642;
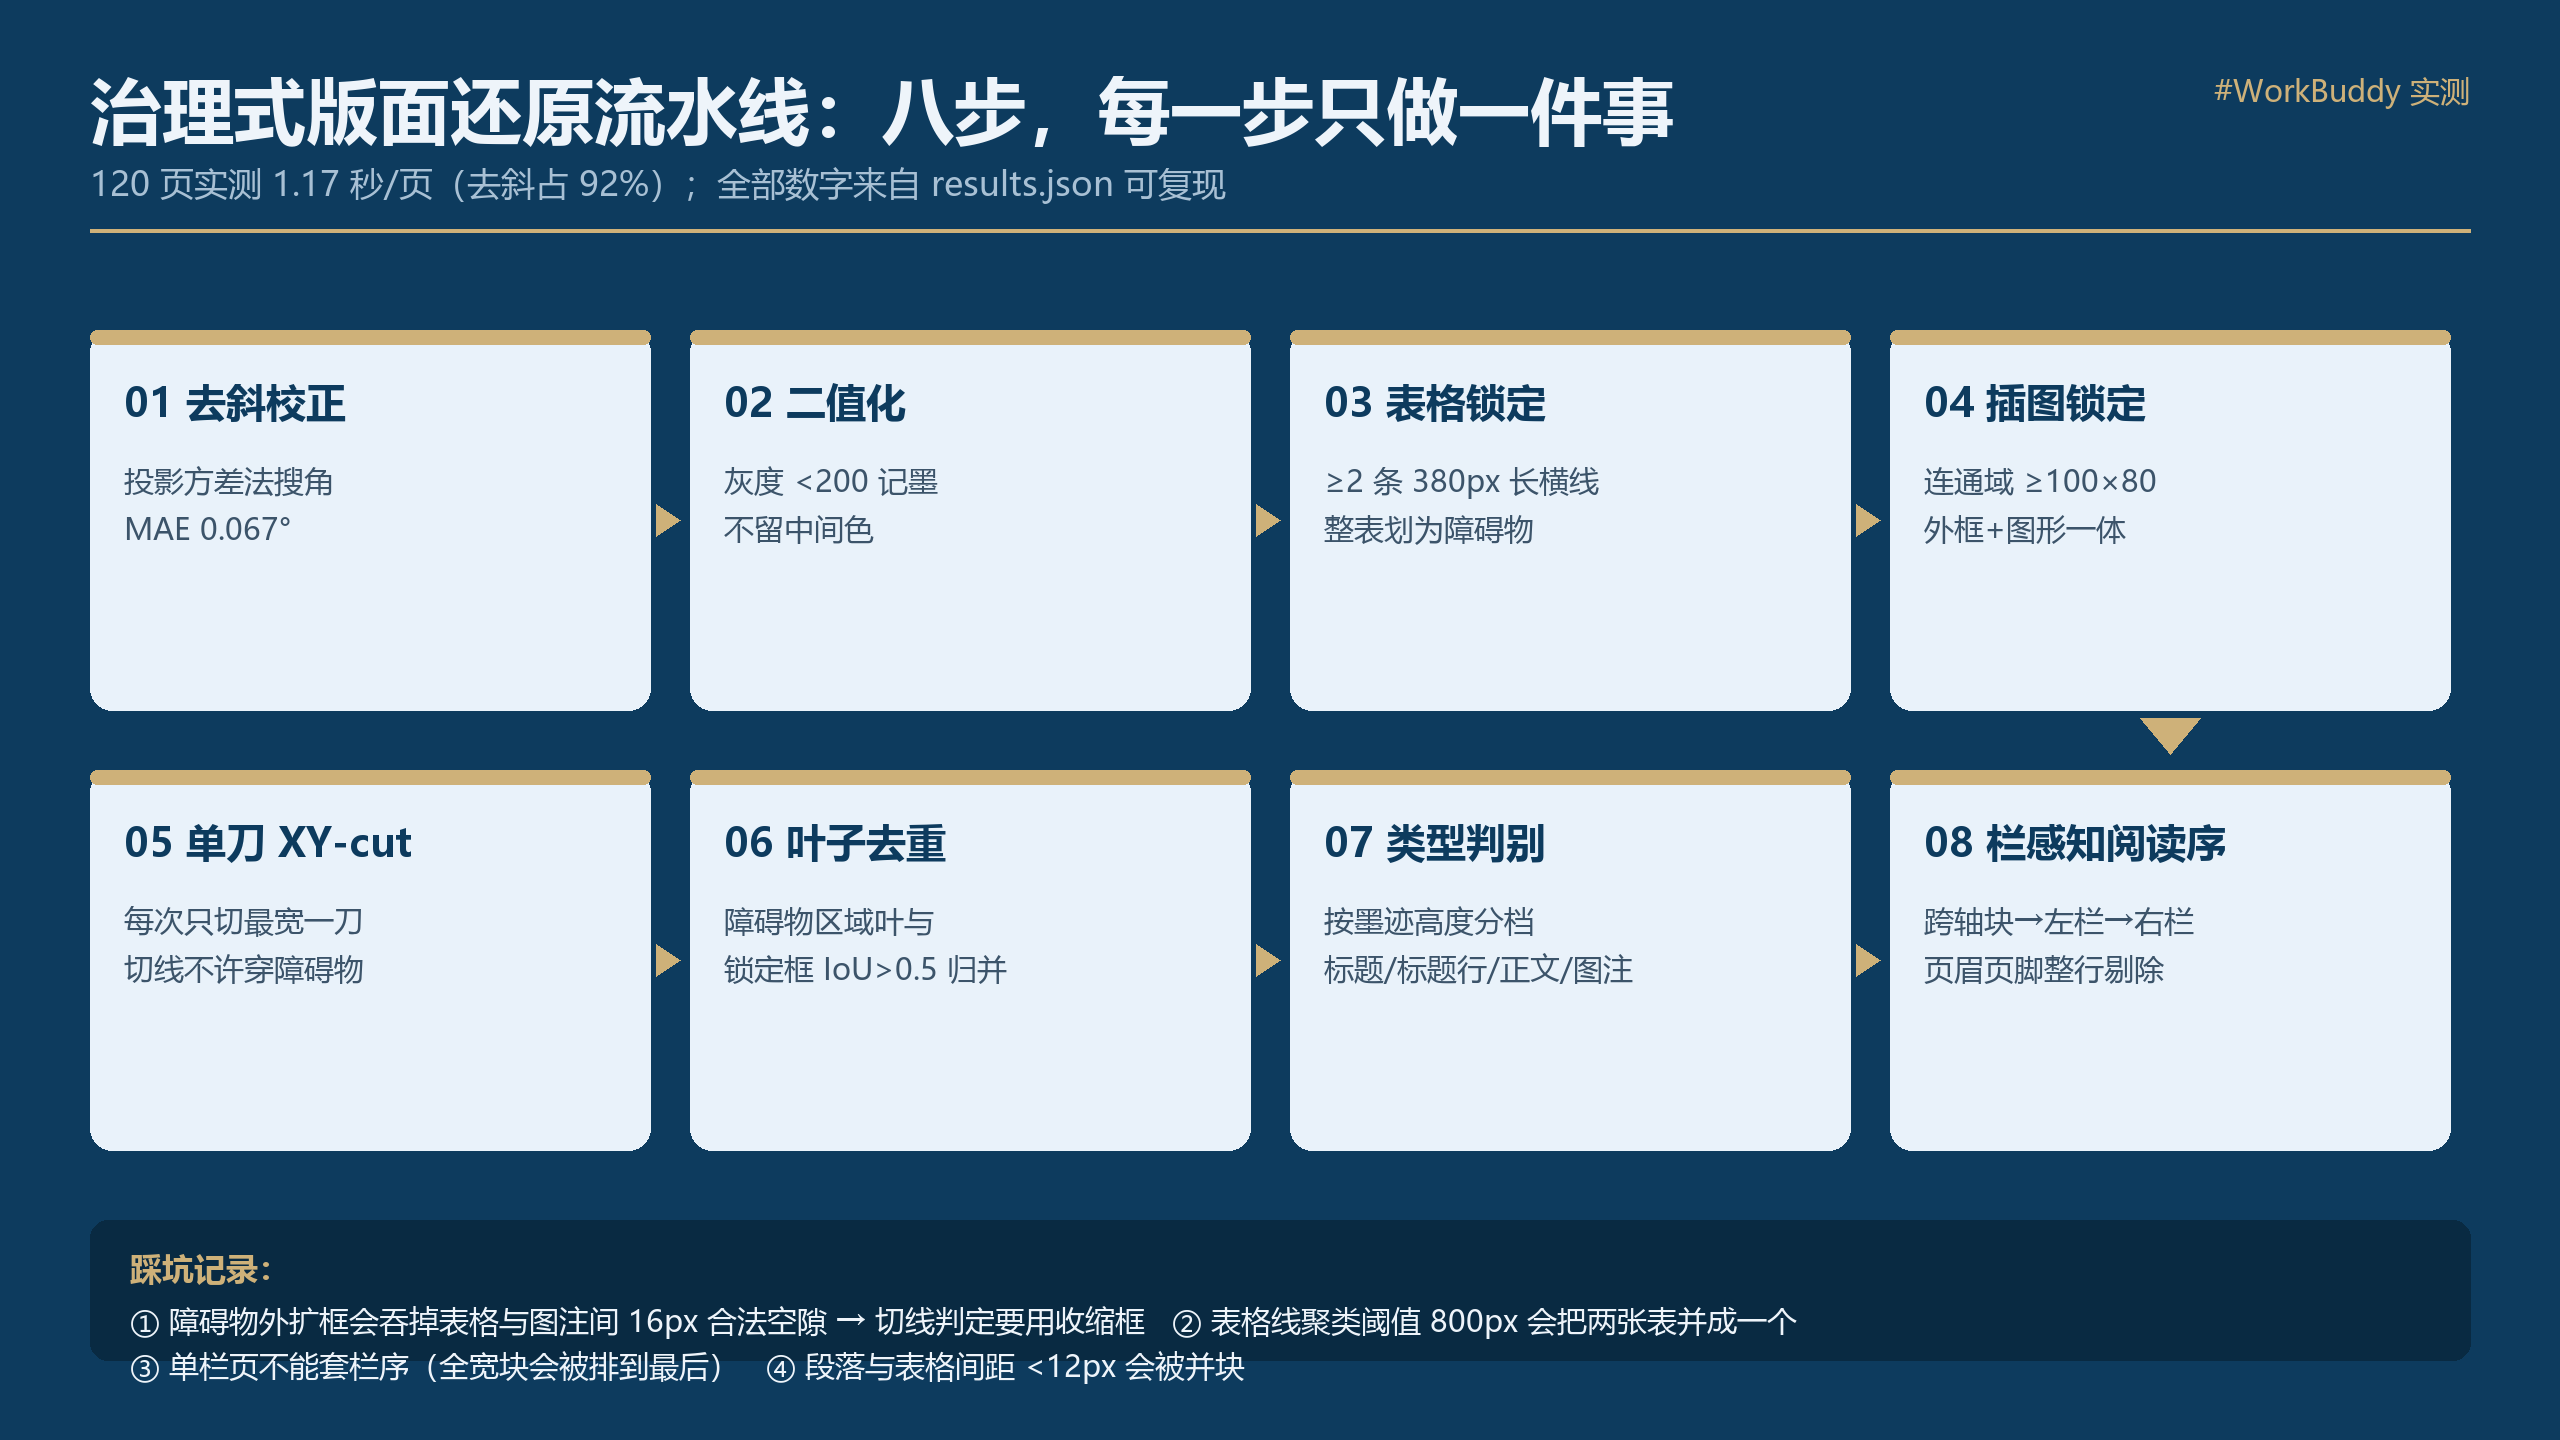
- 治理式流水线(去斜 → 障碍物锁定 → 单刀 XY-cut → 类型判别 → 栏感知排序)做到阅读序 88.2%、切分 F1 0.918、块类型判对 99.6%。
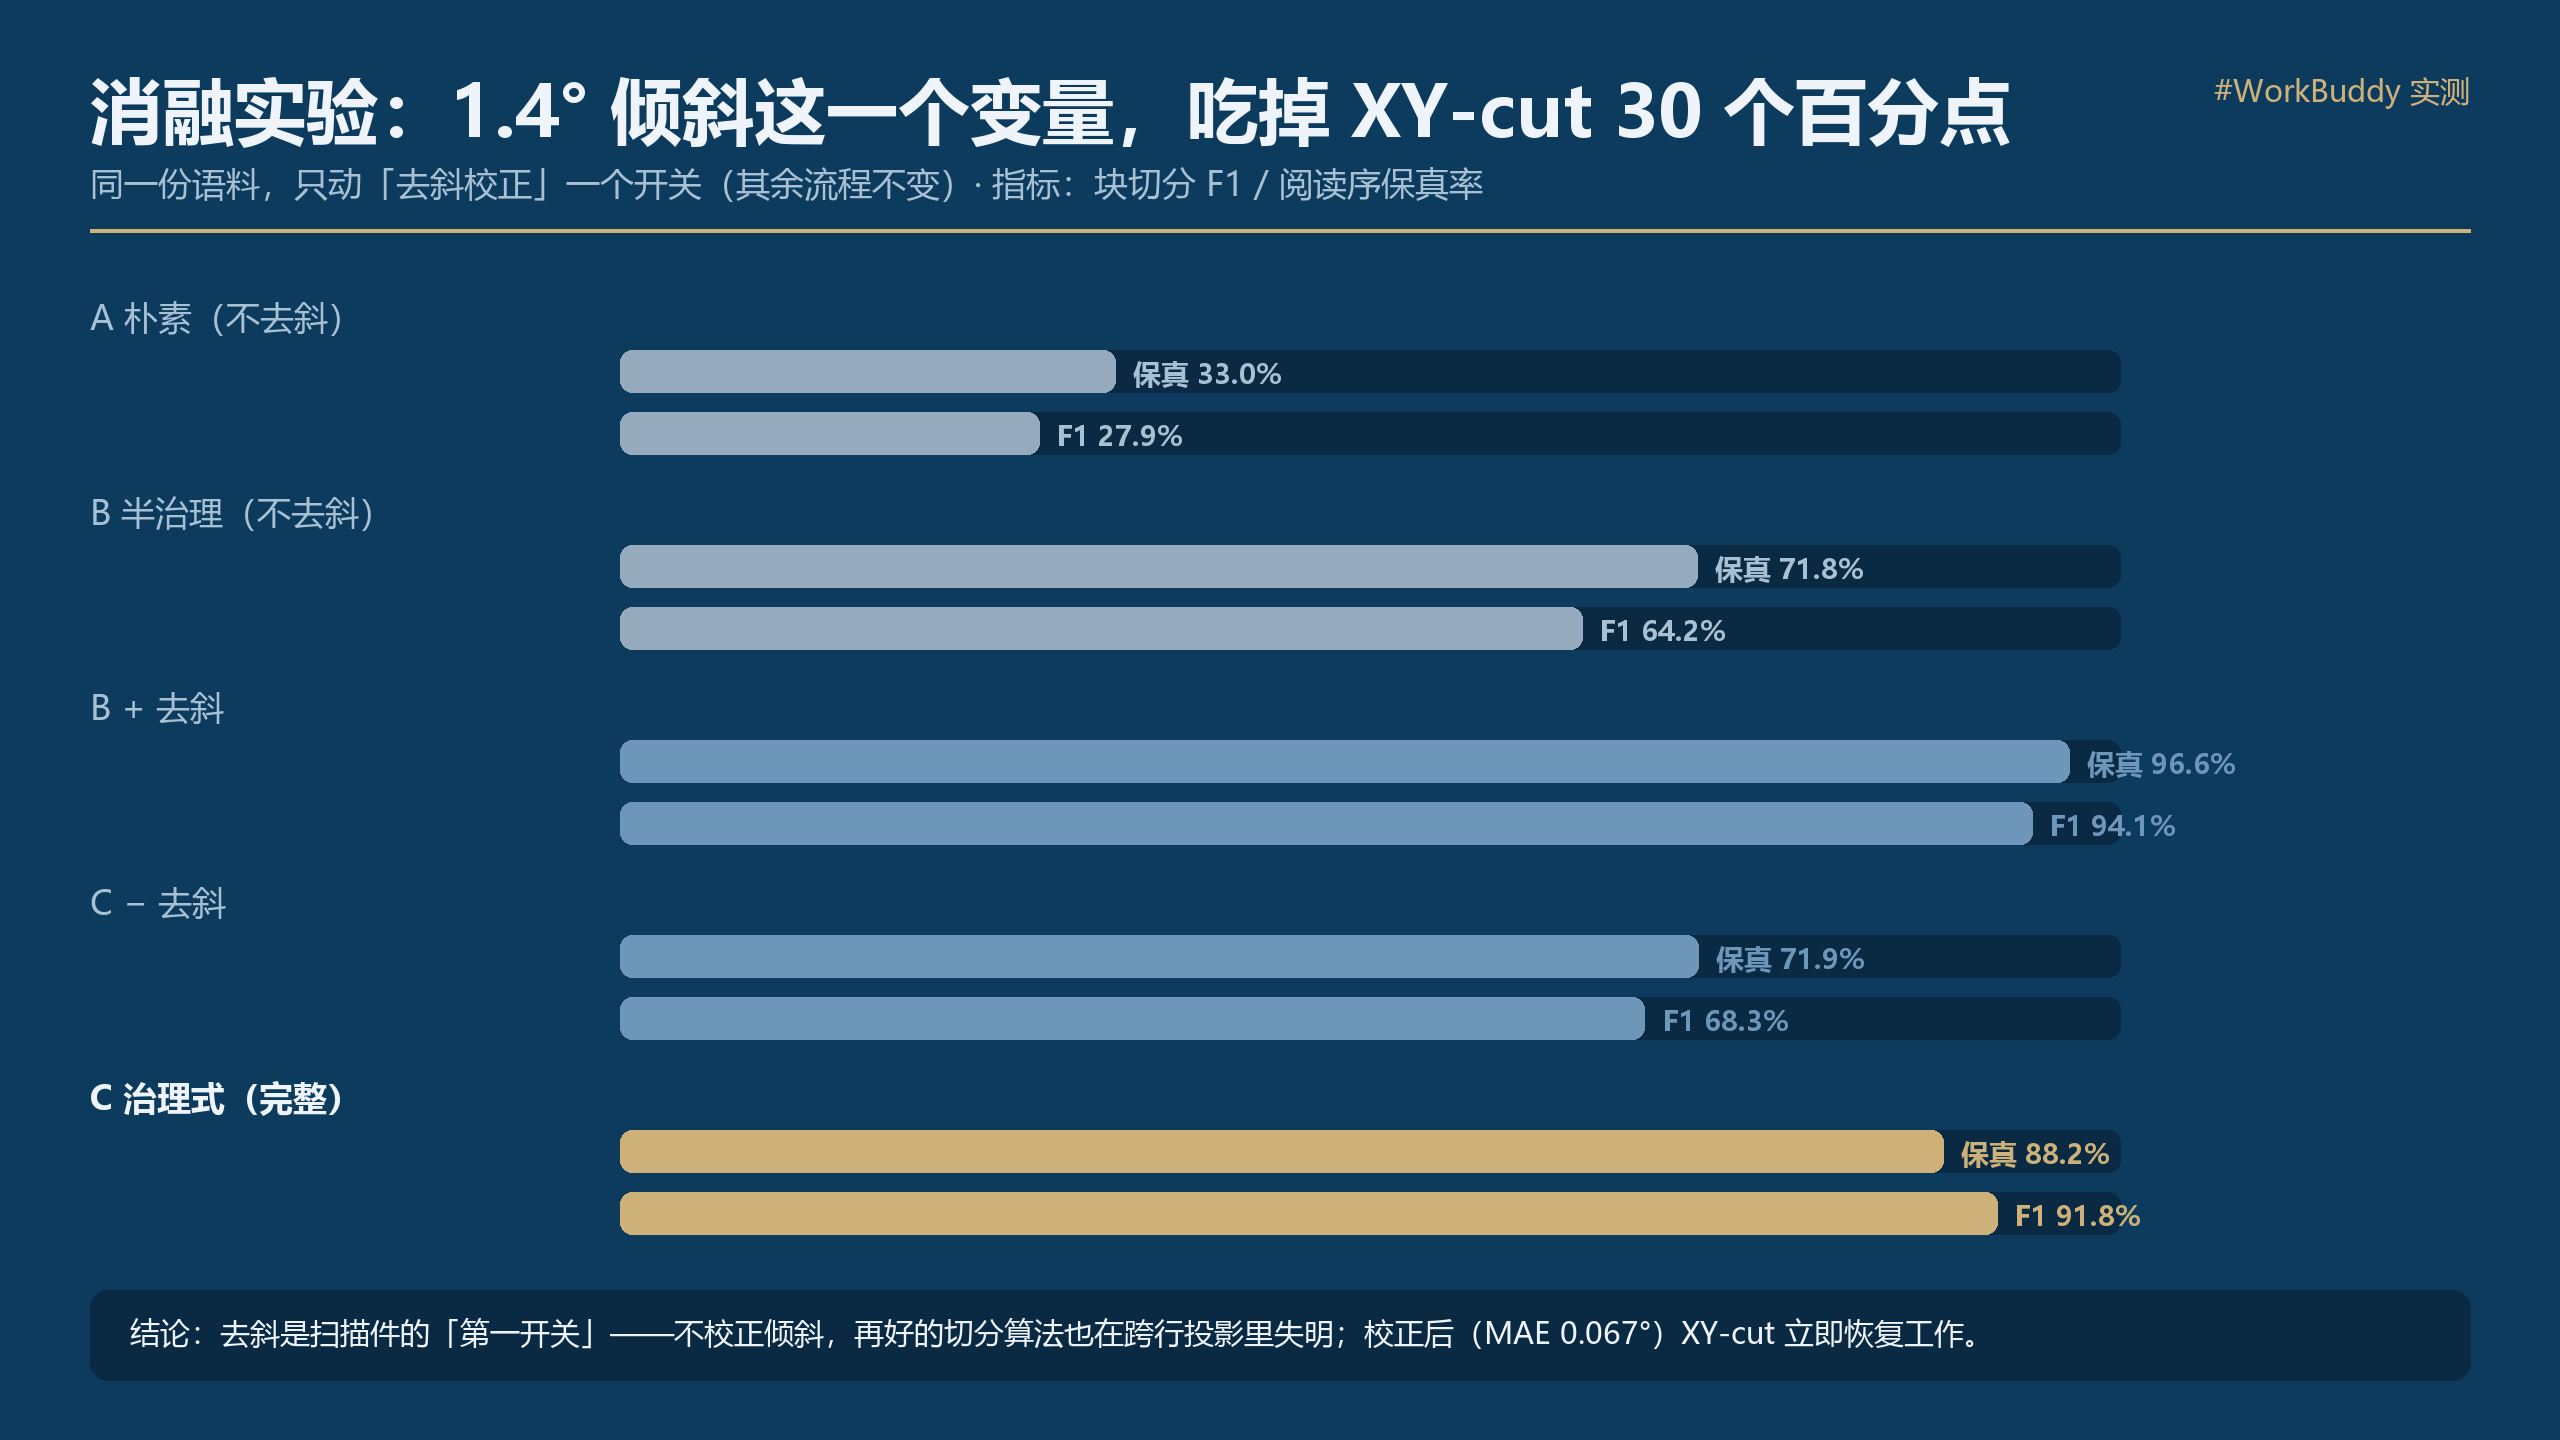
更有意思的是消融实验:1.4° 的页面倾斜这一个变量,就吃掉了 XY-cut 30 个百分点的 F1。下面把根因、数据、代码和踩坑一次讲清。
根因分析:三个失败模式
失败一:双栏页的 y 排序是灾难。 朴素方案把每页按水平空隙切成横条再按 (y, x) 排序。单栏页它有 76.0% 保真率,可一到双栏页就只剩 2.3%——左右两栏的块被逐行交替输出,左栏第一段和右栏第一段混在一起。实验里朴素方案在双栏页产生的"双栏交叠"逆序对占比 94%(59/62)。
失败二:倾斜让投影切分失明。 XY-cut 靠行列投影找空白带切分。页面一旦倾斜 1.4°,一行文字的墨迹会跨过 30 多个像素行,投影剖面里的"空白带"被邻居的墨迹填满——该切的切不开,不该切的乱切。实测不去斜的 XY-cut 切分 F1 0.642,同一算法先做去斜再切分,F1 直接跳到 0.941。去斜本身不难:投影方差法,在 ±2° 范围搜索使"行墨迹方差"最大的角度,120 页实测平均误差只有 0.067°(最大 0.8°)。
失败三:表格和插图不能交给通用切分。 只有横线、带空单元格的表格,内部空隙跟段落间距同量级,XY-cut 会把它切成一堆单元格碎片;插图的图注和正文段落又长一个样。治理式的做法是先识别、后锁定:检测到 ≥2 条 380px 以上的长横线,整表划为"障碍物",切分线不允许穿过;大连通域(≥100×80)同理锁定为插图。锁定要付一点代价——消融显示障碍物机制让 F1 从 0.941 降到 0.918(-2.3 点),但换来块类型判对率 37.5% → 99.6%、页眉页脚等杂质块 149 → 18。工程上这笔交换是值的:下游 OCR 按"表格块"走表格识别、按"插图块"走描述生成,类型错了后面全错。
真实数据对比表
三档方案在同一份 120 页语料上的实测(全部数字由 results.json 落盘可复现):
指标 | A 朴素(3.8ms/页) | B 半治理 XY-cut(47ms/页) | C 治理式(1.17s/页) |
|---|---|---|---|
阅读序保真率 | 33.01% | 71.82% | 88.19% |
块切分 F1 | 0.279 | 0.642 | 0.918 |
切分精确率 | 32.84% | 66.42% | 94.91% |
切分召回率 | 27.24% | 63.28% | 89.90% |
块完整率 | 21.74% | 49.71% | 69.10% |
块类型判对率 | 39.80% | 37.45% | 99.63% |
杂质块总数 | 269 | 149 | 18 |
消融(只动去斜一个开关):
配置 | 阅读序保真率 | 切分 F1 |
|---|---|---|
B 半治理(不去斜) | 71.82% | 0.642 |
B + 去斜 | 96.60% | 0.941 |
C − 去斜 | 71.88% | 0.683 |
C 治理式(完整) | 88.19% | 0.918 |
两个结论:一是去斜贡献了绝大部分收益(B 档 +24.8 点保真);二是单双栏要分开看——A 档单栏 76.0% / 双栏 2.3%,B 档单栏 65.6% / 双栏 76.3%(倾斜把它单栏的优势也毁了),C 档单栏 94.3% / 双栏 83.8%。治理式去斜耗时占总耗时 92.3%(1.08s/页),想提速先优化角度搜索(降采样或粗细两级搜),切分本身只占 0.09s/页。
@@FIG1@@
可复制代码
核心三段:去斜、障碍物检测、单刀 XY-cut(每次只切当前最宽的一刀,切线不许穿过障碍物)。
import numpy as np
from PIL import Image

def deskew(ink):
    """投影方差法去斜:行墨迹方差最大的角度即校正角"""
    im = Image.fromarray(ink.astype(np.uint8) * 255)
    best_a, best_s = 0.0, -1
    for a in np.arange(-2.0, 2.01, 0.2):          # 粗搜
        r = np.array(im.rotate(a, resample=Image.BILINEAR, fillcolor=0))
        s = float(np.var(r.sum(1).astype(np.float64)))
        if s > best_s: best_s, best_a = s, a
    for a in np.arange(best_a - 0.2, best_a + 0.21, 0.05):  # 细搜
        r = np.array(im.rotate(a, resample=Image.BILINEAR, fillcolor=0))
        s = float(np.var(r.sum(1).astype(np.float64)))
        if s > best_s: best_s, best_a = s, a
    return np.array(im.rotate(best_a, resample=Image.BILINEAR, fillcolor=0)) > 120, float(best_a)

def detect_tables(ink):
    """>=2 条 380px 长横线且行距 <=60px → 锁为表格障碍物"""
    h, w = ink.shape
    line_rows = []
    for y in range(h):
        nz = np.nonzero(ink[y])[0]
        if len(nz) == 0: continue
        d = np.diff(nz); brk = np.nonzero(d > 1)[0]
        starts = np.concatenate([[0], brk + 1])
        ends = np.concatenate([brk, [len(nz) - 1]])
        run = max((nz[e] - nz[s] + 1) for s, e in zip(starts, ends))
        if run >= 380:
            line_rows.append(y)
    groups = []
    for y in line_rows:
        if groups and y - groups[-1][-1] <= 60: groups[-1].append(y)
        else: groups.append([y])
    boxes = []
    for g in groups:
        if len(g) < 2: continue
        xs = np.nonzero(ink[g[0]])[0]   # 首行横线横贯表宽 → 其起止即表格 x 范围
        boxes.append((int(xs[0]), g[0] - 4, int(xs[-1]), g[-1] + 2, "table"))
    return boxes
@@FIG2@@
def xy_cut(ink, x0, y0, x1, y1, obstacles, out, min_hg=12, min_vg=26):
    """单刀递归 XY-cut:横竖一起比,每次只切最宽的一刀"""
    if x1 - x0 < 8 or y1 - y0 < 8: return
    sub = ink[y0:y1, x0:x1]
    if sub.sum() == 0: return
    for ob in obstacles:                       # 整块落在障碍物内 → 叶子
        if ob[0] <= x0 and x1 <= ob[2] and ob[1] <= y0 and y1 <= ob[3]:
            out.append({"bbox": [x0, y0, x1, y1], "type": ob[4]}); return
    def gaps(profile, ming):
        runs, st = [], None
        for i, v in enumerate(profile):
            if v == 0:
                st = i if st is None else st
            else:
                if st is not None and i - st >= ming: runs.append((st, i))
                st = None if v != 0 else st
        if st is not None and len(profile) - st >= ming: runs.append((st, len(profile)))
        return runs
    def ok(g, axis):                           # 切线不穿障碍物(用收缩 3px 的框判)
        for ox0, oy0, ox1, oy1, _ in obstacles:
            ox0, oy0, ox1, oy1 = ox0+3, oy0+4, ox1-3, oy1-4
            if axis == "x":
                gx0, gx1 = x0+g[0], x0+g[1]
                if gx1 > ox0 and gx0 < ox1 and oy1 > y0 and oy0 < y1 \
                   and ox0 >= x0-2 and ox1 <= x1+2 and oy0 >= y0-2 and oy1 <= y1+2:
                    return False
            else:
                gy0, gy1 = y0+g[0], y0+g[1]
                if gy1 > oy0 and gy0 < oy1 and ox1 > x0 and ox0 < x1 \
                   and ox0 >= x0-2 and ox1 <= x1+2 and oy0 >= y0-2 and oy1 <= y1+2:
                    return False
        return True
    xg = [g for g in gaps(sub.sum(0), min_vg) if ok(g, "x")]
    yg = [g for g in gaps(sub.sum(1), min_hg) if ok(g, "y")]
    best = None
    for axis, gs in (("x", xg), ("y", yg)):
        for g in gs:
            if best is None or g[1]-g[0] > best[0]: best = (g[1]-g[0], axis, g)
    if best is None:
        out.append({"bbox": [x0, y0, x1, y1], "type": "text"}); return
    _, axis, (a, b) = best
    if axis == "x":
        xy_cut(ink, x0, y0, x0+a, y1, obstacles, out, min_hg, min_vg)
        xy_cut(ink, x0+b, y0, x1, y1, obstacles, out, min_hg, min_vg)
    else:
        xy_cut(ink, x0, y0, x1, y0+a, obstacles, out, min_hg, min_vg)
        xy_cut(ink, x0, y0+b, x1, y1, obstacles, out, min_hg, min_vg)
阅读序最后一步:先剔除页眉页脚(整块在页顶 80px / 页底 60px 内),再判断页面是否有第二栏(存在 x0 > 页面中轴的块);单栏页全部按 y 排序,双栏页按"跨轴块 → 左栏按 y → 右栏按 y"输出。块类型按墨迹高度分档:大于 28px 是标题、18–28px 是章节标题行、17px 以下且紧邻障碍物下沿 40px 内的是图注,其余是正文段落。
@@FIG3@@
踩坑清单
这次 120 页跑通,一多半时间花在修正面流水线自身的坑上,每一条都实测过:
- XY-cut 不能"一刀切多段"。早期版本对水平空隙一次性切完,双栏页的切分带里左右栏交错输出,逆序对 1,910 个;改成"横竖一起比、每次只切最宽一刀"的递归后降到 35 个。
- 障碍物外扩框会吞合法空隙。表格框上沿外扩 4px 余量后,表格与图注之间 16px 的真实空隙被判成"穿越障碍物"而禁止切分,图注全部并进表格块。切线判定必须用收缩后的障碍物框,不能用外扩框。
- 表格线聚类阈值不能拍脑袋。初版把"800px 内的横线"并成一组,同栏两张相距 600px 的表格被并成一个巨大障碍物,整栏切分被封锁,召回率掉到 0.59。表内行距是 30px,阈值改 60px 才对。
- 单栏页不能套栏序。"跨轴块→左栏→右栏"的三段式用在单栏页,会把全宽的标题、段落排到最后(先决条件:确实存在第二栏)。
- 类型判别要用墨迹高度,不是外框高度。单行段落外框高 26px,和 22px 的章节标题几乎分不开;但真实墨迹高度一个 17px 一个 22px,边界干净。
- 保真率分母必须含未覆盖块。早期只统计"被识别出来的块"的逆序率,朴素方案漏掉一半的块反而得 91% 保真——指标分母错了,结论全是假的。
- 真值 bbox 要贴墨迹。标题真值框最初取了全宽,而标题文字只有 544px,IoU 永远到不了 0.7,三档方案的标题召回全是 0——语料错了,先修语料。
给 WorkBuddy 的提示词模板
这套流水线在 WorkBuddy 里一句话就能复现,模板拿走直接用:
请用 Python 完成文档图像版面还原,要求:
1. 输入 <图片目录>,输出 blocks.json(每块含 bbox、type、阅读序号);
2. 流水线:投影方差法去斜(±2°粗搜0.2°+细搜0.05°) → 二值化 →
   长横线(>=380px、>=2条、行距<=60px)锁定表格 → 连通域(>=100x80)锁定插图 →
   单刀 XY-cut(水平垂直空隙一起比,每次切最宽一刀,切线不穿障碍物,行空隙阈值12px、列空隙阈值26px) →
   页眉页脚剔除(整块在页顶80px/页底60px内) → 类型判别(墨迹高度>28标题/18-28章节行/<=17且邻障碍物为图注) →
   阅读序(有第二栏时:跨轴块→左栏按y→右栏按y;单栏页全按y);
3. 评估:与真值比 IoU>=0.7 的切分 F1、IoU>=0.8 的块完整率、按真值序的逆序对率;
4. 所有中间结果落盘 JSON,报告每页耗时与去斜角误差。
收尾
三档方案的差距不是"算法更聪明",而是三件朴素的事:先把页面摆正,再让切分器看见空白;识别不了的表格插图就锁定成整块;最后按排版常识排阅读序。0.6 到 0.92 之间隔着的不是深度学习,是去斜那 0.07° 和障碍物那几条长横线。完整脚本、真值与 results.json 都可复现,欢迎在评论区拿去跑你自己的扫描件。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号