让极速交易从物理机迈向超融合时代:4家金融机构的验证与实践
原创
让极速交易从物理机迈向超融合时代:4家金融机构的验证与实践
原创
SmartX
修改于 2026-11-11 11:48:53
修改于 2026-11-11 11:48:53
在期货和证券行业中,极速交易、行情推送、算法策略执行等业务对网络与计算延迟极为敏感,微秒级时延差异都可能影响交易效率与系统表现。传统物理架构虽能满足高频交易的性能与低延迟需求,但在使用成本等方面存在明显挑战:
- 空间与资源利用率低:交易所机柜空间和电力资源紧张,物理服务器资源利用率不足,拉高托管成本并带来资源浪费。
- 难以满足定制化需求:不同交易系统需求不一,需大量采购多种服务器满足定制化需求,大幅提升采购成本。
- 难以实现国产化转型:传统物理架构国产化改造难度大、成本高,难以满足自主可控趋势。
一个关键问题摆在面前:更具成本优势的超融合架构,能否承载核心的低延迟交易?
以下,我们将结合四家金融机构的测试实践,分享超融合在低延迟交易场景中的性能表现、调优思路与落地价值,供企业用户参考。
基于超融合的低延时解决方案:多重核心技术支撑
针对低延迟交易场景,超融合从计算、网络、存储三个维度进行全栈性能优化,同步保障核心交易的高性能、低延迟与高可用:
- 计算效能:通过 CPU 独占、vCPU 绑核、NUMA 亲和与 Boost 模式,提升计算性能与计算资源利用率。
- 存储性能:按需启用 Boost 与 RDMA,配合 I/O 本地化及高性能硬件平台实现低 I/O 延时。
- 网络低延迟:支持PCIe 网卡直通与 SR-IOV 网卡切分,绕过虚拟网络路径,降低延迟抖动。
- 高可用:支持挂载 SR-IOV 网卡的虚拟机 HA,并结合反亲和与双网卡冗余提升连续性。
基于以上技术特性,企业用户可针对不同业务场景,采用不同技术路径进行验证与性能优化:行情接收链路优先验证 PCI 网卡直通,交易报盘链路可通过 SR-IOV 兼顾低时延与网卡资源复用,PTP 与管理网络独立隔离,关键虚拟机通过 CPU 独占、NUMA 亲和与反亲和策略减少资源争用。
多场景全域性能探索验证
场景一:某期货机构基于 AMD 环境的低延迟托管交易场景验证
在期货托管交易场景中,某期货机构需要为不同客户交付低延迟策略机,对网络时延、计算性能、资源隔离和交付效率都有较高要求。但随着客户规模扩大,传统物理机模式容易带来资源利用率不足、机柜空间紧张和交付周期较长等问题。
为评估超融合在期货托管交易场景中的可行性,该机构基于 AMD 四代服务器,针对虚拟机与物理机两个环境的性能基线进行对比,重点验证两个环境的计算性能、网络时延、网络带宽和柜台穿透时延。测试使用同一套 AMD 四代服务器硬件,先部署物理环境形成性能基线,再部署超融合架构进行相同的虚拟机性能基准测试。
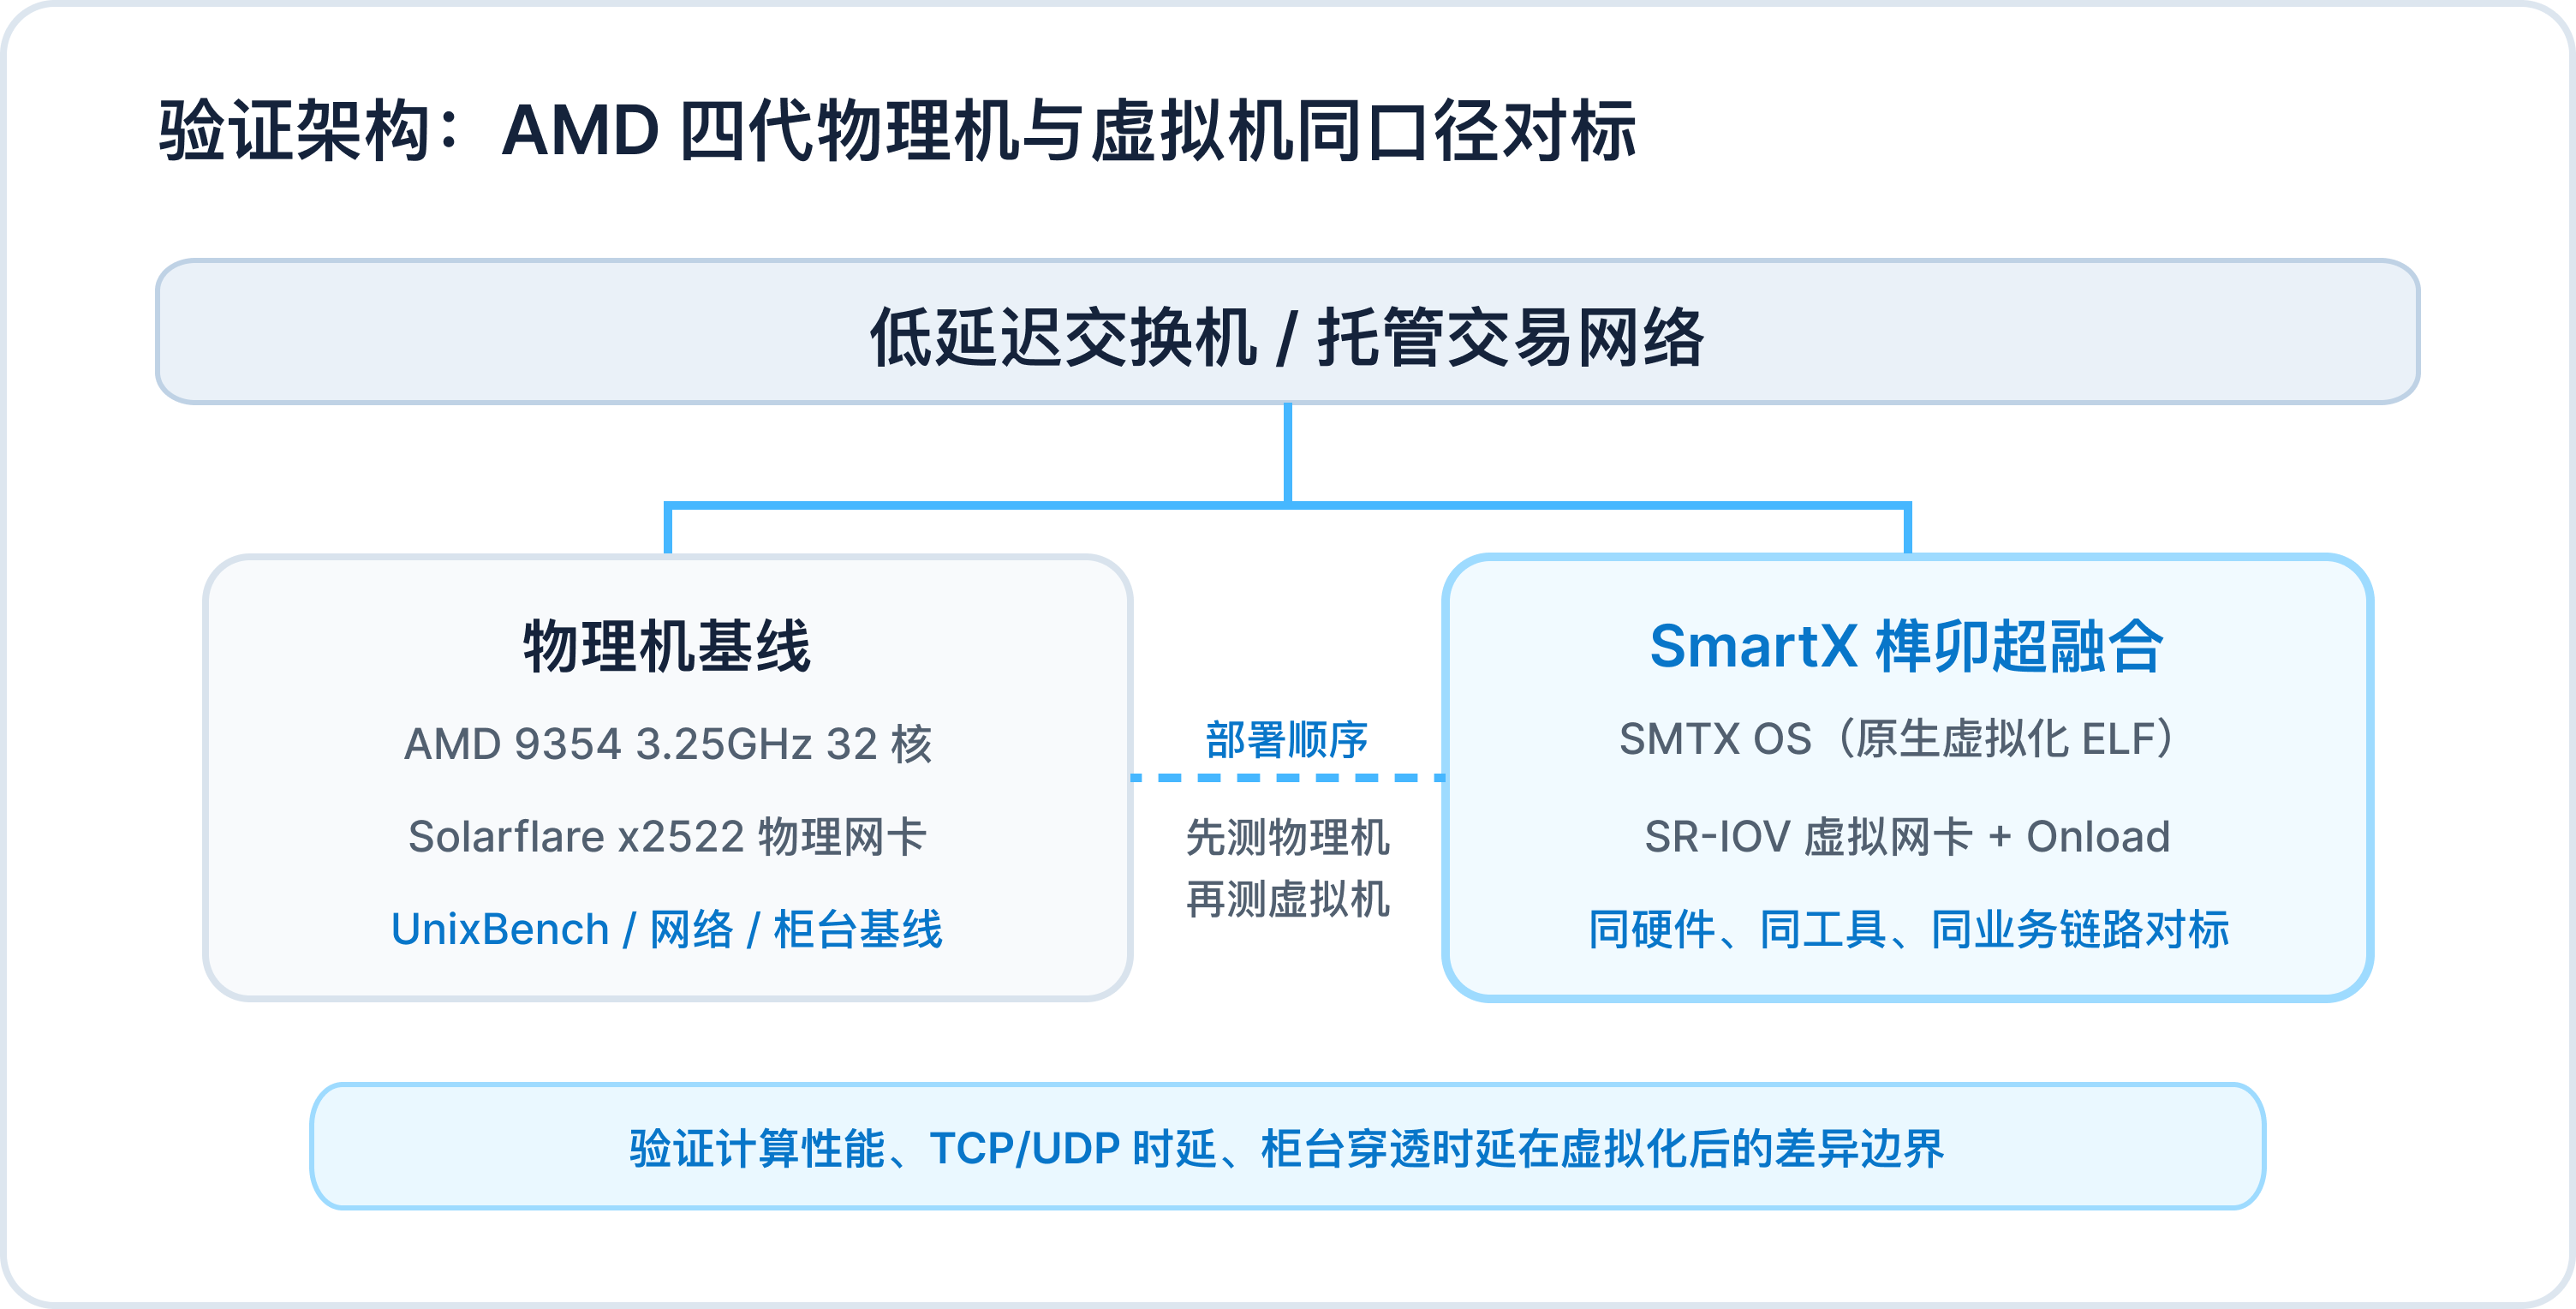
图:验证架构 – AMD 四代物理机与国产超融合配置对标
测试环境
集群配置项 | 测试环境 | |||
|---|---|---|---|---|
集群规模 | 3 节点 AMD 四代服务器超融合集群 | |||
服务器配置 | AMD 9354 3.25GHz 32 核 CPU | |||
内存配置 | DDR5 512GB | |||
存储配置 | 3.84TB SSD × 4 | |||
网络配置 | Solarflare x2522 × 1 | |||
虚拟机配置项 | 8C/16G | SR-IOV 网卡 | |||
|---|---|---|---|---|
测试数据
基准性能测试
测试项 | AMD 物理机 | 榫卯超融合虚拟机 | 差异 | |
|---|---|---|---|---|
UnixBench 单线程 | 2666.8 | 2332.7 | -12.7% | |
UnixBench 8 线程 | 16075.3 | 14319.5 | -10.9% | |
网络带宽 | 9.41Gbps | 9.41Gbps | 一致 | |
柜台穿透时延 | 3~4us | ~5us | +1~2us | |
低延时压测 – sfnt-pingpong
TCP 延时/size | 1 | 16 | 32 | 64 | 128 | 512 |
|---|---|---|---|---|---|---|
AMD 物理机 | 1.724us | 1.738us | 1.751us | 1.789us | 1.869us | 2.105us |
榫卯超融合虚拟机 | 1.757us | 1.769us | 1.782us | 1.813us | 1.895us | 2.136us |
UDP 延迟/size | 1 | 16 | 32 | 64 | 128 | 512 |
|---|---|---|---|---|---|---|
AMD 物理机 | 1.620us | 1.620us | 1.649us | 1.677us | 1.747us | 1.994us |
榫卯超融合虚拟机 | 1.639us | 1.640us | 1.674us | 1.702us | 1.767us | 2.022us |
验证结论
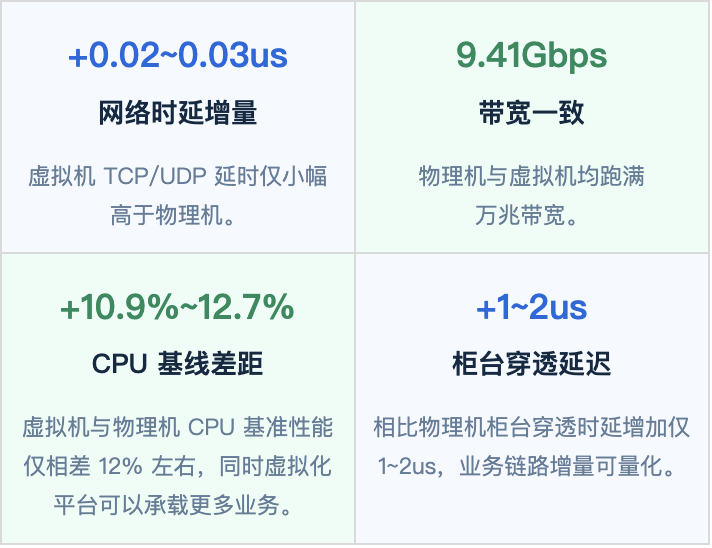
结果表明,虚拟机相比物理机网络损耗低、吞吐相当:虚拟机网络时延相比物理机仅增加约 0.02~0.03us,网络吞吐与物理机一致;CPU 基准性能差距约 10% 左右,柜台穿透时延增加约 1~2us。目前,基于测试结果,客户已启动基于榫卯超融合的业务试运行,并计划扩容后承接中低频托管业务。
- 经验分享:低延迟业务虚拟化需综合 CPU 主频、网卡模式、网络隔离、业务压力模型联合验证;通过分阶段测试 + 渐进试运行,能够在可控风险下提升基础设施资源利用率与交付弹性。
场景二:某证券机构基于 Intel 环境的低延迟与 HA 场景探索
在券商托管和极速交易场景中,很多存量业务仍基于 Intel x86 服务器建设,无法在短期内全部迁移到新的硬件平台。对于这类场景环境而言,虚拟化改造需要回答两个问题:通用 x86 硬件上的虚拟机网络时延是否可控,以及主机、进程或网卡故障时业务能否快速恢复。
某证券机构 A 基于浪潮 Intel 通用商用服务器搭建三节点榫卯超融合集群,搭配 Solarflare 低延迟网卡、SR-IOV 网卡虚拟化和 Onload 高性能网络协议栈,对网络性能、柜台业务穿透时延以及虚拟机 HA 故障切换能力进行验证。
验证环境
配置项 | 测试环境 |
|---|---|
集群规模 | 3 节点榫卯超融合集群,运行超融合原生虚拟化 ELF,开启虚拟机 HA |
服务器配置 | 浪潮 NF5280M5;Intel 6248R 3.0GHz 24 核 CPU |
内存配置 | DDR4 256GB |
存储配置 | 1.92TB SSD × 2、18TB HDD × 8 |
网络配置 | Solarflare x2522 低延迟网卡 × 2;虚拟机低延迟行情、交易业务网口统一上联 Cisco 3548 低延迟交换机 |
网卡虚拟化 | 通过 SR-IOV 将物理端口拆分为多组 VF 虚拟端口,供多台业务虚拟机使用 |
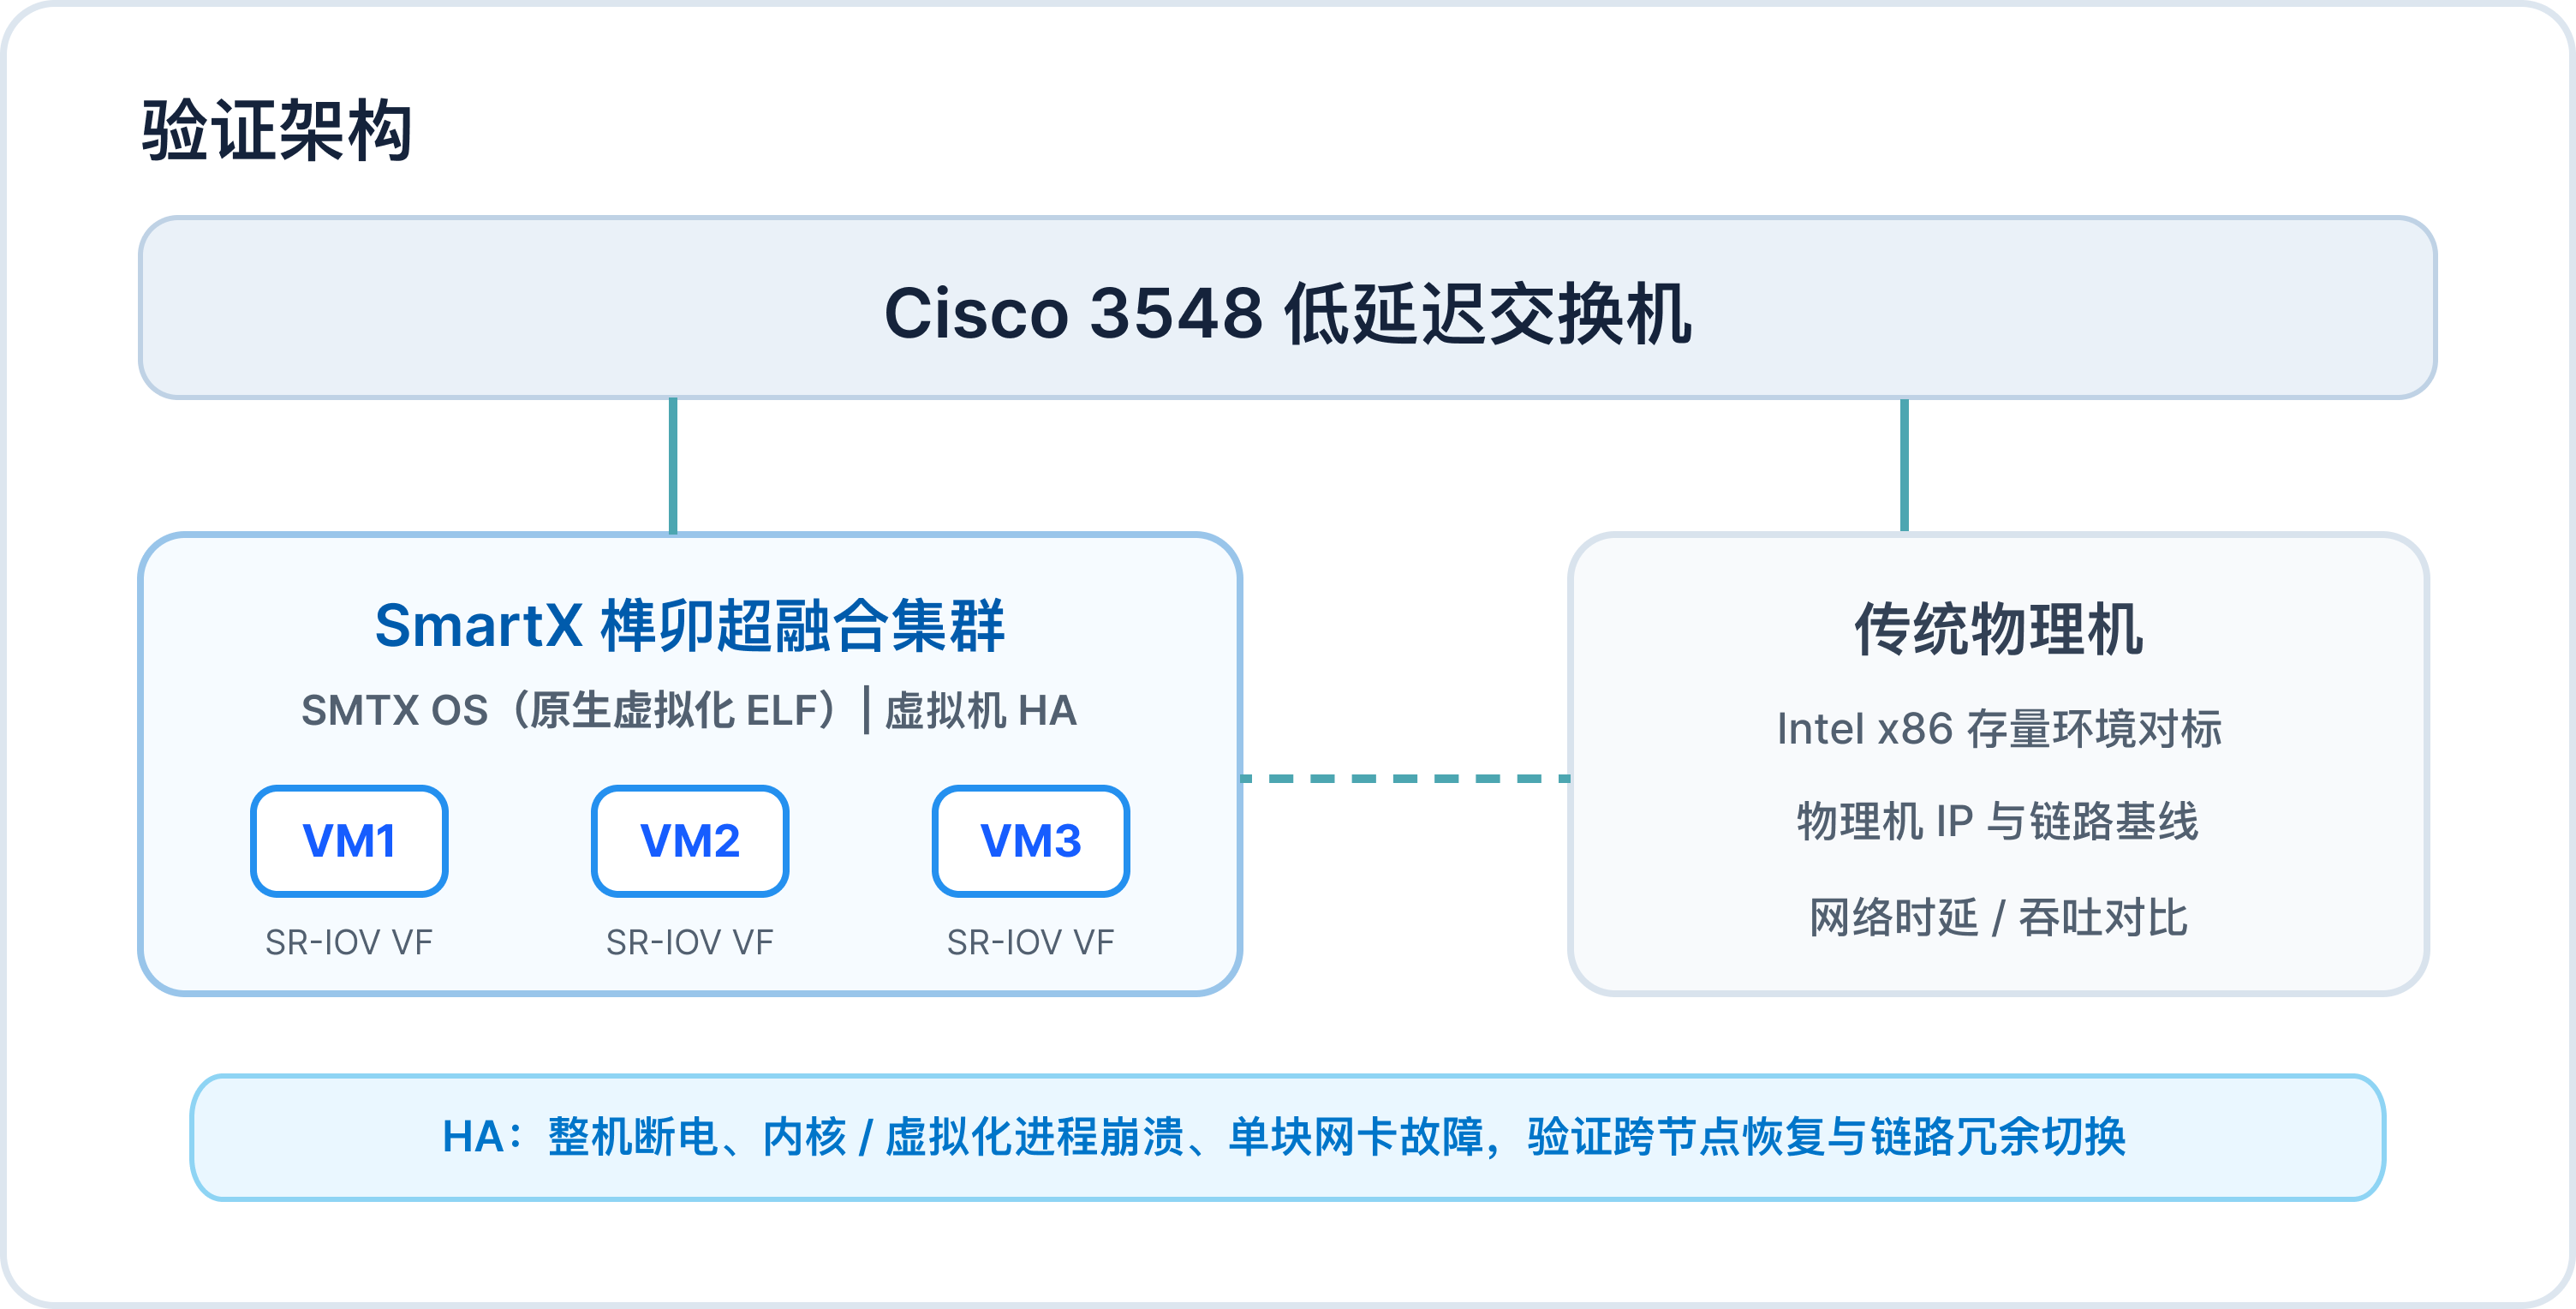
图:某证券机构 A 低延迟与 HA 高可用验证架构
测试数据
基于 Intel 环境的超融合低延迟性能与 HA 验证
网络测试项 | 传统物理机 | 榫卯超融合 SR-IOV 虚拟机 | 差异 | ||||
|---|---|---|---|---|---|---|---|
极限网络带宽 | 9.42Gbps | 9.42Gbps | 一致 | ||||
柜台业务穿透时延 | 3~4us | 3.3~4.3us | +0.3us 左右 | ||||
低延迟-Onload /size | 64TCP | 128TCP | 64UDP | 128UDP | ||||
|---|---|---|---|---|---|---|---|---|
传统物理机 | 1.805us | 1.874us | 1.708us | 1.778us | ||||
榫卯超融合 SR-IOV 虚拟机 | 1.820us | 1.891us | 1.709us | 1.778us | ||||
- TCP:超融合 SR‑IOV 虚拟机延迟略高于物理机,差异很小,最大差值仅 0.017μs。
- UDP:两者几乎完全持平,64UDP 仅差 0.001μs,128UDP 数值完全一致。
低延迟-TcpDirect/size | 64TCP | 128TCP | 64UDP | 128UDP | ||||
|---|---|---|---|---|---|---|---|---|
传统物理机 | 1.542us | 1.628us | 1.449us | 1.539us | ||||
榫卯超融合 SR-IOV 虚拟机 | 1.542us | 1.634us | 1.449us | 1.536us | ||||
- TCP:64TCP 两者延迟完全一致;128TCP 虚拟机比物理机高 0.006μs。
- UDP:64UDP 两者完全一致;128UDP 虚拟机比物理机低 0.003μs。
HA 场景 | 故障类型 | 表现说明 | ||
|---|---|---|---|---|
场景 1 | 单宿主机整机断电宕机,运行的虚拟机挂载 SRIOV 网卡 。 | 虚拟机在剩余节点重起,SR-IOV 网卡重新挂载,重启后时延恢复基准水平。 | ||
场景 2 | 单块 Solarflare 网卡硬件故障 | 双网卡链路冗余,流量切换至备用网卡,虚拟机无重启、业务无中断。 | ||
验证结论
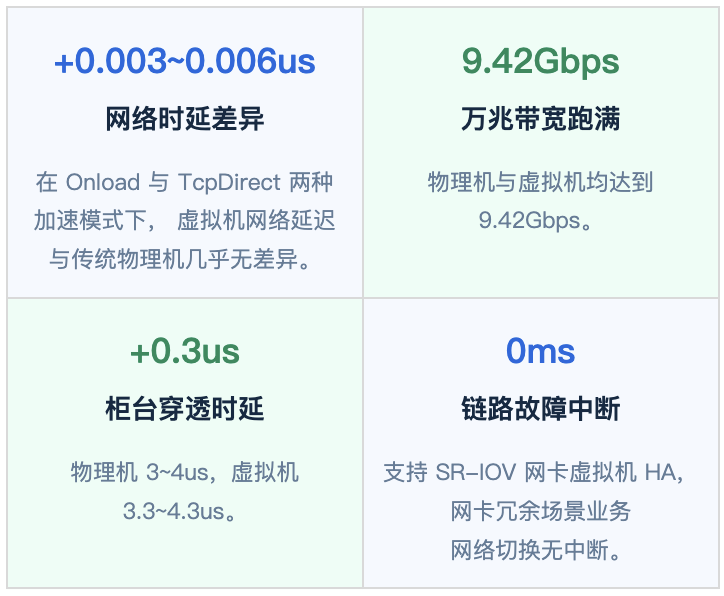
本次验证表明,在通用 Intel 商用服务器环境中,超融合架构结合 Solarflare 低延迟网卡、SR-IOV 和 Onload / TCPDirect 后,可以将虚拟化网络损耗控制在较低范围内,并保持万兆带宽吞吐能力。同时,高可用测试表明,使用 SR-IOV 网卡,三节点集群能够在主机或进程故障后完成虚拟机跨节点恢复;在双 SR-IOV 网卡冗余场景下,单块网卡故障可实现业务无中断切换。
对仍运行大量 Intel x86 存量业务的券商而言,这类验证提供了一条更稳妥的演进路径:在保护现有硬件和网络投资的前提下,逐步验证低延迟业务虚拟化承载能力,并通过集群 HA 提升关键业务连续性。
场景三:某证券机构行情交易低延迟场景实践
某证券机构 B 长期依赖物理策略机和低延迟专用网卡支持低延迟行情接收、策略计算与交易链路,随着客户数量增长,托管机房机柜空间、电力与硬件资源利用率逐渐成为扩容约束。为评估虚拟化架构在极速行情与交易场景中的可行性,该证券机构基于超融合开展了面向真实生产链路的长期验证。
本次测试覆盖 PCI 网卡直通、SR-IOV 虚拟网卡、OpenOnload 网络加速、NUMA 亲和调度与 CPU 独占等关键配置,并通过半年实盘运行和高倍速行情回放,验证虚拟化环境下的网络时延、吞吐、丢包与稳定性表现。
>>了解完整验证配置、测试过程与数据:虚拟化支持证券极速行情&交易系统:交易网卡延时达物理机水平!
验证结论
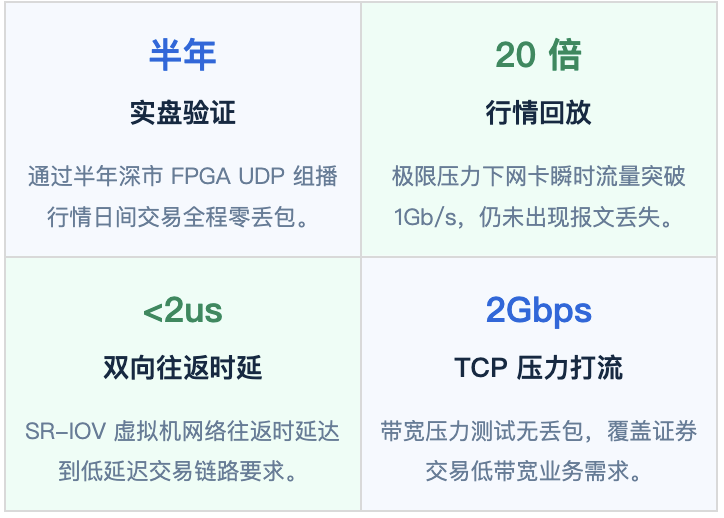
本次验证表明,在证券极速行情与极速交易场景中,虚拟化架构能否进入生产链路,关键不只在于虚拟化平台本身,也取决于低延迟网卡适配、OpenOnload 加速、NUMA 亲和、CPU 独占、链路隔离和压力验证等工程化设计。超融合通过完整生产链路、长期实盘运行和高倍速行情回放验证,展现出承载低延迟证券业务的可行性。
其中,PCI 直通更适合对时延极为敏感、需要独占硬件资源的行情链路;SR-IOV 则更适合交易链路及多虚拟机共享网卡的场景,有助于提升网卡和服务器资源利用率。
场景四:某证券机构基于 AMD 超融合与 Intel 超频物理机的极速交易性能对比
为了验证虚拟化环境能否支撑量化私募服务场景所需的纳秒/微秒级性能,某证券机构 C 重点验证基于 AMD 架构的榫卯超融合与 Intel 超频物理机在全链路低延迟交易场景下的性能差异。首轮仅部署 1 台业务虚拟机,若验证达标,后续可扩展为集群部署,让单台服务器承载多客户策略机,从而提升资源利用率并降低部署成本。
验证环境
对比项 | AMD 榫卯超融合策略机 | Intel 超频物理机 |
|---|---|---|
算力平台 | CPU:AMD 7985WX 64 核;全核固定 4.8GHz,单核最高 5.1GHz;内存:DDR5 512GB | CPU:Intel i9-14900KS 24 核;全核固定 5.8GHz,单核最高 6.2GHz;内存:DDR5 128GB |
网络配置 | Solarflare x2522 × 2;Mellanox MCX512A-ACAT × 2 | Solarflare x2522 |
资源规格 | 虚拟机配置:8vCPU | 96G | 网卡 SR-IOV | 网卡直通 | 同物理机配置 |
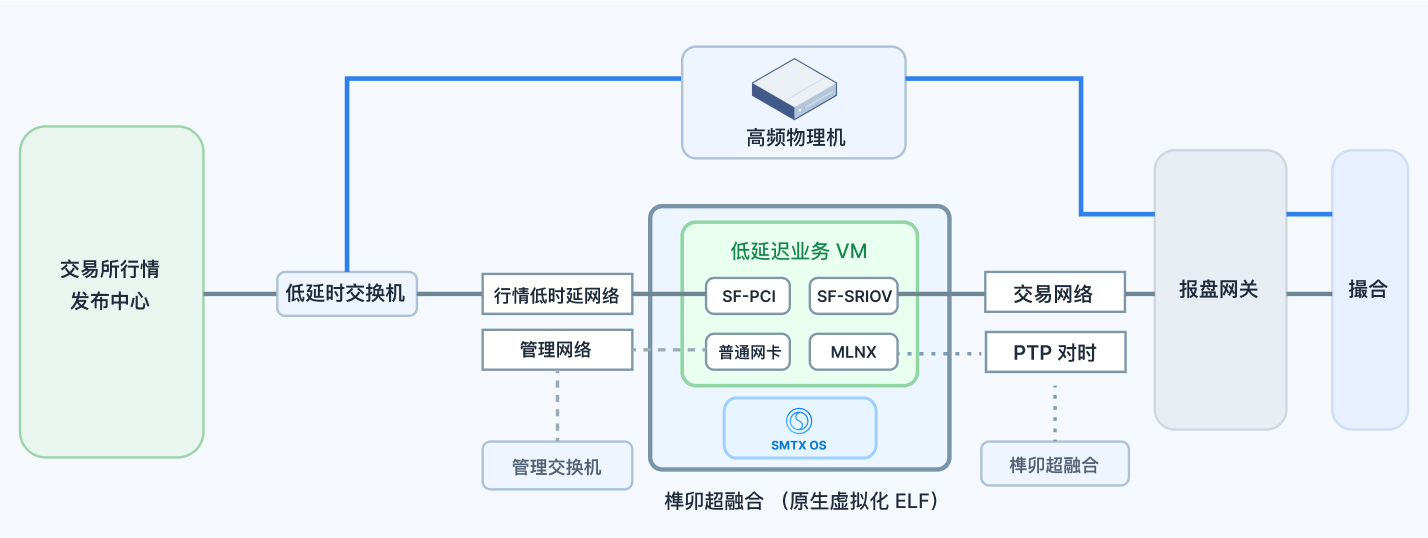
图:榫卯超融合环境下的低延迟交易测试架构
虚拟机配置 4 张功能隔离网卡:
- Solarflare PCI 直通网卡负责深交所 UDP 组播 L2 行情数据接收;
- Solarflare SR-IOV 虚拟网卡负责极速交易报盘;
- Mellanox SR-IOV 虚拟网卡负责高精度 PTP 时钟同步;
- Virtio 通用网卡用于服务器带内远程管理和运维操作。
测试指标分为四个:深交所 L2 行情接收时延、本地策略计算耗时、完整委托回报全链路时延,以及虚拟机 vCPU 相较物理 CPU 性能达成率;即行情接收、策略计算和报盘确认的整体链路时延以及虚拟化层 CPU/内存性能损耗。
测试数据
测试项 | Intel 超频物理机 | AMD 榫卯超融合 | 差异 |
|---|---|---|---|
行情接收中位数差值基准 | 基准 | +192ns | +192ns |
本地策略计算中位数 | 0.7~1.018us | 3~3.535us | +2~3us |
委托确认回报全链路中位数 | 3576us | 3927us | 达成91% |
测试项 | AMD 物理机 | AMD 榫卯超融合 | 差异 |
|---|---|---|---|
Sysbench 单线程 CPU 跑分 | 57897 | 57706 | -0.33% |
Sysbench 4 线程 CPU 跑分 | 14470 | 14426 | -0.3% |
内存随机读写带宽 | 3740MiB/s | 3685MiB/s | -1.47% |
验证结论:瓶颈主要来自 CPU 主频,而非虚拟化架构
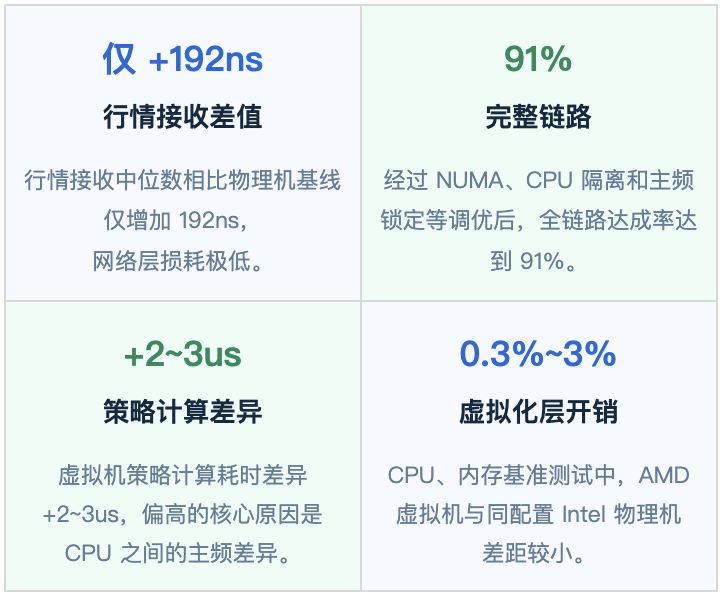
本次验证表明,在低延迟交易场景中,超融合架构通过 PCI 直通、SR-IOV、NUMA 绑定、CPU 隔离和关闭省电策略等配置,可以将网络层损耗控制在极低水平,并将完整业务链路时延差距收敛到可接受范围。
虚拟机策略计算耗时偏高的核心原因,主要来自 AMD 宿主机全核 4.8GHz 与 Intel 超频物理机 5.8GHz 之间的主频差异。测试中,同架构高主频 AMD 9950X 物理机的运算耗时接近 Intel 超频机,也进一步印证了主频是策略计算时延的关键变量,而不是虚拟化架构本身。
企业用户可以从整体业务流视角进行性能评估:各单元(网络 / 虚拟化 / 计算)分别较物理机有差距,但端到端全链路中位数已达到物理环境的 91%,整体达标;若 CPU 主频拉平,超融合虚拟机性能将进一步接近物理机方案。
超融合低延迟方案整体落地价值
结合全场景测试数据,从性能、资源、成本、运维、可用性、合规等维度, 超融合低延时交易方案相较于传统物理机架构的核心价值:
- 性能表现:网络额外时延仅增加 0.02~0.04us,全链路业务时延上浮控制在 1us 以内,满足证券、期货极速交易生产准入标准。
- 资源利用率:服务器、网卡硬件资源池化共享,单台物理机可承载多套交易策略虚拟机,解决物理机资源闲置痛点。
- 成本降低:硬件采购成本降低 50% 以上,托管机柜空间节省 50%,机房整机功耗降低 30%+,削减机房刚性支出。
- 运维敏捷性:虚拟机模板化一键部署,主机发布时长从小时级缩短至分钟级,快速应对客户新增、临时扩容、业务下线需求。
- 高可用容灾:原生虚拟机 HA、支持 SR-IOV 双网卡链路冗余,具备物理机不具备的自动故障转移能力,提升交易业务整体连续性。
- 国产化合规:全面适配 Intel、AMD、海光、鲲鹏等芯片,摆脱国外虚拟化厂商依赖,满足金融行业基础设施自主可控改造要求。
结语
极速交易场景下,超融合虚拟化并非性能瓶颈,CPU 主频、网卡组网模式、底层硬件配置才是决定时延的核心变量。
超融合平台依托计算、网络、存储全栈低延时支撑能力,打破金融行业多年来“核心交易必须跑物理机”的固有认知,让超融合虚拟机可以近乎无损承载纳秒/微秒级极速交易业务。相比传统物理机孤岛部署模式,超融合方案在保证裸机同级低时延性能的同时,兼具资源池化弹性、自动化容灾、极简运维、低成本、国产化合规等多重优势。
未来,超融合平台将持续深耕金融极速交易基础设施,助力证券、期货行业完成托管机房从物理机时代向超融合时代的平稳转型升级。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号