运维超自动化的根因分析超自动化
原创
凌晨排障的场面,做运维的都懂:告警刷屏、电话不停,一群人在几个系统之间来回翻——日志、监控指标、拓扑、配置、变更记录。忙了两三个小时,最费劲的往往不是"修",而是"找":到底哪个才是根因,哪个只是表象?
行业里有一句很扎心的现状描述:故障发生后靠人工或预设脚本排障,MTTR以分钟甚至小时计,高度依赖运维人员的个人经验,核心业务中断风险始终存在。换句话说,卡住MTTR的,不是手速,而是"定位"这一环。找到根因,等于解决了一半问题——但恰恰是这一半,最耗人。
根因分析能不能也超自动化?能,而且这才是超自动化的"深水区"。
它要解决的是三个层次的问题。
第一层:从"告警风暴"到"收敛降噪"。 传统排障的第一道坎是噪音——传统监控会产生海量告警,运维人员难以快速定位根源。超自动化平台的做法是:快速接入各类告警信息,基于人工智能算法结合内置检测规则、专家经验,对海量告警风暴自动去重降噪,减少冗余告警、聚焦核心事件。行业实践里,这种自动降噪甚至可以细到"从10万条日志中识别出'数据库锁等待'导致应用超时"的颗粒度。先把噪音关掉,根因才浮得出来。
第二层:从"单点指标"到"多维关联"。 单看某一台服务器的CPU曲线,永远看不出全局问题。借助智能算法对CPU、内存、磁盘、网络等性能数据与业务指标数据进行异常检测,快速识别系统异常,同时辅以关系链路和日志的分析,进行故障根因分析,帮助快速定位故障。再叠加关联分析引擎,实时关联多维度数据——多来源告警、情报数据、资产数据,结合系统规则与专家经验进行综合研判。指标、日志、链路、资产四路数据一对齐,很多"悬案"就变成了"答案"——单一指标是"症状",多维关联才能看见"病根"。
第三层:从"一次分析"到"人机协同的持续收敛"。 真正的超自动化,不是把人踢出排障流程,而是让算法的每次输出都能被人校准:算法支持与运维人员交互,根据运维人员的反馈调整根因,不断交互,直到找出正确的根因;同时,系统可以通过运维专家的反馈对模型进行自动调参。每一次排障,既解决一个故障,也"喂"了一次模型——定位会越来越准。这种"越用越聪明",才是超自动化区别于脚本自动化的本质。
根因找到之后,剩下的交给"联动":故障决策、根因定位、智能决策、下发决策、应急自愈、故障自愈,串成一条完整的业务联动链路;简单故障通过自动化实现自愈,复杂故障自动创建工单、由AI算法给出处置建议并进入跟踪处理。
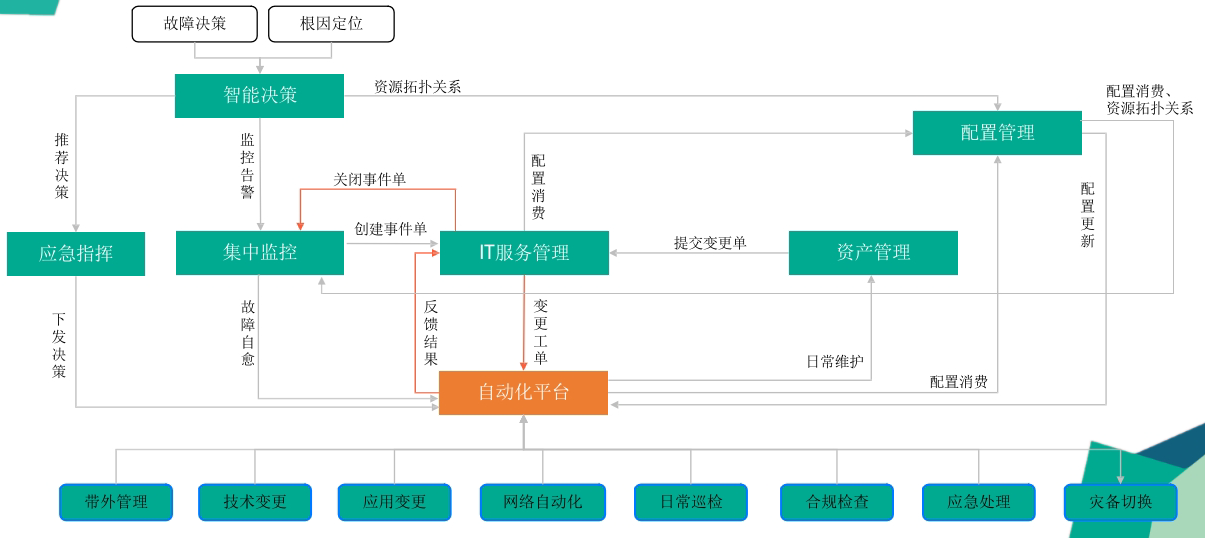
配合自愈机制,监控发现进程僵死可自动触发重启、资源超阈值可自动扩容,平均故障修复时间(MTTR)可缩短至30分钟以内。
效果也有数据佐证:借助AI异常检测与关联分析,变更或故障的排查时间可以从数小时缩短至几分钟;有城商行的统一运维管理平台上线后,通过智能聚合压缩告警事件抑制告警风暴、以健康度算法与根因分析快速定位故障,故障平均定位时间缩短60%、日常运维效率提升50%。
从"告警降噪"到"根因定位"再到"自动闭环",这套"看得快、找得准、动得了"的能力,正是SAB这类超自动化平台持续打磨的智能中枢。
所以,下次排障,别再让所有人凭经验"猜"根因。
行动建议:挑一个"每月都来、每次都靠人翻半天"的典型故障,把它的数据链路——指标、日志、拓扑、变更记录——对齐一次,让平台完整跑一遍"发现→定位→处置"的闭环。根因分析的超自动化,就从这一个场景开始。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号