我把 happy-dom 的 SSRF 拆到调用级,发现只修了一半
原创
我把 happy-dom 的 SSRF 拆到调用级,发现只修了一半
原创
Lethehong
发布于 2026-11-12 15:32:07
发布于 2026-11-12 15:32:07
8.6 分不是给解析器的
先说结论,这个漏洞不需要你写错任何业务代码。只要你的服务端用 happy-dom 解析过一段来自用户的 HTML,攻击者就能让服务器替他向内网发请求。
CVSS 向量里 AV 是 N,意思是攻击者从公网就能发起。AC 是 L,条件稳定,每次都能复现。PR 和 UI 都是 N,不需要账号,也不需要谁去点一下。
这四个分量叠在一起,说的是同一件事,攻击者把恶意 HTML 丢进任何一个会触发解析的入口就行。评论区、富文本编辑器回显、邮件模板预览,都算入口。
S 是 C,范围变更。这一项最容易被忽略,它意味着漏洞影响的不只是 happy-dom 这个组件,还包括运行它的宿主进程能碰到的网络位置。
C 是 H,机密性完全失守。I 和 A 都是 N,不改数据,不打服务。攻击者要的只是读,读内网接口的返回,读云元数据里的临时凭据。
所以 8.6 这个分数不是给「解析 HTML」这件事的,是给「解析的同时还替文档发请求」这件事的。
我自己第一次把向量逐项拆开的时候,最在意的是 S 等于 C 那一格。组件级的漏洞通常 S 是 U,影响范围锁在组件自己身上。这次不是,评分方认为它能捅穿组件边界,摸到宿主的网络空间。这一格决定了修复不能只靠升级一个包,还得看宿主怎么布网络。
默认值才是这次的主角
官方描述里点得很清楚,21.0.0 之前,happy-dom 在解析不可信 HTML 时,默认会去加载 iframe 的 src,也会去加载 link rel 等于 stylesheet 的 href。
控制这两个行为的开关叫 disableIframePageLoading 和 disableCSSFileLoading,两个的默认值都是 false。也就是说,什么都不配,加载就是开着的。
我第一次看到这两个参数名的时候愣了一下。名字里带 disable,默认却是 false,读起来像是「默认不禁用」,实际上就是「默认启用」。这种命名在配置项里很常见,但放在服务端解析不可信输入的组件上,代价很大。
为什么这两个默认值危险,得看 happy-dom 的定位。它把自己当成浏览器来用,浏览器加载 iframe 和样式表是天经地义的事。可浏览器跑在用户机器上,请求发出去暴露的是用户自己的网络位置。happy-dom 跑在服务器上,请求发出去暴露的是服务器的网络位置。
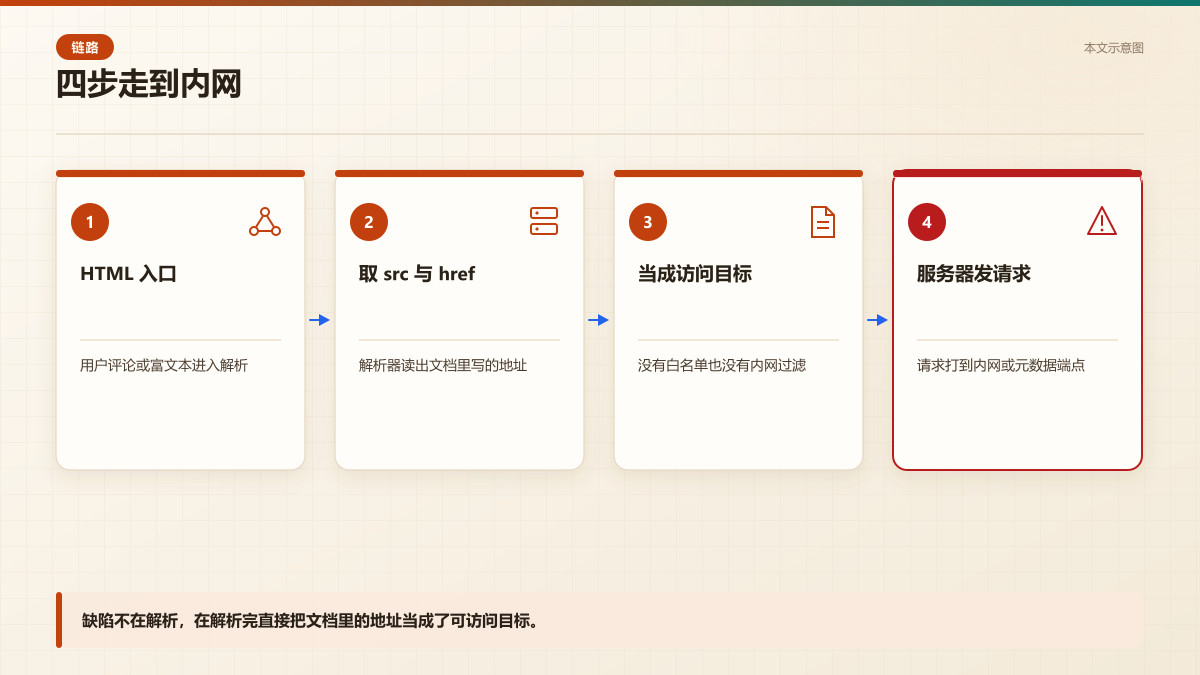
图 1 本文示意图:从不可信 HTML 进到服务器发出请求,中间没有任何一步拦一下目标地址。
同一个行为,换了个执行位置,风险等级就完全不一样。这是这次缺陷最根本的错位,不是代码写错了,是默认值按浏览器的直觉设的,却用在了服务端的场景里。
我后来想,这个错位在开源组件里其实很普遍。一个库从浏览器侧长出来,它的默认行为天然带着浏览器视角。等它被搬进服务端,搬的人只关心 API 像不像,很少有人去翻默认值背后的威胁模型是不是也跟着搬过来了。
错在解析器太听话
我把链路拆成四步来看,每一步都能对上官方描述里的一个词。
第一步,HTML 从业务入口进来。这一步 happy-dom 管不着,它拿到的是字符串。第二步,解析器遇到 iframe 标签或者 link 标签,把 src 和 href 的值取出来。
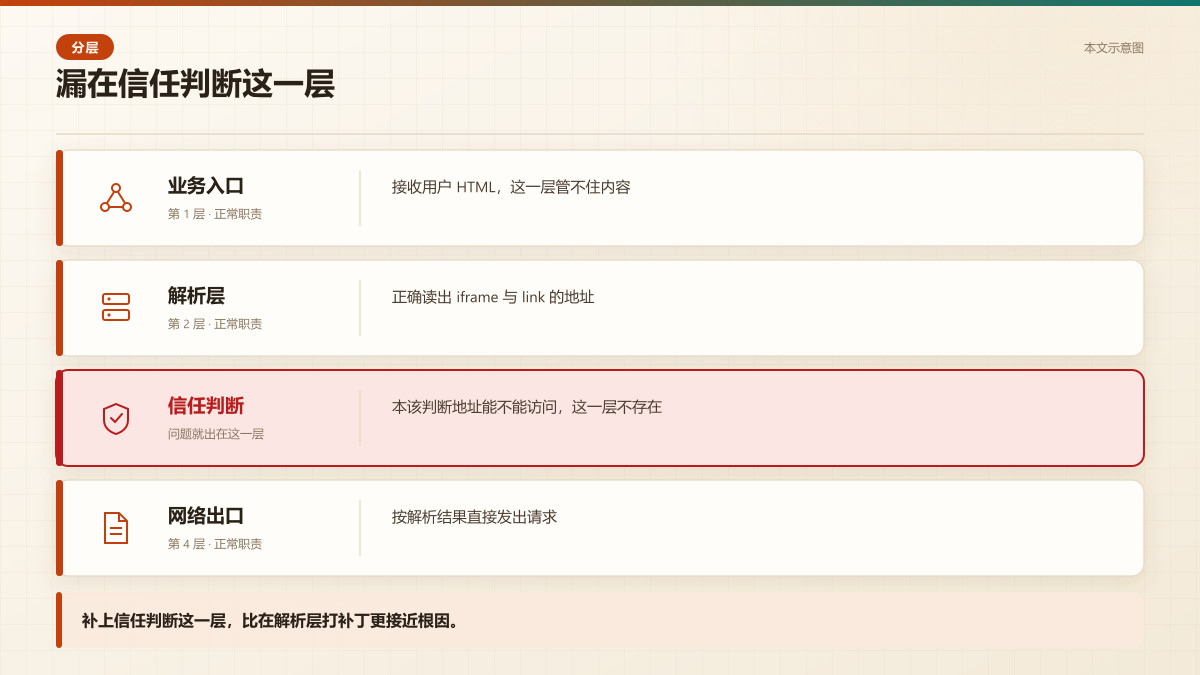
图 2 本文示意图:解析层做得没问题,问题出在它下面那层,没有对目标地址做任何判断。
第三步,也是最关键的一步,取出来的值没有被当成「文档里写的字」,而是被当成「要去访问的地址」。解析器在这里做了一个决定,它要替这段 HTML 把资源取回来。
第四步,请求从服务器发出。发往哪里,完全由第二步取出来的字符串决定。如果这个字符串是 169.254.169.254 这类云元数据地址,请求就会打到那里,返回的内容再被塞回 DOM。
整条链路上,没有任何一个环节问过一句「这个地址该不该访问」。没有协议白名单,没有内网地址段过滤,没有对解析来源的信任分级。
这就是 CWE-918 的典型形态,不是某个函数漏了校验,是整个设计里就没有「校验目标地址」这个环节。组件默认认为,文档里写的地址就是可以访问的地址。
同类实现里,有的会把资源加载做成显式开关,默认关闭,由调用方决定要不要开。有的会在发起请求前过一遍地址解析,把私有网段和链路本地地址拦掉。happy-dom 在 21.0.0 之前这两样都没有。
这里我得补一句推断,按 CWE-918 的通用规律,这类缺陷往往不是单点漏检,而是「谁来决定目标地址可不可信」这个职责在架构里没有归属。happy-dom 把这件事交给了文档,文档又来自攻击者,于是等于没交。这条判断是我按同类组件的共性推的,不是从 happy-dom 源码里读出来的。
哪些场景真的会被打到
不是所有用 happy-dom 的地方都危险。判断标准只有一条,被解析的 HTML 是不是来自不可信的一方。
第一种,测试环境。Vitest 和 Jest 里用 happy-dom 当 DOM 环境,跑的是自己写的测试用例,HTML 是自己造的,这种场景风险很低。除非你的测试会去拉取外部页面内容再解析。
第二种,SSR 预渲染。服务端拿到用户请求的页面片段或者模板,用 happy-dom 渲染一遍再返回。如果这个片段里带有用户可控的 iframe 或 link,请求就会从服务器发出。
第三种,HTML 转换和清洗。把用户提交的富文本转成别的格式,中间用 happy-dom 解析一遍。这是最容易被忽略的入口,因为做转换的人往往只关心输出格式对不对,不关心解析时发了什么请求。
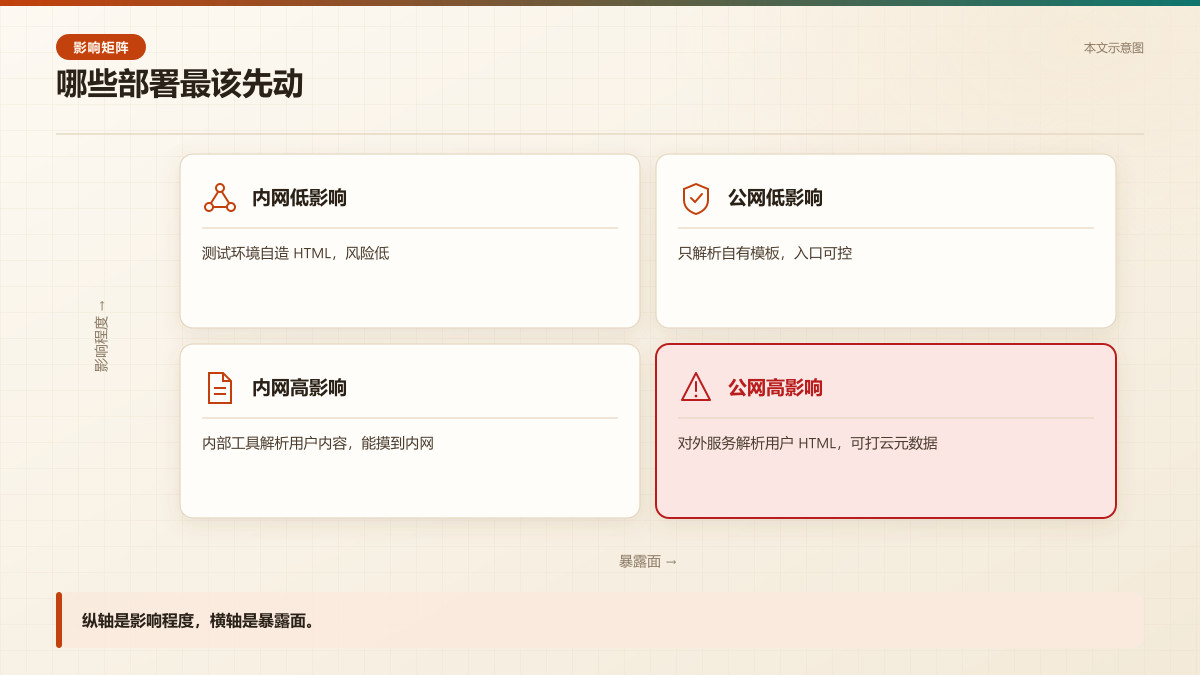
图 3 本文示意图:暴露在公网又解析用户 HTML 的服务,是这次最该今天就处理的那一格。
第四种,爬虫和内容抓取。抓回来的页面本身就可能带有指向内网的地址,解析的时候等于替目标页面发了一次请求。
这四种里,第二种和第三种最常见,也最容易被漏掉。因为在这两种场景里,happy-dom 只是工具链中间的一环,没人会把它当成一个网络组件来审。
我再补一个判断维度,别只按场景分,按「谁能控制这段 HTML」分更准。控制者是外部陌生人,风险高。控制者是同一团队的同事,风险中。控制者是你自己写的测试夹具,风险低。这个维度比场景分类更好落地,因为它直接对应攻击面。
我怎么验的,验到哪一步
我得说清楚,这次我没有搭完整的利用环境。公开信息里没有给 PoC,我也没有去构造能打到云元数据的完整链路。
我能确认的是调用顺序。解析器在遇到 iframe 标签时,会读取 src 属性,然后在页面加载阶段发起请求。这个顺序可以从官方描述和参数命名推出来,但我没有实际抓包验证请求的完整头部和超时行为。
推演触发顺序(示意代码,把从标签到请求的调用顺序写成可读的伪代码)
下面这段伪代码是我按调用顺序推演的,不是从源码里抄的。它想说明的是触发条件有多简单,不代表真实实现的函数名。
我还做了一件小事,把两个开关的默认值在本地 20.x 版本上打印出来看了一遍。结果和官方描述一致,两个都是 false。这一步只能证明默认值没被改过,证明不了请求真的发出去。
所以我的验证停在这一层,默认值确认了,调用顺序推出来了,真实请求没打。要说这是完整复现,我不敢认。
今天就能做的三件事
第一优先级,查版本。所有依赖树里出现 happy-dom 且版本低于 21.0.0 的项目,今天就要列出来。命令在后面代码段里。
第二优先级,如果暂时升不上去,把两个开关显式关掉。disableIframePageLoading 和 disableCSSFileLoading 都设成 true。这一步不依赖版本,20.x 也能配。
查依赖树里的版本(示意代码,筛出所有低于 21.0.0 的 happy-dom 实例)
第三优先级,在解析入口外面加一层网络出口控制。服务端进程的出站请求,至少要把链路本地地址段 169.254.0.0/16 和常见私有网段拦掉。这一层是兜底,不能替代升级。
过渡办法还有一个,把解析不可信 HTML 的环节挪到独立的、没有内网访问权限的进程或者容器里跑。这样即使请求发出去了,也打不到有价值的目标。
这三件事里,升级最彻底,关开关最快,网络出口控制最稳。三个一起做,才算把这条链路堵上。
我把动作再拆细一点,免得看完还是不知道手往哪放。今天上午先跑一遍依赖扫描,把命中低于 21.0.0 的项目列成一张表,按「是否对外解析用户 HTML」排个序。排在前面那两个项目,下午就把两个开关显式设成 true 并重新跑一次回归,确认没有样式或 iframe 相关的用例挂掉。
明天再做出口控制。在容器或者进程的网络策略里,把 169.254.0.0/16、10.0.0.0/8、172.16.0.0/12、192.168.0.0/16 这四段出站请求拒掉,只放行白名单域名。这一步做完,即使某个依赖又冒出一个默认发请求的开关,也打不穿内网。
关掉两个默认加载(示意代码,不升级也能先堵住 iframe 与样式表请求)
升级排在本周内。21.0.0 改的是默认值,升级本身风险不大,但要盯住那些显式依赖「默认会加载资源」行为的用例,升级后它们会静默失效,不会报错,只会结果不对。这一点我在自己的项目里踩过一次,回归跑绿了,功能其实是空的。
这次没查到什么
这次没查到什么,我列清楚。NVD 的状态是 Awaiting Analysis,收录时间是 10 月 28 日,29 日更新过一次细节。到 11 月 12 日为止,公开信息里没有厂商的补充公告,也没有第三方复现报告。
这意味着有几件事我判断不了。第一,除了 iframe 和 link,还有没有别的标签会触发资源加载,公开描述只点了这两个。第二,请求发出后返回的内容,在什么条件下能被攻击者读到,描述里说的是 may expose,用的是可能。
第三,21.0.0 的修复方式是只改了默认值,还是同时加了地址过滤,公开信息没说。如果是前者,显式把开关打开仍然有风险。
第四,云元数据端点的实际可达性取决于部署环境,我没有在真实云主机上验证过 happy-dom 发出的请求会不会带上必要的头部。这部分我是按 SSRF 的通用规律推断的,不是实测结论。
这几条都得等后续修订或者源码对比才能确认。我现在的判断建立在官方描述的字面意思上,推断的部分我在文中都标了。
还有一条我够不到的地方,得单独说。happy-dom 在解析阶段之外,比如序列化、事件派发这些路径上会不会也碰网络,我没有能力在没读源码的情况下下结论。公开描述只覆盖了解析这一段,我的分析也就停在这里。
另外,CWE-918 这个分类本身也有边界。它描述的是「服务端替攻击者访问了不该访问的地址」,但具体到 happy-dom,返回内容怎么回到攻击者手里,中间有没有编码转换、有没有大小限制,公开信息一个字都没提。这一段我只能空着,不敢补。
默认信任文档里的地址,这事不止一个组件
把这件事放大一点看,它不是一个库的疏忽。服务端解析 HTML 的组件,大多是从浏览器实现里长出来的,而浏览器的默认假设是「文档是半可信的,用户自己承担后果」。
搬到服务端之后,这个假设就不成立了。服务端解析的文档来自陌生人,后果却由服务提供方承担。默认值没跟着场景变,漏洞就长出来了。
所以我看这类组件的时候,现在会先问一句,它默认会替文档做什么动作。发请求、读文件、执行脚本,这三样里只要有一样默认开着,就得当成网络组件来审,不能当成纯解析库。
happy-dom 这次修的是默认值。但同类组件里,默认替文档发请求的还有多少,值得挨个翻一遍配置项。这件事没法一次做完,但每翻一个,就少一个默认敞着的口子。
说到底,这次 8.6 分不是 happy-dom 一个库的问题,是所有「从浏览器侧长出来、又被搬进服务端」的组件的共同问题。你今天修完 happy-dom,明天可能又冒出一个默认加载资源的库。真正该改的是审依赖时的那个习惯,拿到一个解析类库,先翻它的默认值,别等评分出来才去看。
写在最后
一个跑在测试环境里的 DOM 实现,评分能到 8.6,说明服务端组件的默认值该按服务端的威胁模型重设一遍。浏览器默认替文档发请求,是因为后果由用户自己承担。服务端替文档发请求,后果由服务提供方承担。这两件事看起来一样,其实差了一整个信任模型。你要真想把这件事坐实,别只看版本号,去翻一遍你项目里所有默认会替文档发请求的开关,看看有几个是开着的。
以上,既然看到这里了,如果觉得不错,随手点个赞、在看、转发三连吧,如果想第一时间收到推送,也可以给我个星标⭐~ 谢谢你看我的文章,我们,下次再见。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号