我把百度词元所这门生意拆开看,发现它卖的不是模型
原创
三年烧钱之后,行业开始算账了。这篇我不聊参数和榜单,只拆一件事,把AI能力按词元卖出去,这套账到底怎么记,记在哪一层,谁在为哪一段付费。
这笔账以前没人算清楚
先说我看到的事实。2026年11月13日,安全客公开报道了百度词元所这件事,标题里那句「重新定义AI生意」,把话说得很满。
我第一反应不是兴奋,是怀疑。大模型跑了三年,按调用次数收费、按包月收费、按Token收费,这些玩法早就有了。所谓重新定义,到底是换了个计价单位,还是把整条成本链路重新切了一遍。
这两件事差得很远。前者是计费口径的调整,后者是商业结构的变化。公开信息目前只给到「词元所」这个概念和一句定位,具体怎么结算、覆盖哪些能力、对开发者怎么计费,没有披露。
所以这篇我只能拆到能拆的那一层。拆不了的,我会明确写没查到。
词元不是新词,新的是它成了计价锚点
大模型的输入输出,本来就以词元为单位切分。分词器把一句话拆成若干词元,模型按词元数量吃算力,按词元数量吐结果。这是技术侧早就存在的事实。
问题在于,技术侧的计量单位和商业侧的计价单位,过去并不重合。你按次买接口,一次请求里塞多少词元,价格是一样的。
这就埋了一个结构性错配。同样的价格,有人一次请求塞进去几千词元,有人只塞几十个。成本全压在后端,前端感知不到。
词元所如果做的是把计价单位对齐到计量单位,那它解决的正是这个错配。按词元算,用多少付多少,成本从「按次摊平」变成「按量结算」。
这个逻辑我认。但这里有个前提,计量必须准,且必须可核验。计多了算谁的,计少了谁来补,这套账本的对账机制才是这门生意的命门。公开信息没披露这一层。
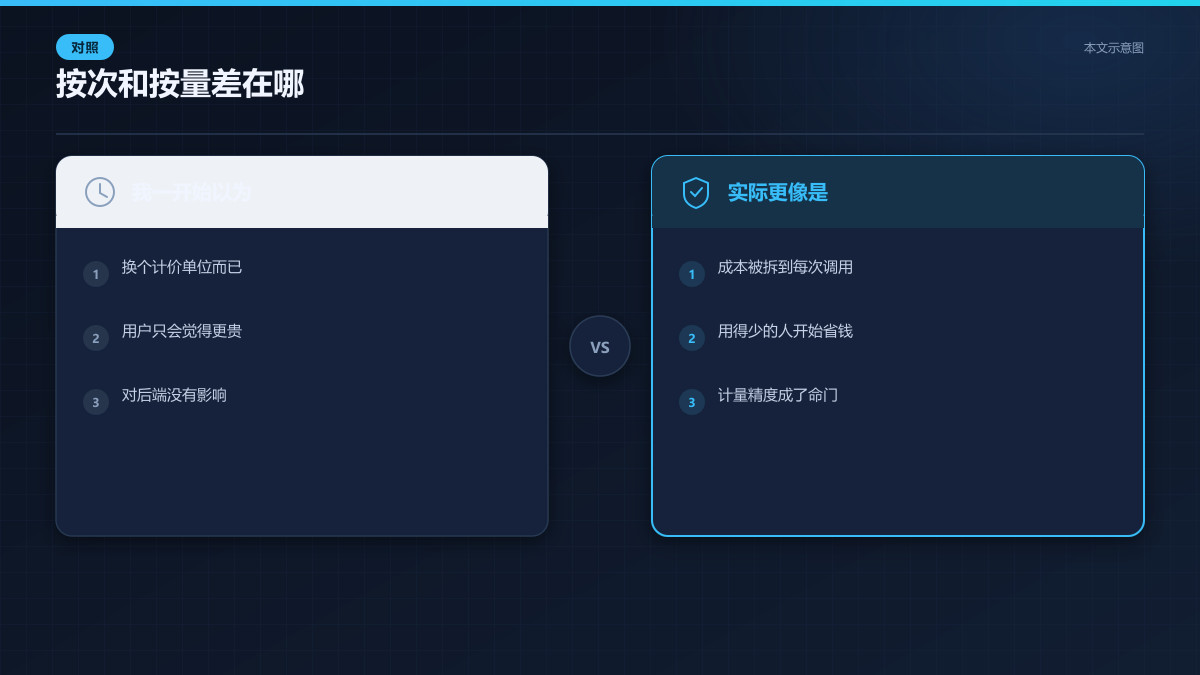
图 1 本文示意图:计价单位从次数换成词元,成本从摊平变成可见,风险也随之转移。
缺陷不在模型层,在计量与结算的接缝
我把这套东西拆成四层来看。模型推理层、词元计量层、计费结算层、对账与审计层。
真正容易出问题的地方,不是模型跑得好不好,是计量层和结算层之间那道缝。
为什么这么说。推理层输出的是原始的词元流,计量层把它数出来,结算层拿这个数字去乘单价。中间任何一环口径不一致,账就是错的。
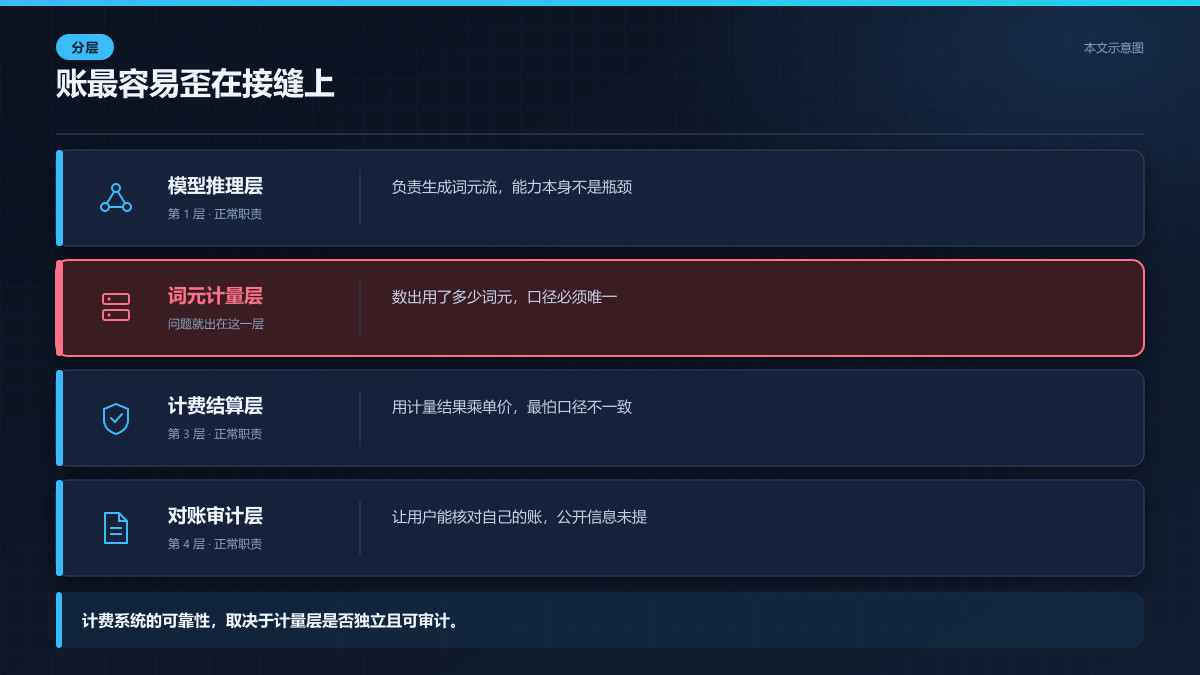
图 2 本文示意图:把按词元计费拆成四层,真正脆弱的是计量与结算之间那道缝。
举个具体的。分词器版本升级,同一句话切出来的词元数变了。计量层用的是旧分词器,结算层按新单价算,两边对不上。这种问题不会报错,只会让账单慢慢偏离。
再比如流式输出。模型一段一段吐,计量层如果按请求结束才统计,中途断开的那部分算不算,边界在哪,谁来定。
这些都不是模型能力问题,是工程接缝问题。同类按量计费的系统,通用规律是把计量做成独立可审计的服务,而不是嵌在业务代码里顺手加一。这是我从其他计量系统迁移过来的推断,不是这次披露的事实。
所以我说,这门生意的技术难点,八成不在模型,在那本账。」
什么样的调用顺序才会把账算歪
我想推一下,什么情况下这套计量会失准。
第一种,重试。请求发出去,超时了,客户端重试。后端如果两次都记了词元,用户为一次失败付了两次钱。
第二种,缓存命中。相同前缀命中缓存,实际没跑完整推理,计量层如果按请求体大小算,就多收了。
第三种,多轮会话。上下文不断累加,每一轮都把历史带上,词元数滚雪球。按词元计费时,这个滚雪球的成本必须让用户看得见。
这三种都不是恶意攻击,是正常使用下的边界情况。计量系统要经得住这些,才算能用。
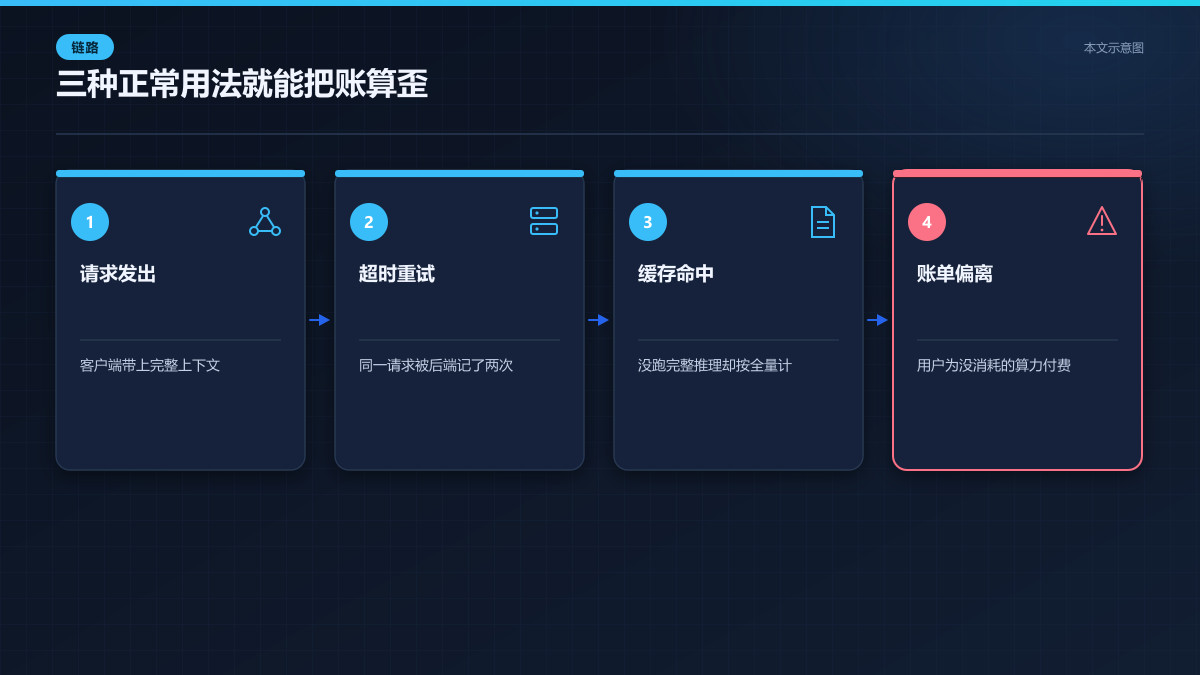
图 3 本文示意图:重试、缓存命中、多轮上下文,都会让词元统计偏离真实消耗。
我在这里只能推到调用顺序这一层。具体的计费实现、是否有去重、重试是否幂等,公开信息没有,我也没环境去验。这条我不敢下结论。
我拿一个自检脚本把能查的先查了
我没有百度词元所的内部环境,能做的只有外围核对。
如果你手上接了按词元计费的能力,第一件事是把分词口径和计费口径对齐。我写了一段脚本,用来核对本地分词结果和账单词元数是否一致。
核对词元口径(示意代码,对比本地分词结果与账单词元数,定位差额来源)
import tiktoken

def count_tokens(text, model="cl100k_base"):
    enc = tiktoken.get_encoding(model)
    return len(enc.encode(text))

def check(prompt, completion, billed_tokens):
    local = count_tokens(prompt) + count_tokens(completion)
    diff = billed_tokens - local
    if diff == 0:
        print("口径一致")
    else:
        print(f"差额 {diff},本地 {local},账单 {billed_tokens}")
        print("先核对分词器版本,再怀疑重试与缓存")

if __name__ == "__main__":
    check("你好,帮我总结这段话", "好的,这段话主要讲了", 42)
这段脚本不能证明对方计费有错,只能帮你发现自己的账和对方的账差在哪。差额一旦稳定出现,就是要去问的地方。
跑之前先确认一件事,你用的分词器版本和对方声明的一致。版本不一致,这个对比没有意义。
今天该动的那一步
立刻做的,是把现有按次调用的接口,统计一遍每次请求的实际词元分布。你会看到长尾有多长。这一步不用改代码,加日志就行。
这周做的,是给每次调用打上三个字段,请求词元数、响应词元数、重试次数。有这三个数,账单来了你能对上。
做不到改造的过渡办法,是设一个词元上限的硬闸。单次请求超过阈值直接拒绝,宁可失败也不要让成本失控。
给调用加词元闸(示意代码,单次请求词元超阈值直接拒绝,防止成本失控)
#!/usr/bin/env bash
set -euo pipefail

MAX_TOKENS=${MAX_TOKENS:-4000}
PROMPT_FILE=$1

CHARS=$(wc -m < "$PROMPT_FILE")
# 中文粗估,1 个汉字约 1.5 词元,英文约 0.25
EST=$(( CHARS * 3 / 2 ))

if [ "$EST" -gt "$MAX_TOKENS" ]; then
  echo "预估 $EST 词元,超过阈值 $MAX_TOKENS,拒绝发送"
  exit 1
fi

echo "预估 $EST 词元,放行"
exit 0
我不建议现在就去切换计费模式。概念刚披露,条款没出,这时候切过去是拿自己的账做实验。
先把自己的计量做扎实,等对方的规则清晰了再谈迁移。这个顺序不能反。
我没查到的那些
说清楚这次够不到哪里。
词元所的具体计费粒度、单价、是否区分输入输出、是否对缓存命中打折,公开信息一条都没有。
它覆盖哪些产品线,是只覆盖API调用,还是也包括训练、微调、推理部署,报道里没展开。
「重新定义AI生意」这个判断,我目前只能确认它是一个定位表述,不能确认它已经在商业上跑通。
上面关于计量接缝的分析,是我从同类按量计费系统的通用规律推出来的,属于推断,不是这次披露的事实。
等条款和文档出来,这篇里的部分判断可能要修。我会盯着。
真正被重估的不是价格,是成本可见性
三年狂奔,大家比的是模型多强、榜单多高。到了算账的时候,比的会变成另一件事,谁能把成本拆到用户看得懂的粒度。
按词元卖,表面是换了计价单位。往深一层看,它把过去藏在黑箱里的算力消耗,摊到了每一次调用上。
这对开发者未必是坏事。你看得见花在哪,才谈得上优化。看不见的成本,永远只能靠猜。
但前提是那本账得是真的。计量不准的按量计费,比按次计费更糟,因为它给了你一个精确的错觉。
词元所能不能立住,不看概念讲得多漂亮,看那本账经不经得起对。
以上,既然看到这里了,如果觉得不错,随手点个赞、在看、转发三连吧,如果想第一时间收到推送,也可以给我个星标⭐~
谢谢你看我的文章,我们,下次再见。
写在最后
AI生意换计量单位这件事,最后拼的不是谁的模型更聪明,是谁能把成本算得让用户信。一本算不准的账,比没有账更危险。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号