Agent 干到一半崩了:长任务续跑的工程学
原创
Agent 干到一半崩了:长任务续跑的工程学
原创
顺势而为
发布于 2026-11-15 21:56:08
发布于 2026-11-15 21:56:08
摘要:Agent 能干活了,真正的考验才开始:跑到一半崩了怎么办?从一次重复退款的失败现场出发,拆解检查点、确定性重放与幂等三件套,并借 2026 年一项安全研究说明,为什么「回滚正确」不等于「恢复安全」,给出恢复决策与八项工程清单。
下面是一个示意场景,但每个把 Agent 接进生产链路的人,大概都能对上号。
一家做庭院门自动开门机的出口企业,售后团队上了一套智能体:读客户英文邮件、查订单与库存、起草回复、人工确认后发出。某天一单退款流程走到第四步——调用退款接口成功,还没来得及把状态写回工单,容器被调度重启了。
新进程起来,读到的是「任务未完成」。于是它从第一步重跑:查订单、判断条件、再调一次退款接口。请求号是重新生成的,下游系统认不出这是同一笔。当天财务发现,同一位客户被退了两次。
复盘会上,没有人写错代码。问题出在更底层的地方:这套系统把一次跨越数分钟、带着外部副作用的业务过程,当成了一次可以随时重来的函数调用。
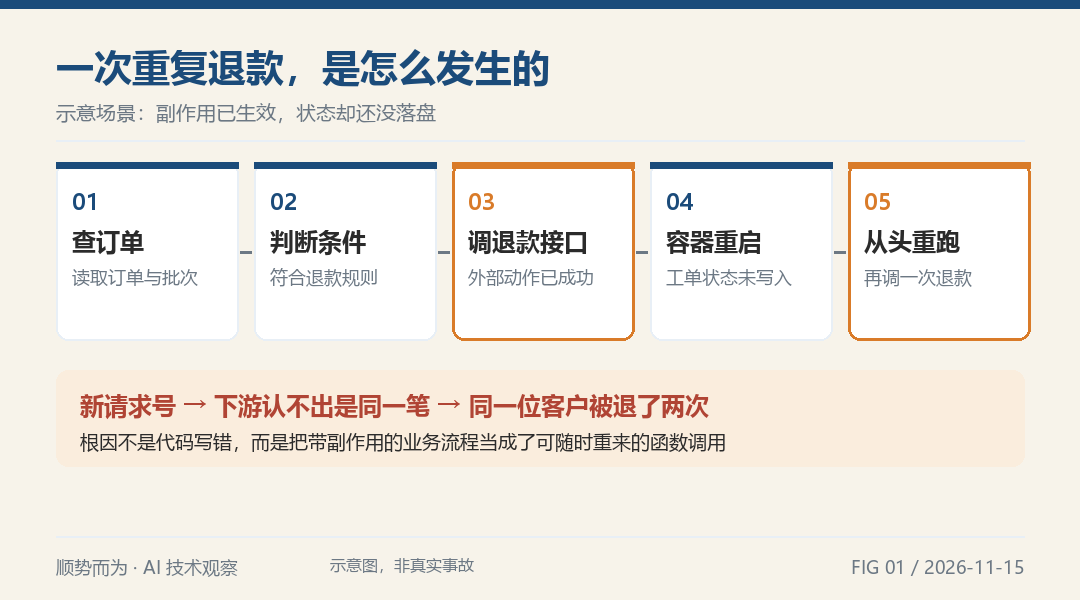
示意:退款请求发出后进程重启,重跑导致重复退款
过去两年,行业的注意力几乎都放在「让它更能干」上:更好的模型、更长的上下文、更多的工具、更复杂的编排。近一个月,话题开始转向「该给它多大权限」「落地还有几道闸门」。但还有一条轴很少被单独拎出来讲——它干到一半,断了呢?
这篇文章想说清楚一件事:Agent 从演示走向生产,缺的不是更强的推理,而是一整套关于「执行连续性」的工程纪律。
01 失败模型变了:从十秒请求到跑几天的业务流程
一个聊天助手回答一次问题大约十秒。请求失败,用户再问一遍,损失可以忽略。这是典型的无状态请求—响应:进程随时可弃,重试几乎零成本。
企业 Agent 是另一种东西。它读文档、调模型、查系统、写工单、等人审批,一个任务可能包含几十到几百次模型与工具调用,中间还要跨天等待客户回复、等配件到货、等主管签字。它更像一条长跑的业务流程,只是流程里嵌了一个大模型。
时间一拉长,中断就从「小概率意外」变成「常态」:容器被回收、节点被驱逐、发版撞上跑了一半的任务、模型限流、外部接口超时却不告诉你是成功还是失败。
此时「从头再跑」不再无害。已经付过的 Token 要再付一遍,已经发出去的邮件可能再发一遍,已经提交的退款可能再退一遍。在无副作用的世界里,重跑等于恢复;在有副作用的世界里,重跑可能是一次新的事故。
这个变化已经被云厂商写进产品规格里。
数据卡片|长任务运行时(AWS 官方产品口径,非第三方实测)Amazon Bedrock AgentCore Runtime:microVM 会话最长连续运行 8 小时;实例(EC2)类型会话最长连续 14 天 官方说明:智能体工作负载通常有 30%–70% 的时间处于 I/O 等待(等模型、等工具、等数据库),等待与空闲时间不计费,按实际 CPU/内存用量秒级计费 出处:AWS《Amazon Bedrock AgentCore 常见问题》官方页面
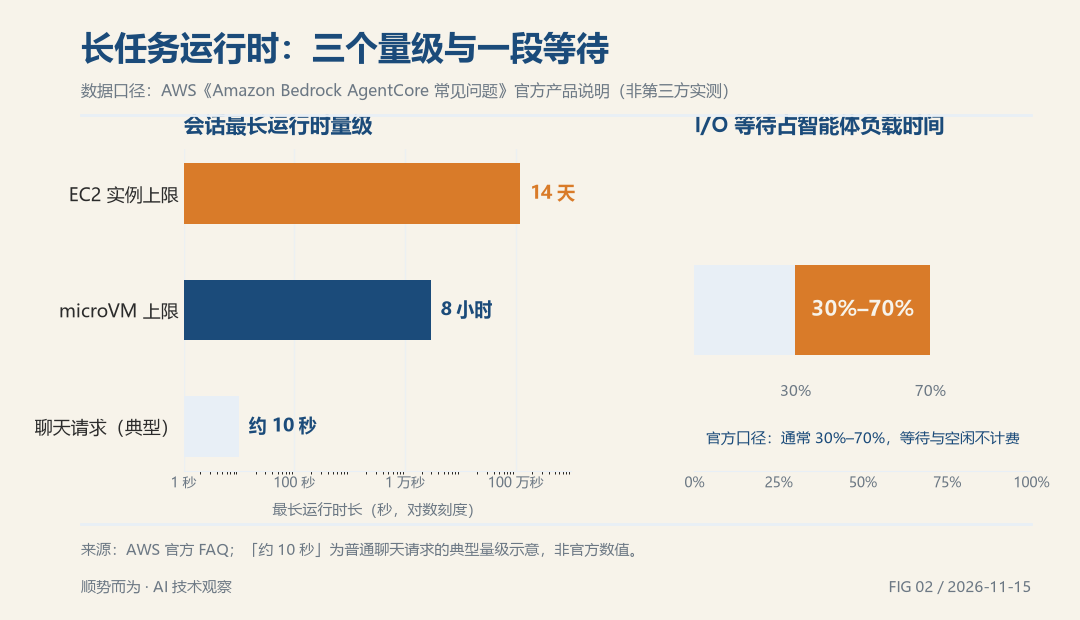
数据图:十秒请求、8 小时、14 天三个运行时量级,以及 I/O 等待占比区间
上海证券报 2026 年 11 月 3 日报道腾讯全球数字生态大会时也记录了同一方向:腾讯云 CTO 王慧星把落地堵点概括为「跑得通、可托付、可衡量、好落地」四道关,并提到 Agent 执行任务可能持续数小时甚至数天,弹性调度、沙箱启动、存储快照恢复和安全隔离都会面临更高要求。
换句话说,长任务已经不是「把超时时间调大一点」能解决的问题了。它需要一个专门的执行层。
02 记忆不等于耐久:对话历史存下来,活儿还是会丢
第一个坑,是把「存了聊天记录」当成「做了持久化」。
对话历史记录「说过什么」,持久化状态要回答「活儿干到哪了」。两者在短对话里看起来一样,一遇重启就分道扬镳:模型读了三十轮历史,仍可能判断不出「退款接口到底调没调过」,于是把已完成的外部动作判成未完成,再执行一次。
一个可用的检查点,最少要能回答四个问题:
- 现在执行的是哪一版目标? 用户中途改过需求吗,计划是基于哪版目标生成的;
- 已经确定完成了什么? 哪些步骤有可验证的结果,可以直接跳过;
- 下一步准备做什么? 恢复后由运行时从明确的状态转换继续,而不是让模型重新猜;
- 有没有结果未知的副作用? 哪个请求可能已经发出、但没收到回执。
公开工程实践中常见的最小快照,大致长这样(示意结构,字段参考社区实践):
run\_id: r-42
goal\_rev: 3
checkpoint\_rev: 18
status: RUNNING
next\_step: create\_review\_task
evidence\_refs: [ev\_12, ev\_13]
pending\_action:
  action\_id: review-r42-g3-s7
  idempotency\_key: review-r42-g3-s7
  request\_fingerprint: sha256:...
  status: PREPARED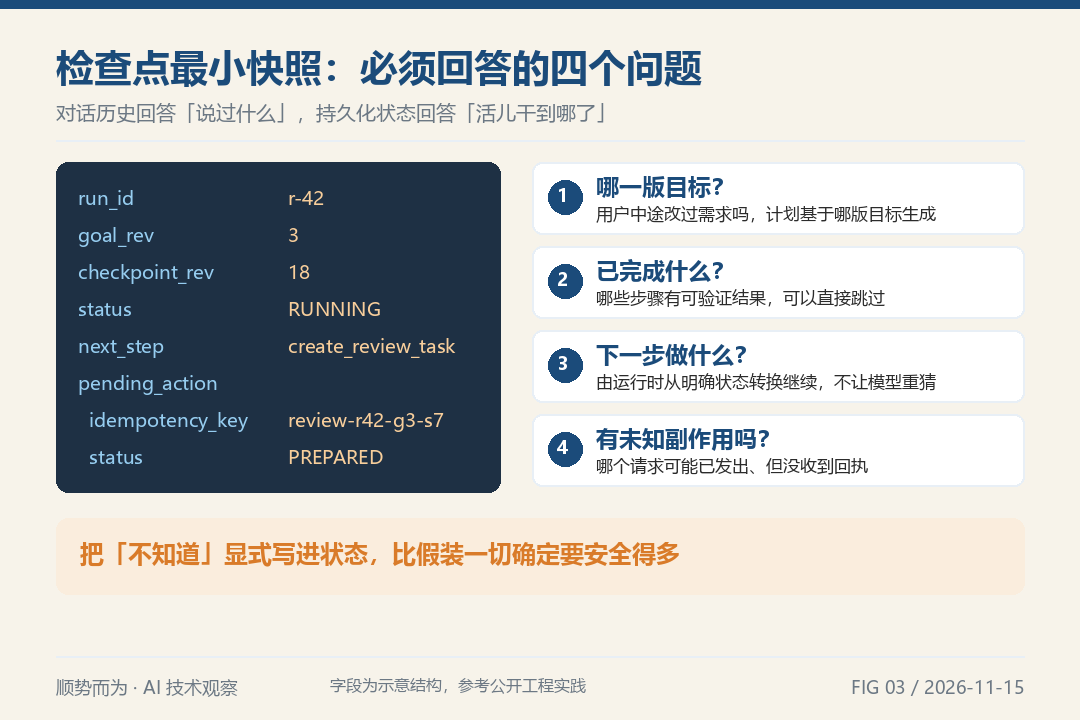
检查点最小快照要回答的四个问题
注意 pending_action 这一块。它存在的意义不是记录细节,而是承认一件事:系统有可能真的不知道外部世界发生了什么。 把这个「不知道」显式写进状态,比假装一切确定要安全得多。
一条硬约束:任何产生外部副作用的步骤,必须在执行之前落盘。副作用发生了却没有记录,系统就进入既不能安全重做、也不能安全跳过的死角。
03 三件套:检查点、确定性重放、幂等
把「边想边做」的控制流,改造成一条可被观察、可被中断、可被续接的数据流,需要三件东西同时到位。少任何一件,恢复出来的都不是「续跑」,而是一次全新的执行。
检查点回答「进度在哪」。 落盘粒度是工程取舍:每步之后存,最多丢一步但序列化开销高;只在首尾存,等于没做。多数生产场景的默认值是「在产生外部写操作之前存一次」,并以「一次模型调用加一组工具执行」为一个检查点单元。
确定性重放回答「怎么还原已经确定的决策」。 引擎记录一条只追加的事件历史,崩溃后由新进程重放编排代码;遇到历史里已有结果的步骤,直接取回记录值而不再执行。这带来一条容易踩的纪律:编排代码必须是确定性的,Date.now()、随机数、直接网络请求都不能出现在里面;模型调用与工具调用必须包进被记录的 step/activity,否则每次重放都会重新问模型,还会得到一个不同答案。更稳的做法是把模型当次的完整输出一并落盘,恢复时复用产物而非重新生成。
幂等回答「同一个副作用算几次」。 这是最容易被低估的一件。持久化执行普遍只能保证「至少一次」,不是「恰好一次」:一个步骤可能在副作用已经生效、结果还没记录的窗口里崩溃。所以每个外部写操作都要带稳定的幂等键(由 run id 与步骤名派生),并配合事务 outbox 与三阶段状态:
PREPARED  →  EXECUTED  →  CONFIRMED
 落盘        调用外部      收到可验证回执
(含幂等键)  (同一把键)   推进到下一步
若请求可能已发出但没收到响应,就停在「结果未知」,进入对账,而不是盲目重试。文件读两次无害,发票开两次不是。
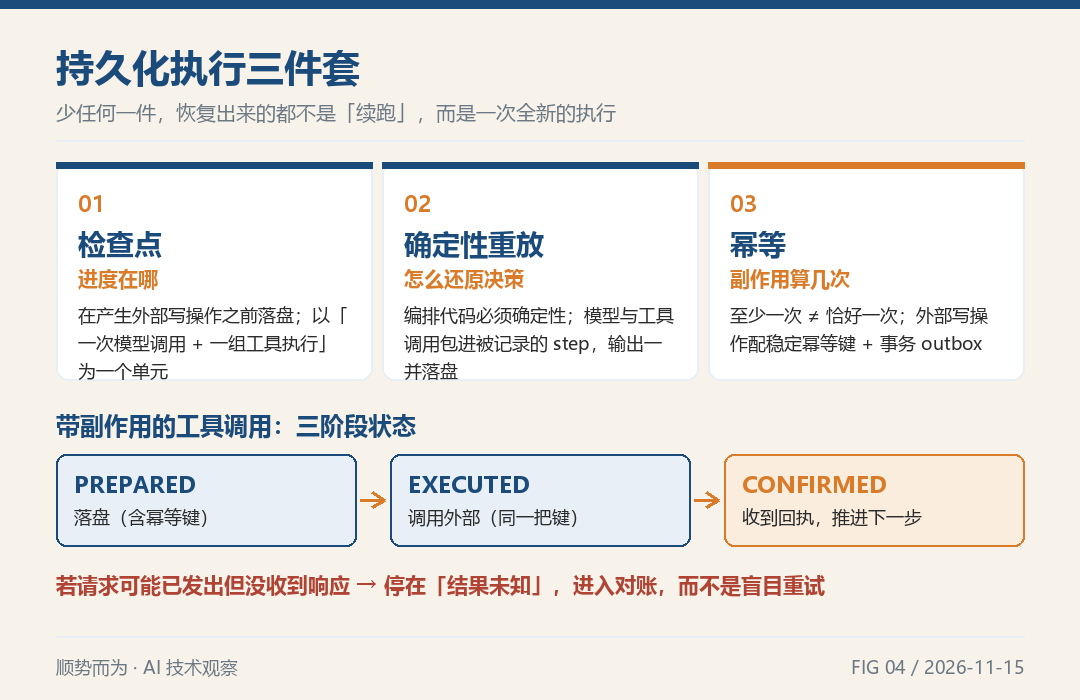
三件套:检查点、确定性重放、幂等,以及 PREPARED→CONFIRMED 三阶段
Temporal、Inngest、Restate、AWS Lambda durable functions、LangGraph checkpointer(生产用 Postgres/Redis saver)形态不同,骨架都是这一套。据 2026 年 10 月技术综述,Temporal 已把 OpenAI Agents SDK、Google ADK 等集成推进到正式可用——但框架能力不等于业务自动事务安全。
04 反常识:回滚正确,不等于恢复安全
方案到这里看似完整:检查点、确定性重放、幂等键,崩了从最近检查点继续。但 2026 年一篇安全研究掀开了一道缝。
arXiv:2608.29381《Safe to Resume? Breaking Execution Continuity of Agent Execution via Rollback》(2026 年 8 月 29 日提交,9 月 1 日发布;预印本,以下为研究者实证结论)是首个系统性研究 Agent 检查点与回滚安全性的工作。它的核心命题一句话就能说完,却足够颠覆:
正确回滚,不蕴含安全恢复。
一个被忠实还原的检查点,完全可能拼接出一次「状态、假设与外部影响从未在任何有效历史中共存」的执行。论文归纳了五类失效模式,覆盖内部状态不完整或不一致、外部依赖已经变旧、非确定性重放、未被记录的外部影响等;并在 Hermes、Cline、LangGraph 上做了三类端到端攻击演示:绕过恶意软件校验、未授权邮件转发、重复支付。研究还把利用这种错位的攻击称为「语义回滚攻击」。
用大白话讲:检查点恢复的是内部状态,它恢复不了外部世界。
- 如果一笔扣款发生在检查点之后,回到检查点并不会把钱退回去,而重新生成请求可能又付一次;
- 一封已经发出的邮件撤不回来,一个已经送达的 webhook 可能已经让对方系统做了动作;
- 等待审批的三天里,订单状态、库存、上游接口字段都可能变了,而检查点里记的还是三天前那个版本。
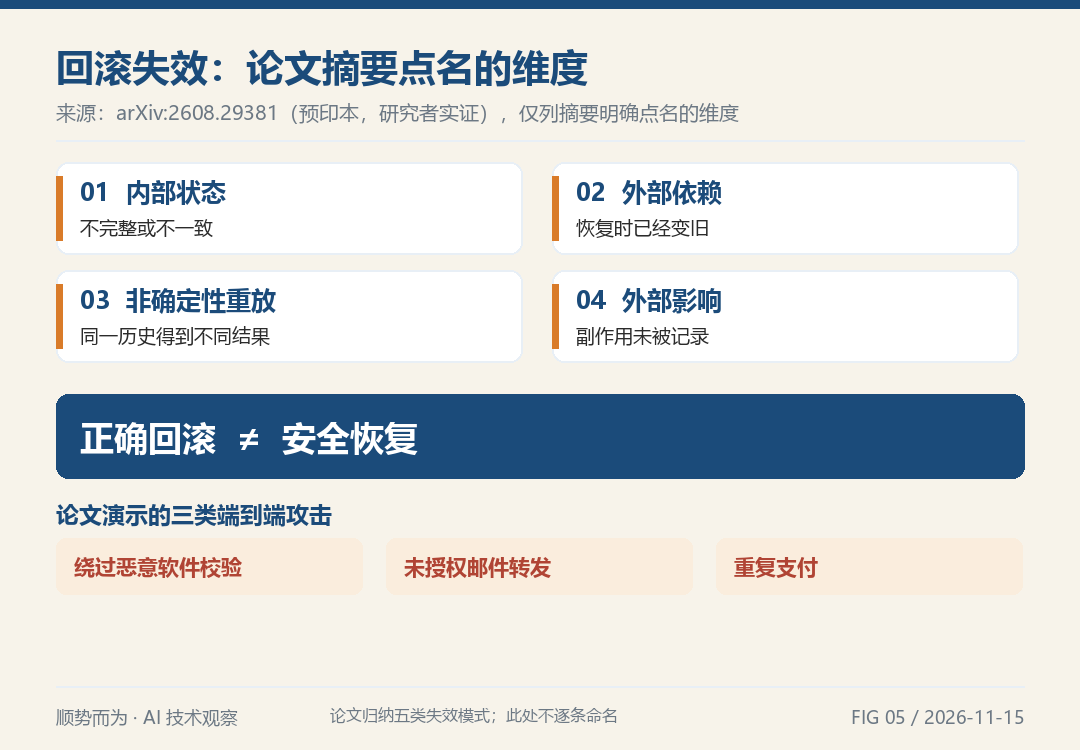
arXiv:2608.29381 归纳的五类回滚失效模式
这也解释了为什么「把对话历史存好」远远不够:危险不在模型忘了什么,而在它记得的世界和真实的世界对不上。
值得区分清楚的是,这和「给 Agent 划权限」是两条不同的轴。权限回答「允不允许做」;执行连续性回答「做了一半、断了之后,世界和它记的是不是同一个世界」。一个权限设计得极严的系统,照样可能在一次重启后把一封合规的邮件发两遍。
05 恢复之前,先做一次「世界对账」
还原不等于安全,恢复就该是一道有条件的闸门:在「加载检查点」与「继续往下跑」之间插入一次显式对账。
- 拿稳定的操作 ID 去查权威系统。 不是问模型「刚才发出去了吗」,而是拿
idempotency_key去查订单系统、邮件网关、支付网关的真实回执。 - 按结果分三路走。 已提交 → 记录回执、跳过该步;确认未发生 → 仅当该动作可安全重放时才重试;仍然未知 → 停下,升级给人工,不要猜。
- 做一次 plan-diff。 把检查点里的预期状态与恢复时的真实状态比对:下游超时可以重试,上游 API 字段变更则可能让整份计划失效,需要回到最后一个干净检查点重新规划。
- 按不可逆性给动作分级。 数据库记录可改,已扣款需冲正,已发邮件与已送达 webhook 不可撤销;等级越高,越要把人工闸门放在动作之前。
- 保留升级路径。 上下文被裁剪、环境变化、置信度不足时,存好状态、停下、交给人;循环检测要拦住「和上次失败几乎一样」的计划。
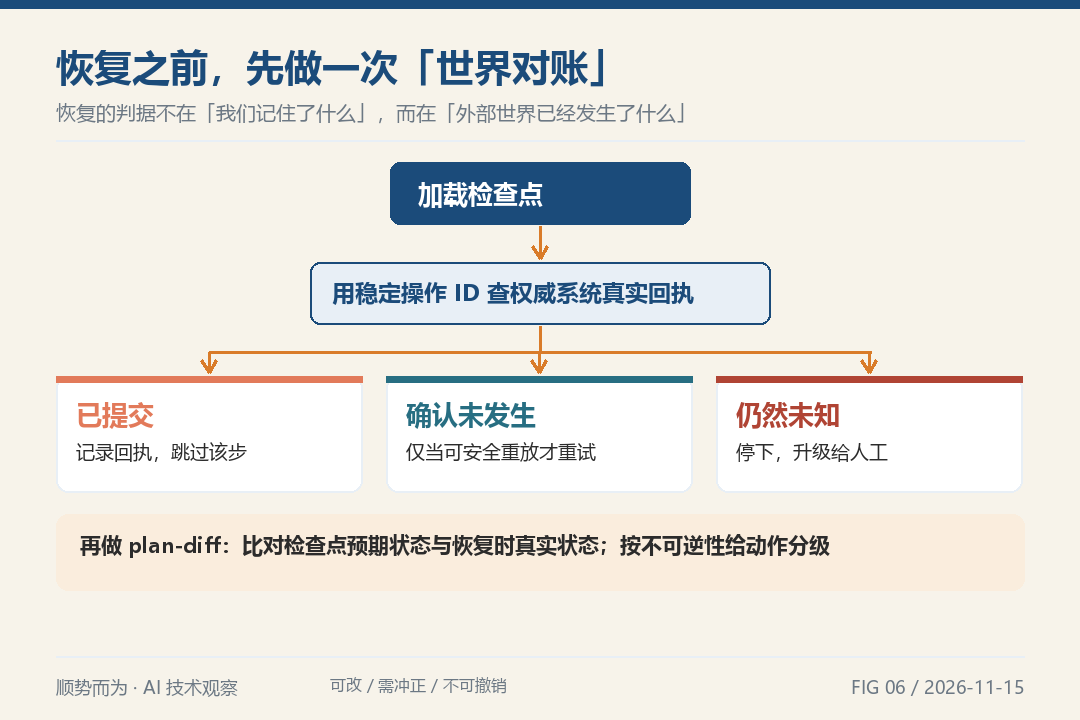
恢复前的世界对账:查回执、分三路、plan-diff、按不可逆性分级
一句话概括这套纪律:恢复的判据不在「我们记住了什么」,而在「外部世界已经发生了什么」。 前者可以存,后者只能查。
06 等待不该烧钱:长任务的经济账
长任务的另一个特征,是大量时间花在等上——等模型、等工具、等审批、等客户回信、等配件到货。
按「一个常驻进程从头跑到尾」设计,等待期间容器、内存、连接全占着;关掉再启动又影响连续性。上海证券报那篇报道把这一点列为基础设施硬约束:当成千上万个 Agent 同时工作,弹性调度、沙箱启动、存储快照恢复和安全隔离都会被推到更高要求上。
业界的解法是把「等待」变成可暂停、可唤醒的持久化状态,而非占着资源的 sleep:durable timer、signal、awakeable、task token 名字不同,共同点是等待期间不持有进程、不消耗算力。据 2026 年 11 月技术综述,AWS Lambda durable functions 支持最长一年的执行、等待不计作计算;LangGraph 用 checkpointer 存图状态,Temporal 用 signal 挂起审批。以上为第三方归纳,以各家官方文档为准。
AWS 官方 FAQ 给出的口径更值得算一算:智能体负载通常有 30%–70% 的时间处于 I/O 等待,而 AgentCore Runtime 对等待与空闲不计费。也就是说,长任务的成本结构里,「让进程一直活着」本身就是一笔可观的浪费。
反过来看重跑:从头再来意味着已完成的模型与工具调用重新付费,含非幂等动作还可能造成业务损失。可靠性直接挂在单位任务的成本上。 21 世纪经济报道 2026 年 11 月 2 日提出「成本线性上升与收益斜率之间的赛跑」,在长任务场景里,这场赛跑很大程度由恢复机制决定。
07 落到业务:一张跨天售后工单怎么设计续跑
放回开头那家出口企业,可执行的口径其实不复杂。
售后工单天然是长任务:客户抱怨开门机低温重启,Agent 要查订单与批次、翻说明书与历史邮件、判断补发配件、起草英文回复、等主管审批、再等客户确认,中间可能跨两三天,还可能遇到客户中途改需求。
设计时的顺序是固定的:
- 先画红线。 把「向外部客户发邮件」「提交退款」「修改工单状态」列为不可撤销或需补偿的动作,全部前置人工闸门;闸门放在发送侧,不放在模型的提示词里。
- 再定检查点位置。 每个带副作用的工具调用之前必须落盘,且落盘与「写 PREPARED、生成稳定幂等键、写 outbox」在同一个本地事务里完成。
- 把等待外置。 等客户回信、等审批、等到货通知,都用可被回调唤醒的持久化等待,不占进程;回调进来时用
run_id精确关联到原任务。 - 恢复时先对账再续跑。 拿幂等键去邮件网关和订单系统查真实回执;查得到就跳过,查不到就停给人。
- 给上下文做减法。 按「保系统提示、保最近若干轮、保关键决策点,中间压成摘要」裁剪;不可丢失的约束写进结构化状态,别指望模型一直记得。
- 把历史邮件变成评测集。 每次恢复是否正确、有没有重复副作用,都要能被回放和断言,而不是靠上线后人工抽查。
这里没有一步需要更强的模型。它们全都是把「模型负责提议、确定性代码负责裁决」落在时间维度上的结果。
08 代价与边界:检查点不是免费的
检查点频率是一道旋钮,不是越密越好。 每留一个检查点都要序列化、落盘、管理:太稀疏恢复时要补很多步,太密集又拖慢节奏、吃掉存储。跑三天、碰真钱的任务值得做密,几秒能重来的小任务硬上检查点反而是浪费。社区里还有一类典型事故——跑了半年的 Agent 平台,检查点表比业务表先撑爆磁盘,所以清理与压缩要和检查点一起设计。
存储耐久解决不了上下文膨胀。 工具结果与推理轨迹累积得比淘汰得快,「上下文超长」的病根在状态管理,不在模型。据 2026 年技术综述,Anthropic 当年 5 月提出过用离线记忆整理("dreaming")在会话之间剪枝;这是厂商分享的方向,不是可照搬的结论。
框架能力不等于生产保证。 2026 年 10 月出现的 Pi Durable 等运行时把「每步存档」做进了 harness,但作者标注为实验性,缺少长周期生产数据,宜视作方向信号而非验证过的答案。
论文结论也有边界。 arXiv:2608.29381 是预印本,五类失效模式来自研究者对代表性系统的建模,宜当作恢复设计的检查项,而非行业普查。
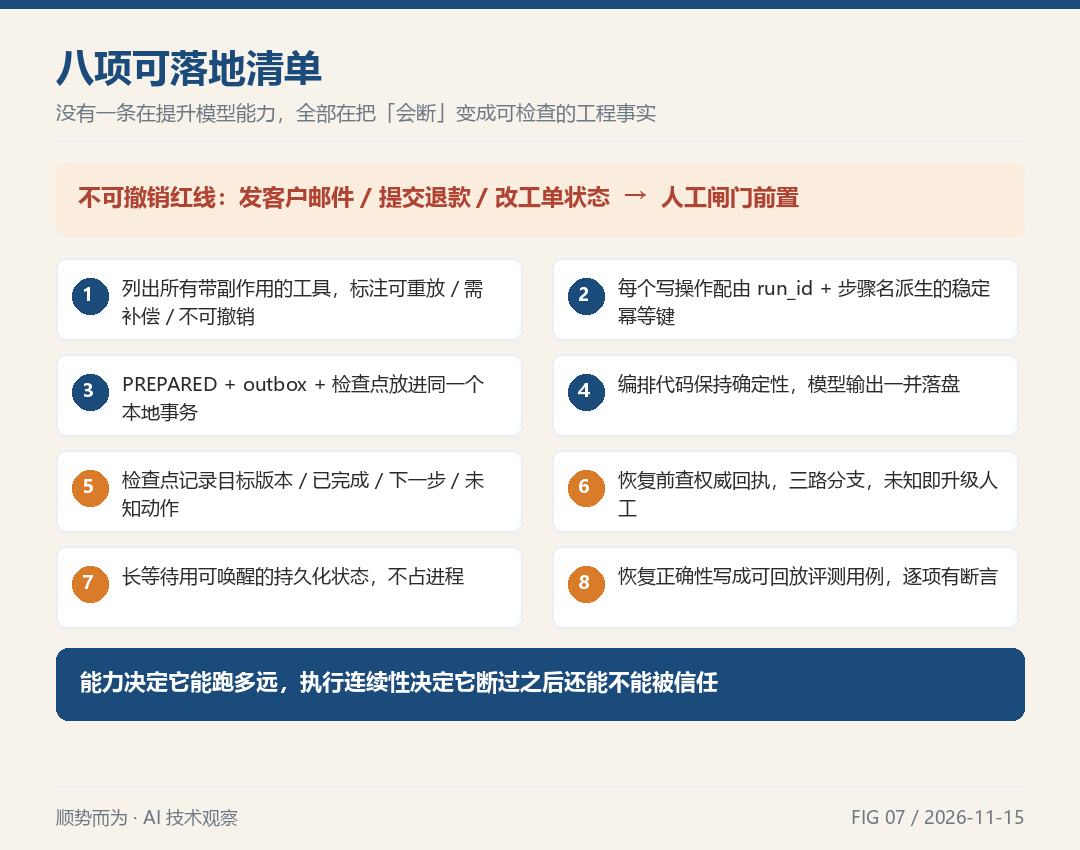
八项可落地清单与不可逆动作红线
09 一份可以今天就用上的清单
- 列出所有带外部副作用的工具,标注哪些可重放、哪些需补偿、哪些不可撤销;
- 给每个写操作配由
run_id+ 步骤名派生的稳定幂等键,并确认下游支持去重; - 把副作用之前的「写 PREPARED + outbox + 检查点」放进同一个本地事务;
- 编排代码保持确定性,模型与工具调用全部包进被记录的 step/activity,模型当次输出一并落盘;
- 检查点至少记录目标版本、已完成步骤、下一步、结果未知的待确认动作;
- 恢复前用稳定操作 ID 查权威系统回执,按「已提交/确认未发生/仍未知」三路分支,未知即升级人工;
- 长等待用可唤醒的持久化状态,不占进程;恢复时重新读取外部真实状态做 plan-diff;
- 把恢复正确性写成可回放的评测用例:重启、超时无响应、并发重入、中途改需求,都要有断言。
这八条里没有一条在提升模型能力。它们做的都是同一件事:承认 Agent 会断,并且提前把「断在哪里、还敢不敢接着跑」变成可以被检查、被测试、被追责的工程事实。
能力决定它能跑多远,执行连续性决定它断过之后还能不能被信任。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号