分布式温湿度采集监控实践:Modbus TCP温湿度传感器断点续传、本地缓存方案设计
原创
分布式温湿度采集监控实践:Modbus TCP温湿度传感器断点续传、本地缓存方案设计
原创
BJ盛世宏博小程
发布于 2026-11-16 15:33:17
发布于 2026-11-16 15:33:17
分布式温湿度采集监控实践:Modbus TCP温湿度传感器断点续传、本地缓存方案设计
物联网 · 盛世宏博 · 边缘采集
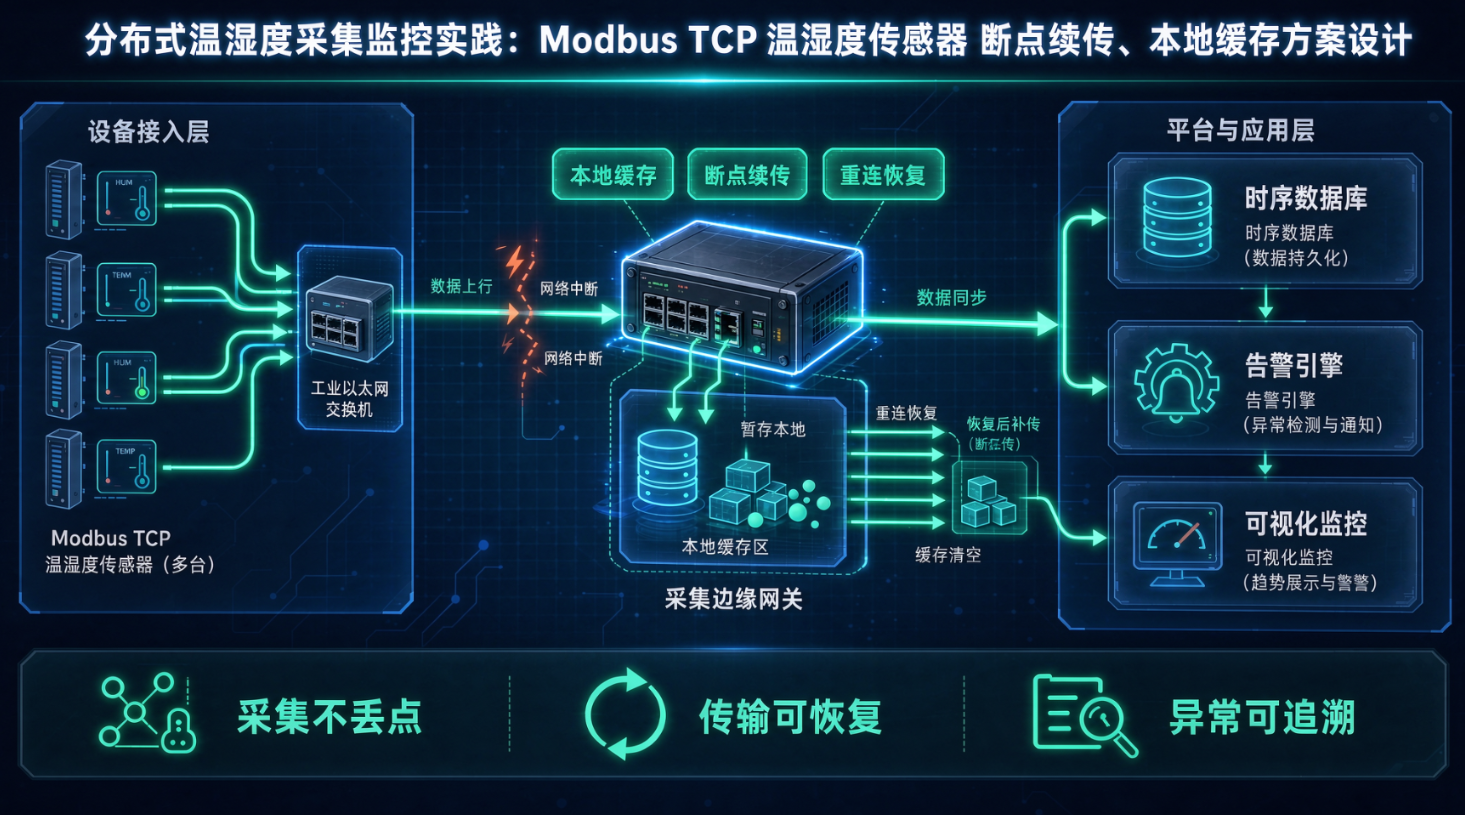
一、先立命题:断点续传不是“断网重发”,是“数据不断链”
分布式温湿度采集里,网络抖动、平台升级、专线割接、远程站点链路不稳是常态。真出问题往往不是“当时没数据”,而是:
- 平台恢复后曲线出现空洞,无法判定那 20 分钟库房到底超没超标
- 补传数据时间戳乱了,趋势图倒流、报表全错
- 缓存把磁盘写满,网关卡死,现场联动一起挂
- 补传数据冲进实时告警引擎,历史越限被当新告警狂轰
所以断点续传的设计目标只有一句话:边缘侧离线期间,数据一条不丢、时间不乱、补传不冲击平台、不干扰实时链路。
二、断链故障分类:不同“断法”用不同兜底
故障类型 | 表现 | 风险 | 兜底策略 |
|---|---|---|---|
平台不可达 | TCP 连不上/拒绝 | 数据无处上送 | 本地缓存 + 指数退避重连 |
网络抖动 | 时通时断、RTT 抖动 | 半包、乱序、重复 | 单连接串行 + 序号去重 |
平台重启/升级 | 端口通但业务未就绪 | 连接成功却写入失败 | 健康检查探针 + 写确认 |
网关进程崩溃 | 整机采集停摆 | 缓存与采集双失 | systemd 看门狗 + 落盘前 WAL |
传感器离线 | 单台无响应 | 点位空洞 | 质量戳 COMM_LOST,不写缓存假值 |
断电重启 | 全站重启 | 缓存易失、时间回跳 | 持久化 + RTC + 启动补传 |
关键区分:平台断 ≠ 传感器断。传感器离线要标质量戳,不能拿“最后值”填坑;平台断才走缓存补传。
三、总体架构:三层缓冲 + 单一数据管道
传感器(RJ45/Modbus TCP)
        │ 轮询采集(并发池 + 超时 + 质量戳)
        ▼
┌──────────────────────────────────────────────┐
│ 边缘网关                                     │
│  ① 采集层  → 原始帧 + dev_ts + gw_ts + seq   │
│  ② WAL     → 追加写日志(先落盘再入队)      │
│  ③ 环形缓存 → SQLite / 文件分片(带水位线)  │
│  ④ 上传层  → 实时通道 + 补传通道(双队列)   │
│  ⑤ 状态机  → ONLINE / SUSPECT / OFFLINE /    │
│                RECOVERING / BACKFILLING      │
└──────────────────────────────────────────────┘
        │ MQTT(实时,QoS1) + HTTPS(补传,批量)
        ▼
平台:去重(seq+dev_ts) → 时间校准 → 分流入库
      ├─ 实时流 → 告警引擎(只吃实时)
└─ 补传流 → 历史库(打 backfill 标记)核心设计:实时与补传走两条独立队列、两个主题。补传数据永不进实时告警引擎,这是防止“历史告警刷屏”的根本手段。
四、数据模型:一条记录该带什么
{
  "seq": 1048721,
  "dev_id": "IDC-A03-R05-TH01",
  "ip": "192.168.90.11",
  "point": {"temp": 22.35, "humi": 51.20, "dew": 12.10},
  "raw": {"temp": 2235, "humi": 5120},
  "quality": "GOOD",
  "dev_ts": 1760620805123,
  "gw_ts":  1760620805180,
  "plat_ts": null,
  "firmware": "2.3.1",
  "crc": "a9f3c2"
}
字段设计要点:
seq:网关侧单调递增序号,补传去重的唯一依据dev_ts:设备采样时间(设备有 RTC 就用设备时间,没有则用网关接收时间)gw_ts:网关入库时间,用于计算链路延迟raw+point:原始寄存器值与换算值双存,便于回溯缩放错误quality:GOOD / SUSPECT / COMM_LOST / OUT_OF_RANGE / STALEcrc:整条记录校验,防存储介质位翻转
时间以设备采样时间为准,平台入库时间只做辅助。断网重连后若用网关时间覆盖,曲线会出现“时间坍塌”。
五、本地缓存设计
1. 存储介质选型
方案 | 优点 | 缺点 | 适用 |
|---|---|---|---|
SQLite(WAL 模式) | 事务安全、可索引查询、单文件易备份 | 高频写需调优 | 推荐主力 |
文件分片(每 N 分钟一个 .jsonl) | 简单、抗损坏、按文件补传 | 查询弱 | 大批量站点 |
环形内存 + 周期快照 | 快 | 断电丢数据 | 仅做二级缓冲 |
建议:SQLite 为主 + 文件分片为灾备,双写代价可控。
2. SQLite 建表与调优
PRAGMA journal_mode=WAL;
PRAGMA synchronous=NORMAL;
PRAGMA busy_timeout=5000;
PRAGMA wal_autocheckpoint=2000;

CREATE TABLE IF NOT EXISTS env_data (
    seq      INTEGER PRIMARY KEY,
    dev_id   TEXT    NOT NULL,
    temp     REAL,
    humi     REAL,
    dew      REAL,
    raw_t    INTEGER,
    raw_h    INTEGER,
    quality  TEXT    NOT NULL,
    dev_ts   INTEGER NOT NULL,
    gw_ts    INTEGER NOT NULL,
    uploaded INTEGER NOT NULL DEFAULT 0,
    crc      TEXT
);
CREATE INDEX idx_upload ON env_data(uploaded, dev_ts);
CREATE INDEX idx_dev_ts ON env_data(dev_id, dev_ts);关键点:uploaded 字段 + 索引,让补传查询走覆盖索引,不扫全表。
3. 水位线与淘汰策略
单条记录 ≈ 320 字节
32 点 × 1次/分钟 × 1440 分钟 ≈ 4.6 万条/天 ≈ 15MB/天
缓存 7 天 ≈ 105MB,设上限 2GB 可存约 4 个月

水位线:
  70%  → 正常
  85%  → 告警“缓存积压”,提示检查链路
  95%  → 淘汰最老已上传记录(DELETE uploaded=1 ORDER BY dev_ts LIMIT N)
100% → 停写非关键点位(慢变量),保证快变量与告警不丢淘汰只删已上传的,未上传记录永不自动丢弃——宁可停采集也不删未传数据。
4. 先落盘再入队(WAL 语义)
def on_sample(rec):
    db_insert(rec)          # 1. 同步落盘(事务提交)
upload_queue.put(rec) # 2. 再进内存队列顺序反了会怎样:进程在“已入队未落盘”时崩溃,这条数据既没上传也没存,永久丢失。
六、断点续传状态机
采集正常
  ┌──────────► ONLINE ──────────┐
  │              │ 上传连续失败 3 次
  │              ▼               │
  │          SUSPECT ────────► OFFLINE(平台不可达)
  │              │                 │ 探活成功
  │              │                 ▼
  │              │           RECOVERING(校验时间/配置)
  │              │                 │ 校验通过
  │              │                 ▼
  │              │           BACKFILLING(补传队列优先)
  │              │                 │ 追平水位
  └──────────────┴─────────────────┘
状态含义:
- SUSPECT:偶发失败,降级观察,不急着标离线
- OFFLINE:确认断链,进入退避重连,采集照跑、缓存照写
- RECOVERING:重连成功但先校验(平台时间、点位表版本、seq 水位)
- BACKFILLING:先把积压补完,再切回实时通道
七、重连与退避策略
import random, time

class Backoff:
    def __init__(self, base=2.0, cap=120.0):
        self.base, self.cap = base, cap
        self.attempt = 0

    def next(self):
        self.attempt += 1
        delay = min(self.cap, self.base ** self.attempt)
        return delay * (0.8 + 0.4 * random.random())  # ±20% 抖动

    def reset(self):
        self.attempt = 0
要点:
- 指数退避 2s→4s→8s…上限 120s,别无限打平台
- 加 ±20% 随机抖动,防上百台网关在同一秒集体重连(惊群效应)
- 探活用轻量健康检查接口,不用业务写入探活
八、补传算法:分块、限速、幂等
BATCH = 500          # 每批条数
RATE  = 20           # 每批间隔 ms,避免打满上行带宽

def backfill(db, uploader, last_seq):
    while True:
        rows = db.query(
            "SELECT * FROM env_data WHERE uploaded=0 AND seq>? "
            "ORDER BY seq LIMIT ?", (last_seq, BATCH))
        if not rows:
            return True

        ok_seq = uploader.upload_batch(rows)   # 返回成功的最大 seq
        if ok_seq is None:
            return False                        # 失败,退避后重试

        db.exec("UPDATE env_data SET uploaded=1, plat_ts=? WHERE seq<=?",
                (time.time() * 1000, ok_seq))
        last_seq = ok_seq
        time.sleep(RATE / 1000)
三个必须:
- 按 seq 顺序补,不并发乱序入库
- 批量提交(500 条/批),比逐条快两个数量级
- 服务端幂等:以
(dev_id, seq)为唯一键,重复包直接丢弃不报错
补传限速:按站点上行带宽算,控制在 30% 以内,别把实时通道一起挤死。
九、平台侧配合改造
网关做对了,平台不配合照样乱。平台需要:
-- 历史表加唯一约束,天然幂等
ALTER TABLE env_history ADD CONSTRAINT uk_dev_seq UNIQUE (dev_id, seq);

-- 入库分流
IF backfill = true THEN
    INSERT INTO env_history (...) ;          -- 只进历史库
ELSE
    INSERT INTO env_realtime (...) ;         -- 进实时表 + 触发告警引擎
    INSERT INTO env_history (...) ;
END IF;
平台侧还要做:
- seq 断号检测:
seq不连续即告警“网关丢数”,比在线率更真实 - 时间倒流保护:
dev_ts小于该设备最后入库时间则丢弃或隔离 - 补传标记:报表区分“实时数据”和“补传数据”,审计可追溯
- 延迟监控:
plat_ts - dev_ts作为链路健康指标,P99 超阈值预警
十、断电与重启:最容易漏的一环
断电重启会同时打死三样:内存队列、未刷盘 WAL、系统时钟。
对策:
synchronous=NORMAL+ WAL:崩溃最多丢最后若干条,且库不损坏- 启动时时钟校验:NTP 未同步前禁止采集写入(否则时间戳回跳几十年)
- RTC 电池:设备侧保留时间,断网断电不失准
- 启动流程固定顺序:时钟同步 → 配置加载 → seq 水位读取 → 采集启动 → 补传启动
- systemd 守护:
Restart=always+WatchdogSec=30s
[Service]
ExecStart=/usr/bin/python3 /opt/gw/main.py
Restart=always
RestartSec=5
WatchdogSec=30s
十一、可观测性:缓存系统自己也要被监控
指标 | 含义 | 阈值建议 |
|---|---|---|
cache_usage_ratio | 缓存水位 | >85% 告警 |
cache_pending_rows | 未上传条数 | >50 万告警 |
backfill_lag_seconds | 补传落后时长 | >10min 告警 |
upload_success_rate | 上传成功率 | <99% 告警 |
seq_gap_count | 序号断号数 | >0 即告警 |
clock_drift_ms | 网关与 NTP 偏差 | >500ms 告警 |
db_write_p99_ms | 落盘延迟 | >50ms 预警 |
这些指标走同一条 MQTT 通道上报(独立 topic),平台看不到指标就等于盲开。
十二、故障注入测试清单
用例 | 操作 | 期望 |
|---|---|---|
平台进程停 10min | systemctl stop platform | 缓存完整、恢复后自动补传、无重复 |
拔网线 30min | 断开上联 | 采集不停、缓存不丢、退避不打满日志 |
网关 kill -9 | 强制杀进程 | WAL 未损坏、重启后 seq 连续 |
断电拔插 | 直接断电 | 库可打开、时钟校验后才写入 |
平台返回 500 | mock 持续报错 | 退避生效、不死循环 |
补传中途再断 | 补到一半断网 | 断点续传,不从头重发 |
补传数据入库 | 检查告警引擎 | 不触发任何新告警 |
重复投递 | 同一批发两次 | 平台幂等丢弃,条数不翻倍 |
时间回跳 | 手动改系统时间 | 采集拒绝写入并告警 |
十三、验收红线
- [ ] 断网 8 小时,恢复后数据条数 = 理论采样数(允许 ≤0.1% 丢失)
- [ ] 补传记录
dev_ts单调递增,无时间倒流 - [ ] 补传数据打
backfill标记,不触发告警 - [ ]
(dev_id, seq)平台侧无重复 - [ ] 缓存水位 95% 时只淘汰已上传数据
- [ ] 断电重启后数据库可正常打开、seq 连续
- [ ] 时钟未同步时拒绝写入
- [ ] 网关 CPU <30%、内存无持续增长(72h 无泄漏)
- [ ] 缓存指标全部上平台可见
十四、常见翻车实录
- 用最后值填坑 → 断网期间“数据完美”,实际库房在那 20 分钟飙到 70%RH 没人知道
- 补传走实时 topic → 平台恢复瞬间涌入 5 万条历史越限,短信轰炸
- 无 seq 靠时间戳去重 → 设备时钟漂移 2 秒,同秒两条被当重复删掉一条
- 缓存写内存队列 → 断电丢 3 小时数据,且库文件损坏打不开
- 退避无抖动 → 40 台网关同一秒重连,平台被自己人打挂
- 补传不限速 → 占满专线带宽,实时数据反而延迟到分钟级
- 淘汰策略删错数据 → 按时间删最老,把还没上传的先删了
- NTP 未同步就采集 → 断电重启后时间戳变成 2016 年,报表全废
十五、收口
分布式温湿度采集的断点续传与本地缓存,落成四句话:
数据模型上:一条记录带齐 seq + dev_ts + gw_ts + quality + raw,序号是去重的命根,采样时间是曲线的命根。
缓存设计上:先落盘再入队,SQLite WAL 为主、文件分片为灾备,水位线明确,只淘汰已上传。
传输策略上:实时与补传双通道隔离,指数退避加抖动,分块限速,服务端按 seq 幂等。
平台配合上:唯一约束兜底,补传标记分流,断号检测代替在线率,链路延迟做健康指标。
最后记住那条底线:
断网时数据可以晚到,但不能不到、不能错序、不能冒充实时。
缓存不是“存起来再说”,是让平台在恢复之后,还能诚实还原现场那几个小时到底发生了什么。
关键词:分布式采集、Modbus TCP、断点续传、本地缓存、SQLite WAL、序号幂等、双通道分流、指数退避、水位线淘汰、时钟同步
标签:#ModbusTCP #断点续传 #本地缓存 #边缘网关 #SQLiteWAL #幂等去重 #补传限速 #状态机 #动环采集 #断网自治
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号