Python gzip能读出内容,为什么最后还报CRC错误?
原创
Python gzip能读出内容,为什么最后还报CRC错误?
原创
逻界软件科技工作室
发布于 2026-11-17 10:58:05
发布于 2026-11-17 10:58:05
假设要导入一份本地 .gz 数据文件:先用 gzip.open() 打开,读一个字节做预览,没报错,便把文件标为可用。等导入程序读到最后,却收到了 CRC check failed。前面的内容明明能读,文件为什么仍不合格?
打开成功、读出开头和完整读完,是三个不同的检查点。下面用 CPython 3.14.3 的真实临时文件复现这个区别,不涉及 HTTP 的 Content-Encoding,也不需要第三方压缩库。
1. 错误在尾部,开头可以先返回
一个 gzip member 包含头部、压缩数据和尾部。尾部保存 CRC32,以及未压缩长度对 2**32 取模后的 ISIZE。数据能够解压出来,并不意味着这些值已经比对完毕。
在 CPython 3.14.3 的 Lib/gzip.py 中,读取器逐步计算输出的 CRC 和长度;走到 member 结束处理时,_read_eof() 才读取尾部并比对。之后还要尝试读取下一个 member,才能知道整个输入是否结束。
因此,read(1) 可以先返回开头,而 CRC 错误留到后续读取才暴露。缓冲和预读也可能让错误更早出现,不能反过来保证“少读一定不报错”。关闭读取对象只是释放资源,不会替你消费未读完的内容。
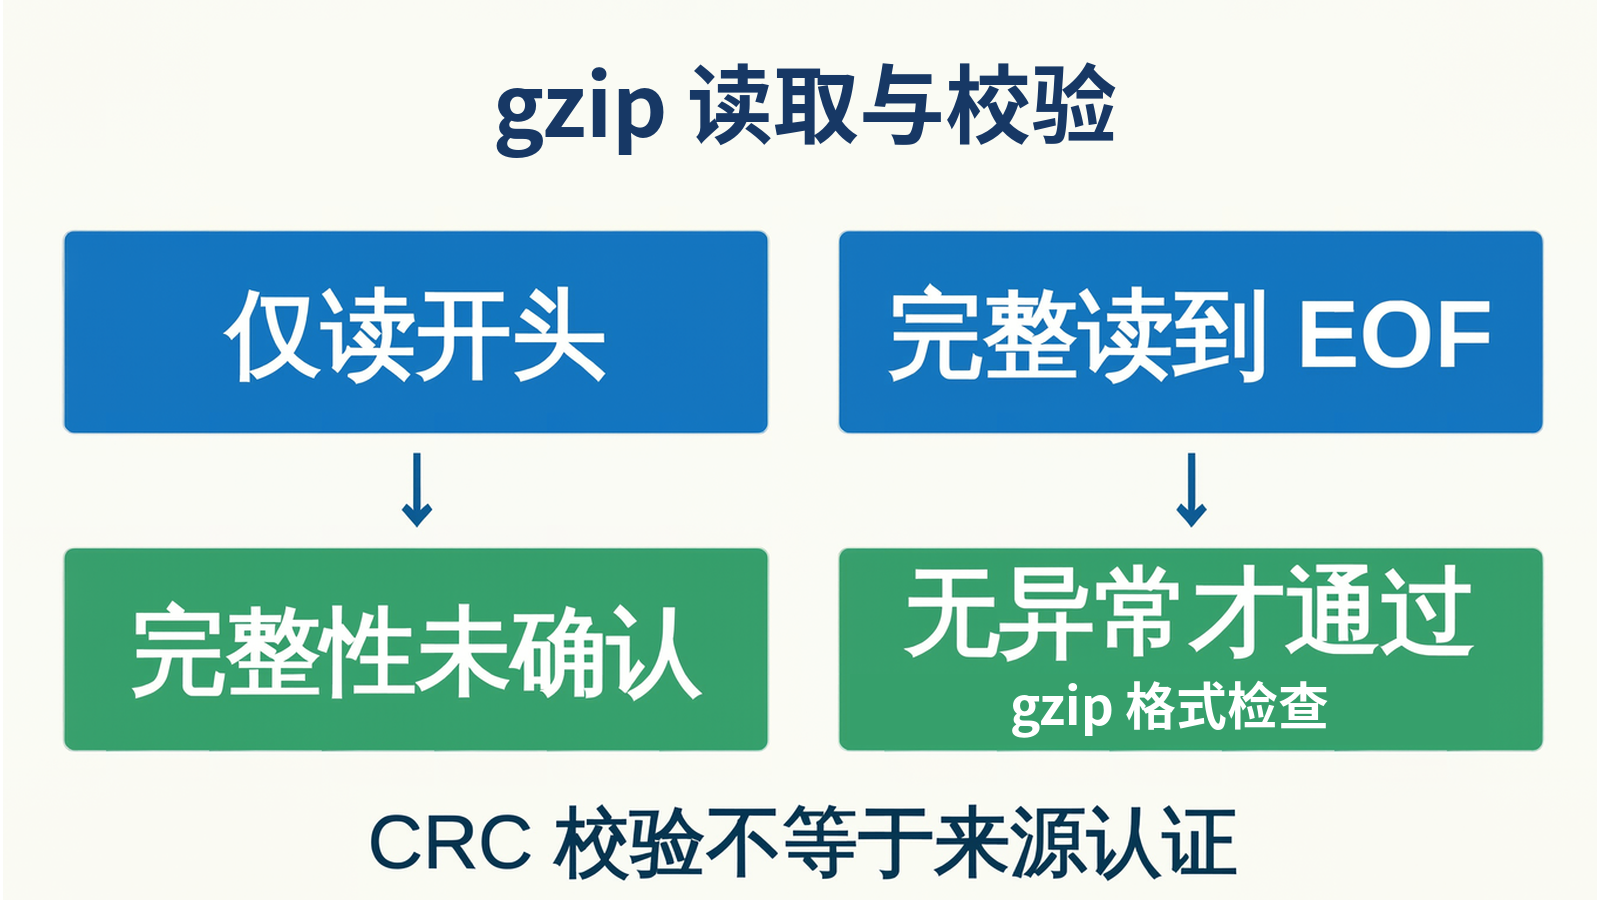
AI辅助示意:部分读取≠完整性校验;完整消费到EOF后再做业务验收。
2. 用足够长的内容复现,别让小样本干扰结论
下面是一份完整实验,保存为 code.py,用 python3 code.py 运行。它先构造固定的约 2 MiB 原文,再把 gzip 字节写入普通临时文件。tempfile 遵循运行环境的临时目录约定,退出时自动清理;样本不接触已有业务文件。
CRC 反例只翻转尾部 CRC32 的一位;截断反例删掉最后四字节,让尾部不完整。长输出是为了在本次实验中让一次 read(1) 不必完成整份内容的解压与尾部处理,不是声称底层绝不预读。
代码中的 消费() 每次读取 64 KiB,直到 read() 返回 b'',不把解压结果全部拼进内存。它只是实验函数,不是通用安全解压器。所有检查均显式抛错,不依赖 assert。
import gzip
import platform
import tempfile
import zlib
from pathlib import Path

通过项 = []


def 检验(名称, 操作, 预期=None, 异常=None):
    try:
        结果 = 操作()
    except Exception as 错误:
        if 异常 is None or type(错误) is not 异常:
            raise
        说明 = type(错误).__name__
    else:
        if 异常 is not None or 结果 != 预期:
            raise RuntimeError(f"检验失败:{名称},实际={结果!r}")
        说明 = repr(结果)
    if 名称 in 通过项:
        raise RuntimeError("用例名称重复")
    通过项.append(名称)
    print(f"通过:{名称} -> {说明}")


def 消费(路径, 上限=None):
    # 这里只演示输出计数;预算拒绝时不宣称已校验尾部。
    累计 = 0
    with gzip.open(路径, "rb") as 文件:
        while 块 := 文件.read(64 * 1024):
            累计 += len(块)
            if 上限 is not None and 累计 > 上限:
                raise ValueError("输出超预算;未确认完整性")
    return 累计


def 仅打开(路径):
    with gzip.open(路径, "rb"):
        return "打开后关闭,未读取"


def 浅读后关闭(路径):
    with gzip.open(路径, "rb") as 文件:
        开头 = 文件.read(1)
    return 开头  # with 已退出;关闭不等于把剩余内容读完。


print(f"解释器:{platform.python_implementation()} {platform.python_version()}")
原文 = b"record=2026\n" + bytes(range(256)) * 8192
正常 = gzip.compress(原文, compresslevel=1, mtime=0)
校验错 = bytearray(正常)
校验错[-8] ^= 1  # 最后8字节是 CRC32 和 ISIZE;只翻转 CRC 的一位。
长度错 = bytearray(正常)
长度错[-4] ^= 1
编码错 = bytearray(正常)
编码错[10] |= 6  # 本例固定10字节头;DEFLATE 首块类型改为保留值3。
样本 = {"正常": 正常, "空内容": gzip.compress(b"", mtime=0),
      "校验错": 校验错, "截断": 正常[:-4], "非法头": b"not gzip",
      "长度错": 长度错, "编码错": 编码错,
      "拼接正常": 正常 + 正常, "拼接第二损坏": 正常 + 校验错}
with tempfile.TemporaryDirectory(prefix="gzip-check-") as 临时目录:
    根目录 = Path(临时目录)
    for 名称, 内容 in 样本.items():
        (根目录 / 名称).write_bytes(内容)
    def 路径(名称):
        return 根目录 / 名称
    for 名称, 预期 in [("正常", len(原文)), ("空内容", 0),
                     ("拼接正常", len(原文) * 2)]:
        检验(f"完整消费/{名称}", lambda 名称=名称: 消费(路径(名称)), 预期)
    for 名称, 异常 in [("校验错", gzip.BadGzipFile), ("截断", EOFError),
                     ("非法头", gzip.BadGzipFile), ("长度错", gzip.BadGzipFile),
                     ("编码错", zlib.error), ("拼接第二损坏", gzip.BadGzipFile)]:
        检验(f"完整拒绝/{名称}", lambda 名称=名称: 消费(路径(名称)), 异常=异常)
    检验("只打开非法头", lambda: 仅打开(路径("非法头")), "打开后关闭,未读取")
    for 名称 in ["校验错", "截断"]:
        检验(f"浅读并关闭/{名称}", lambda 名称=名称: 浅读后关闭(路径(名称)), 原文[:1])
    检验("预算恰好且读到EOF", lambda: 消费(路径("正常"), len(原文)), len(原文))
    检验("空内容零预算", lambda: 消费(路径("空内容"), 0), 0)
    检验("正常输出超预算", lambda: 消费(路径("正常"), 1), 异常=ValueError)
    检验("损坏输出提前超预算", lambda: 消费(路径("校验错"), 1), 异常=ValueError)
    检验("缺失路径", lambda: 消费(路径("不存在")), 异常=FileNotFoundError)
print(f"独立用例:{len(通过项)},全部通过")
3. 这次执行实际证明了什么
本机 CPython 3.14.3 的 17 个独立用例全部通过。这里的“通过”也包括按预期拒绝坏输入,并非所有文件都能正常解压。
操作或样本 | 本次结果 |
|---|---|
完整读取正常 gzip、空内容 gzip | 正常结束,输出长度分别为 2097164、0 |
完整读取 CRC 损坏、ISIZE 损坏 |
|
完整读取尾部截断 |
|
完整读取非法头 |
|
完整读取非法 DEFLATE 块类型 |
|
两个正常 member 拼接 | 完整读取两份输出,共 4194328 字节 |
第一个正常、第二个 CRC 损坏 |
|
只打开非法头文件,随即关闭 | 没有读取,也没有触发格式错误 |
CRC 损坏或截断,只读一个字节再关闭 | 均返回 |
其余用例核对了预算恰好足够、空内容零预算、两个超预算拒绝,以及缺失路径。原稿与最终 HTML 抽出的代码,还分别在默认、-O、-OO 模式执行;这些重放不增加独立用例数。
4. 异常要分层,别都记成文件损坏
官方文档说明,非法 gzip 输入可能触发 gzip.BadGzipFile、EOFError 或 zlib.error。本例分别构造了对应反例,但异常和损坏类型不是跨版本的一一映射,实际结果还取决于损坏位置与读取路径。
BadGzipFile 从 Python 3.8 起提供,而且继承自 OSError。业务程序如果需要区分日志类别,应先处理这几种格式、解压异常,再处理其他 OSError。否则,一个过宽的 OSError 分支会把格式错误和文件系统错误混在一起。
例如,本次缺失路径得到的是 FileNotFoundError,不是 gzip 校验失败。权限、磁盘和其他 I/O 故障也应按环境问题排查;这些环境故障并未在本例逐一模拟。若使用文本模式,字符解码还可能另行失败。
捕获异常后,也不能一边记录“校验失败”,一边把此前读出的半份数据标为导入成功。
5. 分块消费不代表没有资源风险
对不可信输入,无限制读到 EOF 可能耗费大量输出空间和 CPU 时间。分块只避免一次性保存全部输出,不会自动限制解压总量、运行时间或临时磁盘占用。
本例的输出预算有意写得很简单:收到一块后累计长度,超限就抛 ValueError。它不是分配前的硬内存限制,库的缓冲和解压工作仍然存在。真实接入还需按场景约束输入、输出、时间及存储资源。
“损坏输出提前超预算”用例先得到预算拒绝,而不是 CRC 错误。程序已经停止,不能再声称尾部通过或失败。预算拒绝、完整校验通过,必须是不同的结果。
如果要在校验后导入数据,可以先写入受控临时产物;只有完整消费成功,再进行格式与业务验收,最后才进入正式提交。失败时丢弃临时产物。这个流程仍需单独设计空间预算、提交方式和故障恢复,本例没有实现这些能力。
6. 读到 EOF 后,还有哪些事没证明
gzip 支持多个 member 拼接。只验完第一个,不代表第二个没有问题;本例就用第二个 member 的坏 CRC 验证了这一点。读取循环必须继续到整个输入结束,不能把第一段输出当作全部完成。
但若整段 member 被移除,剩下的输入仍可能是一个合法 gzip。库无法知道发送方原本打算交付几段、多少条记录。需要这些保证时,要另外核对可信清单、期望长度或记录数。
CRC32 不是密码学认证,不能证明来源可信或内容未被恶意替换;攻击者可以修改内容并重新计算 CRC。真实性应由独立的可信摘要传递、MAC 或签名等机制解决。
同样,字节解压成功、UTF-8 解码成功,都不证明字段、记录数量或业务约束正确。完整读取无异常后,再核对记录数、字段和业务约束;需要确认来源时,另行验证可信凭据。
参考资料
- Python 3.14 官方 gzip 文档:API、异常类型及
BadGzipFile的版本说明。该地址随 3.14 分支维护,不等同于固定补丁版文档。 - CPython v3.14.3 的 Lib/gzip.py:重点对照
_GzipReader.read()、_read_eof()与读取模式的close()。本文只报告本机 3.14.3 的文件实验结果。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号