广告归因与长期价值分析的数据链路
原创
广告归因与长期价值分析的数据链路
原创
数据党
修改于 2026-11-17 14:14:03
修改于 2026-11-17 14:14:03
摘要: 安装成本低,不代表获客划算。本文从媒体归因、端内行为和同批用户的留存及购买入手,说明如何比较渠道质量、计算观察期内的 LTV 与回本表现,并据此调整投放和新客承接。
在企业数字化营销与用户增长的系统架构演进中,广告投放与获客归因一直是数据管线建设的关键场景。然而,从实际落地效果来看,许多企业的数据架构往往呈现出前后端严重脱节的状态:
一方面,市场投放团队每天在各大主流媒体平台投入大量预算,各大媒体的点击监测链接和第三方归因组件源源不断地产生点击、激活回调事件;另一方面,企业在云端数据仓库中沉淀了海量的用户在移动 App、小程序及 Web 端的行为流水(埋点日志、加购、履约、退款)。
由于两套系统在标识体系、数据时序与归因模型上缺乏统一设计,数据团队往往需要编写大量复杂的离线 ETL 脚本去缝合数据。这种架构不仅时效性差、维护成本高,而且无法支撑面向广告创意颗粒度的 30 天、60 天乃至 90 天长周期 LTV 与长线商业回报评估。
本文将结合现代云原生数据架构,探讨如何构建一套高可用、低延迟的全渠道广告归因与全生命周期价值分析数据管线。
一、全渠道广告数据接入与设备归因引擎设计
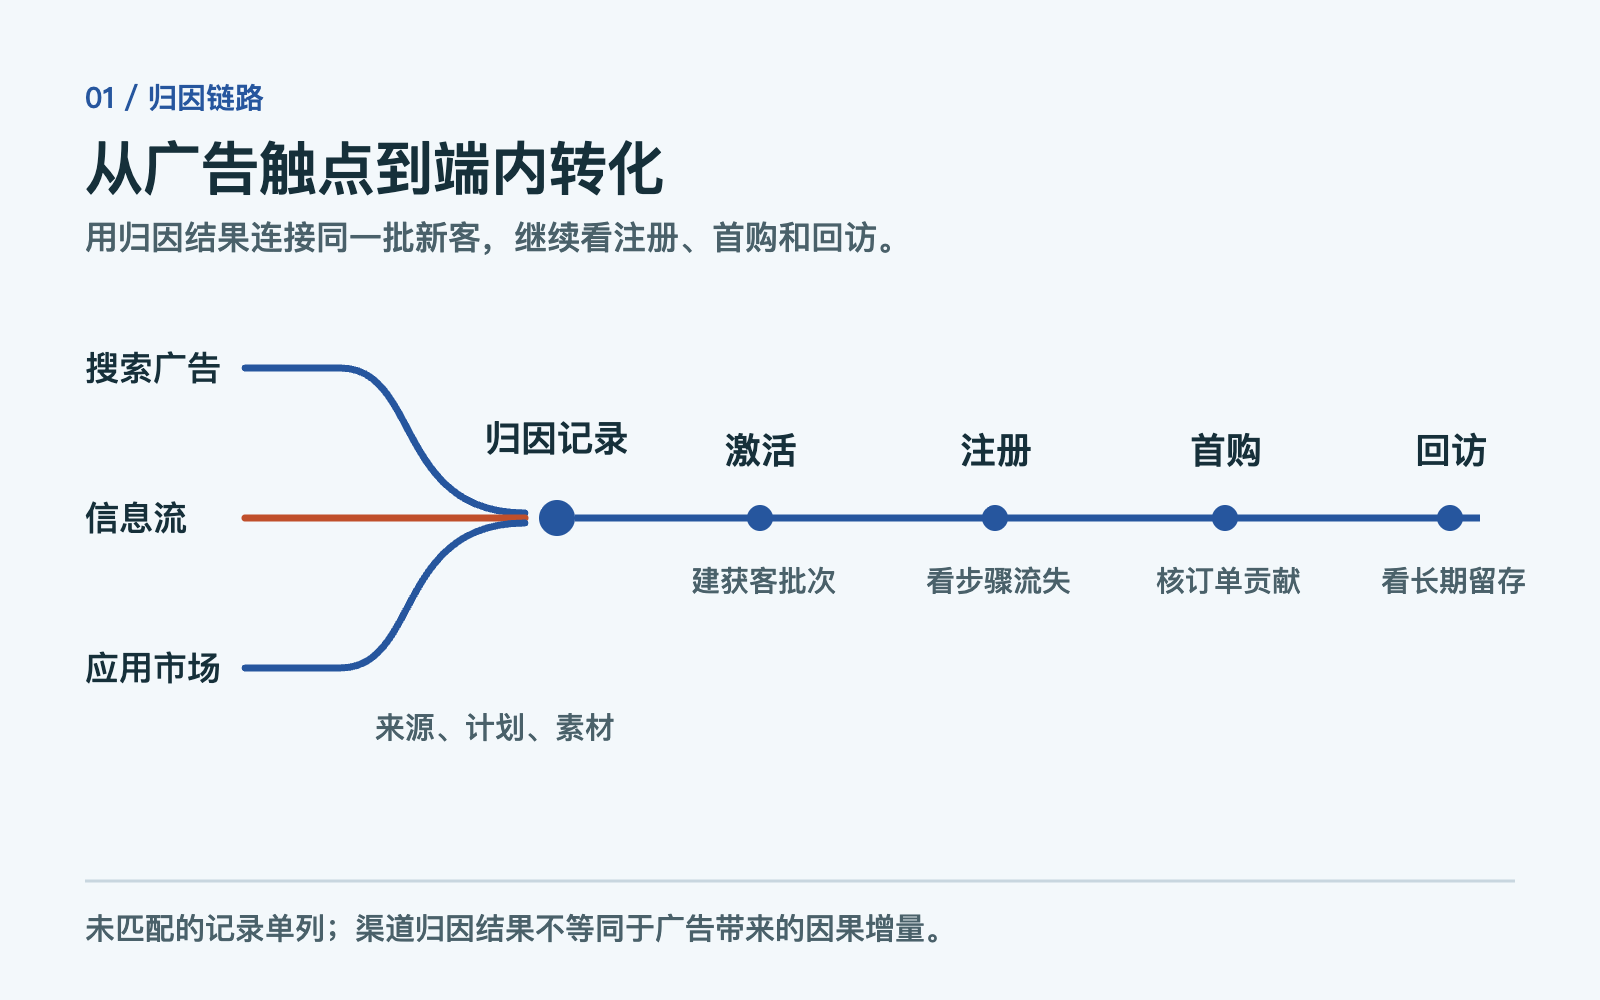
全链路分析管线的首要环节,是在数据接入层(Ingestion Layer)完成多媒体平台异构数据的统一抽取与客观公正的归因匹配。
1. 点击监测与回传数据的标准化数据湖接入
主流广告媒体平台在监测链接参数规范、宏参数命名与点击回调机制上存在较大差异。
在数据管线设计中,通常采用解耦的微服务或云函数架构:
- 点击参数标准化解析与入湖:统一接收来自主流媒体监测链接重定向或回调接口上报的点击事件,解析渠道、推广计划、广告组、创意素材及媒体允许传入且必要的关联字段;
- 数据湖标准化写入与去重:将各媒体点击数据进行标准化清洗,通过流式或微批方式写入云端对象存储或数据湖基座,采用以联合业务键为基准的幂等写入策略,解决点击重复上报导致的数据失准。
2. 设备标识与归因匹配算法
当广告端产生点击行为、端侧产生首次安装激活时,归因判定模块需要执行低延迟的时序关联计算:
[媒体端点击日志] ---> 分布式消息队列 (Clicks) ---> 分布式内存缓存 (时间窗口)
                                                                |
                                                          (归因匹配调度)
                                                                |
[端侧首次激活]   ---> 分布式消息队列 (Installs) ---> 触发归因匹配与规则判定
匹配引擎的核心判定逻辑分为两级:
- 确定性设备匹配:
- Android 端:优先匹配移动安全联盟标准匿名设备标识(OAID);
- iOS:按 ATT 授权状态使用允许的标识;未获授权时使用系统支持的聚合归因,不用其他标识替代个人级跟踪。
- 时序归因规则:
- 采用最后互动归因模型(Last Click Model),在预设的有效回溯窗口(如点击后 24 小时至 7 天)内,将激活事件归因于距离发生时间最近的有效点击;
- 归因完成后,系统生成唯一的归因全局记录,并异步触发端侧点击回调(Callback),将激活事件安全反传至对应媒体,为媒体出价算法提供样本支撑。
3. 多维度渠道质量矩阵与策略寻优算法
在归因数据入库后,数据计算引擎通过流批一体处理对各渠道表现进行多维量化:
- 四象限质量矩阵评估:结合各渠道带来的新增激活量、关键行为转化率与跨周期留存率,按预设阈值划分为高流高质、低流高质、高流低质与低流低质四个象限,为投放调优提供自动化分级依据;
- 计划与素材维度的下钻拆解:数仓支持将归因实体沿推广计划(Campaign)、广告组(Ad Group)及创意素材(Creative)层级向下穿透,自动计算出各策略组合的转化效能,为投放策略优化提供严谨的数据支撑。
二、架构融合:打破归因与端内时序行为的物理鸿沟
许多企业自建数据架构的痛点,在于归因服务与行为分析服务在物理上是两套独立的孤岛系统。
- 统一 ID Mapping 与元属性透传:
- 当用户首次激活时,端侧 SDK 生成全局唯一的匿名设备标识(
anonymous_id),并将归因判定生成的渠道来源、广告计划与素材属性写入该实体的基础维度表; - 用户后续完成注册或登录时,ID Mapping 服务在数仓底层将
anonymous_id与业务主键user_id自动关联,用户的后续全部行为轨迹天然具备初始获客的上下文信息;
- 当用户首次激活时,端侧 SDK 生成全局唯一的匿名设备标识(
- 多步转化漏斗的渠道下钻:
- 分析团队可以直接以渠道或素材为切片维度,拉取从“点击广告 -> 首次激活 -> 注册认证 -> 浏览商品 -> 加入购物车 -> 首单支付”的完整漏斗;
- 通过漏斗各节点的流失率比对,工程与业务团队能够精确评估各渠道带来的真实新客转化效率,及时淘汰“表面单价低、端内无转化”的劣质渠道。
三、渠道质量与长周期 LTV 评估模型的工程计算
不同渠道要按相同获客批次与观察天数比较,尚未满观察期的新客不直接计入。累计贡献按统一退款与成本口径计算,超过人均获客成本时才达到所定义的回本线。渠道归因用于解释来源分布,因果增量仍需对照实验等方法另行验证。
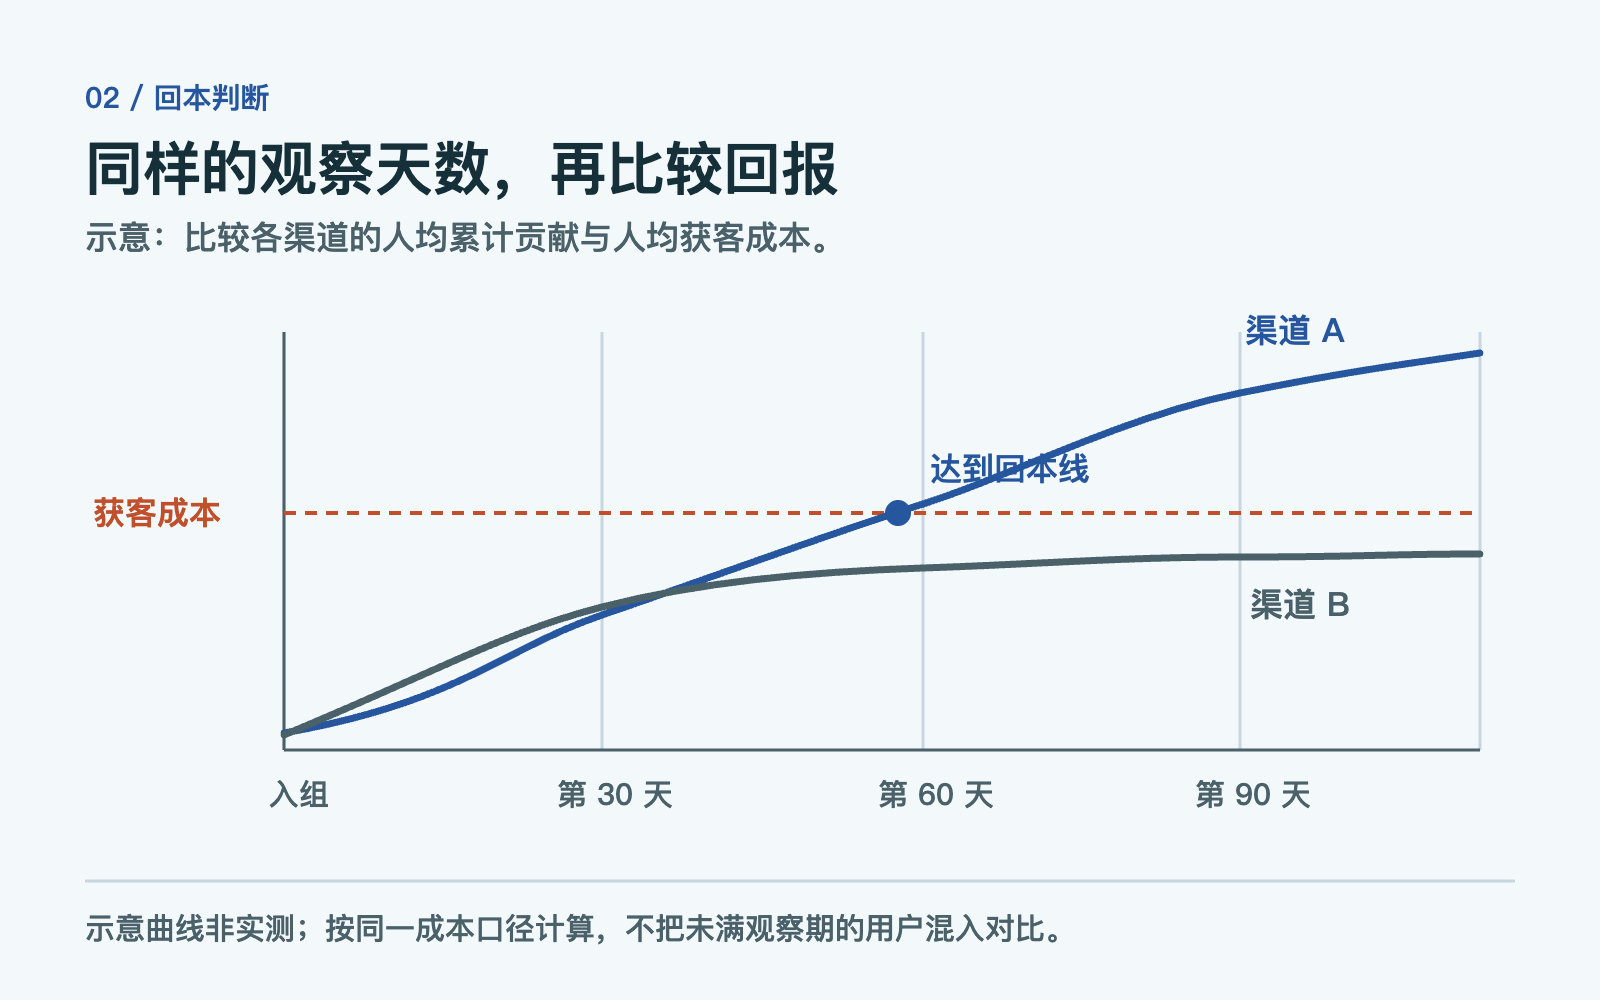
对渠道质量的评估,本质上是一个跨数据源的同群组时序聚合(Cohort-based Time-series Aggregation)问题。
1. 同群组累计 LTV 计算模型
按获客渠道与激活日建组。以净交易额衡量时,观察期内的人均累计 LTV = 组内用户累计净交易额 ÷ 入组用户数。分母包含未付费用户,净交易额按统一退款口径核算。
2. 渠道价值评估与回本周期模型
以毛利作为贡献口径时,先汇总同组订单毛利再除以入组用户数。将其与同批次的单客获客成本比较,第一次达到回本线的观察日即为按该口径计算的回本日;到窗口结束仍未达线,就记录为“观察期内未回本”。
在云端数仓的日常调度中,通过增量聚合任务每日更新 30 天、60 天、90 天的 Cohort 矩阵表,前端数据可视化模块即可实时渲染出各渠道的 LTV 与价值演变趋势,为精细化预算调优提供严谨的数据支撑。
四、双向闭环:深度转化数据向媒体广告算法的安全回传
将端内深层数据反哺给前端媒体算法,是广告工程实现从“人工策略调整”走向“自动化模型优化”的最后关键环节:
- 高阶转化事件采集与脱敏: 先核对媒体支持的事件、必要字段、授权与去重规则,再决定是否回传首购等转化信号。标识符经过哈希也不等于匿名,不直接同步内部客户画像;
- 高可用异步回传管线: 通过消息队列解耦端内业务系统与外部媒体接口,结合指数退避重试与死信队列机制,确保回传请求的高可靠交付;
- 效果回查: 比较变更前后各批次的获客成本与贡献;如果需要判断增量,预先安排对照实验。不要把媒体接受回传直接视为效果提升。
结语
在精细化运营与降本增效成为主旋律的今天,企业搭建广告归因分析系统已不再满足于简单的“激活统计”,而是要求实现全链路端到端的数据穿透。
通过将全渠道点击监测对接、中立归因算法、多维渠道质量评估与端内行为分析、数仓 Cohort 建模进行体系化拉通,企业能够彻底终结前后端数据扯皮的历史难题,建立起以真实商业 ROI 为核心驱动力的增长数据底座。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号