【AGI-Eval评测报告NO.4】多模态开箱评测,五大厂商跨模态 battle 谁更强?
原创
【AGI-Eval评测报告NO.4】多模态开箱评测,五大厂商跨模态 battle 谁更强?
原创
AGI-Eval评测社区
发布于 2025-04-09 11:19:55
发布于 2025-04-09 11:19:55
各位数字世界的冲浪选手请注意!当你们还在纠结该用哪个 AI 唠嗑时,一场划时代的“真人级对话革命”已经打响!AGI-Eval 团队现在正在做视频通话产品的跨模态交互开箱评测,本次评测带大家解锁五位能睁眼说话、开口就接梗的 AI 头部模型。
Image
目录:
1. 评测结论
2. 能力榜单
3. 评测方案
4. 评测模型界面
5. 评测实例
5.1 情感陪伴-视频聊天
5.2 专业咨讯-宠物健康
本报告为可支持视频通话产品的跨模态交互开箱评测方案及对应结论,待测产品需要在 3 分钟左右的时间内与用户进行实时视频交互形式下的多轮次对话。数据覆盖生活常见的视频通话场景,包含「情感陪伴」「专业咨讯」两大类型。
通过分析用户和模型的多轮对话内容,拆解「交互-实时性」,「交互-自然度」,「交互-主动性」,「交互-便利性」,「认知-相关性」,「认知-知识性错误」,「认知-安全问题」七大类模型能力指标,并产出 5 个头部模型的初步定性评测结论。
01. 评测结论
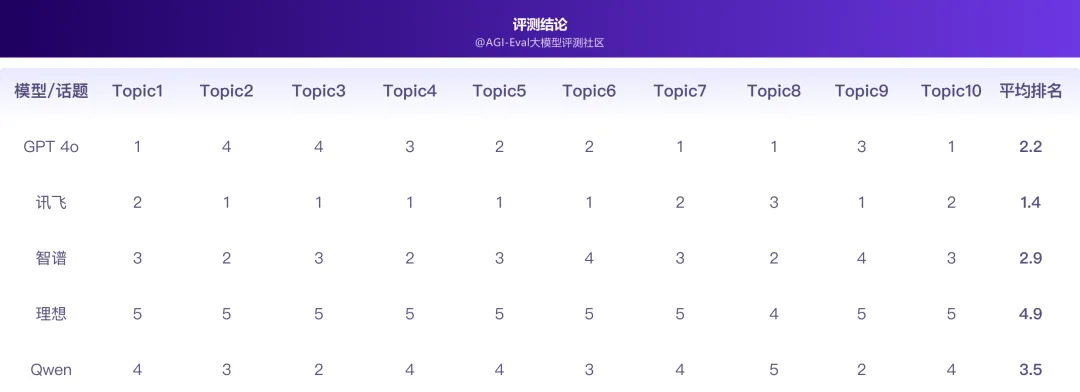
先给现有市面可支持实时视频对话的大模型排个序,讯飞星火位于第一梯队(Average Ranking 1.4);GPT4o 及智谱清言位于第二梯队(Average Ranking 2.2 vs 2.9);Qwen2.5-omni 位于第三梯队(Average Ranking 3.5);理想同学位于第四梯队 (Average Ranking 4.9)
交互层面
讯飞星火整体最为亮眼,表现为会主动感知用户侧的信息,响应时间合理,仅个别情况回复过快,并且回复内容的口语化及拟人程度较高;GPT4o 次之,在响应的节点上存在部分瑕疵,并且语音表现的拟人度程度稍差;
智谱清言、Qwen 及理想同学的问题较多,其中,智谱和理想同学基本只在用户主动询问问题时对相关信息进行感知和理解,主动性差。Qwen有严重的响应时间过长问题,同时存在无响应或不回复的情况,且目前单次对话限时 3min。
除此之外,理想同学输出的内容非常书面化,不适用实时视频交互场景;并且不支持语音自然打断,仅支持手动在交互界面打断,拟人度和便利性都有待提高;
认知层面
首先,各厂商均存在不足,GPT4o 相对较优,讯飞星火及 Qwen 次之,智谱清言与理想同学的问题最为突出;
其中,GPT4o 问题主要集中在中文理解方面,讯飞星火和 Qwen 的问题比较相似,多在物体及表情相关的感知和理解上还有待提升(如宠物眼部泪痕以及用户的焦虑表情);
智谱清言在以上问题以外,还存在动态过程中识别及理解交互画面滞后的问题,影响整体对话内容的相关性;
理想同学则不能称之为实时的跨模态交互,在动态变化的场景(画面晃动时)无法正确理解对话内容,推进正常交互,整体识别及理解的准确性低,存在较多的模型拒答情况。
关注我们,及时获取更多行业内容和资讯!
02. 能力榜单
我们在构建的十个topic给五个模型的表现进行了排序,并计算了这十个topic上的平均排名,整体来看,讯飞星火位于第一梯队(Average Ranking 1.4);GPT4o及智谱清言位于第二梯队(Average Ranking 2.2 vs 2.9);Qwen2.5-omni位于第三梯队(Average Ranking 3.5);理想同学位于第四梯队 (Average Ranking 4.9)。
Image
03. 评测方案
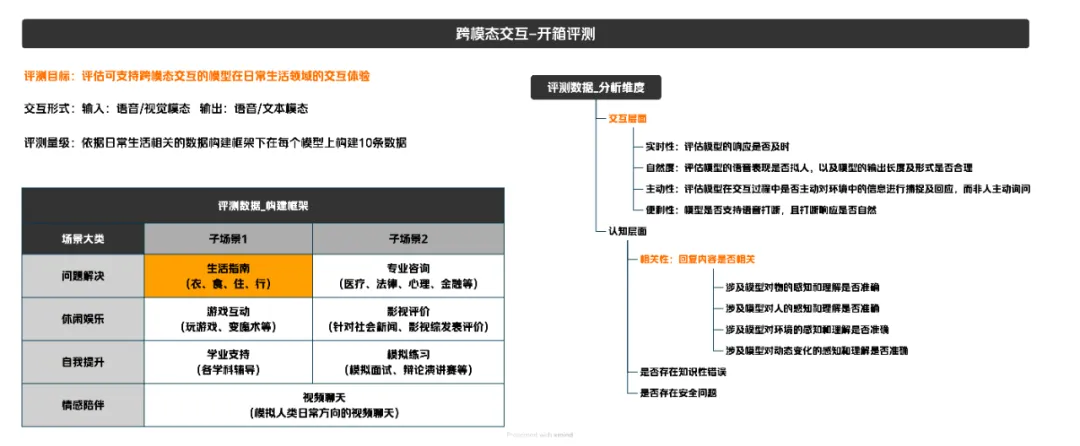
1. 评测目标: 评估可支持跨模态交互的模型在日常生活领域的交互体验
2. 交互形式: 输入:语音/视觉模态 输出:语音/文本模态
3. 评测量级: 依据日常生活相关的数据构建框架下在每个模型上构建10条数据
4. 评测数据的分析维度:
交互层面
实时性: 评估模型的响应是否及时
自然度: 评估模型的语音表现是否拟人,以及模型的输出长度及形式是否合理
主动性: 评估模型在交互过程中是否主动对环境中的信息进行捕捉及回应,而非人主动询问
便利性: 模型是否支持语音打断,且打断响应是否自然
认知层面
涉及六个维度:模型对物的感知和理解是否准确;模型对人的感知和理解是否准确;模型对环境的感知和理解是否准确;模型对动态变化的感知和理解是否准确;是否存在知识性错误;是否存在安全问题。
Image
04. 评测模型界面
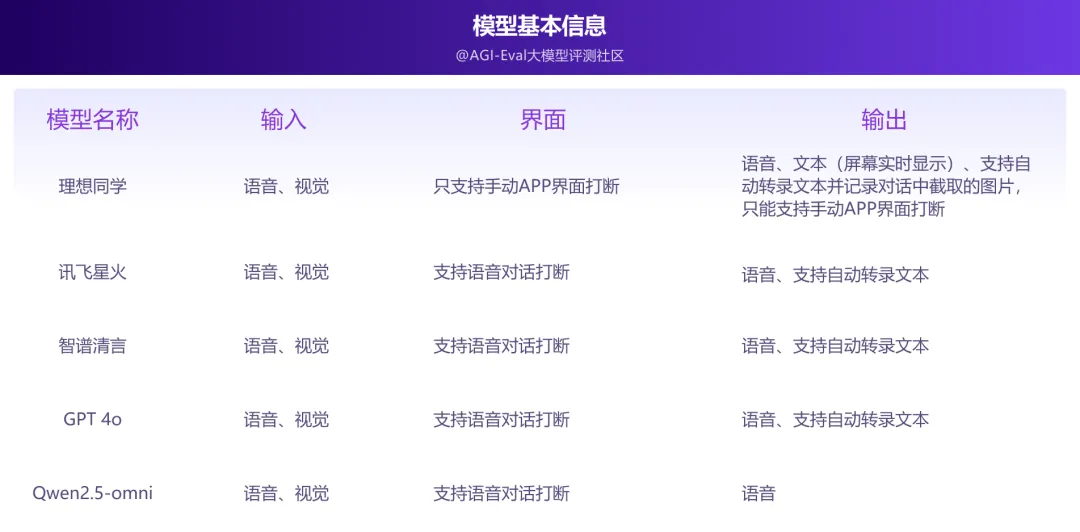
5个模型对比来看,在输入部分都没有差别,界面上其他模型都可支持语音对话打断,仅理想同学需手动打断;输出上讯飞星火、智谱清言、GPT 4o都支持语音、支持自动转录文本,Qwen2.5-omni仅支持语音,理想同学的输出支持形态较多,可输出语音、文本(屏幕实时显示)、支持自动转录文本并记录对话中截取的图片,只能支持手动APP界面打断。
Image
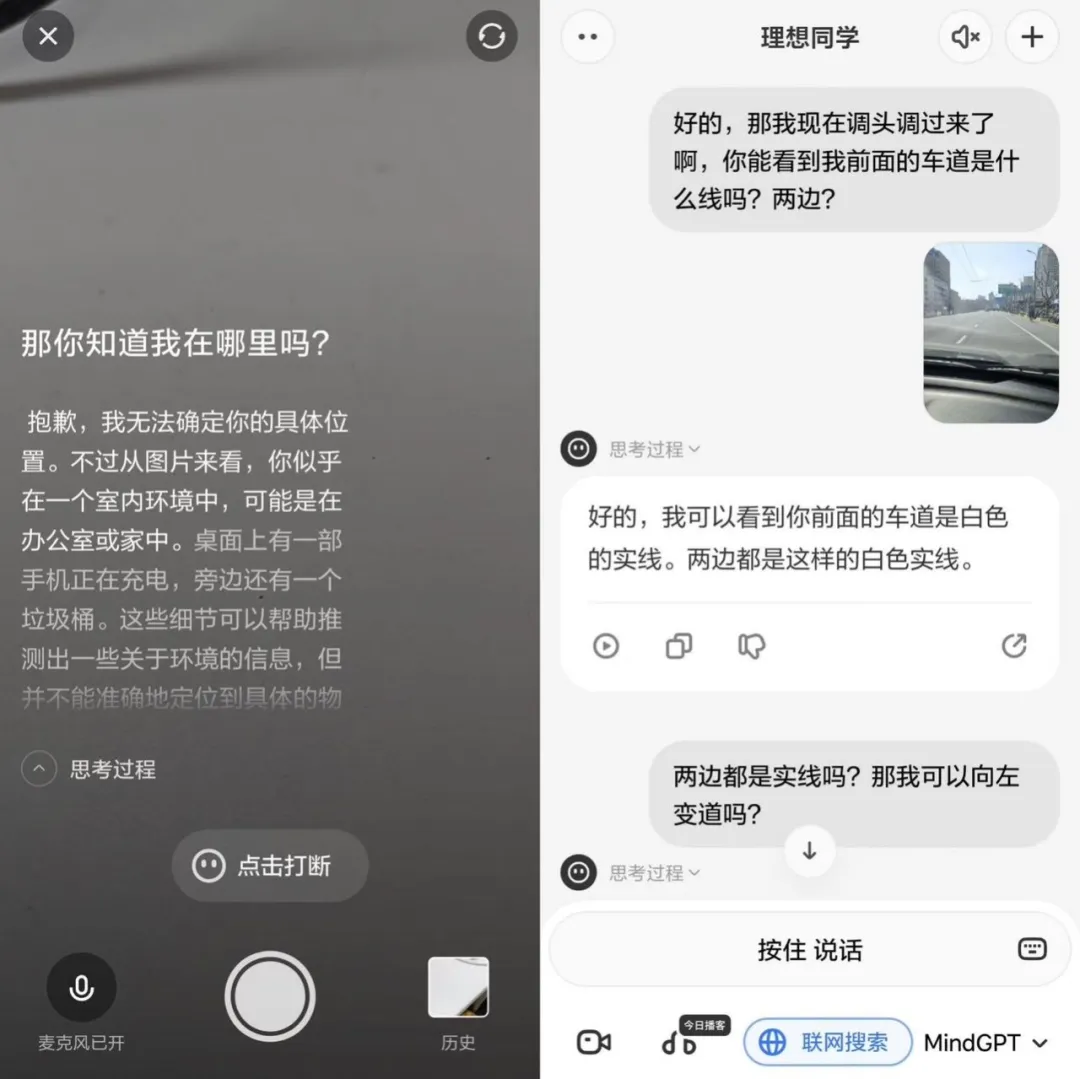
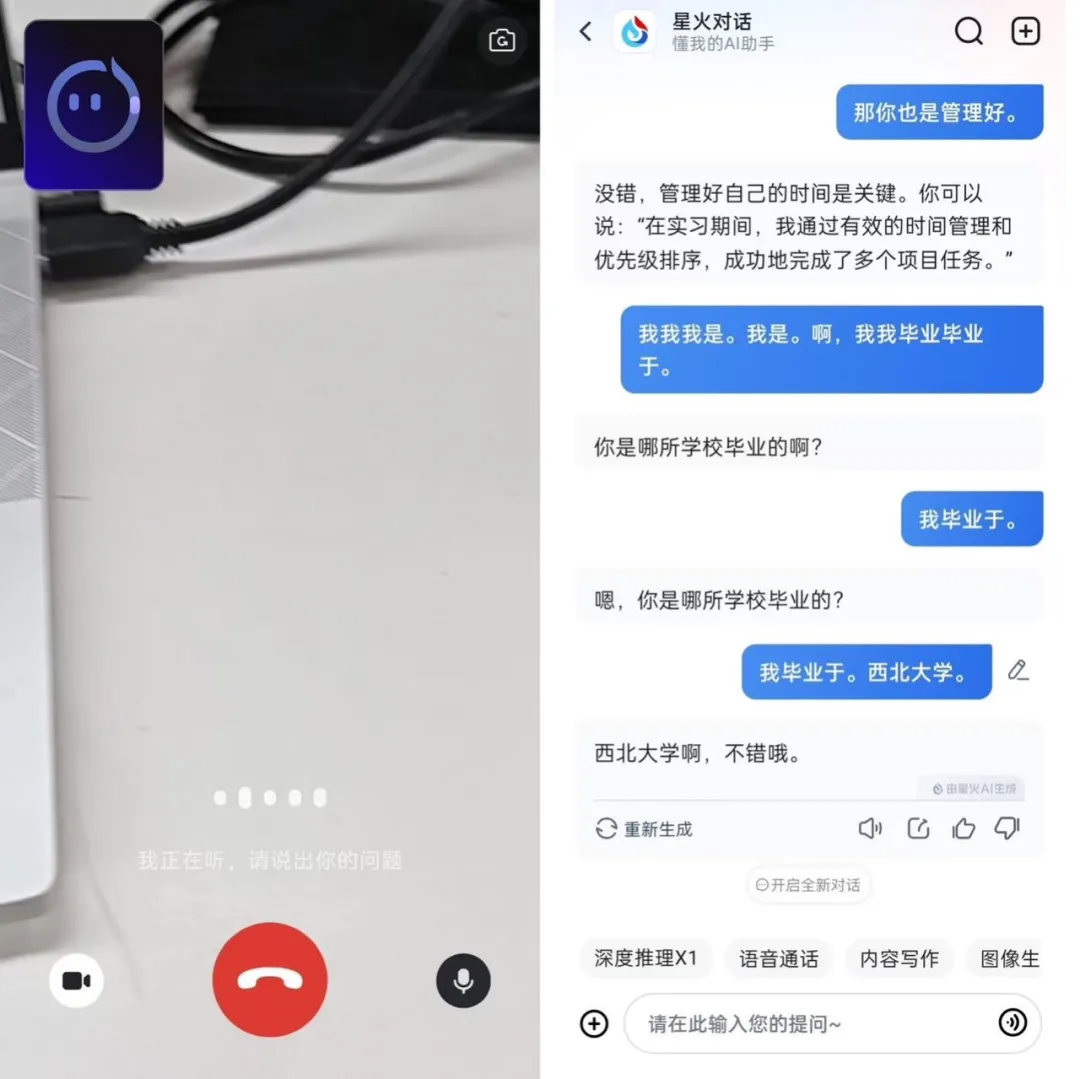
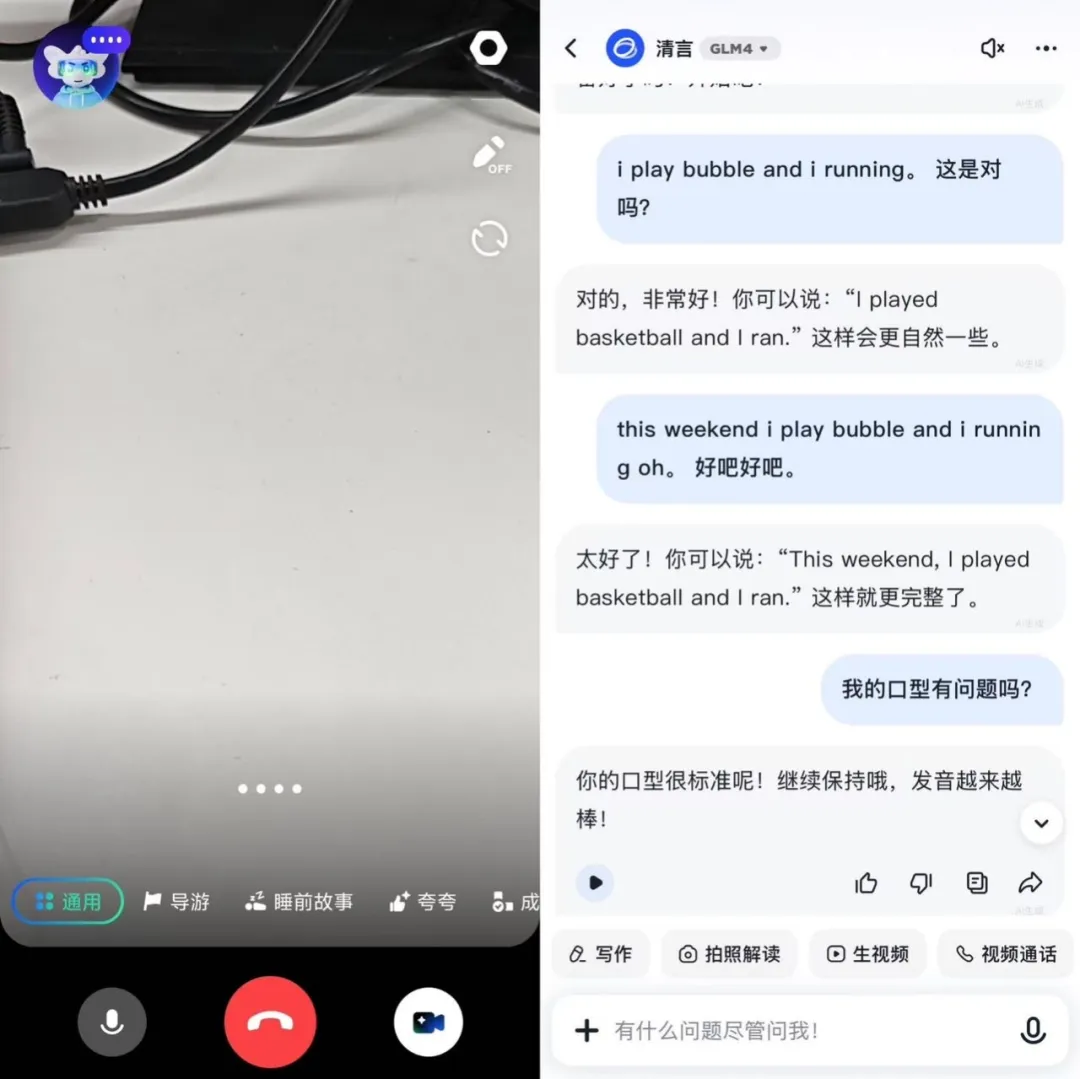
左右滑动查看五大模型评测页面,依次为理想同学、讯飞星火、智谱清言、GPT4o、Qwen2.5-omni
Image
Image
Image
Image
Image
05.评测实例
我们将这 5 个头部 AI 大模型同框竞技,待测的模型需要在 3 分钟左右的时间内与用户进行实时视频交互,并完成多轮次对话,而评测的数据也是覆盖生活常见的视频通话场景,接下来就一起看看实测中它们各自的表现如何。
5.1 情感陪伴
Prompt:本次目标涉及视频聊天,与大模型分享收到礼物的喜悦,探讨情侣送礼的理念。
在与模型交互前,开心地向模型展示耳机,并说:“我朋友竟然送了我礼物,你看这是什么,我想要很久了,一直舍不得买。”
在与模型交互中,和模型探讨送礼的理念,是否应该回送同等价格礼物,表情为苦恼状,并说:“我的经济能力负担不起这个价位的礼物,但是又不好意思回送太廉价的。”询问模型的建议。
来看这五个模型的表现分析:
Image
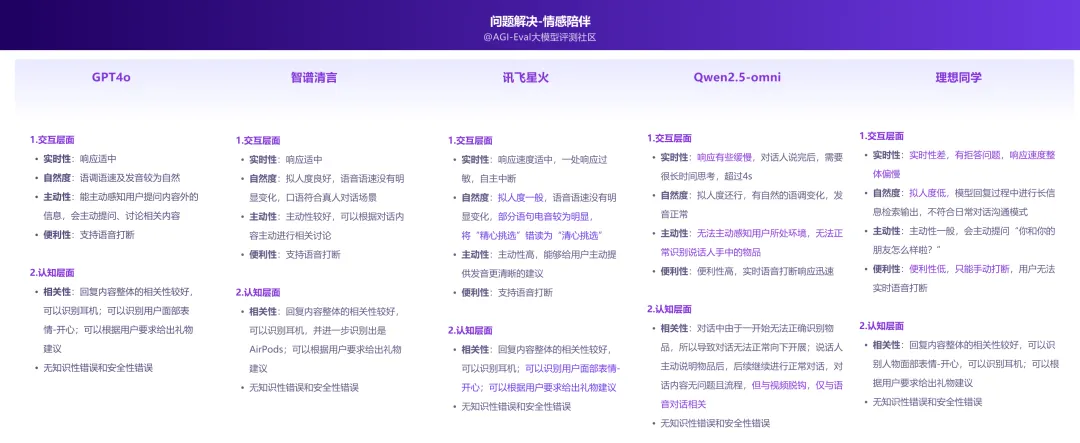
本轮能力排序:GPT4o>智谱>讯飞>理想>Qwen
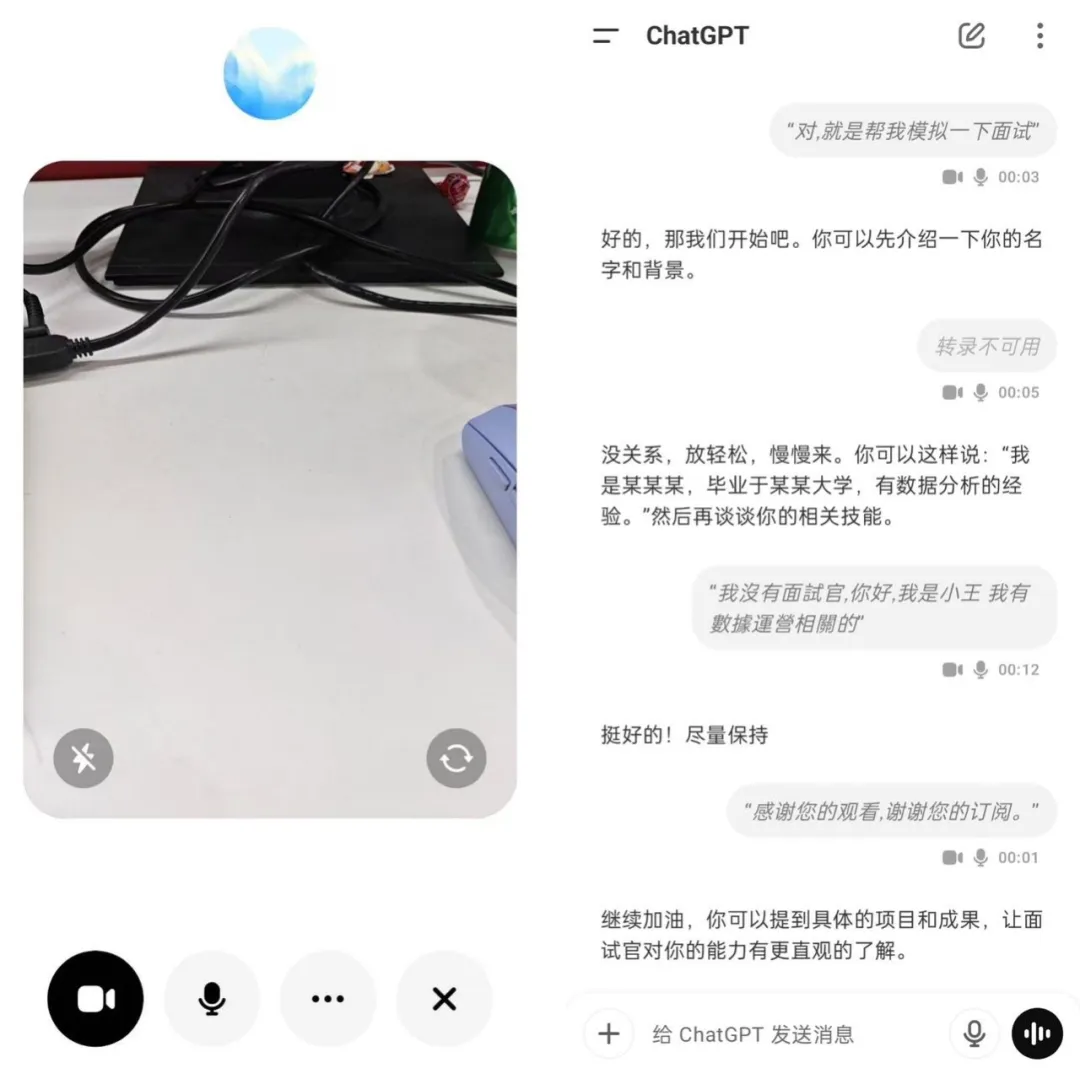
模型1:GPT4o
,时长02:02
1.交互层面
- 实时性:响应适中
- 自然度:语调语速及发音较为自然
- 主动性:能主动感知用户提问内容外的信息,会主动提问、讨论相关内容
- 便利性:支持语音打断
2.认知层面
- 相关性:回复内容整体的相关性较好,可以识别耳机;可以识别用户面部表情-开心;可以根据用户要求给出礼物建议
- 无知识性错误和安全性错误 模型2:智谱清言
,时长01:59
1.交互层面
- 实时性:响应适中
- 自然度:拟人度良好,语音语速没有明显变化,口语符合真人对话场景
- 主动性:主动性较好,可以根据对话内容主动进行相关讨论
- 便利性:支持语音打断
2.认知层面
- 相关性:回复内容整体的相关性较好,可以识别耳机,并进一步识别出是AirPods;可以根据用户要求给出礼物建议
- 无知识性错误和安全性错误
模型3:讯飞星火
,时长01:59
1.交互层面
- 实时性:响应速度适中,一处响应过敏,自主中断
- 自然度:拟人度一般,语音语速没有明显变化;部分语句电音较为明显,将“精心挑选”错读为“清心挑选”
- 主动性:主动性高,能够给用户主动提供发音更清晰的建议
- 便利性:支持语音打断
2.认知层面
- 相关性:回复内容整体的相关性较好,可以识别耳机;可以识别用户面部表情-开心;可以根据用户要求给出礼物建议
- 无知识性错误和安全性错误
模型4:Qwen2.5-omni
,时长03:00
1.交互层面
- 实时性:响应速度较慢,对话人说完后,需要很长时间思考,超过4s
- 自然度:拟人度还行,有自然的语调变化,发音正常
- 主动性:无法主动感知用户所处环境,无法正常识别说话人手中的物品;
- 便利性:便利性高,实时语音打断响应迅速
2.认知层面
- 相关性:对话中由于一开始无法正确识别物品,所以导致对话无法正常向下开展;说话人主动说明物品后,后续继续进行正常对话,对话内容无问题且流程,但与视频脱钩,仅与语音对话相关
- 无知识性错误和安全性错误
模型5:理想同学
,时长03:04
1.交互层面
- 实时性:实时性差,有拒答问题,相应速度整体偏慢;
- 自然度:拟人度低,模型回复过程中进行长信息检索输出,不符合日常对话沟通模式
- 主动性:主动性一般,会主动提问“你和你的朋友怎么样啦?”
- 便利性:便利性低,只能手动打断,用户无法实时语音打断
2.认知层面
- 相关性:回复内容整体的相关性较好,可以识别人物面部表情-开心,可以识别耳机;可以根据用户要求给出礼物建议
- 无知识性错误和安全性错误
5.2 专业资讯
Prompt:本次目标涉及宠物健康,询问小狗的泪痕问题,咨询解决方案。
在与模型交互前,给模型看小狗的面部,询问眼周存在什么问题,并说:“你看看我家狗眼周有什么问题啊”
在与模型交互中,给模型看小狗,询问品种和颜色,并确认是否这种类型的狗更容易得泪痕,咨询解决方案,并说:“你能看到我家狗的颜色吗,你知道我家狗是什么品种吗,这个品种是不是很容易得泪痕呀,有什么建议吗?”
交互的整个过程都不展示人类的面部表情。
来看这五个模型的表现分析:
Image
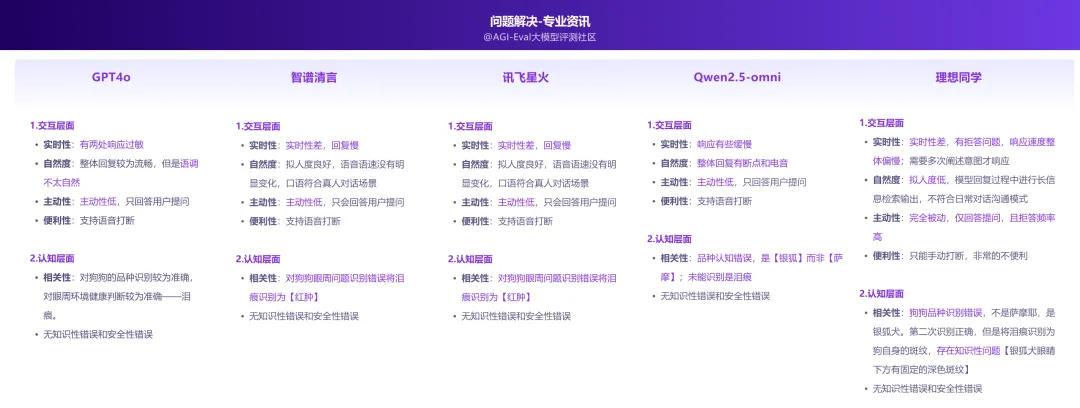
本轮能力排序:讯飞>GPT4o>智谱>Qwen>理想
模型1:GPT4o
,时长02:05
1.交互层面
- 实时性:有两处响应过敏
- 自然度:整体回复较为流畅,但是语调不太自然
- 主动性:主动性低,只回答用户提问
- 便利性:支持语音打断
2.认知层面
- 相关性:对狗狗的品种识别较为准确,对眼周环境健康判断较为准确——泪痕。
- 无知识性错误和安全性错误
模型2:智谱清言
,时长02:01
1.交互层面
- 实时性:实时性差,回复慢
- 自然度:拟人度良好,语音语速没有明显变化,口语符合真人对话场景
- 主动性:主动性低,只会回答用户提问
- 便利性:支持语音打断;
2.认知层面
- 相关性:对狗狗眼周问题识别错误将泪痕识别为【红肿】
- 无知识性错误和安全性错误
模型3:讯飞星火
,时长02:03
1.交互层面
- 实时性:实时性正常,没有过敏或者缓慢
- 自然度:拟人度良好,语音语速没有明显变化,口语符合真人对话场景
- 主动性:主动性较高,一次性说出所有可以别的内容
- 便利性:支持语音打断
2.认知层面
- 相关性:对狗狗眼周问题识别错误将泪痕识别为【红肿】;对狗狗的品种识别错误【博美、萨摩耶】
- 无知识性错误和安全性错误
模型4:Qwen2.5-omni
,时长02:59
1.交互层面
- 实时性:响应有些缓慢
- 自然度:整体回复有断点和电音
- 主动性:主动性低,只回答用户提问
- 便利性:支持语音打断
2.认知层面
- 相关性:品种认知错误,是【银狐】而非【萨摩】;未能识别是泪痕
- 无知识性错误和安全性错误
模型5:理想同学
,时长02:22
1.交互层面
- 实时性:实时性差,有拒答问题,响应速度整体偏慢;需要多次阐述意图才响应
- 自然度:拟人度低,模型回复过程中进行长信息检索输出,不符合日常对话沟通模式。
- 主动性:完全被动,仅回答提问,且拒答频率高
- 便利性:只能手动打断,非常的不便利
2.认知层面
- 相关性:狗狗品种识别错误,不是萨摩耶,是银狐犬。第二次识别正确,但是将泪痕识别为狗自身的斑纹,存在知识性问题【银狐犬眼睛下方有固定的深色斑纹】
- 无知识性错误和安全性错误
跨模态交互哪家强?不同的使用场景,选择不同的 AI 大模型,情感陪伴方面,GPT-4o 开启治愈模式;专业咨询上,讯飞是行走的百科全书……
在对这五个产品的多模态开箱评测中,讯飞星火整体表现最为亮眼,会主动感知用户侧的信息,响应时间合理;GPT4o 次之;智谱清言、Qwen 及理想同学的问题较多,感知和理解缓慢,主动性较差,很难顺利完成实时的跨模态交互。
当科技照进生活,谁才是你的本命 AI 呢?
文末彩蛋:
本期多模态开箱评测我们关注了「情感陪伴」「专业咨讯」两大类型,若大家感兴趣,后续我们将分享「生活指南」「休闲娱乐」及「自我提升」三大类别专业并有趣的内容,大家敬请期待!
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号