大模型核心技术深度总结:模型预训练、微调、量化、剪枝、蒸馏的核心差异与适用场景22.2
原创
大模型核心技术深度总结:模型预训练、微调、量化、剪枝、蒸馏的核心差异与适用场景22.2
原创
未闻花名
发布于 2026-09-11 07:57:38
发布于 2026-09-11 07:57:38
一、前言
基本我们入门大模型开发,都是从简单的接口调用开始,循序渐进接触到各类核心技术。最开始只需直接使用现成通用模型,无需关注模型底层逻辑。但如果想要贴合自身业务做定制开发,就会接触到微调技术,解决模型专业性不足的问题。
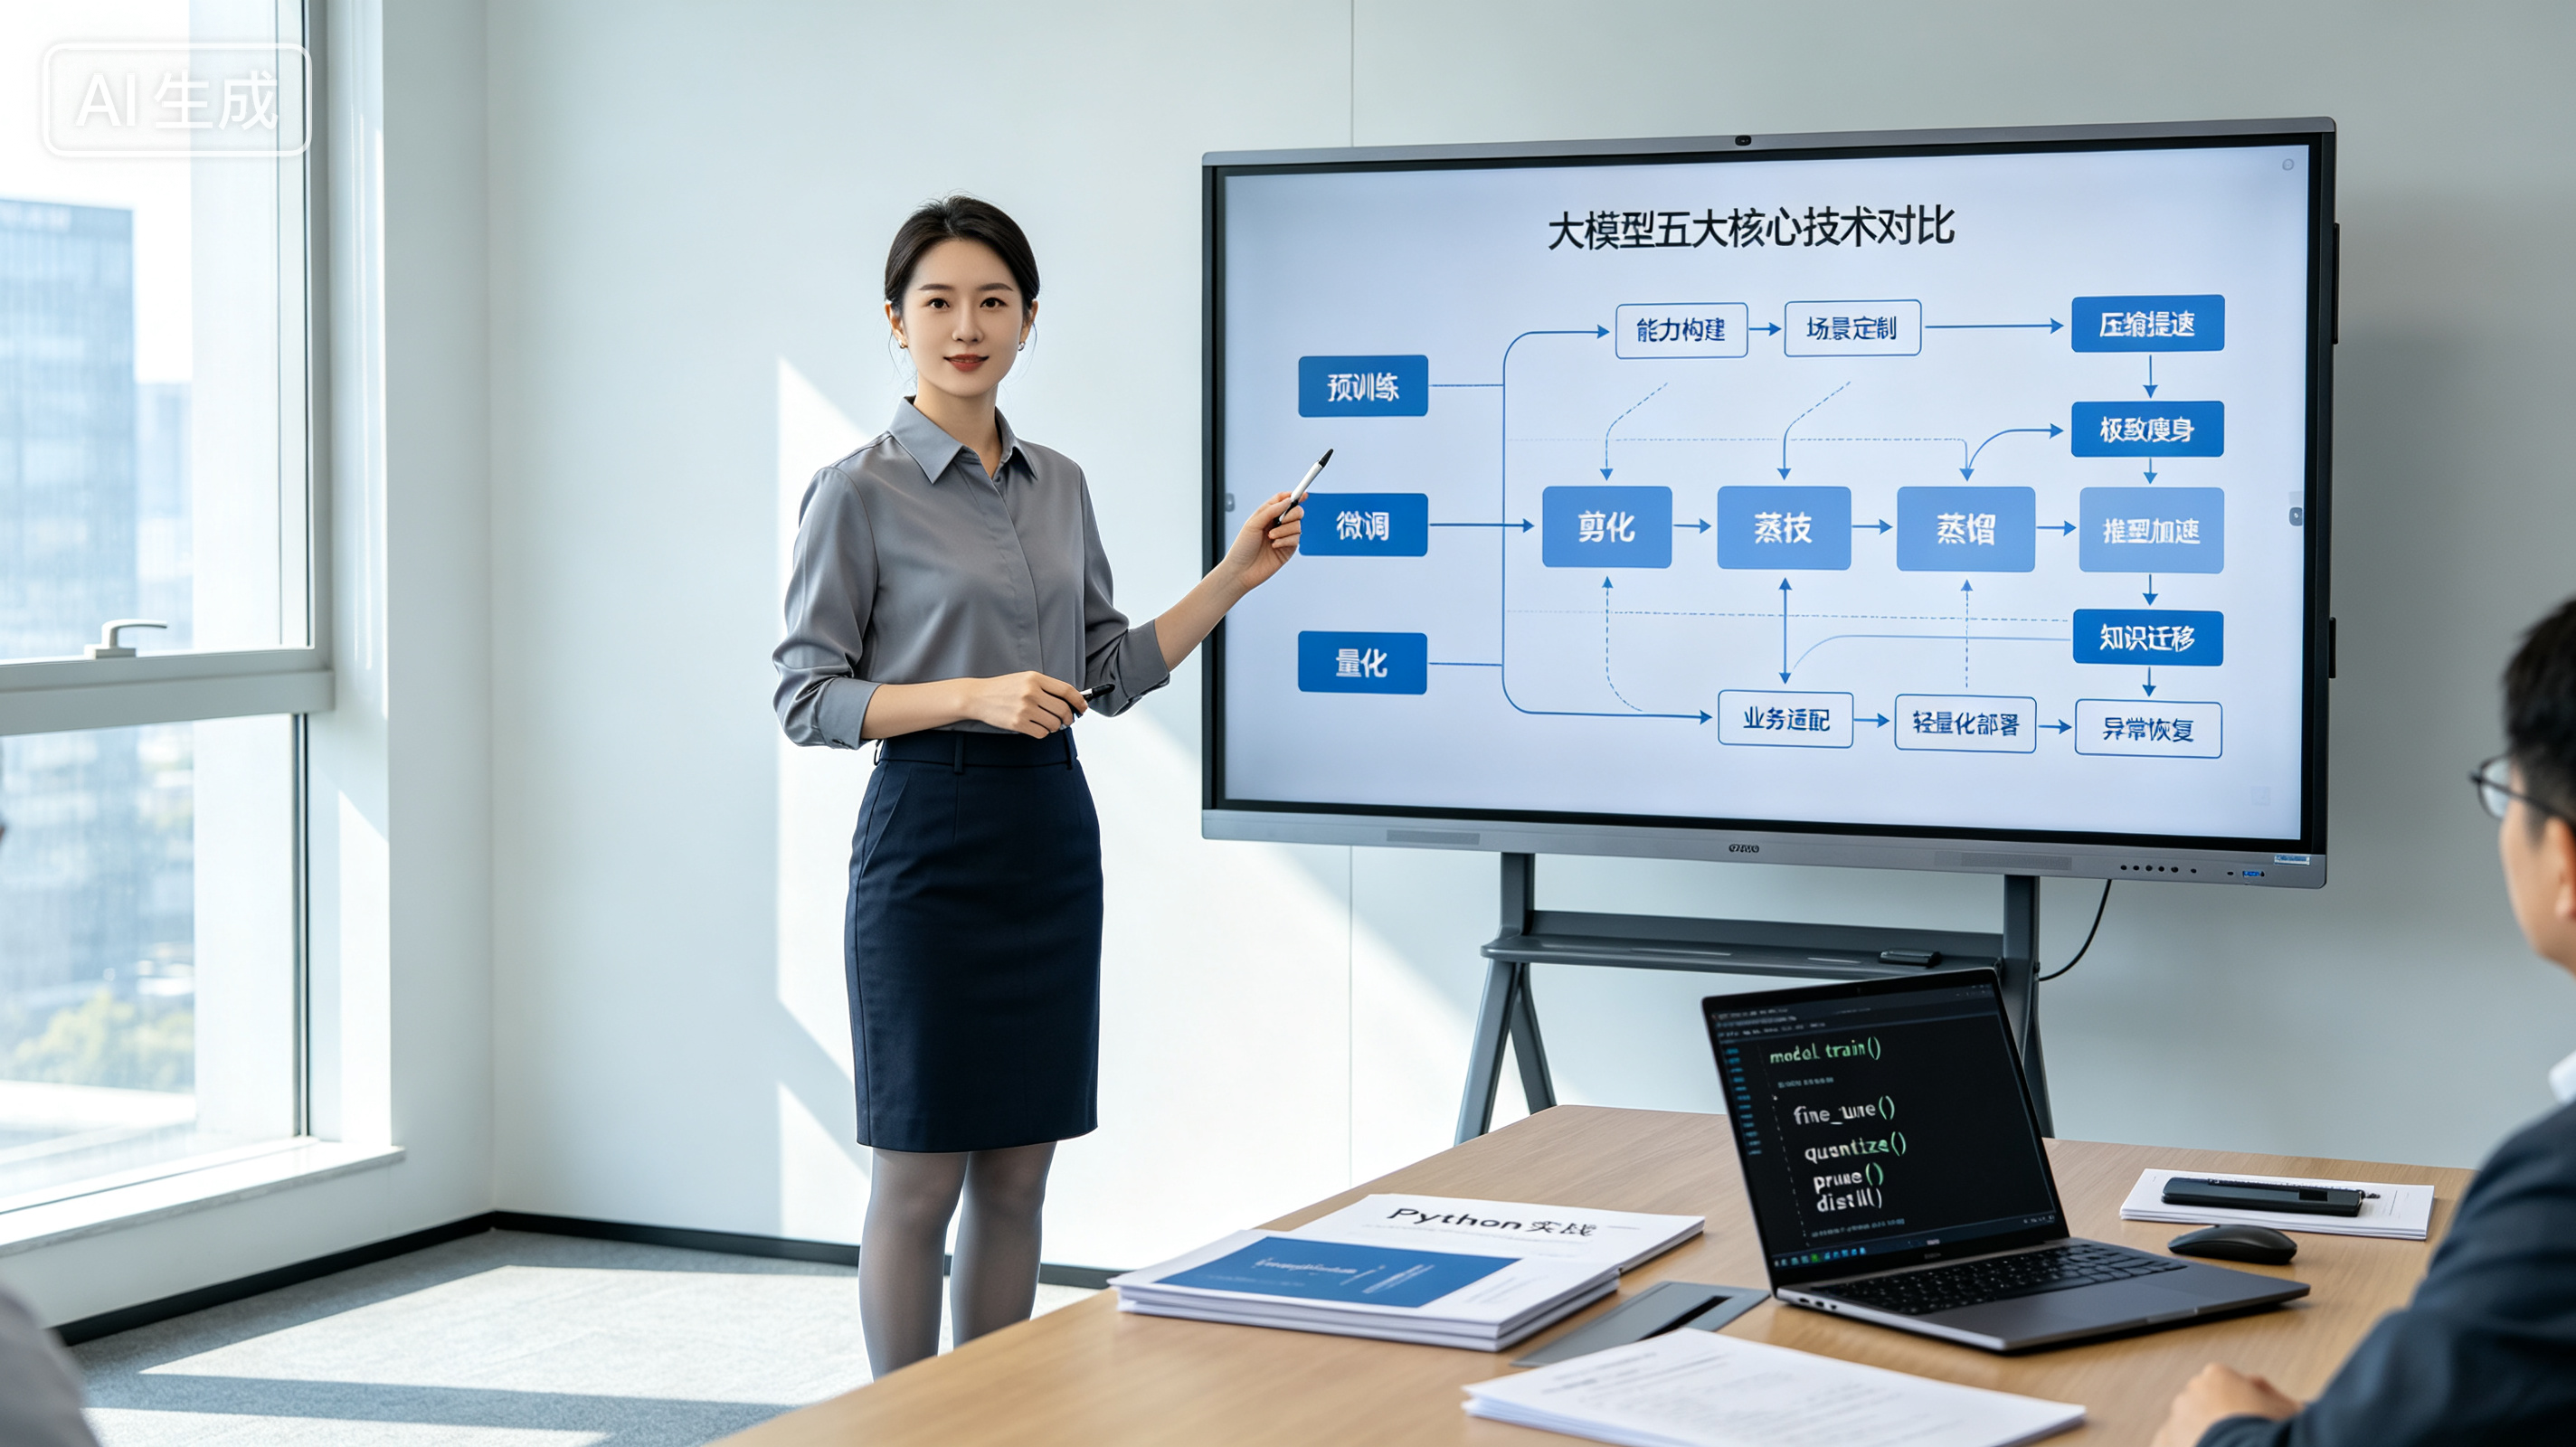
当模型开发落地、部署上线时,又会遇到新问题:模型体积庞大、推理速度慢、普通设备承载困难。为了解决落地痛点,大家会陆续接触量化、剪枝、蒸馏等轻量化优化手段。在不断摸索中,最终才会明白预训练是所有大模型的能力底座,是一切优化的前提。这几项技术极容易混淆,分不清各自作用、适用场景和执行顺序。其实它们各司其职,完整覆盖大模型从诞生、定制优化到轻量化部署的全流程。今天我们循序渐进拆解各项技术核心逻辑、实战差异与联动关系,理清大模型完整落地链路。
二、预训练构建能力底座
1. 基础定义
预训练是大模型能力的基石,是大模型从无到有的核心研发环节,对应AI的通识学习阶段:
- 核心定位:预训练是大模型的初始诞生环节,也是所有大模型能力的基础,相当于给AI完成“通识教育”。
- 核心定义:指在无标注的海量通用数据上,通过大规模迭代训练,让模型自主学习语言规律、知识体系、逻辑思维和基础认知能力的训练过程。
- 核心价值:我们日常用到的GPT、文心一言、通义千问等底座大模型,核心能力全部来自预训练。没有预训练,后续的微调、优化、落地都无从谈起,它是大模型一切能力的根源。
2. 核心原理
预训练全程采用自监督学习模式,无需人工标注数据,依靠海量通用数据迭代更新模型参数,完整原理拆解:
- 核心逻辑:预训练的核心原理可概括为三点,海量数据、通用任务、反复迭代,整体采用自监督学习模式,无需人工标注数据,大幅降低数据成本。
- 主流训练任务:以LLM常见的“掩码预测”“下一词预测”为主。通过给模型输入不完整文本,让模型依据上下文推理缺失内容,在海量数据迭代中自主学习语法、语义、常识与基础推理规律。
- 本质过程:预训练本质是模型海量参数的初始化固化过程。模型通过持续修正权重参数,拟合人类语言与知识体系,最终形成具备通用理解、生成、推理能力的底座模型,参数量、数据量、迭代步数直接决定模型底子扎实程度。
简单通俗拆解:
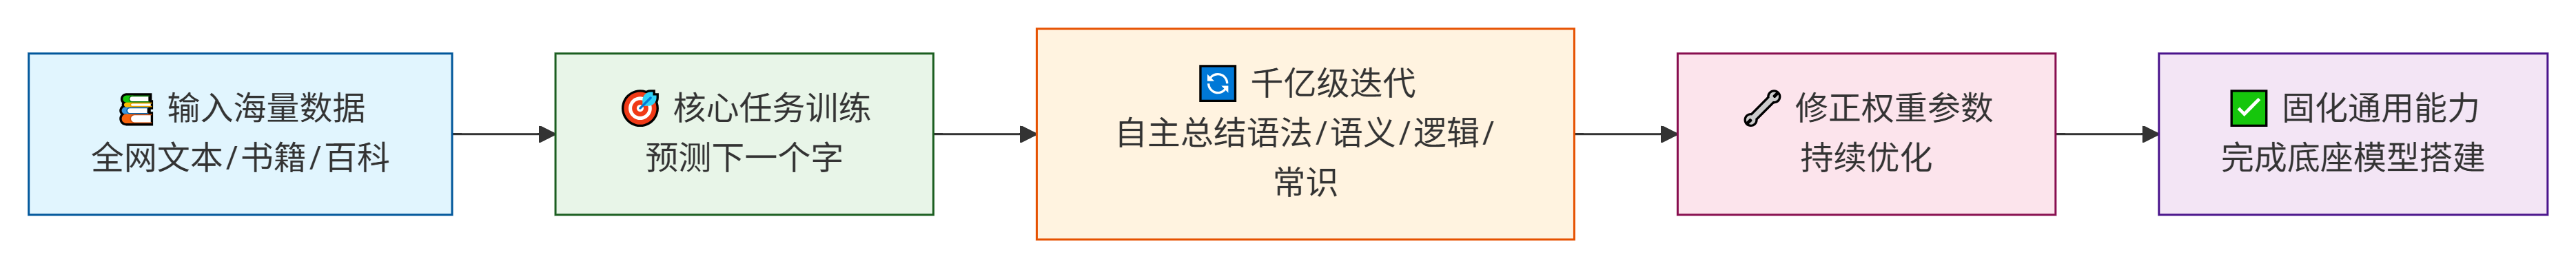
- 给模型输入海量全网文本、书籍、百科数据,以“预测下一个字”为核心任务持续训练。
- 千亿级数据反复迭代中,模型自主总结语法规则、语义逻辑、基础常识与简单推理能力。
- 不断修正权重参数,最终固化通用能力,完成底座模型搭建。
3. 主要特点
预训练作为大模型底座搭建环节,具备高成本、强通用、无专精、一次性落地的鲜明特点:
- 成本极高:预训练需要海量无标注数据、高端GPU集群、超长训练周期,算力、资金、时间成本都是所有环节中最高的,普通企业和个人几乎无法独立完成。
- 通用性最强:训练数据覆盖全网文本、百科、书籍、文章等,模型具备通用对话、知识问答、基础推理能力,适配绝大多数通用场景。
- 能力泛化但不精准:模型什么都懂,但没有垂直领域专精能力,面对行业专属场景、定制化需求时,输出内容容易笼统、出错、不贴合业务。
- 一次性打底:预训练是一次性基础工作,底座模型训练完成后,不会反复重做,后续所有优化都基于预训练模型展开。
4. 适用场景
适用场景:
- 仅适用于头部科技企业、科研机构的底座大模型自研研发。
- 用于打造通用基础大模型,为全行业场景提供通用AI能力底座。
- 普通开发者、中小企业无需自研预训练,直接复用开源、商用预训练模型即可。
核心局限:
- 通用能力有余,专业能力不足,无垂直行业专属知识与业务适配能力。
- 无法直接落地定制化业务场景,输出内容易笼统、不专业、贴合度低。
- 模型体积庞大、算力消耗极高,无法部署在终端、轻量化设备上。
5. 实践示例
完整千亿参数预训练门槛极高,这里提供小模型预训练极简示例,模拟大模型自监督预训练核心逻辑,即进行下一词的预测,适配本地运行,理解预训练底层逻辑。
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM
from datasets import load_dataset

# 1. 加载开源底座权重与分词器(模拟预训练初始化权重)
model_name = "gpt2"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
tokenizer.pad_token = tokenizer.eos_token

# 2. 加载通用文本数据集(无标注自监督数据)
dataset = load_dataset("tiny_shakespeare", split="train[:1%]")

# 3. 数据预处理:适配下一词预测预训练任务
def preprocess_func(examples):
    return tokenizer(examples["text"], truncation=True, max_length=128, padding="max_length")

tokenized_data = dataset.map(preprocess_func, batched=True)
tokenized_data.set_format("torch", columns=["input_ids", "attention_mask"])

# 4. 模拟预训练迭代(自监督学习,无人工标签)
model.train()
optimizer = torch.optim.AdamW(model.parameters(), lr=5e-5)
for step, batch in enumerate(tokenized_data):
    batch = {k:v.unsqueeze(0) for k,v in batch.items()}
    output = model(**batch, labels=batch["input_ids"])
    loss = output.loss
    loss.backward()
    optimizer.step()
    optimizer.zero_grad()
    if step % 10 == 0:
        print(f"预训练迭代step:{step}, 损失值:{loss.item():.4f}")
重点说明:
- 基于无标注通用文本数据,采用自监督学习模式,无需人工标注。
- 以下一词预测为核心任务,迭代更新模型权重参数。
- 完整复刻商用大模型预训练底层逻辑,仅缩减模型与数据规模,适配本地调试。
- 迭代完成后,模型具备基础文本生成、语义理解等通用能力。
三、微调定制应用场景
1. 基础定义
微调是预训练模型落地业务的核心定制手段,是在通用底座基础上做专项优化,可通俗理解为AI的职业专项培训:
- 基础前提:基于成熟的预训练底座模型开展,不从零训练模型。
- 核心操作:使用少量垂直领域高质量标注数据,对模型参数进行二次迭代训练。
- 核心作用:保留模型通用通识能力,针对性补齐行业专属知识、业务话术与输出规范。
- 解决问题:彻底解决通用大模型不专业、不贴合业务、输出笼统易错的痛点。
2. 核心原理
微调核心逻辑为保留通识,精进专项,无需重复学习基础语言能力,专注适配业务场景,核心原理拆解:
- 能力留存:预训练模型已掌握语法、常识、通用推理能力,微调全程保留该基础能力。
- 专项学习:通过垂直领域标注数据,引导模型学习行业专属知识、业务规则、输出风格。
- 参数更新:小幅修正模型权重参数,让模型输出逻辑优先适配目标业务场景。
- 全量微调:更新模型全部参数,场景适配精度最高、效果最优,但算力成本高、易出现过拟合,适合高精度专业场景。
- 参数高效微调(PEFT):仅更新少量增量参数,冻结底座核心权重,算力成本极低、训练速度快、不易过拟合,是工业界主流落地方案。
3. 主要特点
微调是轻量化、高灵活度的模型定制技术,是业务落地必备环节,主要特点:
- 低成本高效率:无需海量数据与高端算力,仅需少量垂直标注数据,普通设备即可完成训练,个人、中小企业均可落地。
- 场景适配精准:可针对性适配行业业务规则、专属话术、专业知识,大幅提升模型输出准确率与贴合度。
- 能力双向保留:合理微调不会丢失模型通用对话、推理、通识能力,实现“通用能力+专业能力”双重适配。
- 定制灵活度高:可根据业务迭代需求随时微调更新,快速适配新规则、新话术、新业务场景。
4. 适用场景
适用场景:
- 所有大模型垂直业务落地场景,是定制化AI开发的必经步骤。
- 典型场景:企业智能客服、行业知识库问答、法律文书生成、医疗咨询、教育答疑、专属办公助手等。
核心局限:
- 仅优化模型输出效果,只提效果,不减体积,无法改变模型大小与算力消耗。
- 微调后模型依然体量庞大,存在推理卡顿、硬件要求高、部署难度大的问题,需搭配轻量化技术优化。
5. 实践示例
采用主流PEFT-LoRA参数高效微调,仅训练少量增量参数、不破坏底座通用能力,低算力、防过拟合,适配企业业务落地。
from transformers import AutoModelForCausalLM, AutoTokenizer
from peft import LoraConfig, get_peft_model
import torch

# 1. 加载预训练底座模型
model_name = "gpt2"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
tokenizer.pad_token = tokenizer.eos_token

# 2. 配置LoRA微调参数(高效微调核心)
lora_config = LoraConfig(
    r=8,
    lora_alpha=16,
    target_modules=["c_attn"],
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM"
)

# 3. 注入微调参数,冻结原模型权重
model = get_peft_model(model, lora_config)
model.print_trainable_parameters()

# 4. 模拟垂直场景微调数据(客服问答数据)
train_texts = [
    "用户:如何查询订单?助手:您可以进入个人中心,点击我的订单即可查询。",
    "用户:如何申请退款?助手:找到对应订单,点击申请退款,审核通过后原路返回资金。"
]

# 5. 微调训练流程
inputs = tokenizer(train_texts, truncation=True, padding=True, return_tensors="pt")
outputs = model(**inputs, labels=inputs["input_ids"])
loss = outputs.loss
loss.backward()
print(f"微调训练损失:{loss.item():.4f}")

# 6. 微调后推理测试
model.eval()
test_input = tokenizer("用户:怎么退款?", return_tensors="pt")
res = tokenizer.decode(model.generate(**test_input, max_length=50)[0], skip_special_tokens=True)
print("微调后应答:", res)
重点说明:
- 全程冻结预训练底座权重,仅训练少量LoRA增量参数,算力开销极低。
- 基于垂直客服数据训练,让模型适配专属业务应答逻辑。
- 训练后可精准响应业务问题,同时保留模型原生通用能力。
四、量化实现精度瘦身
1. 基础定义
量化是大模型落地部署的基础轻量化技术,主打无损压缩、快速提速,是所有工业部署的首选方案,核心定义:
- 核心本质:降低模型参数的存储精度,精简数据存储与计算格式。
- 操作特点:不删除参数、不修改模型结构、不改变模型核心能力。
- 核心目标:在几乎无精度损耗的前提下,压缩模型体积、降低显存占用、提升推理速度。
- 技术定位:落地成本最低、稳定性最高、兼容性最强的轻量化优化手段。
2. 核心原理
量化核心逻辑为精度换效率,无损换提速,利用模型参数冗余特性实现轻量化,原理拆解:
- 参数冗余特性:原生模型默认采用FP32(32位浮点数)高精度存储,精度远超模型推理所需,存在大量冗余。
- 精度映射转换:通过数值缩放、映射、取整操作,将高精度浮点数据转为低精度数据。
- 主流精度等级:FP16、INT8、INT4,精度逐级降低,压缩比例、推理速度逐级提升。
直观压缩效果对比:
- 原生FP32模型10GB → INT8量化后2.5GB,提速50%以上。
- 原生FP32模型10GB → INT4量化后1.25GB,提速100%以上,常规场景无感损精度。
量化技术分类:
- 训练后量化(PTQ):无需重新训练,一键量化,适配绝大多数落地场景。
- 训练中量化(QAT):训练过程同步量化,精度损耗更低,适配高精度刚需场景。
3. 主要特点
量化作为基础轻量化技术,具备高稳定、高兼容、零改造的核心优势,主要特点:
- 零结构改动:不删除、不修改任何模型参数与网络结构,完整保留模型所有能力,稳定性拉满。
- 极致性价比:无需训练、操作简单、耗时极短,压缩提速效果显著,几乎无精度损耗。
- 纯落地优化:仅优化显存占用、模型体积、推理速度,不提升、不改变模型业务效果与场景适配能力。
- 全场景兼容:适配所有大模型架构、所有硬件设备,是唯一无落地风险的轻量化技术。
4. 适用场景
适用场景:
- 全覆盖大模型部署场景,是工业落地标配操作。
- 重点适配:本地PC部署、低配服务器、边缘设备、嵌入式AI、移动端轻量化服务。
核心局限:
- 优化上限有限,仅修改数据精度,不减少模型参数量。
- 无法从根源降低模型计算复杂度,极致轻量化、超高提速场景需搭配剪枝、蒸馏使用。
5. 实践示例
使用主流bitsandbytes工具实现INT4量化,通用方案,一键压缩模型体积、降低显存、提升推理速度、近乎无损精度。
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
import torch

# 1. 配置INT4量化参数
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_use_double_quant=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16
)

# 2. 加载量化模型与分词器
model_name = "gpt2"
tokenizer = AutoTokenizer.from_pretrained(model_name)
tokenizer.pad_token = tokenizer.eos_token
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    quantization_config=bnb_config,
    device_map="auto"
)

# 3. 量化前后体积与推理对比
input_text = "大模型量化的作用是"
inputs = tokenizer(input_text, return_tensors="pt").to("cuda")
output = model.generate(**inputs, max_length=60)
print("量化模型推理结果:", tokenizer.decode(output[0], skip_special_tokens=True))

# 输出模型占用显存
print(f"模型显存占用:{model.get_memory_footprint()/1024/1024:.2f} MB")
重要说明:
- 相比原生FP32模型,INT4量化可压缩75%显存占用,推理速度提升一倍以上。
- 无需训练、一键部署,本地PC、低配服务器均可流畅运行大模型。
- 常规对话、问答场景精度损耗极低,肉眼几乎无法感知。
五、剪枝剔除冗余参数
1. 基础定义
剪枝是针对模型结构的根源性瘦身技术,通过剔除冗余参数实现模型轻量化,相比量化优化更彻底,核心定义:
- 核心背景:大模型普遍存在过参数化问题,海量参数中存在大量无效、低贡献、冗余神经元与权重。
- 核心操作:筛选并剔除对模型输出、推理、特征提取无贡献的冗余参数与网络结构。
- 核心本质:去芜存菁,保留核心有效网络结构,从根源减少参数量、降低计算量。
- 技术区别:量化改精度、不改结构;剪枝直接删减模型结构,是根本性瘦身优化。
2. 核心原理
剪枝核心逻辑为去芜存菁,保留核心能力,通过权重贡献度筛选冗余参数,完整原理拆解:
- 贡献度计算:通过算法遍历模型所有参数,计算每个神经元、权重对最终输出的贡献值。
- 冗余剔除:筛选贡献值无限趋近于0的参数、连接、通道,直接剔除删除。
- 能力修复:高比例剪枝后可搭配小幅微调复训,弥补轻微精度损耗。
行业两大主流剪枝方案:
- 非结构化剪枝:零散删除单个权重参数,精度保留效果好、损耗极低,但生成稀疏矩阵,普通硬件无法加速,仅适用于科研场景。
- 结构化剪枝:以通道、层级、模块为单位整体剪枝,结构规整、硬件适配性强,可真实实现推理提速,是工业落地主流方案。
3. 主要特点
剪枝属于高阶轻量化技术,优化效果优于单一量化,同时存在一定精度管控门槛,主要特点:
- 根源性瘦身:直接减少参数量与计算量,从本质上降低硬件门槛与推理耗时,优化效果远超单纯量化。
- 存在精度风险:剪枝比例过高会误删有效参数,导致模型精度下降、推理出错,需精准把控剪枝率。
- 可修复性强:剪枝后的轻微精度损耗,可通过小幅微调复训快速修复。
- 硬件适配差异大:结构化剪枝落地友好、可硬件加速,非结构化剪枝仅适合学术研究。
4. 适用场景
适用场景:
- 需要极致轻量化、超低延迟、高并发推理的落地场景。
- 典型场景:边缘智能设备、嵌入式AI、实时交互AI、低配服务器高并发部署。
- 常与量化组合使用,实现“结构精简+精度压缩”双重极致优化。
核心局限:
- 可控难度高,剪枝率过低优化效果弱,过高会严重损伤模型精度。
- 对模型结构有改动,通用性不如量化,不同模型需要定制专属剪枝策略。
- 落地流程比量化复杂,高精度场景需额外搭配微调复训。
5. 实践示例
基于PyTorch实现结构化剪枝,筛选并剔除模型冗余权重,固化轻量化模型结构,实现参数量精简与推理提速。
import torch
import torch.nn.utils.prune as prune
from transformers import AutoModelForCausalLM, AutoTokenizer

# 1. 加载原生模型
model_name = "gpt2"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
tokenizer.pad_token = tokenizer.eos_token

# 2. 对注意力层进行结构化剪枝(剪枝比例30%)
module = model.transformer.h[0].attn.c_attn
prune.l1_unstructured(module, name="weight", amount=0.3)

# 3. 永久移除冗余参数,固化剪枝结构
prune.remove(module, "weight")

# 4. 剪枝后推理验证
input_text = "大模型剪枝可以"
inputs = tokenizer(input_text, return_tensors="pt")
output = model.generate(**inputs, max_length=60)
print("剪枝后模型输出:", tokenizer.decode(output[0], skip_special_tokens=True))

# 统计剩余参数量
total_params = sum(p.numel() for p in model.parameters())
print(f"剪枝后总参数量:{total_params/1000000:.2f} M")
重要说明:
- 基于L1正则算法,自动筛选权重值极低的冗余参数。
- 完成剪枝后永久固化模型结构,彻底剔除无效参数。
- 精简模型参数量,降低推理计算量,搭配微调可完全修复微小精度损耗。
六、蒸馏迁移模型能力
1. 基础定义
知识蒸馏是高阶模型轻量化技术,核心是大模型教小模型,能力平移复刻,和其他四种技术逻辑完全不同,具体定义如下:
- 师生架构:高精度大模型为教师模型,轻量化小模型为学生模型。
- 核心操作:让小模型学习大模型的推理逻辑、知识体系、输出分布,而非单纯学习标准答案。
- 核心目标:用极小体量的学生模型,无限逼近超大教师模型的推理效果。
- 技术差异:预训练、微调优化原有模型;量化、剪枝改造原有模型;蒸馏是训练全新轻量化模型。
2. 核心原理
蒸馏核心逻辑为迁移软知识,复刻推理逻辑,区别于传统模型硬标签训练,原理拆解如下:
- 传统训练局限:仅学习单一标准答案(硬标签),只能复刻结果,无法学习推理逻辑。
- 蒸馏核心优势:学习大模型完整输出概率、中间推理过程、语义倾向(软标签),复刻思考逻辑。
完整蒸馏标准流程:
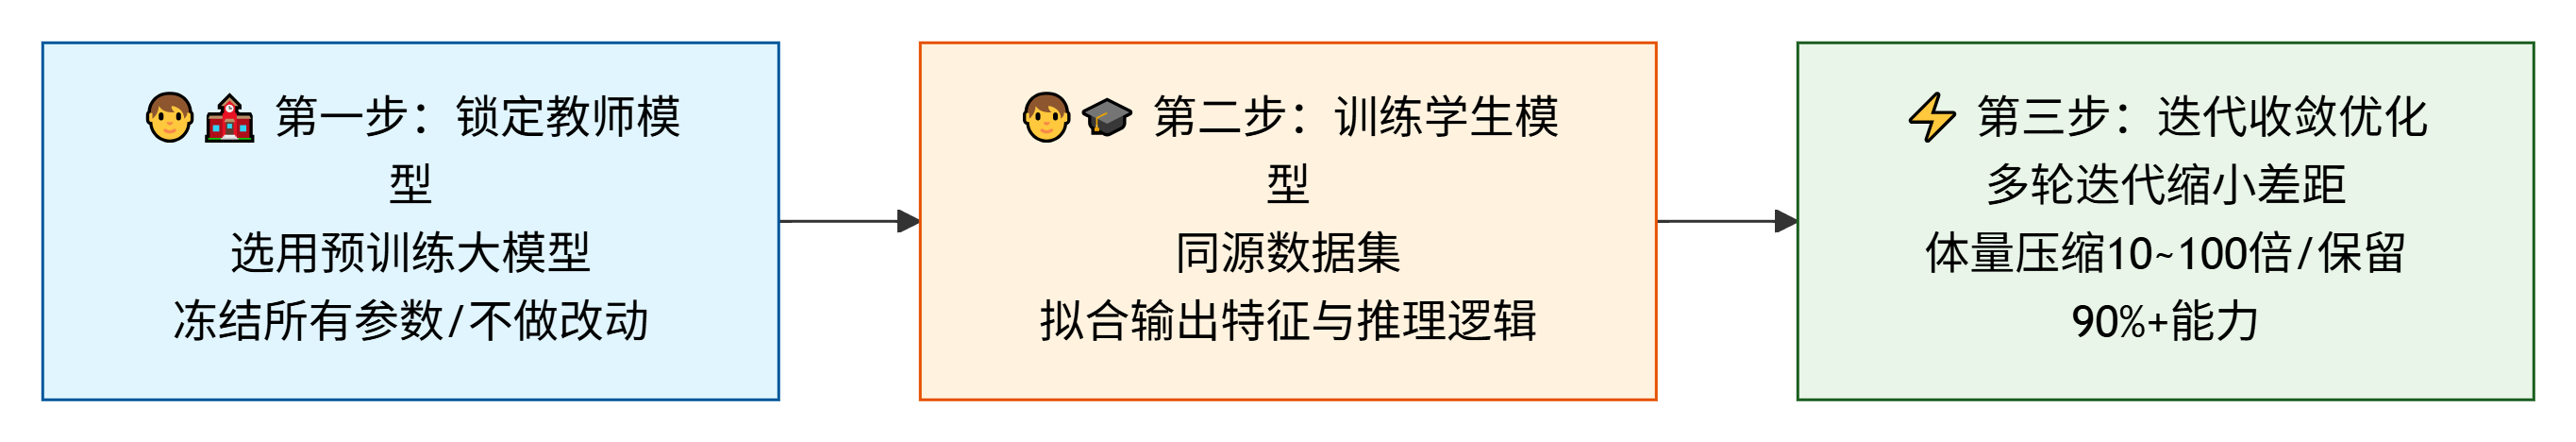
- 第一步:锁定教师模型:选用效果优异的预训练/微调大模型,冻结所有参数,不做任何改动。
- 第二步:训练学生模型:使用同源数据集,让小模型拟合大模型的全部输出特征与推理逻辑。
- 第三步:迭代收敛优化:多轮迭代缩小师生模型效果差距,实现小模型体量压缩10~100倍,保留90%以上大模型能力。
主流蒸馏类型:
- 硬蒸馏:仅学习最终输出结果,效果一般。
- 软蒸馏:学习概率分布与推理逻辑,能力保留度更高,是业界主流方案。
3. 主要特点
知识蒸馏是轻量化效果最优的高阶技术,可打造极致高效的专属小模型,主要特点:
- 极致轻量化:产出模型体量远小于量化、剪枝优化后的模型,推理速度、硬件适配性最优。
- 能力保留度高:复刻大模型核心知识与推理逻辑,同体量下效果远超原生训练小模型。
- 技术门槛偏高:需要搭建师生架构、专属数据集、多轮迭代训练,算力与技术成本高于量化、剪枝。
- 可叠加优化:蒸馏后的小模型,可继续进行微调、量化、剪枝,实现多层优化叠加。
4. 适用场景
适用场景:
- 极致落地、超低延迟、低成本部署场景。
- 典型场景:移动端AI、嵌入式设备、高并发低延迟服务、低成本私有化部署。
- 业界优质开源小模型,基本均由知识蒸馏训练得到。
核心局限:
- 技术门槛高、训练周期长,新手快速落地性价比低于量化、剪枝。
- 能力存在上限,学生模型效果永远无法超越教师模型,仅能无限趋近。
- 小规模简单场景下,无需复杂蒸馏,量化即可满足需求。
5. 实践示例
实现经典师生模型软标签知识蒸馏,让大模型赋能小模型,以小体量实现接近大模型的推理效果。
import torch
import torch.nn.functional as F
from transformers import AutoModelForCausalLM, AutoTokenizer

# 1. 初始化教师模型(大模型)、学生模型(小模型)
teacher_model = AutoModelForCausalLM.from_pretrained("gpt2-large")
student_model = AutoModelForCausalLM.from_pretrained("gpt2-mini")
tokenizer = AutoTokenizer.from_pretrained("gpt2")
tokenizer.pad_token = tokenizer.eos_token

# 冻结教师模型权重,仅训练学生模型
teacher_model.eval()
student_model.train()
optimizer = torch.optim.AdamW(student_model.parameters(), lr=2e-5)

# 2. 蒸馏超参数
temperature = 2.0  # 温度系数,软化输出概率
alpha = 0.7        # 蒸馏损失权重

# 3. 模拟训练数据
train_text = ["大模型知识蒸馏可以实现轻量化部署", "师生模型训练可以提升小模型效果"]
inputs = tokenizer(train_text, return_tensors="pt", padding=True, truncation=True)

# 4. 蒸馏核心损失计算
with torch.no_grad():
    teacher_logits = teacher_model(**inputs).logits

student_logits = student_model(**inputs).logits

# 软标签蒸馏损失 + 硬标签原生损失
loss_soft = F.kl_div(
    F.log_softmax(student_logits / temperature, dim=-1),
    F.softmax(teacher_logits / temperature, dim=-1),
    reduction="batchmean"
) * (temperature ** 2)

loss_hard = F.cross_entropy(student_logits.view(-1, student_logits.size(-1)), inputs["input_ids"].view(-1))
loss = alpha * loss_soft + (1 - alpha) * loss_hard

# 5. 反向传播更新学生模型
loss.backward()
optimizer.step()
optimizer.zero_grad()
print(f"蒸馏训练损失:{loss.item():.4f}")

# 6. 学生模型推理测试
student_model.eval()
test_input = tokenizer("蒸馏的作用是", return_tensors="pt")
res = tokenizer.decode(student_model.generate(**test_input, max_length=50)[0], skip_special_tokens=True)
print("轻量化学生模型输出:", res)
重要说明:
- 通过温度系数软化教师模型输出,释放深层推理逻辑与软标签信息。
- 结合软标签蒸馏损失与硬标签损失,让小模型既学结果、又学逻辑。
- 最终训练出的学生模型体量更小、速度更快,效果无限逼近大模型。
七、核心差异与联动
1. 核心维度对比
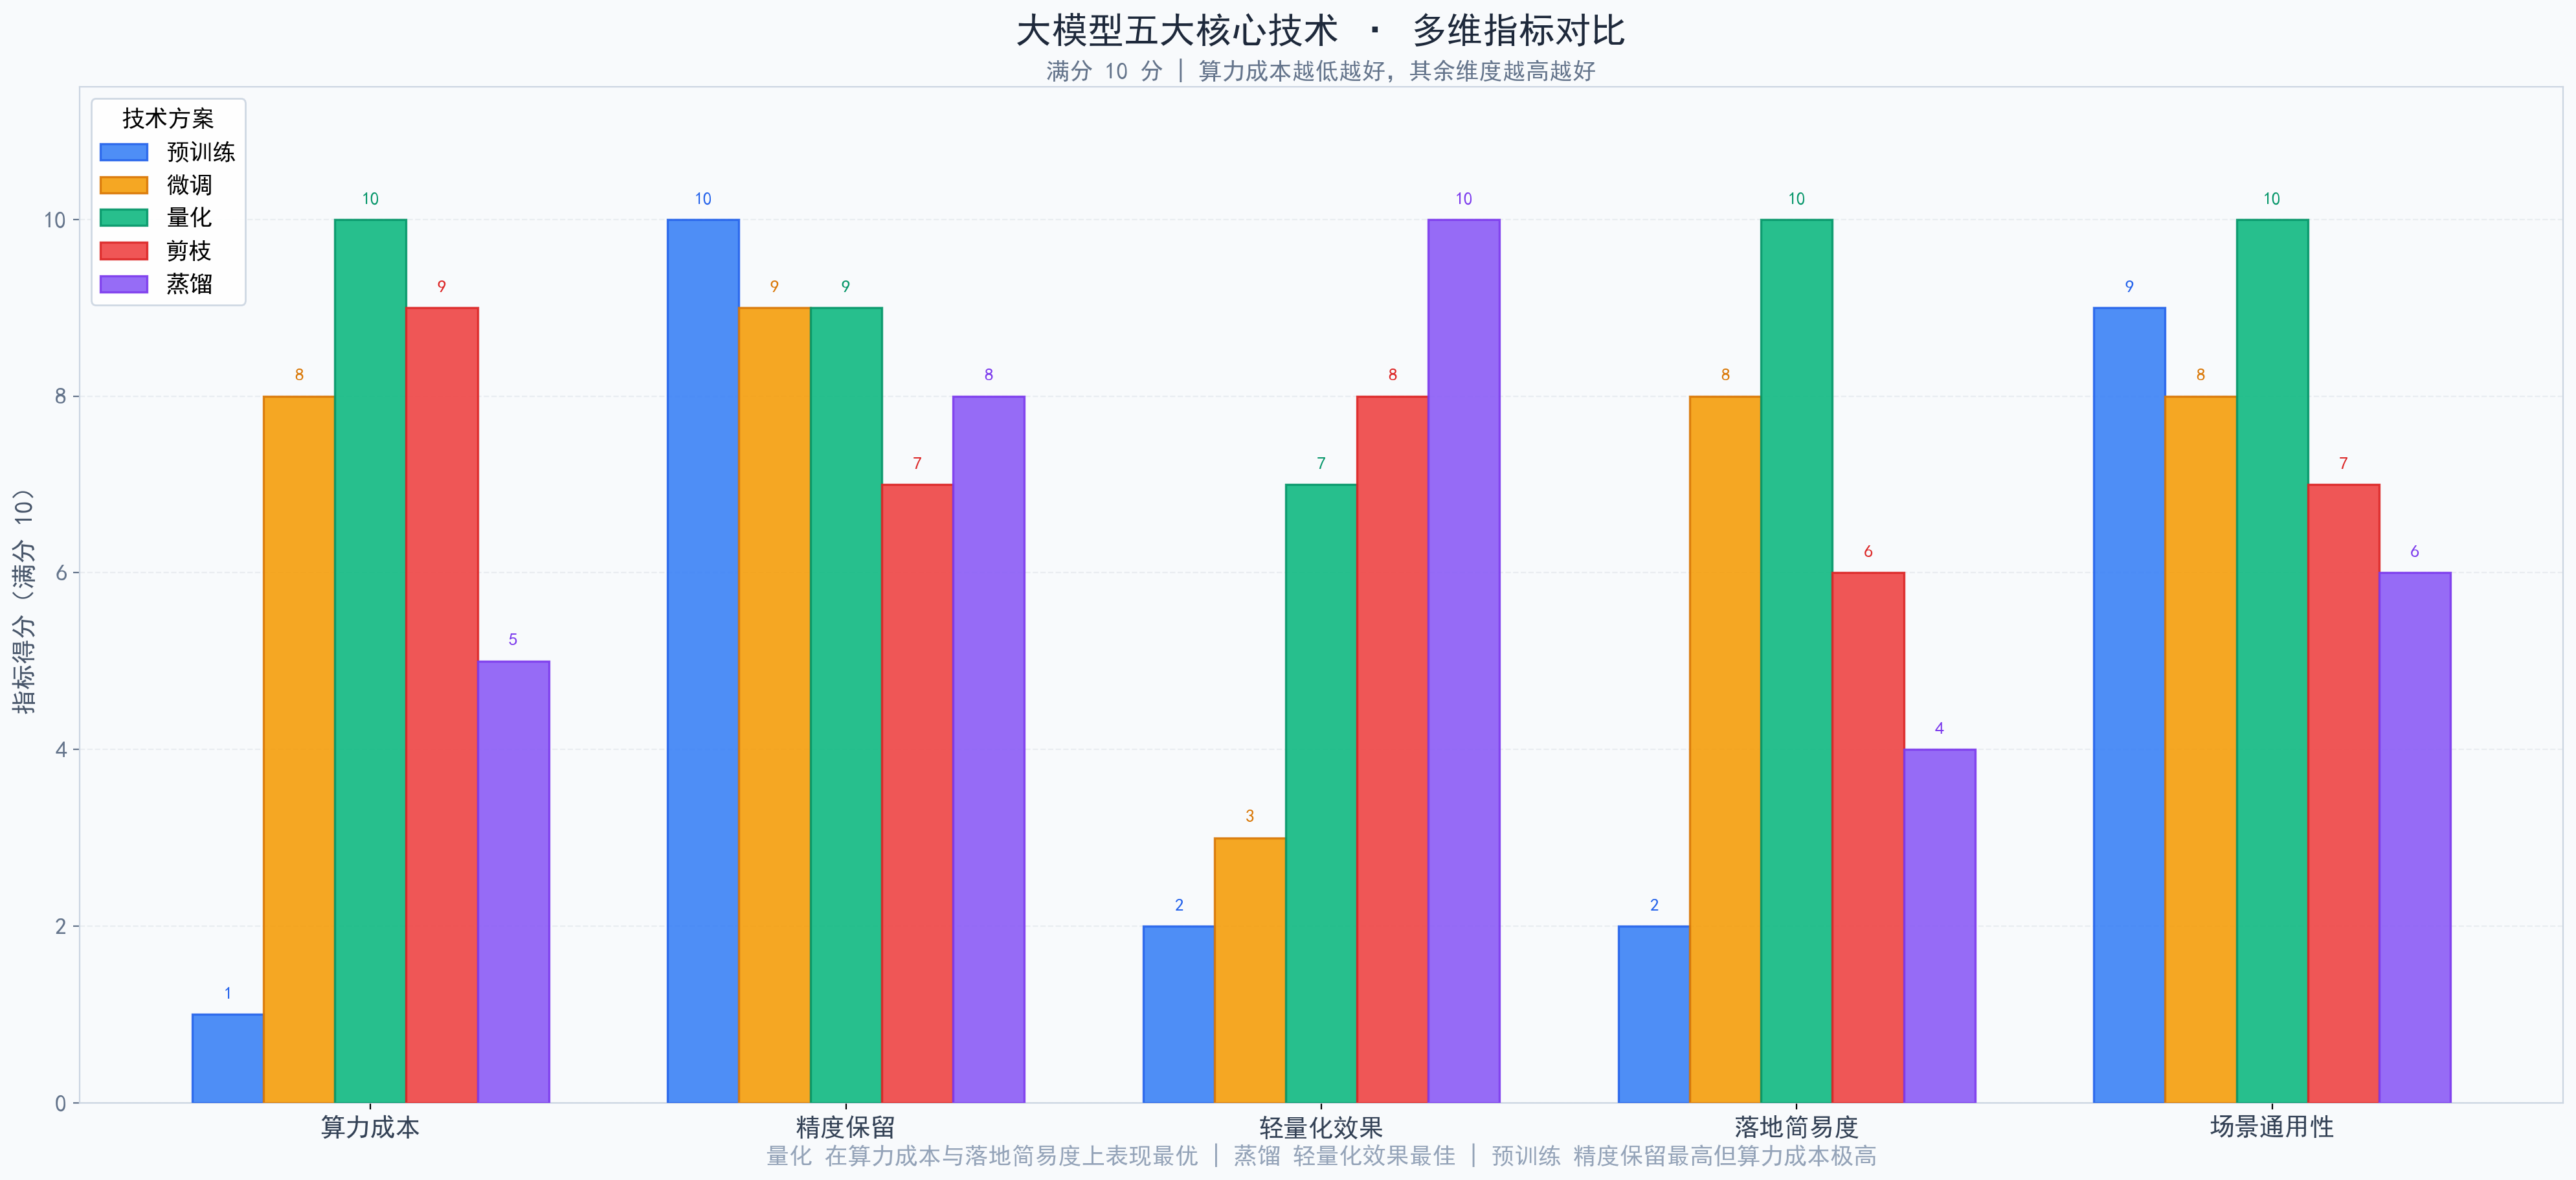
从五大核心维度横向对比五项技术的核心差异,快速区分适配场景:
- 预训练:核心目标是打造通用底座;从零全新构建模型;决定模型核心能力;算力成本最高;仅用于模型研发阶段。
- 微调:核心目标是定制场景能力;小幅更新模型参数;提升垂直场景精度;算力成本极低;是项目落地必备步骤。
- 量化:核心目标是模型压缩推理提速;修改数据存储精度;几乎无精度损耗;零训练成本;所有部署场景首选。
- 剪枝:核心目标是精简模型结构;删除冗余参数与结构;轻微精度损耗可修复;低算力成本;适配极致轻量化场景。
- 蒸馏:核心目标是复刻轻量化小模型;训练全新学生模型;高比例保留大模型能力;中高算力成本;高端轻量化落地场景。
轻量化技术效果权衡对比:
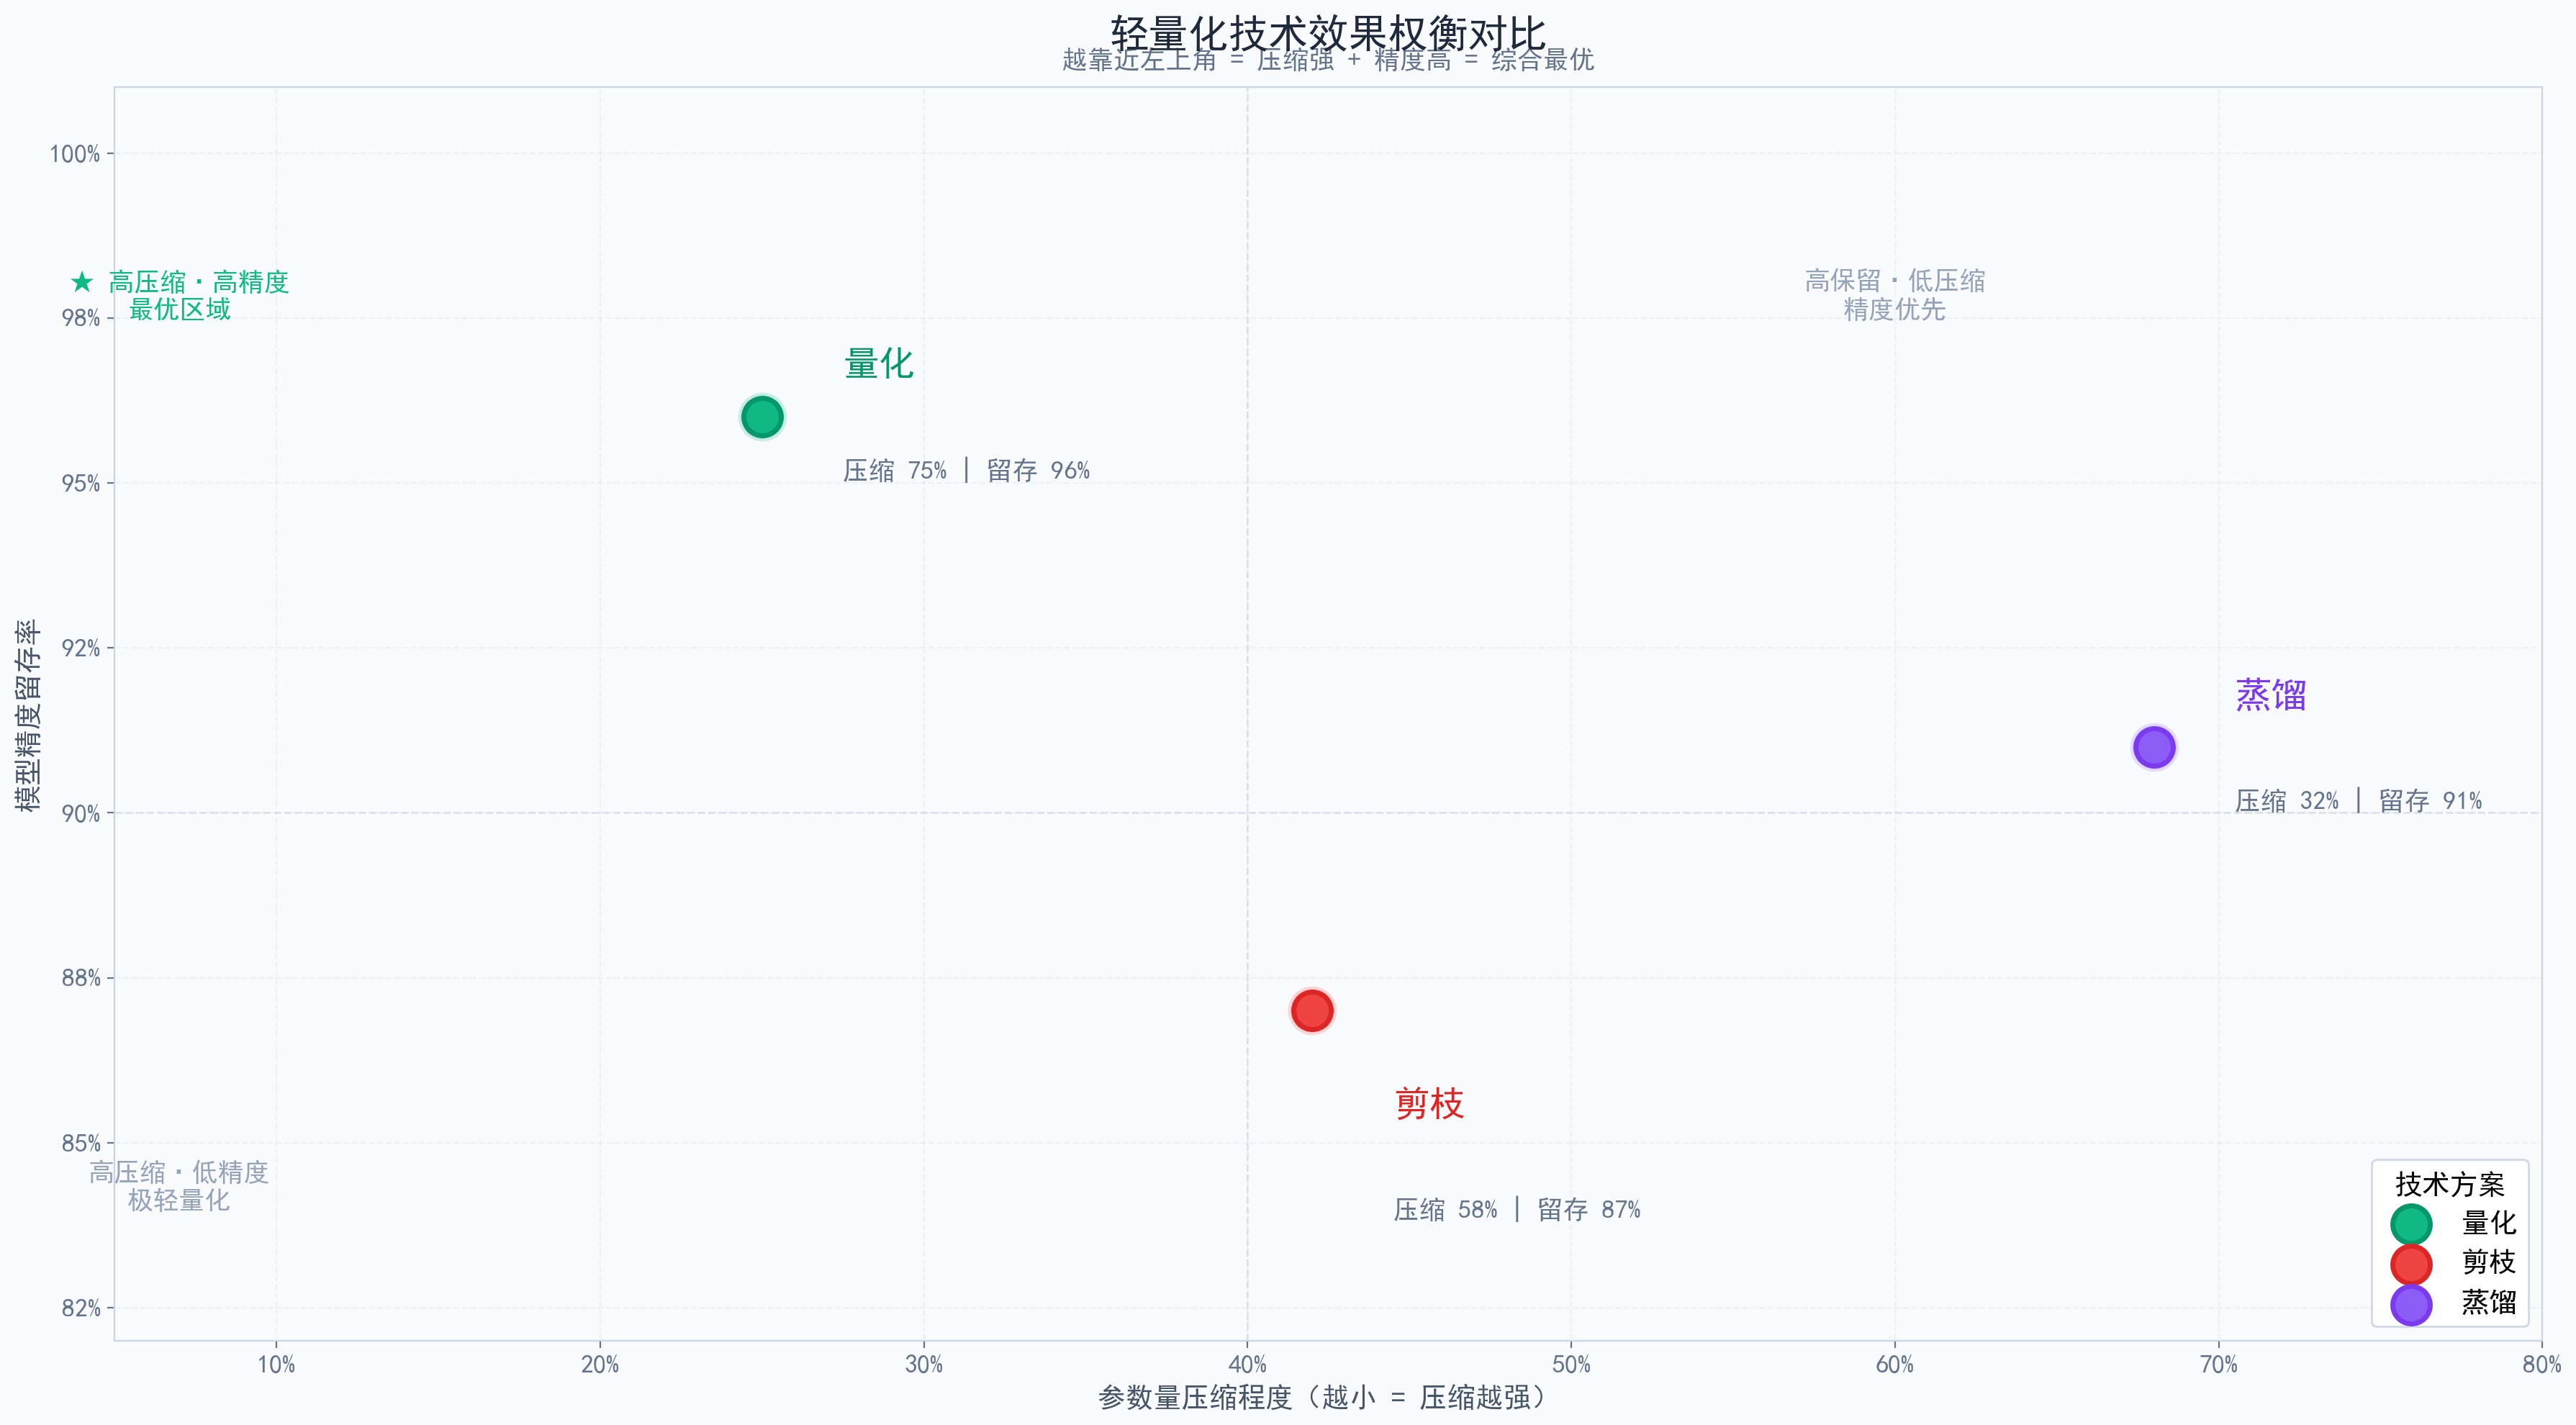
最优区域:
- 左上角(高压缩 + 高精度)是综合最优区
- 量化恰好落在此区域:压缩75%的同时精度留存96%,综合表现最佳
三种技术对比
- 量化(25%, 96%):压缩力度最大、精度留存最高,三者中综合最优
- 蒸馏(68%, 91%):精度留存不错但压缩力度较弱,适合精度优先场景
- 剪枝(42%, 87%):压缩与精度折中,精度留存率最低,需谨慎评估
2. 应用联动流程
标准落地顺序:预训练→微调→蒸馏→剪枝→量化
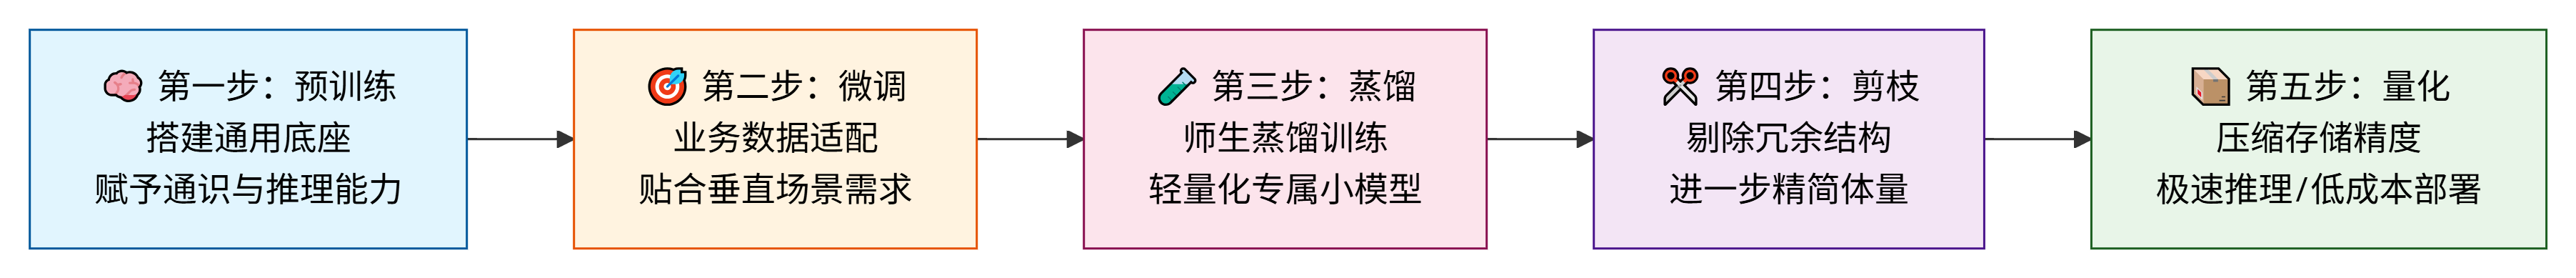
- 第一步:预训练:搭建通用大模型底座,赋予模型通识与基础推理能力。
- 第二步:微调:基于业务数据微调,让通用模型适配垂直场景、贴合业务需求。
- 第三步:蒸馏:通过师生蒸馏,训练出轻量化专属小模型,实现初步瘦身。
- 第四步:剪枝:剔除小模型剩余冗余结构与参数,进一步精简模型体量。
- 第五步:量化:压缩参数存储精度,最终实现极速推理、低成本部署。
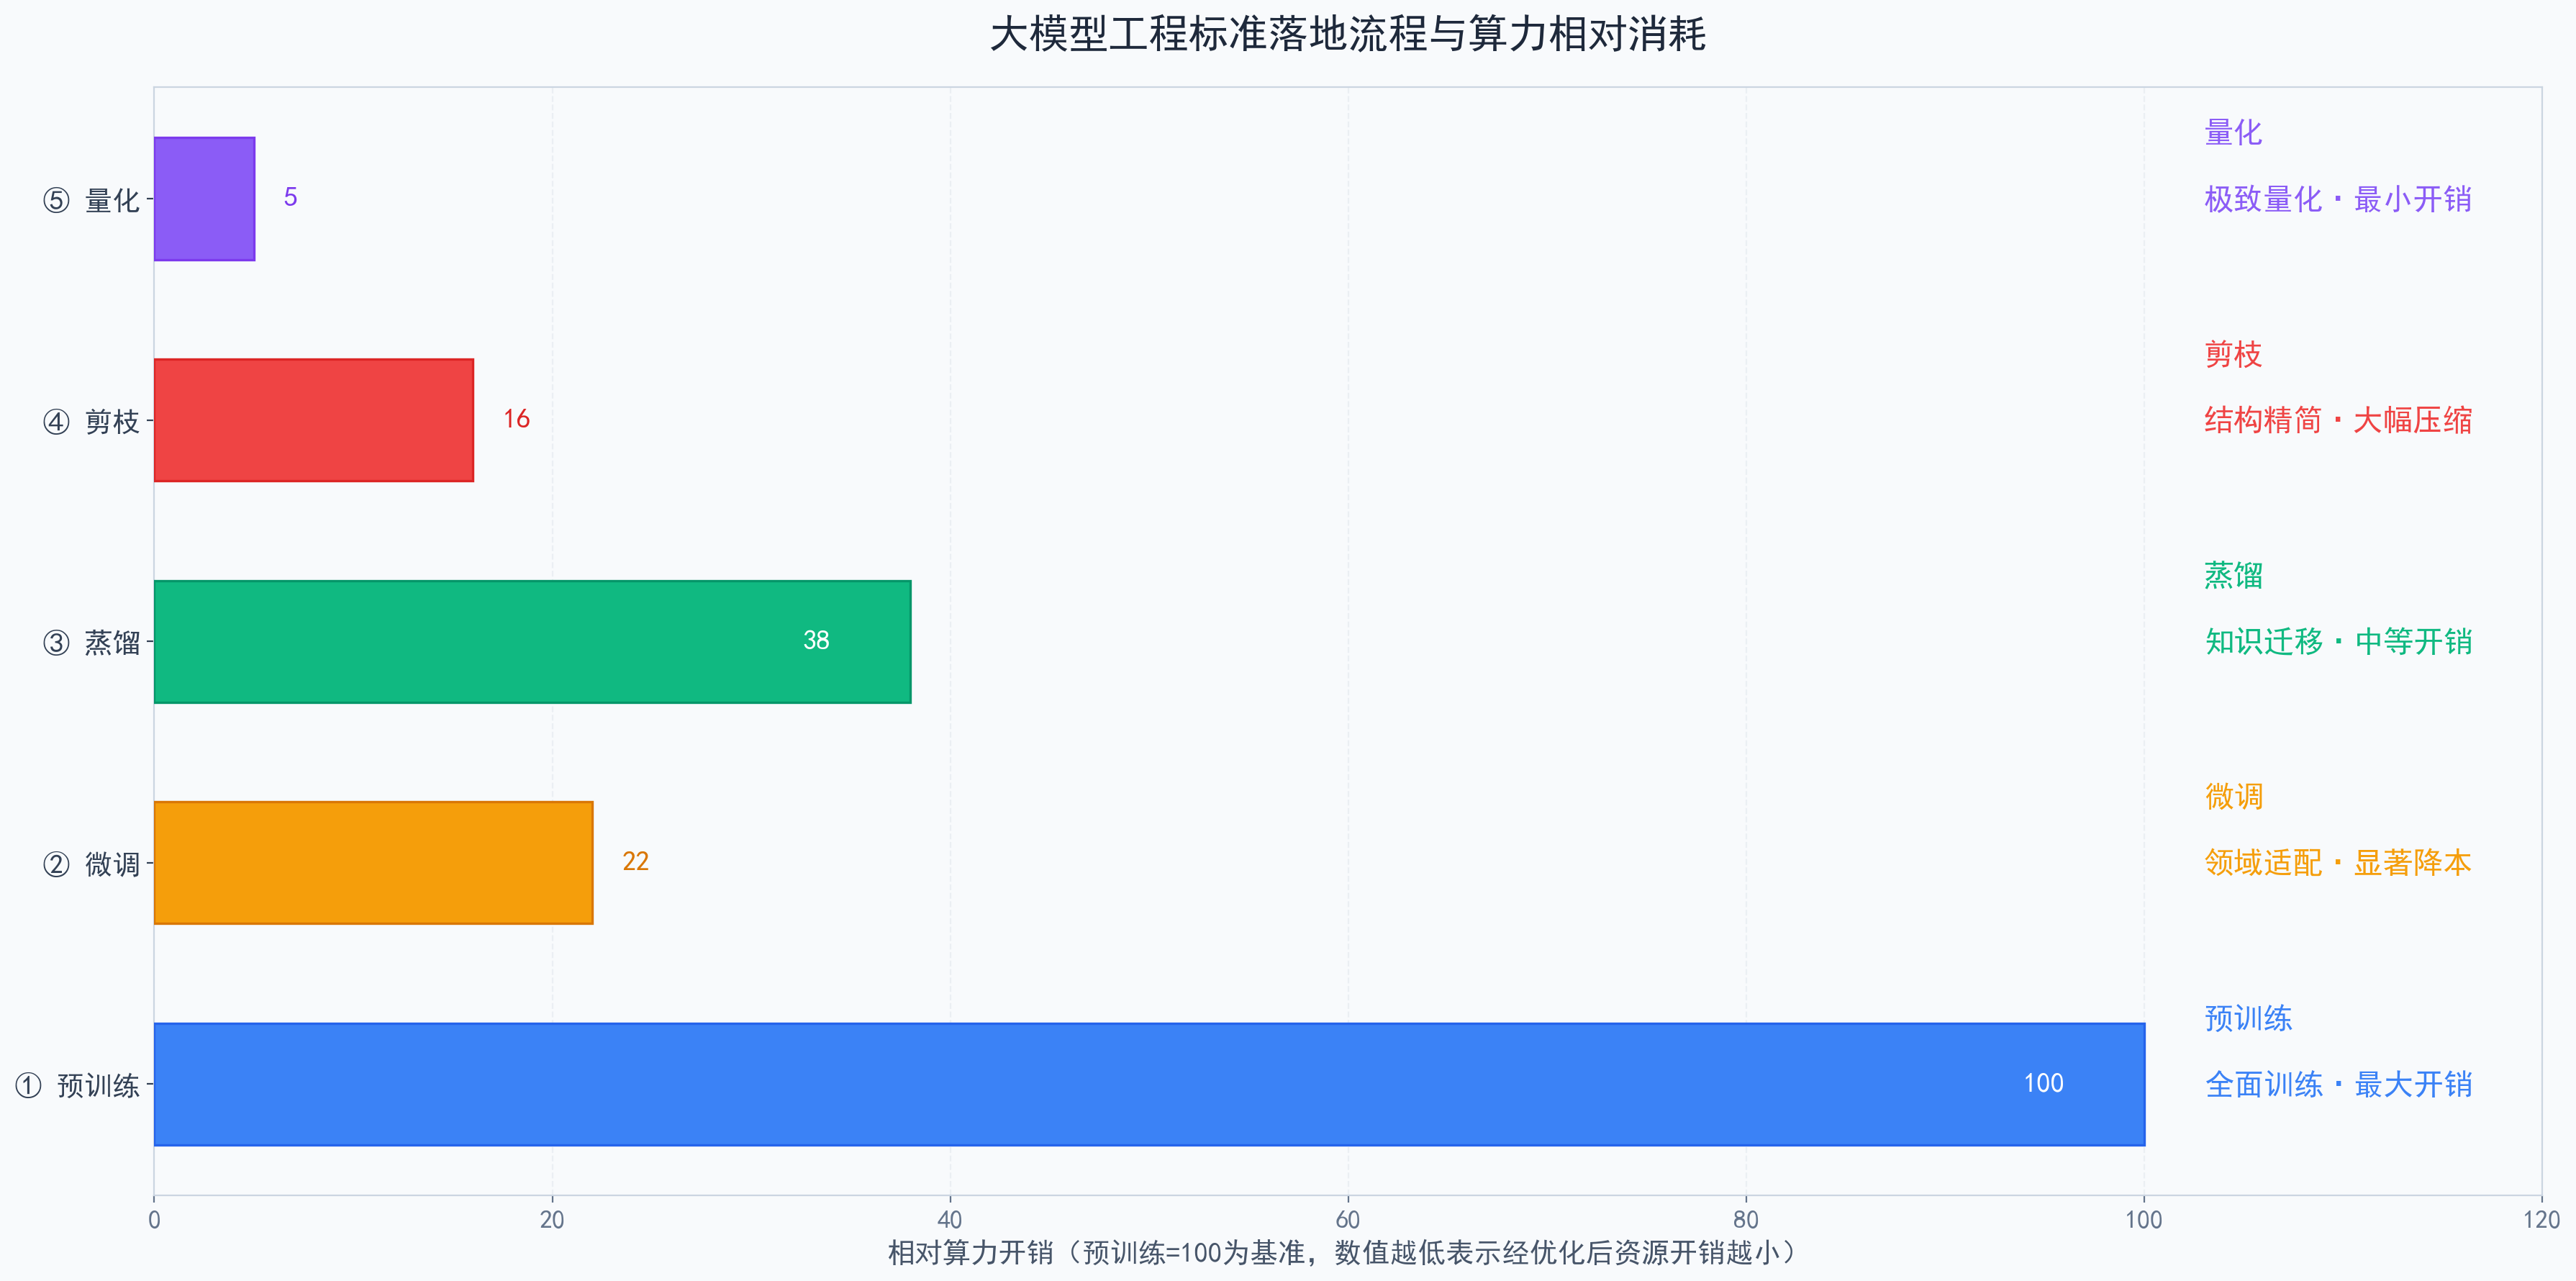
整套流程落地后,可实现效果精准、体积小巧、推理极速、低成本落地的最优状态。
八、总结
总的来说:预训练是从无到有造模型,搭建AI的通用认知底子;微调是从通用到专业改模型,让AI适配行业业务;量化、剪枝、蒸馏是从笨重到轻盈优模型,解决落地部署难题。
这些技术融合贯穿大模型研发、定制、优化、落地全生命周期,没有优劣之分,只有场景适配之别。建议优先掌握微调+量化,低成本快速实现业务落地;进阶优化再叠加剪枝、蒸馏,打造极致轻量化模型;而预训练仅需了解原理。循序渐进的掌握这些技术的核心逻辑,是一个逐步理解领悟的过程,只有掌握这些核心基础,才能打通大模型从研发到落地的核心链路,彻底摆脱技术混淆,能够根据自身业务需求,精准选择对应的优化方案,高效落地大模型应用。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号