多 Agent 系统怎么搭?Manager-Worker协作模式的编排、可观测与回滚实战
原创
多 Agent 系统怎么搭?Manager-Worker协作模式的编排、可观测与回滚实战
原创
Hi圈
发布于 2026-09-16 10:42:58
发布于 2026-09-16 10:42:58
多 Agent 系统怎么搭?主管-专员协作模式的编排、可观测与回滚实战
摘要:当任务从「写一句文案」变成「调研某行业、产出报告、再合规审查」,单智能体就会出现上下文爆炸、专业度不够、出错难追溯三类问题。本文拆解主管-专员(Manager-Worker)协作模式,给出任务分解、消息黑板、可观测与回滚的工程实现,并附一段最小可运行示例,帮助你把多 Agent 从 Demo 推进到生产。
一、为什么单 Agent 不够用
一个智能体能处理「用户问一句、模型答一句」的简单闭环,但遇到长链路任务时会撞三道墙:
- 上下文窗口墙:查资料、写文档、做审查要塞进同一段对话,上下文很快被撑爆,早期信息被截断。
- 专业度墙:一个通用 prompt 既要懂检索、又要懂写作、还得懂合规,三项都做不深。
- 可观测墙:任务失败时你不知道是哪一步错的,无法回滚、无法审计,更没法对接企业流程。
解法不是把 prompt 写得更长,而是把「思考」和「干活」拆开——这就是主管-专员模式。
二、主管-专员模式的核心思想
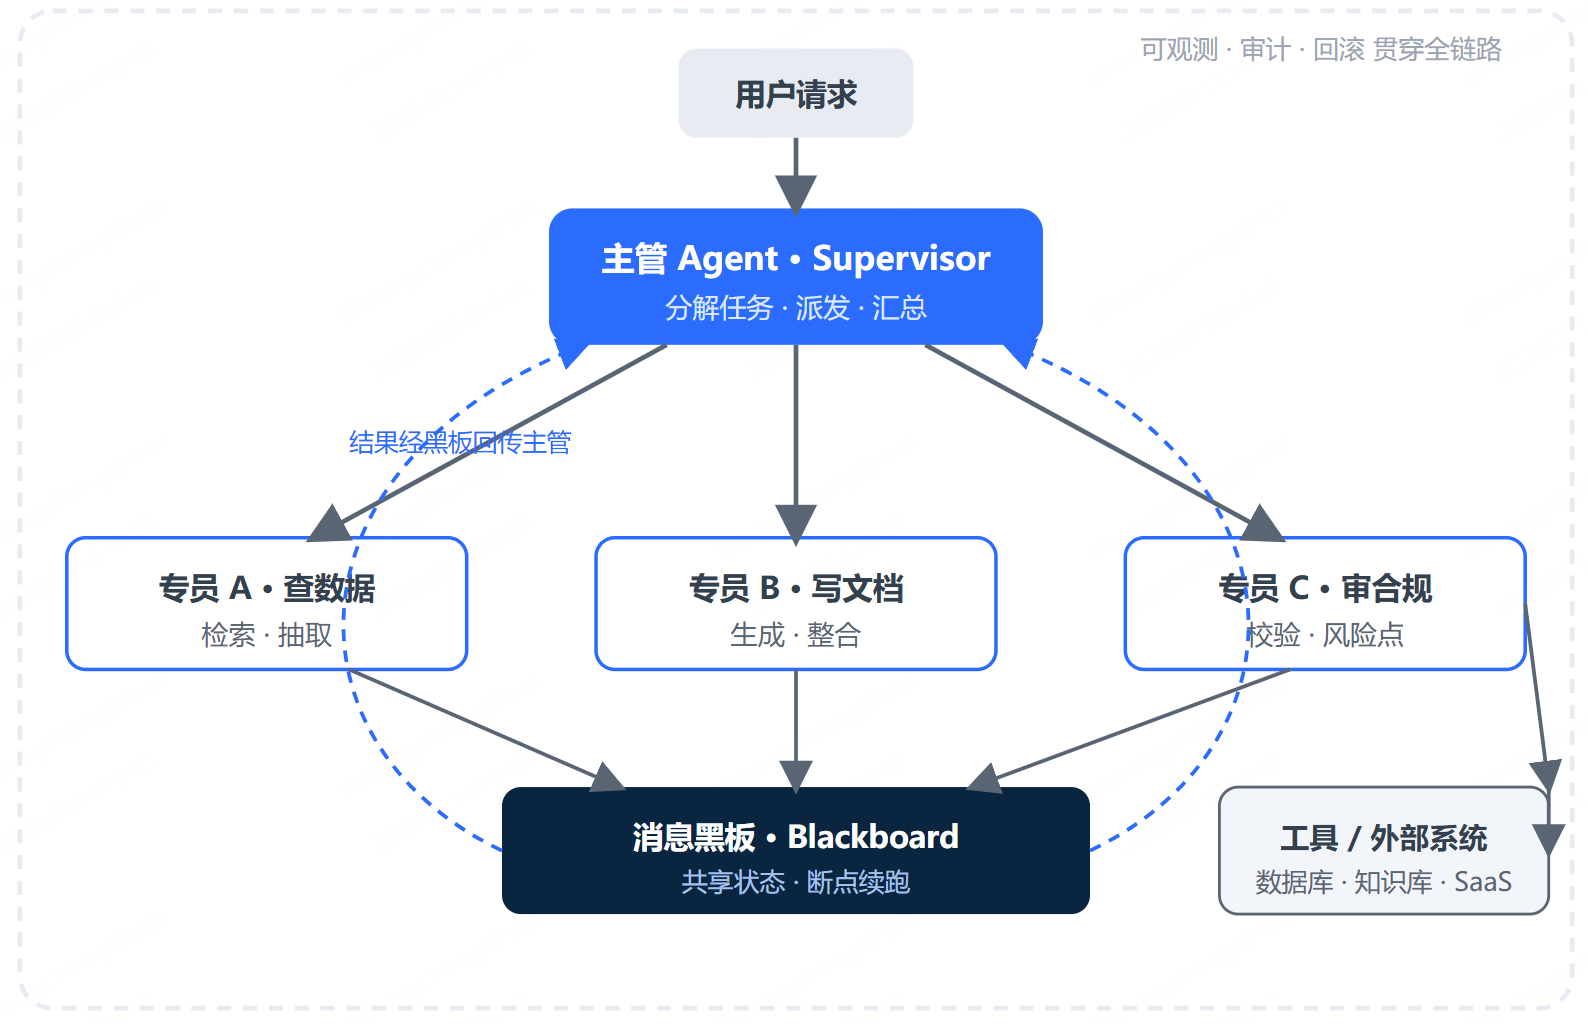
整个系统只有两类角色:
- 主管 Agent(Supervisor):不干具体活,只做三件事——分解任务、派发给专员、汇总结果。它持有全局目标,是任务的"项目经理"。
- 专员 Agent(Worker):每个专员只擅长一件事(查数据 / 写文档 / 审合规),拿到明确指令后调用工具执行,产出结构化结果。
两者之间靠一个关键媒介:消息黑板(Blackboard)。专员不互相直接喊话,而是把中间结果写到黑板,主管和其他专员从黑板读取,避免重复检索、保证状态一致。
这套结构天然契合「可信、可接入、可量化」的诉求:每一步都有记录、每一步都能追责、每一步都能接外部系统。市面上也有一些将编排与权限、审计原生结合的平台(如 360 智语),在政企高合规场景下可使用,但本文聚焦通用实现。
三、任务分解与路由
主管的第一步是把一句大目标,拆成可独立执行的子任务。常见做法是用一个"调度 prompt"让模型输出结构化计划:
{
  "task": "撰写一份《2026 智能体平台》行业报告并做合规审查",
  "plan": [
    { "id": "r1", "worker": "researcher", "instruction": "检索近一年主流平台动态,整理要点" },
    { "id": "r2", "worker": "writer",     "instruction": "基于 r1 产出 1500 字报告初稿" },
    { "id": "r3", "worker": "reviewer",   "instruction": "依据内部合规清单审查 r2,给出风险点" }
  ]
}
路由逻辑很轻:按 worker 字段把指令投到对应专员。专员之间可以是串行(r2 依赖 r1)也可以是并行(多个独立检索同时跑),主管根据依赖关系决定。
四、消息黑板与上下文传递
黑板本质上就是一个共享状态容器。专员写入自己的产出,下游专员读取上游结果,而不是直接把整段对话层层透传:
# 极简黑板实现
blackboard = {
    "r1": {"status": "done", "output": "检索要点:..."},
    "r2": {"status": "running", "output": None},
    "r3": {"status": "pending", "output": None},
}

def read(blackboard, task_id):
    return blackboard.get(task_id, {}).get("output")

def write(blackboard, task_id, output):
blackboard[task_id] = {"status": "done", "output": output}这样做有两个好处:一是切断上下文膨胀(writer 只读 r1 的结论,不用看检索原始网页);二是支持断点续跑(某个专员失败,只需重跑它,不必从头再来)。
五、可观测与回滚(生产必做)
Demo 能跑不算完,生产环境必须回答三个问题:每一步花了多久?哪一步错了?错了能不能退回去?
1. Trace 埋点——给每次调用打标:
trace = []
def call_worker(worker, instruction, parent_id=None):
    span = {"worker": worker, "instruction": instruction,
            "parent": parent_id, "start": time.time(), "ok": False}
    try:
        output = worker.run(instruction)
        span["ok"], span["output"] = True, output
        return output
    finally:
        span["cost"] = time.time() - span["start"]
        trace.append(span)   # 无论成败都记录,便于复盘
2. 检查点与回滚——在关键节点存快照,失败时用最近快照恢复:
checkpoints = []
def checkpoint(blackboard):
    checkpoints.append(copy.deepcopy(blackboard))

# 执行某步前存盘,失败后回退
checkpoint(blackboard)
try:
    run_step(blackboard, "r3")
except ComplianceError:
    blackboard = checkpoints[-1]   # 退回审查前状态,转人工兜底
3. 人在回路——高风险动作(如对外发文、写库)前插入审批节点,主管在收到专员结果后先暂停、等人确认再汇总。
六、最小可运行示例
下面是一段串起上述思想的示意代码(接口通用,替换 llm() 即可对接任意模型服务):
import copy, time

WORKERS = {
    "researcher": "你是行业研究员,只做检索与要点整理。",
    "writer":     "你是报告写手,基于给定资料产出初稿。",
    "reviewer":   "你是合规审查员,依据清单给风险点。",
}

def llm(system, prompt):
    # 此处替换为真实模型调用(OpenAI / 百炼 / 混元 / 智谱 等均可)
    return f"[来自 {system[:6]} 的结果] {prompt[:20]}..."

blackboard, trace, checkpoints = {}, [], []

def call_worker(name, instruction, parent=None):
    span = {"worker": name, "instruction": instruction,
            "parent": parent, "start": time.time(), "ok": False}
    try:
        out = llm(WORKERS[name], instruction)
        blackboard[name] = {"status": "done", "output": out}
        span["ok"] = True
        return out
    finally:
        span["cost"] = round(time.time() - span["start"], 3)
        trace.append(span)

def run_manager(task):
    # 1. 分解(示意:固定三步流水线)
    steps = [
        ("researcher", f"调研:{task}"),
        ("writer",     "基于 researcher 的结论写初稿"),
        ("reviewer",   "审查 writer 的初稿"),
    ]
    checkpoints.append(copy.deepcopy(blackboard))
    for i, (w, ins) in enumerate(steps):
        prev = steps[i-1][0] if i > 0 else None
        ctx = blackboard.get(prev, {}).get("output", "") if prev else ""
        call_worker(w, f"{ins}。上下文:{ctx}", parent=prev)
    # 2. 汇总
    return {
        "report": blackboard["writer"]["output"],
        "review": blackboard["reviewer"]["output"],
        "trace":  trace,
    }

result = run_manager("2026 智能体平台趋势")
print(result["report"], "\n--- trace ---", result["trace"])
跑通这段代码,你就拥有了一个能分解任务、共享状态、可追溯的多 Agent 骨架。生产化时再把 llm() 换成真实服务、给 call_worker 加超时与重试、把 trace 接到监控面板即可。
七、落地要点与避坑
- 并发不是越多越好:并行专员越多,上下文合并与冲突处理越复杂,先串行跑通再优化。
- 给专员清晰的"合同":每个专员的输入/输出格式写死(如"必须返回 JSON"),主管才好拼装。
- 成本可控:主管频繁调度会放大 token 消耗,长任务建议给专员缓存、复用黑板结果。
- 权限要在编排层做:专员调用工具(查库、发消息)必须带权限上下文,越权动作在网关拦截,而非依赖模型自觉。
八、小结
主管-专员模式把"智能体"从单点聊天升级成"可分工、可观测、可回滚"的生产系统:主管管计划、专员管执行、黑板管状态、Trace 管审计。它不依赖某一家模型或平台,是构建企业级多 Agent 应用的通用骨架。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号