179K Star 的 n8n:我把运维值班的活儿自动化了一半,顺便踩了几个坑
原创
179K Star 的 n8n:我把运维值班的活儿自动化了一半,顺便踩了几个坑
原创
大盘鸡拌面
发布于 2026-09-21 22:12:00
发布于 2026-09-21 22:12:00
要是你还没听说过 n8n,先补个课:这是一个开源的工作流自动化平台,GitHub 上 179K Star,比很多老牌项目都高。简单说,它就是让你用"拖拖拽拽 + 写点代码"的方式,把系统之间的那些破事串起来自动跑——告警了自动拉群、表格更新了自动同步、来了邮件自动分类。今天聊聊我怎么用它把运维值班的活儿砍掉一半的,顺便把踩的坑也摆出来。
一、为什么是 n8n,不是 Zapier 或者自己写脚本?
先说说我为什么要用这类工具。运维的日常里有一大堆"胶水活儿":监控告警要转发到企微、工单要同步到表格、发布完要通知测试、备份完了要检查结果……这些事单看每件都不难,但架不住多、碎、天天有。
我的解决方案进化史大概是这样:
阶段一:shell 脚本 + crontab。 能跑,但脚本一多就成了屎山,谁也不敢动,改一行崩一片。
阶段二:Python + 消息队列。 灵活了,但开发成本上去了,而且同事接手成本高——不是谁都想读你的代码。
阶段三:n8n。 工作流可视化,每个节点干嘛一目了然,出问题了看一眼执行日志就知道卡在哪一步。非技术同事(比如运营)居然也能自己改流程。
那为什么不直接用 Zapier?三个理由:
- 数据不出门。n8n 可以完全自部署,告警内容、日志数据、数据库信息都留在内网。SaaS 工具这点没法保证。
- 成本可控。Zapier 按任务数收费,跑多了肉疼;n8n 自部署就是一台服务器的钱。
- 能写代码。Zapier 遇到复杂逻辑就抓瞎,n8n 里有 Function 节点可以直接写 JS,等于可视化 + 代码自由切换。
部署也简单,Docker 一把梭:
# docker-compose.yml
version: "3.8"

services:
  n8n:
    image: n8nio/n8n:latest
    container_name: n8n
    restart: unless-stopped
    ports:
      - "5678:5678"
    environment:
      # 基础配置
      - N8N_HOST=n8n.internal.company.com
      - N8N_PORT=5678
      - N8N_PROTOCOL=https
      # 时区,不设的话定时任务会按 UTC 跑,坑过我不止一次
      - GENERIC_TIMEZONE=Asia/Shanghai
      - TZ=Asia/Shanghai
      # 数据持久化
      - N8N_USER_FOLDER=/data
      # 加密密钥,换容器不丢凭据(务必自己生成一个,别用默认值)
      - N8N_ENCRYPTION_KEY=这里换成你自己的随机字符串
      # 队列模式(生产环境建议开启,用 Redis 做队列)
      - EXECUTIONS_MODE=queue
      - QUEUE_BULL_REDIS_HOST=redis
      # 执行历史保留时间
      - EXECUTIONS_DATA_MAX_AGE=168
    volumes:
      - n8n_data:/data
      - /var/run/docker.sock:/var/run/docker.sock  # 需要操作 docker 时挂载
    depends_on:
      - redis

  redis:
    image: redis:7-alpine
    container_name: n8n-redis
    restart: unless-stopped
    volumes:
      - redis_data:/data

volumes:
  n8n_data:
redis_data:# 一键启动
docker compose up -d
# 检查状态
docker compose logs -f n8n五分钟就能跑起来。但跑起来只是开始,真正的价值在后面的工作流设计上。
二、第一个实战:告警自动分流,值班手机终于清净了
场景背景
我们监控用的是 Prometheus + Alertmanager,告警会推送到企微群。问题是所有告警都往一个群里怼——磁盘水位 85% 是它,服务宕机是它,某个不重要的定时任务失败也是它。值班同学看到手机响,还得先点开看是不是要紧事,一天下来光"辨别告警严重程度"就够烦的。
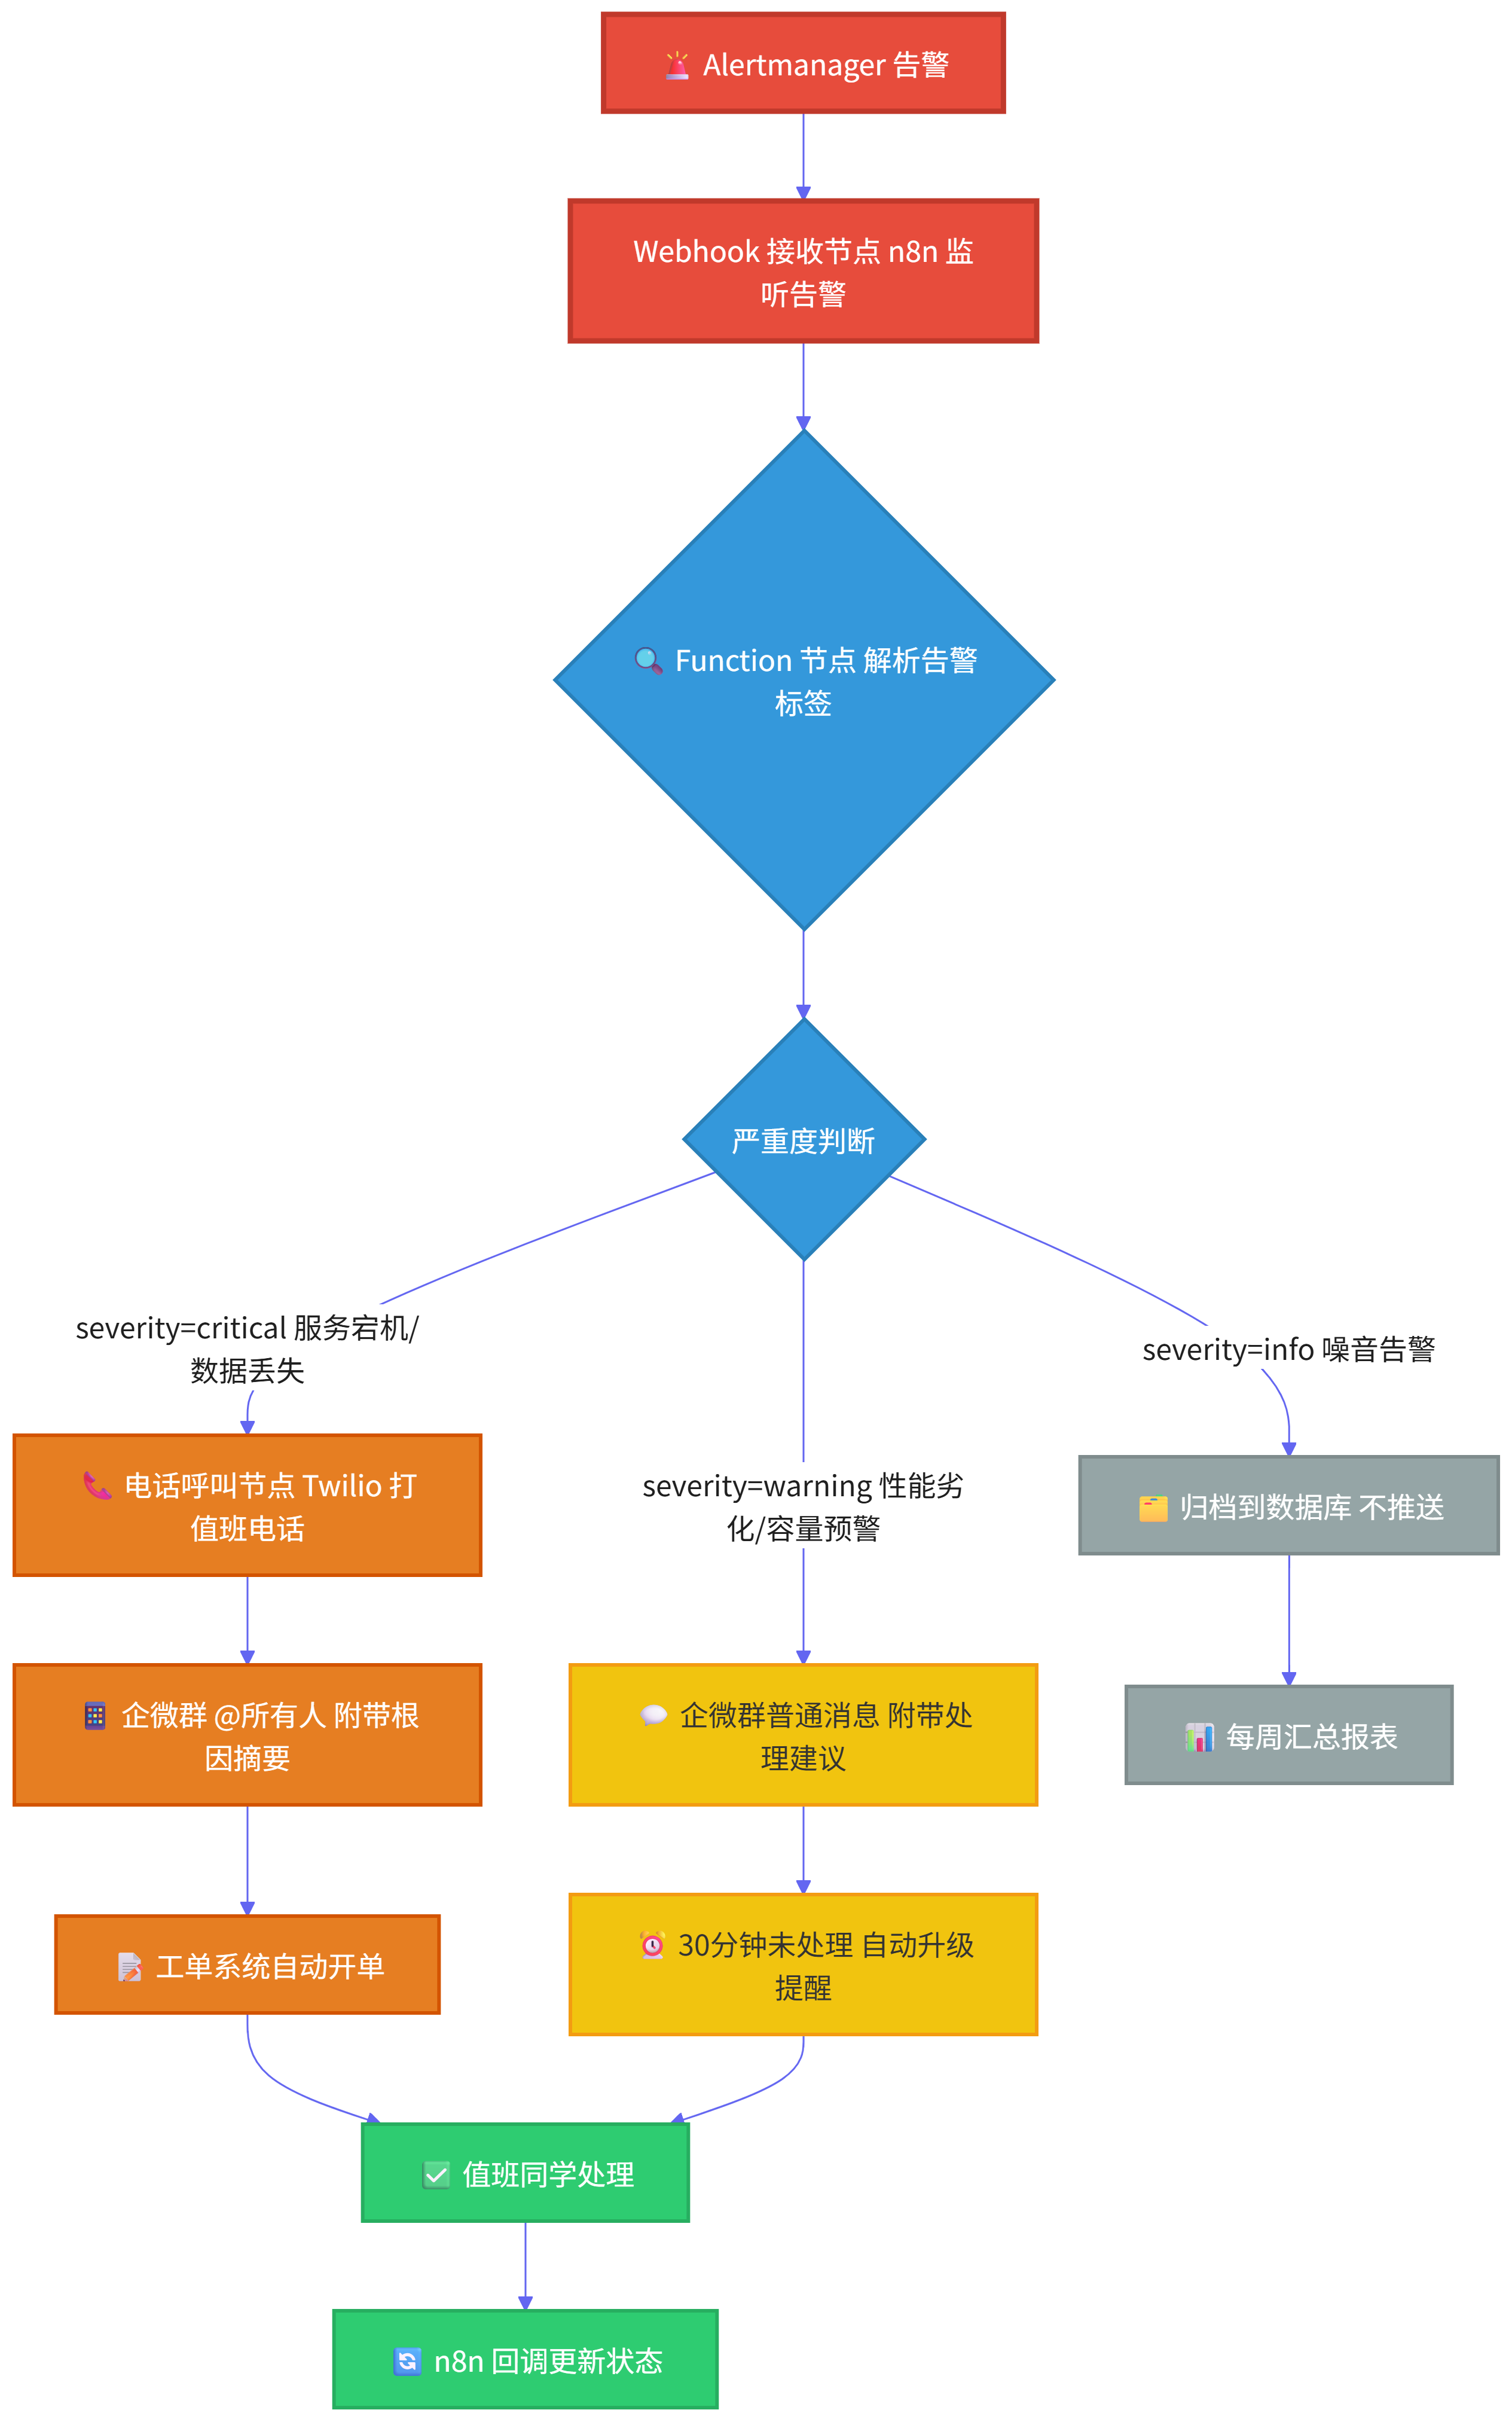
我用 n8n 搭了一条分流流水线,思路是:告警进来 → 先做严重度判断 → 严重的直接打电话 + 拉群,普通的发群消息,噪音级别的直接归档。
整个流程长这样:
关键节点实现
n8n 的核心逻辑写在 Function 节点里,贴一段实际的告警解析代码:
// Function 节点:解析 Alertmanager 告警并做分流决策
// 输入:Alertmanager webhook 的 payload

const alerts = $input.first().json.body.alerts || [];
const results = [];

// 严重度权重表:根据我们的业务实际情况定义
const SEVERITY_RULES = {
  // 直接打电话的:核心链路
  'ServiceDown': { level: 'critical', action: 'call_and_page' },
  'DatabaseReplicationLag': { level: 'critical', action: 'call_and_page' },
  'PaymentServiceError': { level: 'critical', action: 'call_and_page' },
  // 发群消息的:需要关注但不紧急
  'HighCPUUsage': { level: 'warning', action: 'notify_group' },
  'DiskSpaceLow': { level: 'warning', action: 'notify_group' },
  'CertificateExpiringSoon': { level: 'warning', action: 'notify_group' },
  // 归档不推送的:噪音
  'InstanceRestarted': { level: 'info', action: 'archive' },
  'TestJobFailed': { level: 'info', action: 'archive' },
};

for (const alert of alerts) {
  const alertName = alert.labels.alertname || 'Unknown';
  const rule = SEVERITY_RULES[alertName] || { level: 'warning', action: 'notify_group' };

  // 抑制逻辑:同一个实例 10 分钟内重复告警,只处理第一次
  const dedupeKey = `${alertName}:${alert.labels.instance}`;
  const lastSeen = $getWorkflowStaticData('global')[dedupeKey] || 0;
  const now = Date.now();

  if (now - lastSeen < 10 * 60 * 1000) {
    results.push({
      json: { ...alert, level: 'suppressed', reason: '10分钟内重复告警' }
    });
    continue;
  }
  $getWorkflowStaticData('global')[dedupeKey] = now;

  // 给企微消息生成一段"人话"摘要
  const summary = buildSummary(alert);

  results.push({
    json: {
      alertname: alertName,
      level: rule.level,
      action: rule.action,
      instance: alert.labels.instance || 'unknown',
      summary: summary,
      startsAt: alert.startsAt,
      // 打电话用的紧急程度标记
      needsCall: rule.action === 'call_and_page',
    }
  });
}

function buildSummary(alert) {
  const name = alert.labels.alertname;
  const instance = alert.labels.instance;
  const desc = alert.annotations.description || '';

  // 按告警类型定制话术,值班同学一眼看懂
  const templates = {
    'ServiceDown': `💥 服务挂了!${instance} 无响应,${desc}`,
    'DiskSpaceLow': `💾 ${instance} 磁盘快满了,${desc}。建议先看看日志是不是又没清理`,
    'HighCPUUsage': `🔥 ${instance} CPU 打满了,${desc}。可能是流量上来或者有死循环`,
    'CertificateExpiringSoon': `🔒 ${instance} 证书快过期了,${desc}。别等真过期了才想起来`,
  };

  return templates[name] || `⚠️ ${name}: ${desc || '无详细描述'}`;
}

return results;
然后 n8n 会按 action 字段走不同的分支——打电话的走 Twilio 节点,发群的走企微 Webhook 节点,归档的写入 Postgres。这些全是在画布上拖出来的,只有解析逻辑需要写代码。
实际效果
上线一个月后的变化:
指标 | 之前 | 之后 |
|---|---|---|
值班群日均消息数 | 140+ | 25 |
critical 响应时间 | 平均 8 分钟 | 平均 40 秒(电话叫醒) |
噪音告警打扰次数 | 每天二十多次 | 0 |
告警处理遗漏 | 偶尔发生 | 基本消除 |
最明显的是半夜的电话——以前 critical 告警混在群里可能十几分钟后才被看到,现在电话直接打过来,想睡过去都难。
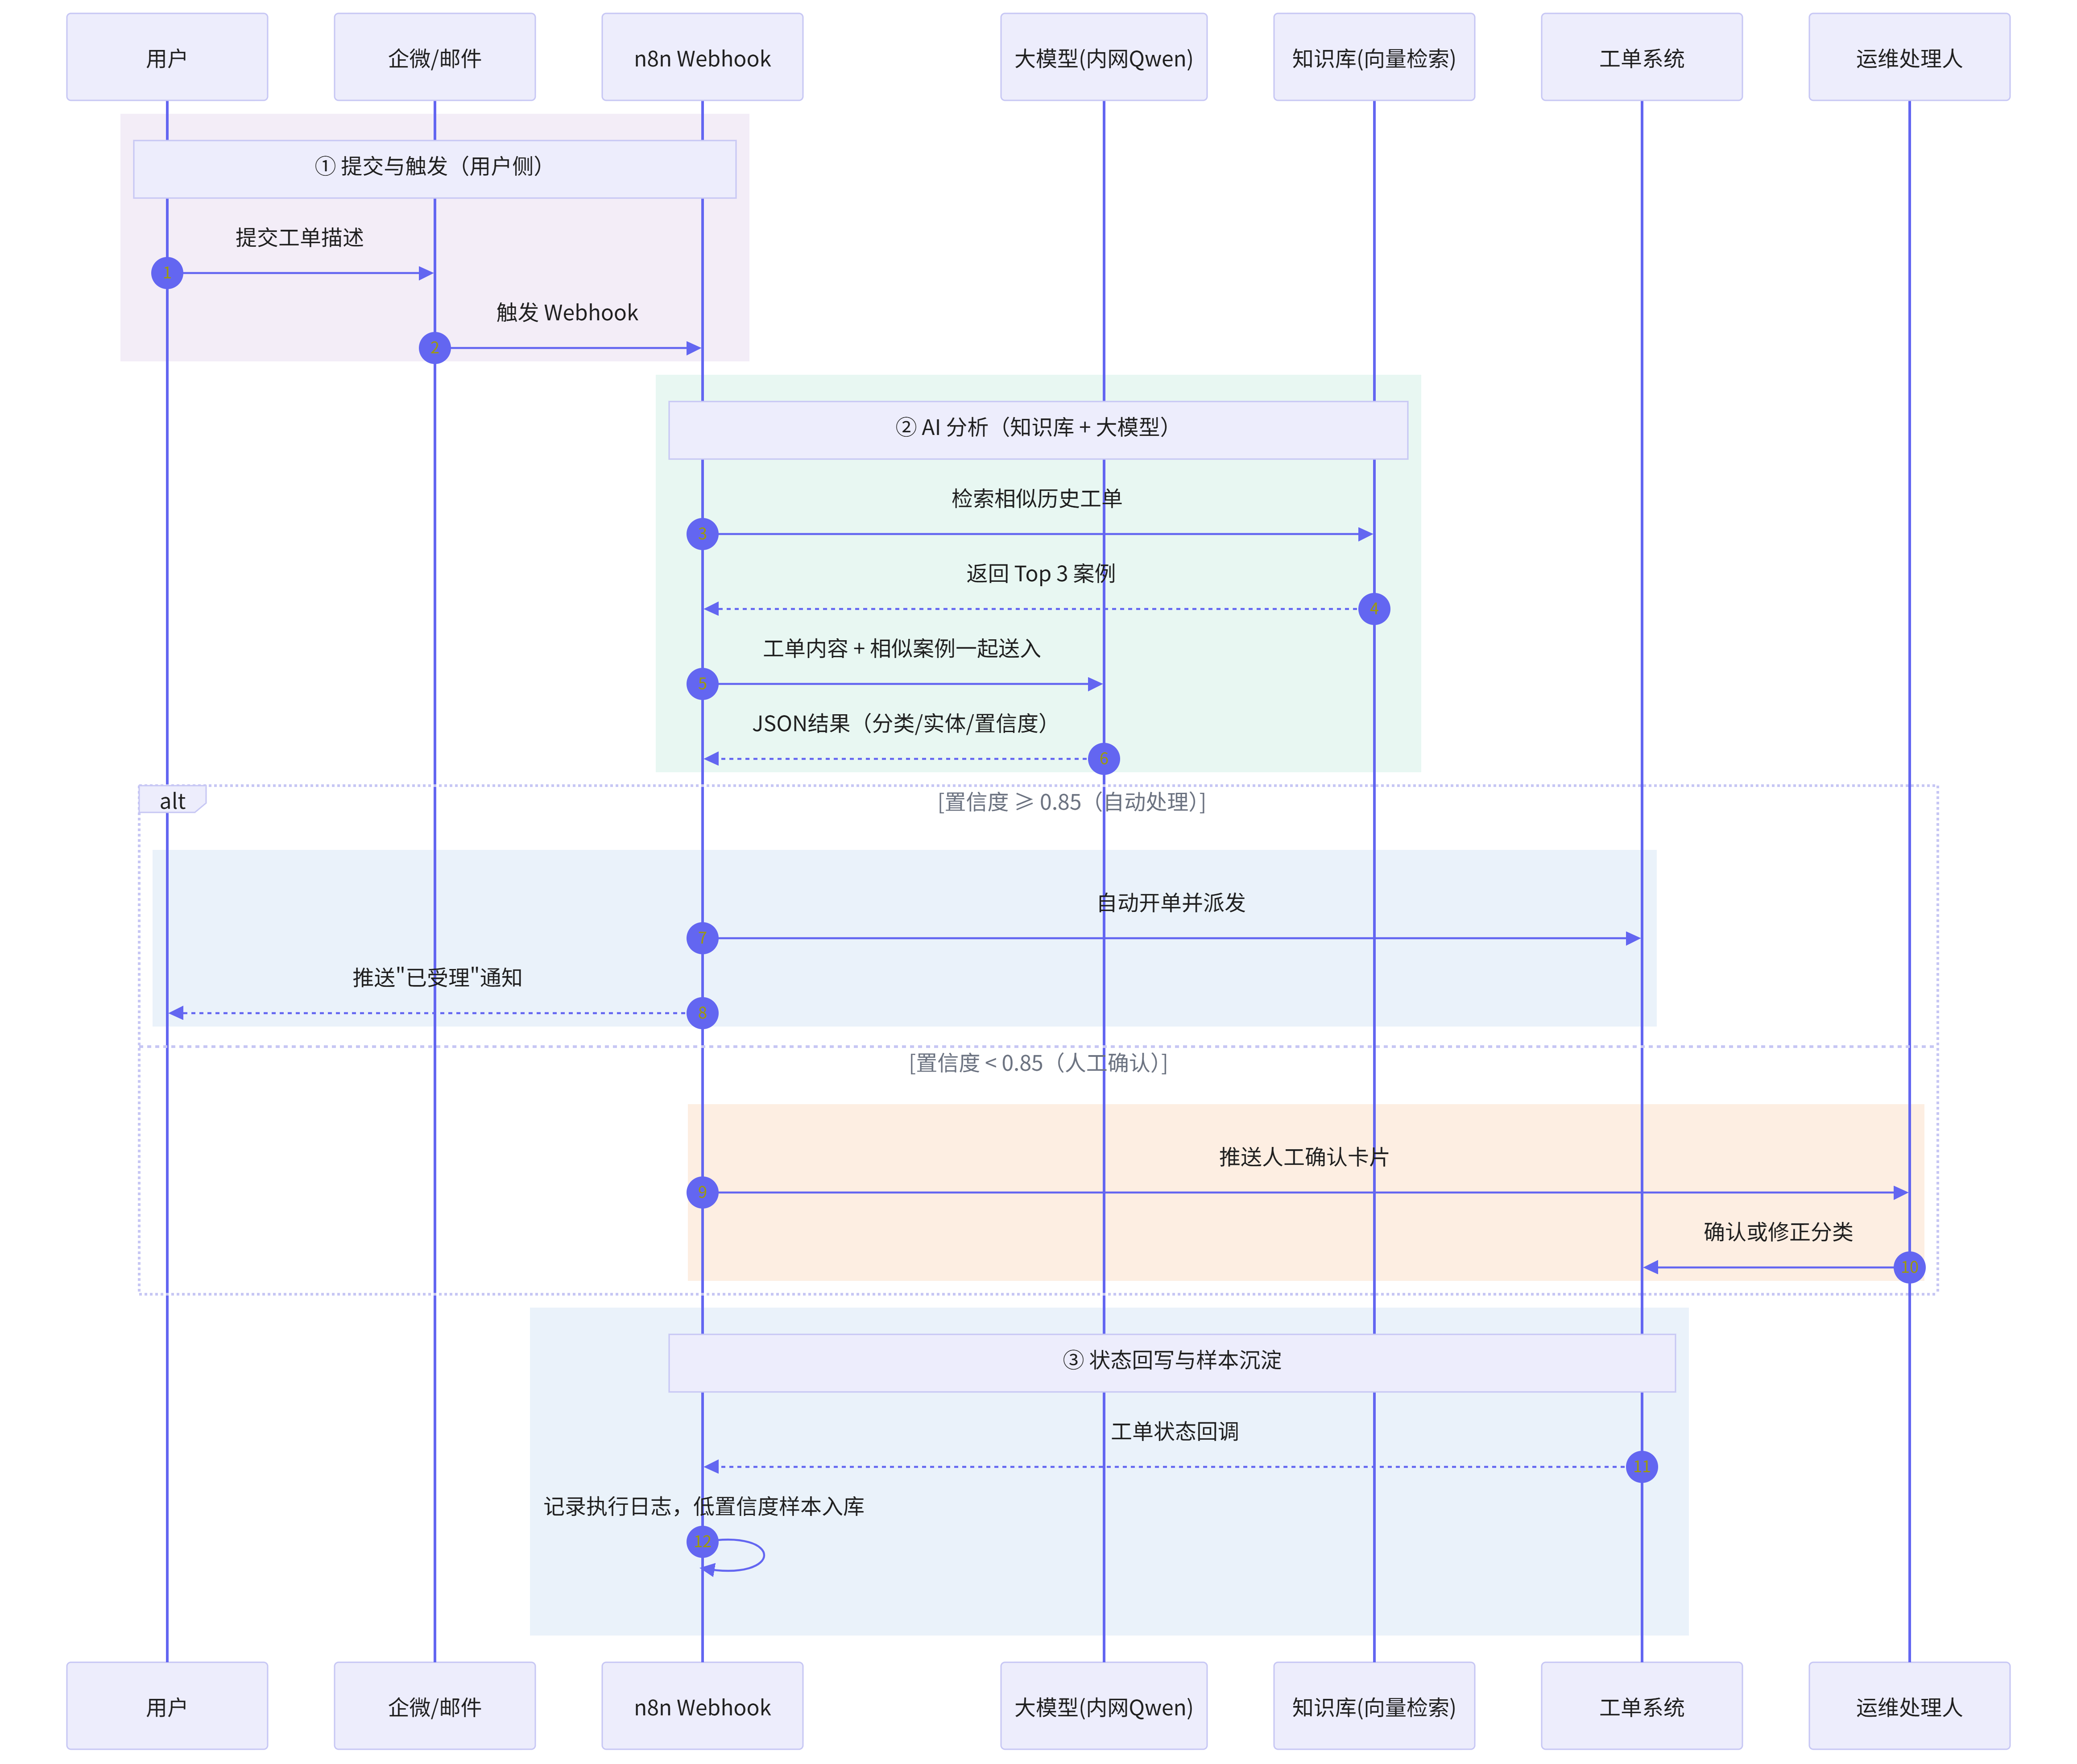
三、第二个实战:n8n + 大模型,工单自动分类
n8n 最近这一年最火的玩法是跟 AI 结合,它内置了 LLM Chain、AI Agent 等节点。我把之前写的"IT 工单分类"逻辑迁到了 n8n 上,感受很深:同样的功能,n8n 上从搭建到上线只用了一下午,自己写代码得两天。
对应的 Prompt 组装节点代码:
// Function 节点:组装 LLM 的 Prompt(带 Few-shot 和知识库上下文)
const ticket = $input.first().json;
const similarCases = $('向量检索').all().map(i => i.json);

// 相似案例作为 few-shot 塞进 prompt,实测能提升 15% 左右准确率
const caseExamples = similarCases.map(c =>
  `示例工单: "${c.description}"\n分类: ${c.category} | 处理组: ${c.team} | 平均耗时: ${c.avg_hours}h`
).join('\n---\n');

const prompt = `你是 IT 工单分类助手。参考以下历史相似工单的分类结果,分析新工单。

历史相似工单:
${caseExamples}

新工单: "${ticket.description}"

请输出 JSON(不要输出其他内容):
{
  "category": "分类(hardware/network/account/software/other)",
  "team": "建议处理组(desktop_support/network_ops/sysadmin/app_support)",
  "entities": {"设备/系统": "", "位置": "", "现象": ""},
  "confidence": 0.0到1.0,
  "reasoning": "一句话判断依据",
  "estimate_hours": 预估处理小时数
}

注意:confidence 低于 0.7 就老实承认,别硬编。低置信度会走人工确认。`;

return [{ json: { ...ticket, prompt } }];
后面接 HTTP Request 节点调内网模型,再接一个 Function 节点做置信度分流。整条链路在 n8n 画布上看得清清楚楚,测试的时候还能单节点重跑——这个体验比裸写代码舒服太多。
四、定时任务全家桶:那些"每周都得干一遍"的事
除了事件驱动,n8n 的定时工作流也接管了我一堆例行任务。列几个典型的:
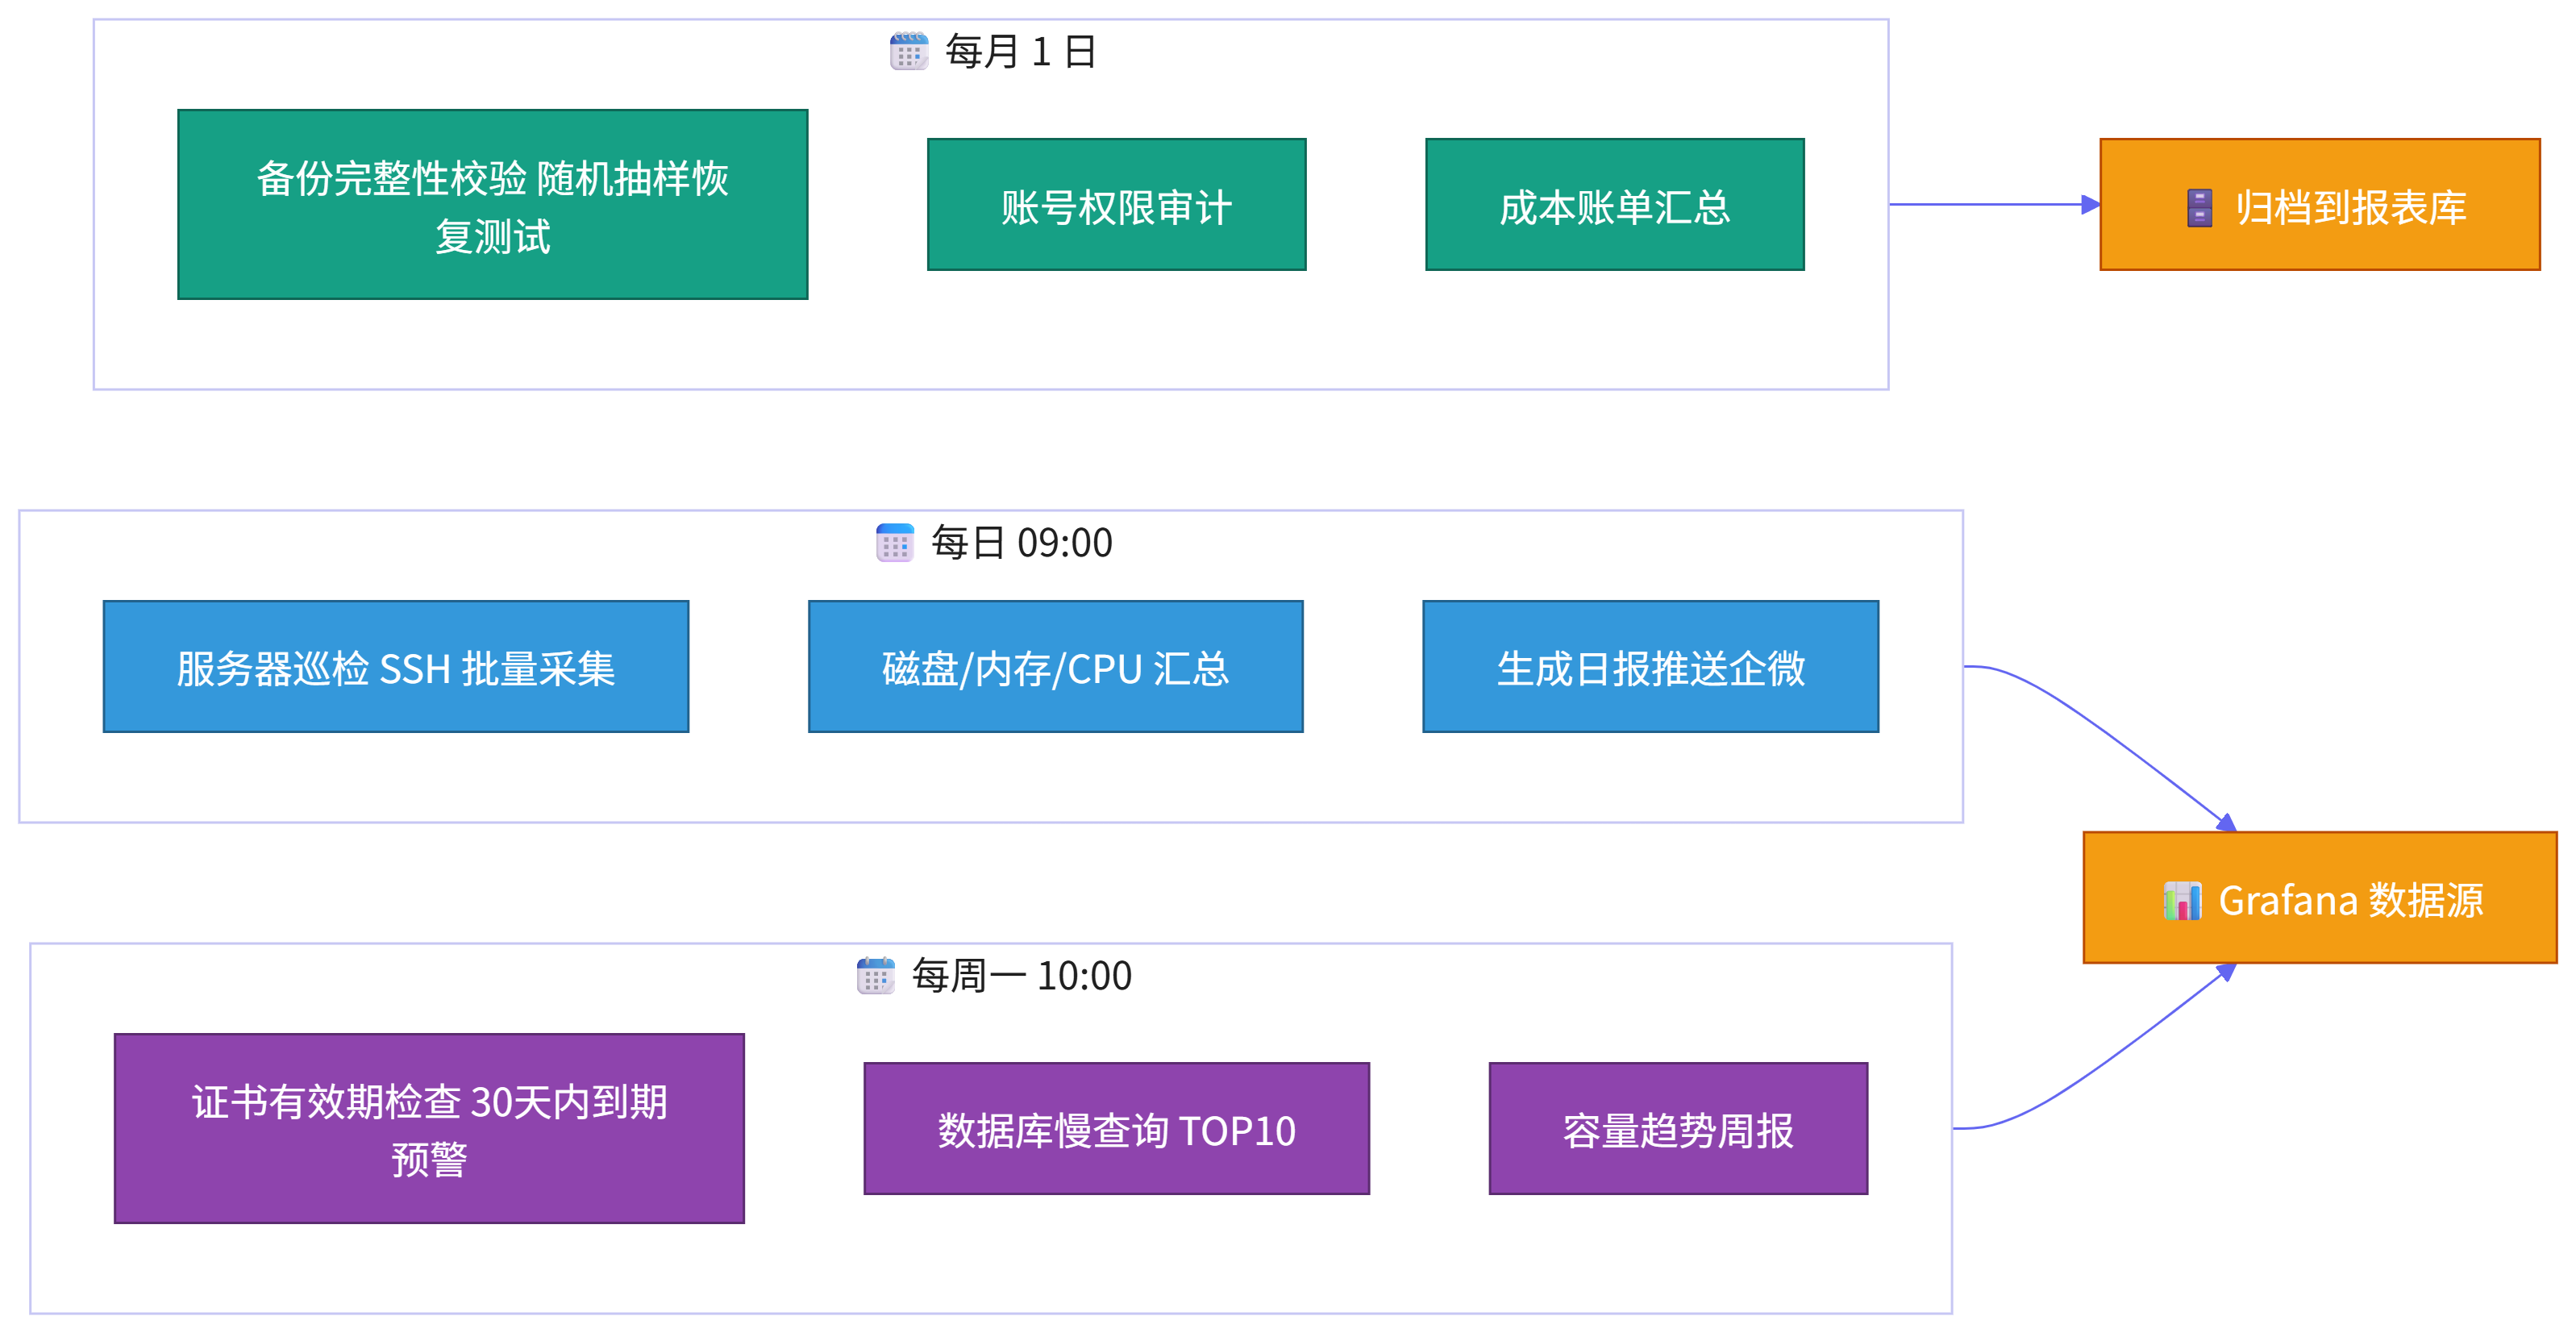
拿"备份完整性校验"举个例子——这个任务以前是写在 crontab 里的,但恢复测试没人真跑过,直到有一次真需要恢复数据时发现备份文件是坏的,差点出大事。迁到 n8n 之后,每月 1 号自动抽样三个备份文件做真实恢复演练,恢复失败直接电话告警:
#!/bin/bash
# n8n 的 Execute Command 节点里调用的恢复测试脚本
# 随机抽取最近的备份文件做恢复演练

BACKUP_DIR=/backups/postgres
TEST_DB=restore_test_$(date +%s)

# 随机抽 3 个最近 7 天的备份
picks=$(find $BACKUP_DIR -name "*.sql.gz" -mtime -7 | shuf -n 3)

fail_count=0
for backup in $picks; do
    echo "开始恢复测试: $backup"

    # 解压 + 恢复到测试库
    if gunzip -c "$backup" | psql -h localhost -U postgres -c "CREATE DATABASE $TEST_DB" \
       && gunzip -c "$backup" | psql -h localhost -U postgres -d $TEST_DB; then

        # 校验关键表行数 > 0
        row_count=$(psql -h localhost -U postgres -d $TEST_DB -tAc \
            "SELECT count(*) FROM users LIMIT 1")

        if [ "$row_count" -gt 0 ]; then
            echo "✅ $backup 恢复测试通过 (${row_count} rows)"
        else
            echo "❌ $backup 恢复后数据为空!"
            fail_count=$((fail_count+1))
        fi
    else
        echo "❌ $backup 恢复失败!"
        fail_count=$((fail_count+1))
    fi

    # 清理测试库
    psql -h localhost -U postgres -c "DROP DATABASE IF EXISTS $TEST_DB"
done

# 输出结果给 n8n,失败数 > 0 时 n8n 会走电话告警分支
echo "{\"fail_count\": $fail_count, \"total\": $(echo "$picks" | wc -l)}"
exit 0
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号