pdf打开显示错误,先分清文件损坏还是阅读器打不开,再用 qpdf 就地重写修复
原创
pdf打开显示错误,先分清文件损坏还是阅读器打不开,再用 qpdf 就地重写修复
原创
软领
发布于 2026-09-28 09:33:27
发布于 2026-09-28 09:33:27
PDF 打开显示错误,多数时候问题出在文件本身:下载没下完、传输中被截断,或者阅读器版本过旧渲染不出来。文件通常还有得救,不必急着重装系统,也不用把机器送修。
排查顺序是固定的:先用浏览器换一种打开方式,把「文件坏了」和「阅读器打不开」这两件事分开;再用 qpdf --check 查内部结构,能读的文件就地重写;结构损坏严重的用 Ghostscript 整份重写,把能解析的页面救回来;最后核对大小与哈希,把预防做在下载环节。按这个顺序走,前两步就能给大部分情况定性。
只有个别页损坏的情况,不必修整份文件,用 Microsoft Print to PDF 把正常页单独导出来就行。这类故障多数来自下载环节和旧版阅读器,硬盘和系统本身一般没坏。
适用系统:Windows 10/11;最后更新:2026-09-27。
先分清是文件坏了还是阅读器打不开
双击一份 PDF,阅读器弹出「载入 PDF 时发生错误」,或者提示「本页面上存在错误」,页面刷成一片空白,翻页也不动。换个阅读器再开,还是原样。报错原文常见这两句:
- 此文件已损坏,无法修复
- 无法打开文件,因为它不是受支持的格式
先判断是文件坏还是阅读器坏,再对症处理,能省下大量盲目重装和反复换工具的时间。
方法一 换一种打开方式,先划定问题范围
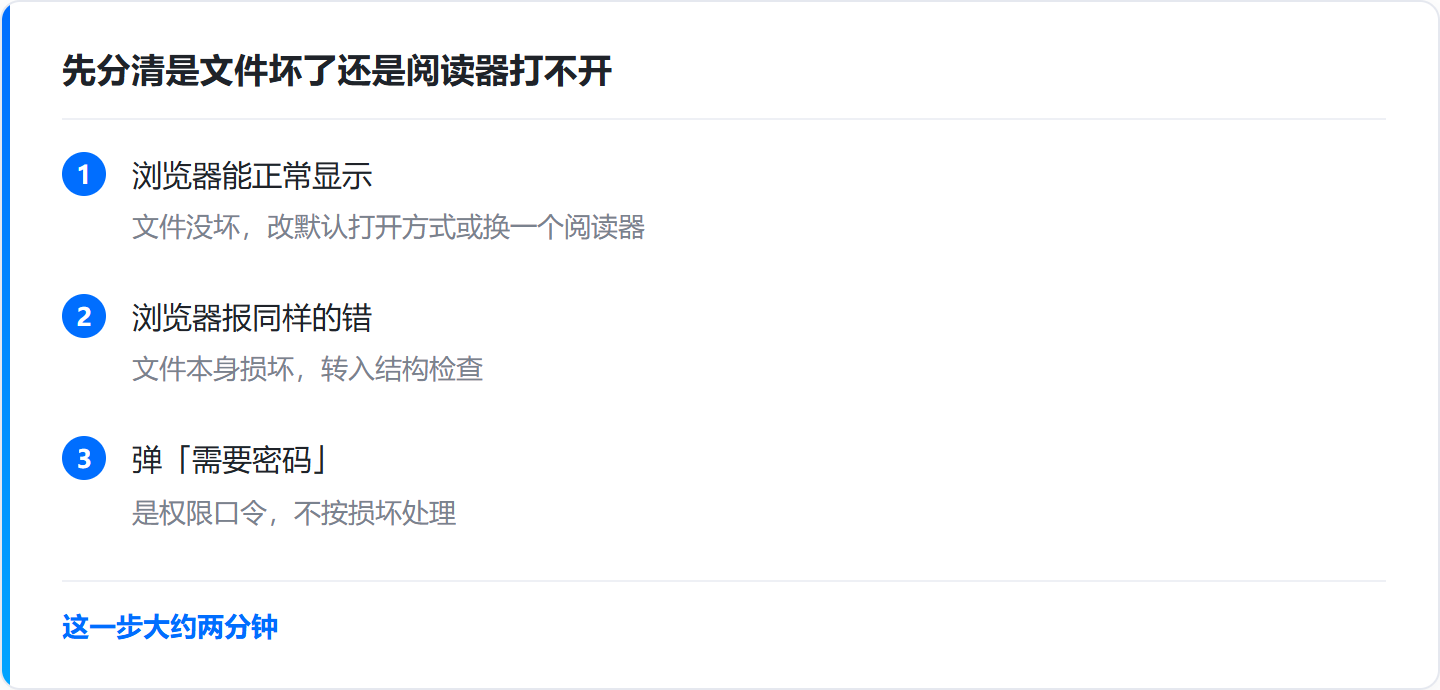
同一个 PDF 用浏览器和另一台电脑各开一次,就能分清是阅读器的问题还是文件本身的问题。这一步只花两分钟,却决定了后面走哪条修复路线。
- 右键该 PDF → 打开方式 → 选择 Microsoft Edge 或 Google Chrome;把文件直接拖进浏览器窗口里也能开。
- 浏览器能正常显示:说明文件没坏,是阅读器的问题。回阅读器里把该 PDF 重新设为默认打开方式,或者换一个阅读器再开。
- 浏览器同样报「载入 PDF 时发生错误」:说明文件本身损坏,直接跳到方法二继续排查。
- 把文件复制到 U 盘或另一台电脑上再双击打开,同样报错可以再次确认是文件的问题。
- 顺带确认没有被加密或加过权限口令:弹出的是「需要密码」,那就不属于损坏。
浏览器能打开就换默认打开方式,打不开就往文件损坏这条路上查,方向一次就能定下来。
换阅读器这一步只做判断,不做修复。方向定下来之前,别在阅读器里反复点「修复」类按钮——多数阅读器修的是自己的渲染状态,改不了文件结构。
检查文件是不是没下载完整
右键看大小、用哈希比对,能排掉很大一部分其实是下载断了的假损坏。文件结构并没有坏,只是写到一半就停了,任何阅读器都打不开。
方法二 大小与哈希两步核对
- 右键 PDF → 属性,看「大小」是不是 0 KB,或者明显小于来源页面标注的体积。
- 大小为 0 KB 或明显偏小:删掉后重新下载一次,下载中不要中断,也不要中途改名。
- 按
Win+R输入powershell回车,算出本地哈希,命令见下。 - 把结果和来源方给出的 MD5/SHA1 值逐位对比,不一致说明传输过程被改动过,重新获取。
- 网盘、邮件附件、聊天工具传的文件容易被截断,优先回原始出处重新下载。
Get-FileHash 'D:\a.pdf' -Algorithm MD5文件打不开的成因并不复杂,常见的就三类,各自的定性不一样:
- 大小为 0 KB:下载中断,内容根本没写进去,换一种下载方式重新取。
- 哈希与来源不一致:传输中被改动或截断,回最早给出的出处重取一份。
- 大小正常、个别页打不开:页级损坏,少数页的数据读不出来,走方法三、方法四。
用 qpdf 检查结构并就地重写
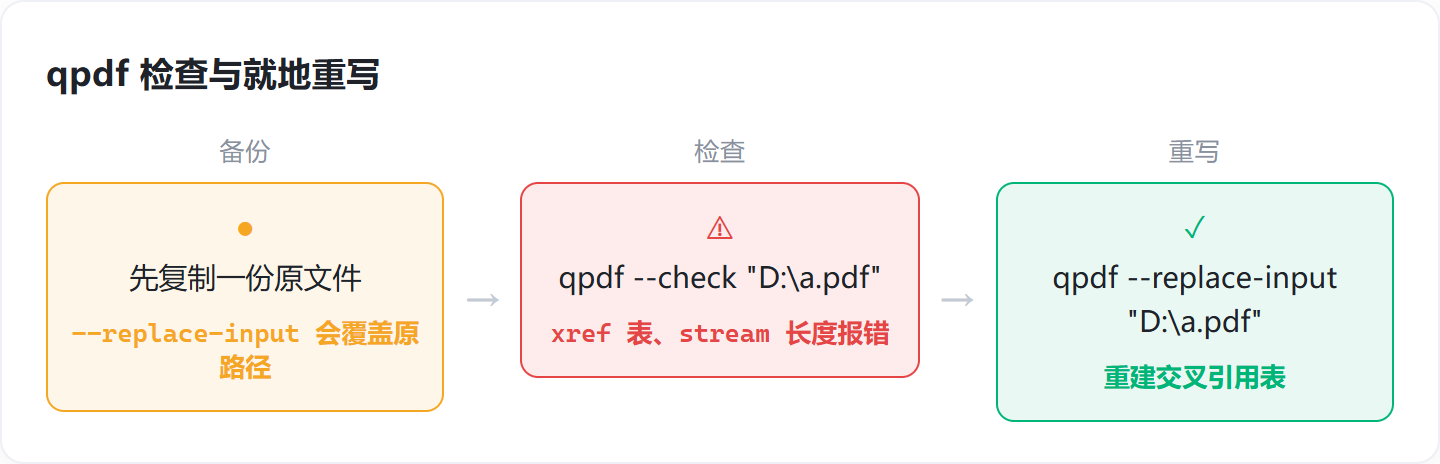
qpdf --check 会直接报出交叉引用表、语法、stream 长度的具体错误,能读出来的文件还能就地重写修好。解压后把它放在短路径下,比如 D:\qpdf,命令行切到该目录再执行;路径里带空格时,记得用引号包住整个文件名。
方法三 读出结构问题,能读就地重写
- 解压 qpdf 后,在存放目录打开命令行,运行
qpdf --check "D:\a.pdf"。 - 关注输出里的
syntax error、xref 表损坏、stream 长度不符这几类报错,它们对应不同的坏法。 - 只报 warning 且文件能正常读:直接就地重写修复。
- 动手之前先复制一份原件,
--replace-input会覆盖原路径。 - 重写后再跑一次
qpdf --check确认报错消失,仍报错就交给方法四整份重写。
qpdf --check "D:\a.pdf"
qpdf --replace-input "D:\a.pdf"
输出里出现 file is damaged 时,qpdf 会尝试重建交叉引用表,能读完就说明主体数据还在;如果卡在 can't find /Root dictionary,说明文件入口对象已经丢了,只能走整份重写。整条链路很短:先用 --check 读出结构问题,看到 xref 表错误就用 --replace-input 原地重写一遍。
用 Ghostscript 整份重写
Ghostscript 会逐页重新解析内容流,再写出一个新文件,多页级别的损坏大多能把可解析的页面救回来。装的时候注意位数,命令名也跟着变:64 位是 gswin64c,32 位是 gswin32c。
方法四 整份重新写出一个文件
- 安装 Ghostscript,进入安装目录的
bin,例如C:\Program Files\gs\gs10.0\bin。 - 在该目录打开命令行,运行下面这条命令。
- 命令跑完看输出行数:报页数就说明已经重新写出;中途报
could not open之类的行,说明该页解析失败。 - 打开生成的
fixed.pdf逐页翻,缺的页通常就是原始文件里彻底坏掉的那几页。 - 重写会把书签、表单、注释一并压平,重要文件先留好原件再交给它处理。
gswin64c -o "D:\fixed.pdf" -sDEVICE=pdfwrite "D:\a.pdf"如果提示 Unrecoverable error, exit code 1,说明整份文件连首页都解析不了。这时别在命令参数上继续耗,转到方法五,只救能读的页面。
只救正常页,预防做在前面
个别页坏了就没必要修整份文件,先把正常页导出来更省时间。导出这一步走的是系统自带的 Microsoft Print to PDF,不用再装别的工具。
方法五 导出正常页
- 在能打开该文件的阅读器里按
Ctrl+P,打印机选择Microsoft Print to PDF。 - 页面范围里排掉空白页和报错页,只导出正常页,另存为一个新的 PDF。
- 损坏页需要保留时,回原始出处重新获取,或者对纸质原件重新扫描。
- 扫描件导出时把单页分辨率控制在 200–300 dpi,避免单页体积过大导致渲染失败。
- 每次下载完先核对文件大小,再比一次哈希,确认完整后再归档。
预防按三层把关:
- 下载环节:核对文件大小,再比一次哈希,与来源标注不一致就重新获取
- 扫描环节:单页分辨率压在 200–300 dpi 之间
- 归档环节:单页体积别做得太大,以免渲染失败;查过的文件顺手存一份原始版本,下次再遇到损坏可以直接比对
什么情况下不适用
情况 | 为什么这条路走不通 | 建议 |
|---|---|---|
打开时弹出「需要密码」 | 不是文件损坏,是权限口令或加密 | 先拿到口令,解密后再打开 |
整份文件连首页都解析不了 | 入口对象已经丢失 | 只导出能读的页面,或对原件重扫描 |
坏掉的正是唯一有效的那几页 | 重写也救不回来 | 回源头重新取一份,纸质原件则重扫 |
文件是别人转发的,来源不可回溯 | 拿不到原始的 MD5/SHA1 值 | 只能靠大小和逐页翻看判断完整性 |
常见问题
pdf 打开显示本页面上存在错误是什么原因?多半是文件在下载或传输中被截断,交叉引用表和页面对象对不上号;也有阅读器版本过旧、渲染某个内嵌字体失败的情况。先用浏览器打开一次把方向定下来,再按方法二到方法四往下排查。
打开 pdf 提示载入错误,qpdf --check 报 xref 表损坏怎么修?先复制一份原件放好,再在命令行运行 qpdf --replace-input "D:\a.pdf" 就地重写,它会重建交叉引用表。完成后重新检查一次,报错消失说明结构已经修好;仍然报错就交给 Ghostscript 整份重写。
PDF 能打开但中间几页是空白,是文件坏了还是阅读器的问题?大多是这几页的页面对象损坏,阅读器读到空对象就渲染成白页。把文件拖进 Edge 或 Chrome 再翻一遍,空白位置一样就是文件本身的问题,位置不一样才考虑换阅读器。
下载的 PDF 属性显示 0 KB,重新下载还是打不开怎么办? 0 KB 说明文件根本没有写进去,先换一个下载方式,或者让浏览器直接保存,不要交给下载工具接管。拿到文件后右键看大小是否和来源页面标注的一致,再用 Get-FileHash 比一次 MD5。
用 gswin64c 重写后仍提示语法错误该怎么处理?看输出里报错对应的页码,那几页通常已经彻底损坏,重写也救不回来。这时改用 Microsoft Print to PDF 导出剩余的正常页,缺的那几页需要从上游再取一份,纸质件则重新扫描。
相关阅读
推荐阅读
- PDF 打不开文件损坏怎么办,5 个方法从换阅读器开始
- PDF 页面显示不全,先用浏览器打开对照判断问题出在哪
- PDF 文件加密怎么解除打印,先分清打开密码还是权限密码再处理
- PDF 打不开什么原因,排查顺序与修复方法
- PDF 加密码怎么设置,加密后客户打不开可按 5 步排查
相关推荐
- PDF 合并失败先查单个文件,只读属性和打开密码最容易拦下来
- PDF 转图片不清晰,先分清是导出 DPI 太低还是源文件本身模糊
- PDF 怎么加页码,先判断有源文件还是没源文件再动手
- Word 转 PDF 图片模糊,先分清是导出压缩还是转换 DPI 的问题
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号