FDE(前线部署工程师):定义、工作方法与案例
原创
FDE(前线部署工程师):定义、工作方法与案例
原创
一深思AI
发布于 2026-09-29 15:55:00
发布于 2026-09-29 15:55:00
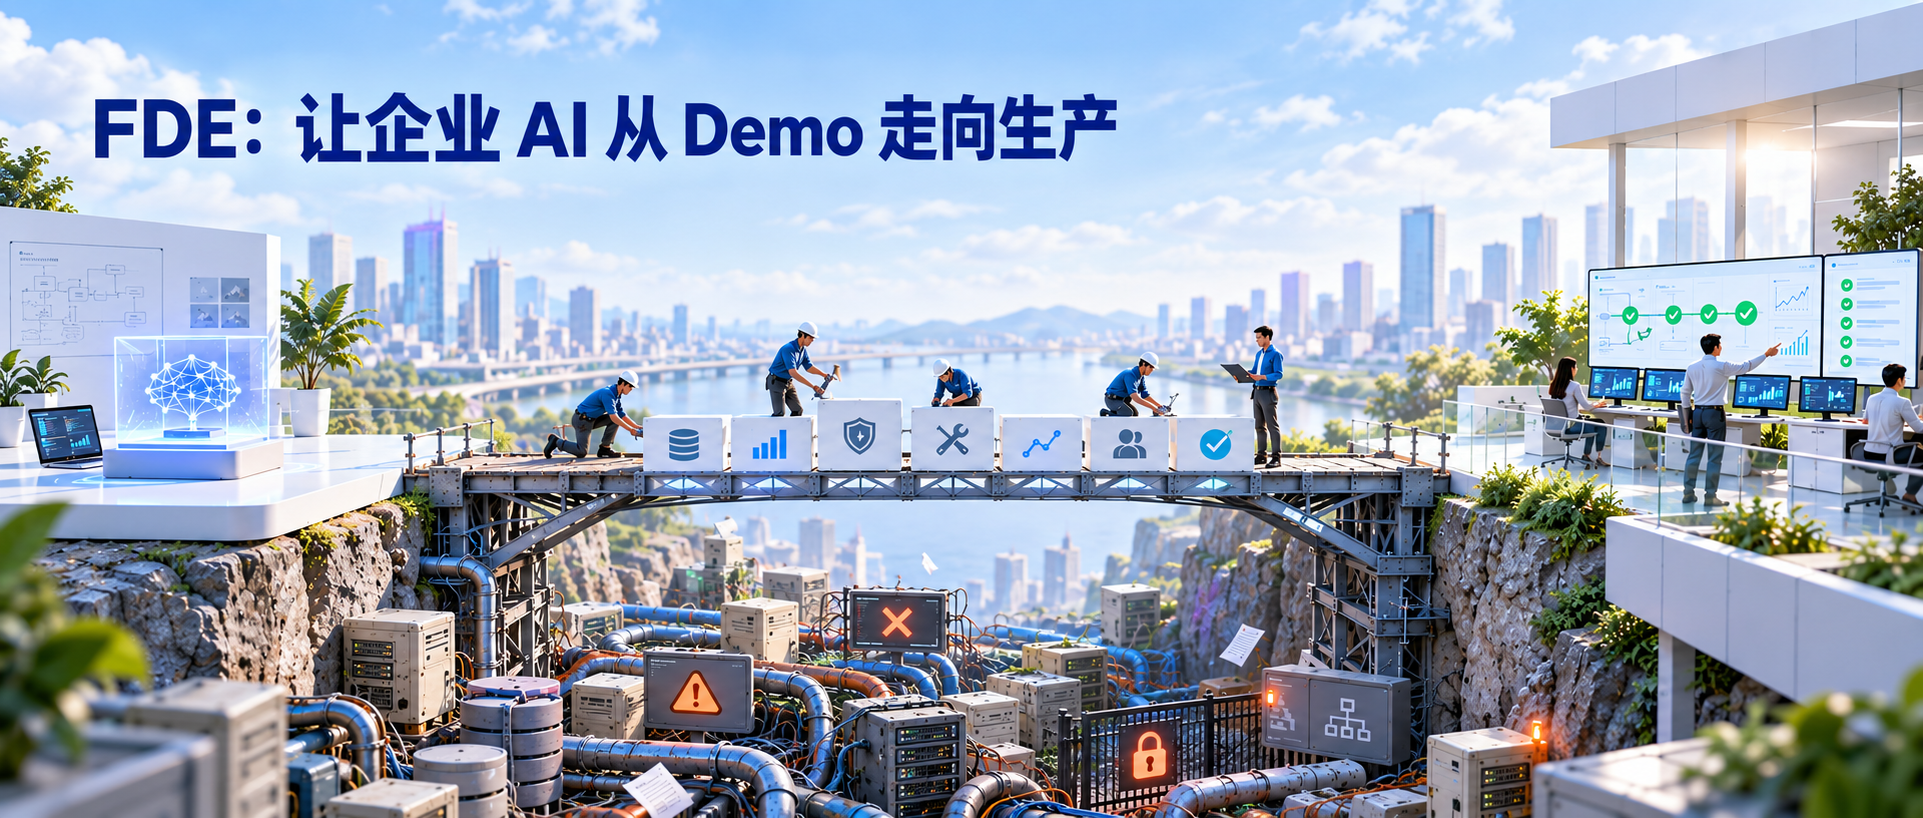
FDE:让企业AI从Demo走向生产
ENTERPRISE AI · FIELD NOTES
FDE(前线部署工程师):定义、工作方法与案例
FDE站在AI模型与企业真实生产系统之间:进入客户现场,理解业务与数据,亲手完成集成和交付,再把一线经验带回产品与研究团队。
AI时代,FDE如何把尚不成熟的AI能力部署进企业核心业务,并通过评估、规则、工具、信任建设和产品回流,让AI从原型走向生产。
一、FDE是什么
1.1 起源:Palantir的“Delta”
FDE这个角色在2010年代初出现在Palantir。Palantir内部叫它“Delta”,正式职位名称是Forward Deployed Software Engineer(FDSE)。这个名字来自早期业务拓展团队按北约音标字母命名的习惯。Delta归属业务拓展部门;负责开发平台的产品研发工程师,内部叫Dev,归属产品开发部门E。
约2016年以前,Palantir的FDE人数比普通软件工程师还多。2016年推出Foundry平台后,不少FDE转回软件工程师,把现场经验带进了核心产品D。
1.2 定义
Dev是“一种能力,服务多个客户”;Delta是“一个客户,调用多种能力”。
Palantir的定义:Delta把公司的软件平台部署到客户那里,职责是替客户实现技术成果,成败看对客户目标的实际影响。客户项目缺功能或遇到Bug时,Delta可以直接改核心产品代码,但要和产品团队协调;较大的需求要经过产品路线图评审E。
The Pragmatic Engineer的描述:FDE在两种环境之间切换:嵌入客户团队,以及回到公司的核心产品团队。通常需要去客户现场,工作环境可能是工厂车间、Airbus总装线,甚至物理隔离的网络。这个角色类似创业公司的CTO,一个小团队端到端负责一个高风险项目D。
OpenAI FDE负责人Colin Jarvis的说法:FDE的工作是“eat pain and excrete product”——消化痛苦,产出产品A。团队的北极星指标是:“You must leave with product”——必须带着产品离开C。
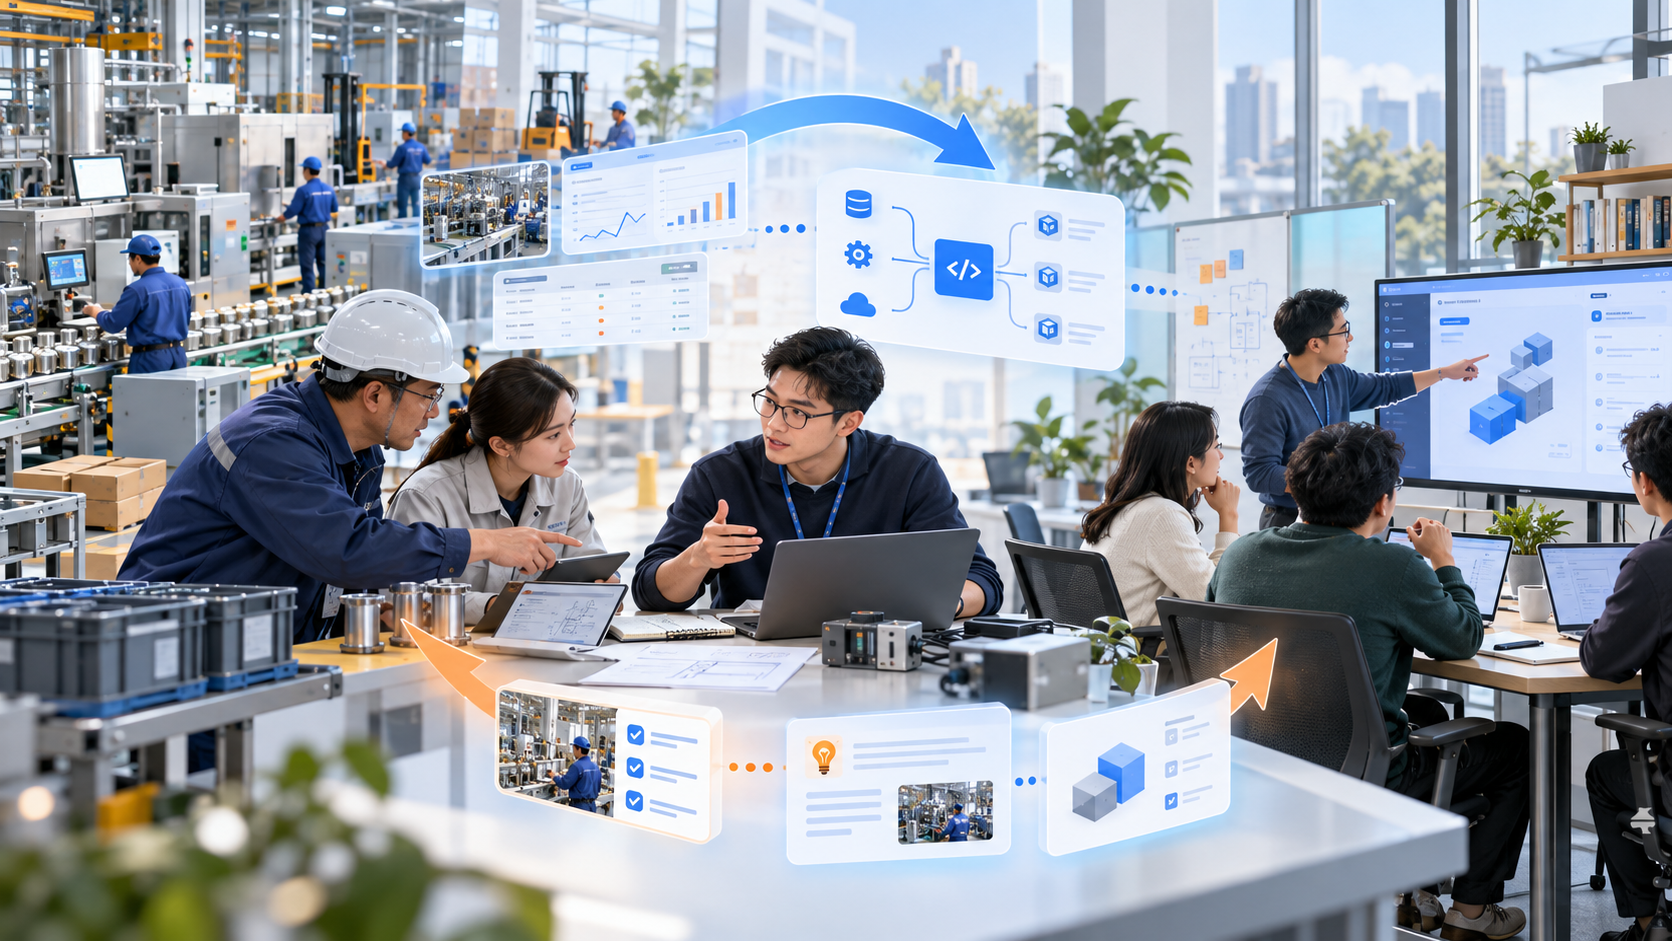
FDE连接客户现场与核心产品团队
FDE既服务客户,也把现场经验、代码和可复用能力带回核心产品。
1.3 与相近角色的区别
对比 | FDE | 对方 |
|---|---|---|
产品研发工程师 | 一个客户,调用多种能力;成败看客户目标是否实现 | 一种能力,服务多个客户;负责平台的某个组件 |
咨询顾问 | 与客户一起做长期方案,部署现成软件产品,工程工作量更大 | 提供一次性的分析、建议或方案 |
解决方案架构师 | 直接在客户基础设施上用客户工具写代码,面对更多不确定性 | 偏顾问角色,通常以匿名或离线数据完成MVP和PoC |
1.4 为什么在AI时代重新火起来
- 从2025年初开始,FDE招聘量明显上升,主要驱动力是企业AI集成需求D。
- 政府机构和传统企业流程复杂。派驻具有创业思维的工程师,往往能绕过组织阻力,加快集成。
- Colin Jarvis引用MIT研究称,95%的企业AI部署对损益几乎没有可量化影响。FDE团队的定位,是让AI真正产生业务结果。这里的“失败”不是技术无法运行,而是缺少可量化价值AB。
- 技术就绪之后,还需要专门的信任建设,才能真正进入生产。
二、FDE的工作方法
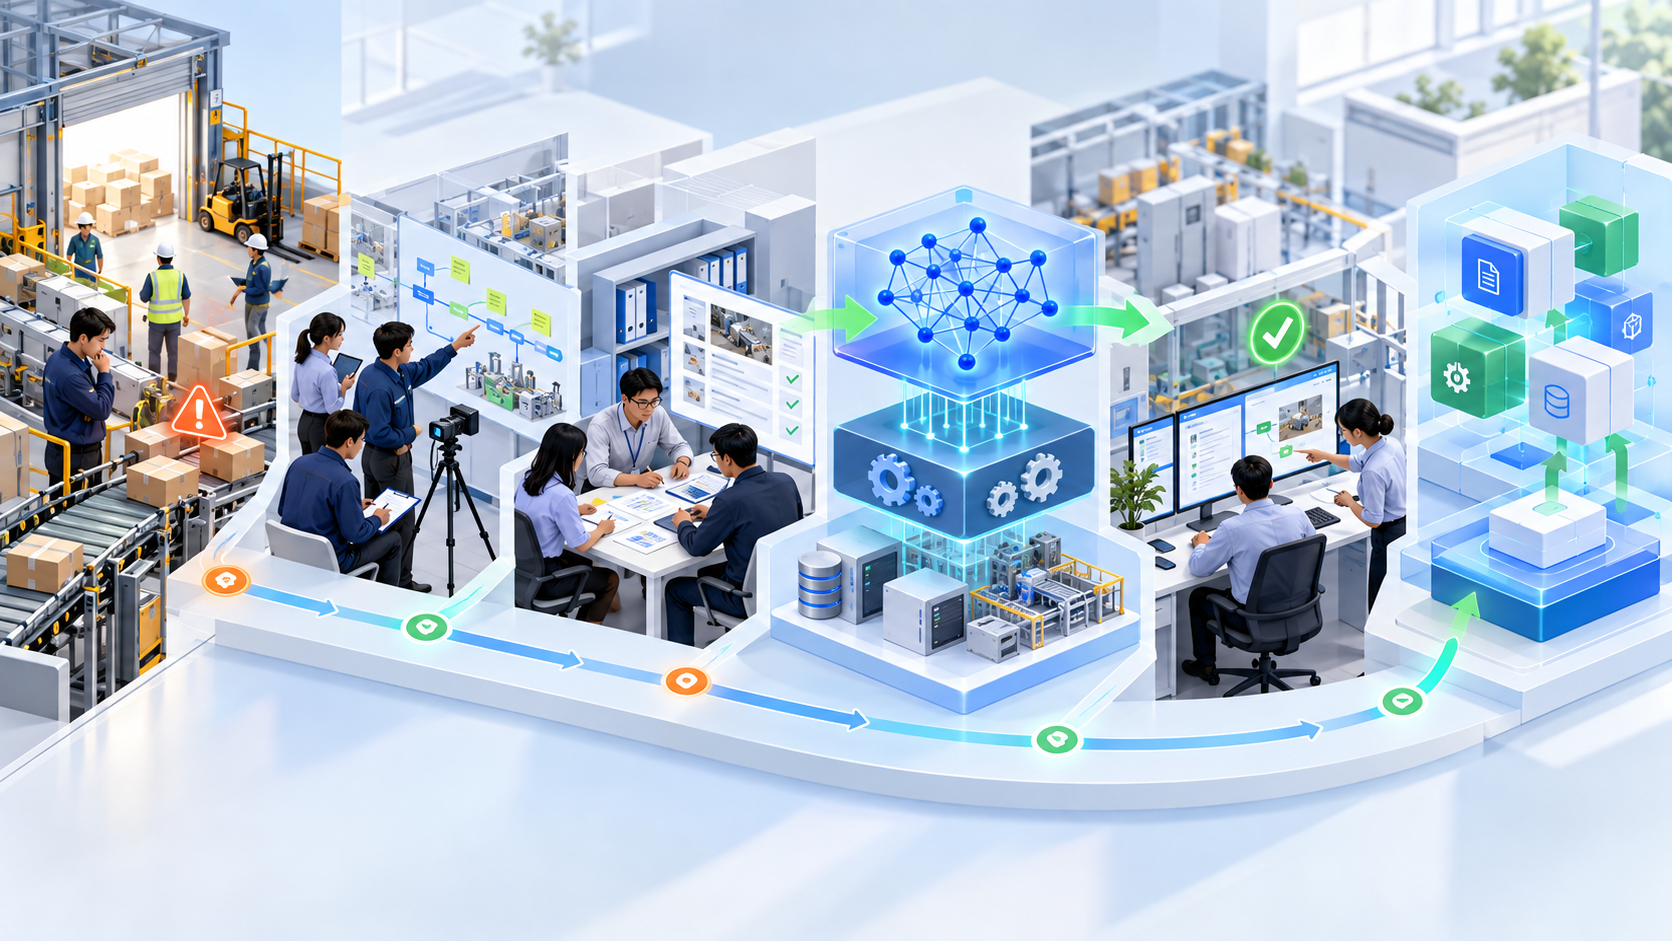
FDE推动企业AI落地的完整工作方法
从现场问题、评估与规则分层,到最小端到端交付和产品沉淀。
2.1 选题:只做高价值问题
- OpenAI FDE只接能为客户节省或创造数千万到数十亿美元价值的问题A。
- 产品假设驱动:为某项能力寻找理想设计合作伙伴,例如客服、临床试验文档。
- 研究驱动:进入半导体、生命科学等技术难度高的行业,即使暂时看不到产品方向。
- 选核心业务,不选边缘场景。核心业务更容易获得组织投入,效果也更容易衡量。
2.2 项目三阶段
阶段 | 做法 |
|---|---|
1. 早期范围界定 | 在客户现场待几天,梳理流程,用合成数据做原型,确定优先级。 |
2. 验证 | 确认范围是否真的最有价值;构建评估集,扩大标注规模,基于评估迭代,最后提交报告。 |
3. 交付 | 每周去客户现场几天,大部分构建工作在公司完成,目标是交付“最小的端到端单元”。 |
客户在范围界定时的描述,常与真实的数据和系统情况不符。我们要快速撞到那些“砖墙”,然后调整范围。
2.3 评估驱动开发
核心原则:任何由LLM驱动的功能,只要还没有一套能验证其效果的评估,就不算完成AC。
- 大规模开发之前,先和客户领域专家一起建立评估集。
- 依据“专家轨迹”构建评估集,即人类专家解决问题时的实际操作序列。
- 项目初期定义核心指标与基准;开发中每次改动都要防止效果回退;交付时把评估框架一起交给客户。
2.4 确定性规则与概率推理分层
能用确定性代码的地方就用确定性代码,只在概率推理真正有价值时使用LLM。关键业务规则、数学约束和校验步骤必须由确定性代码保证。
层级 | 负责内容 |
|---|---|
LLM编排 | 综合多个来源的数据,决定何时组合哪些数据源。 |
确定性规则 | 维护最少供应商数、物料全覆盖等核心约束。 |
模拟器工具 | 让LLM调用人类分析师也在用的工具,运行多个场景并给出权衡。 |
最终把关 | 所有推荐仍需通过确定性校验。 |
透明度 | 提供推理解释、表格数据和可视化,方便人工核查。 |
2.5 低成本快速验证
先用Playground做一个N=10的小测试。例如浏览器自动化场景10次成功7~8次,就说明这个用例有机会在生产环境跑通,值得继续投入B。
2.6 从定制到产品
第一个客户通常只有约20%可以复用;再做2~3个客户后,可复用部分达到约50%,之后再移交规模化团队AB。
Klarna客服 → Swarm → T-Mobile复杂场景验证 → Agent SDK → Agent Kit
反复出现的技术栈包括:工作流编排、追踪与遥测、标注数据与评估框架、运行时护栏。容易被低估的是“元数据翻译层”——它位于原始数据与业务逻辑之间,让LLM真正理解和使用企业数据。
2.7 现场经验回流产品
- OpenAI:每两周与研究团队分享现场知识;向产品负责人汇报;设立“FDE Field notes”频道;每季度举办集训营。
- Palantir:Delta可以向核心产品提交功能或修复,大需求进入产品路线图评审。
- 只做0到1:项目完成后交给客户内部团队或合作伙伴,FDE转去攻下一个难题。
三、六个案例
3.1 摩根士丹利:财富管理研究报告
技术管线用了6~8周,之后又用约4个月试点、收集反馈、完善评估和建立顾问信任。最终财富顾问采用率达到98%,研究报告使用量提升3倍。启示是:技术可行不等于可以上线,信任建设要单独排进计划。
专家轨迹
3.2 欧洲半导体公司:调试调查与分诊Agent
团队驻场梳理价值链,发现工程师70%~80%的时间花在修Bug和维护兼容性上。团队Fork Codex、加入遥测,并把约20步的人类调试过程做成评估集。最早上线部门效率提升20%~30%,整体目标为50%。
规则分层
3.3 亚太某车企:供应链协同
LLM负责跨系统编排和场景权衡,关键约束由确定性代码校验,复杂优化交给模拟器。来源没有给出上线后的效果数据,演示中的5个优化场景被Jarvis称为“toy example”。
产品化
3.4 Klarna → T-Mobile → Agent SDK
Klarna的400多条客服政策推动团队把指令和工具参数化,并为每个意图配评估集。这套方法沉淀成Swarm;在复杂度约高10倍的T-Mobile场景继续验证后,演进为Agent SDK和Agent Kit。
现场交付
3.5 John Deere:OpenAI FDE的第一个项目
团队在爱荷华州与John Deere合作,为农民提供个性化建议,帮助他们用好除草技术、减少农药喷洒,并在下一个种植季之前完成项目。
反哺模型
3.6 呼叫中心语音自动化客户
客户最初因模型表现不足而不愿部署。FDE构建评估集,并把数据带回研究团队改进模型。最终客户成为首个生产部署客户,Realtime API也因此得到改进。
四、从Demo到生产,为什么这么难
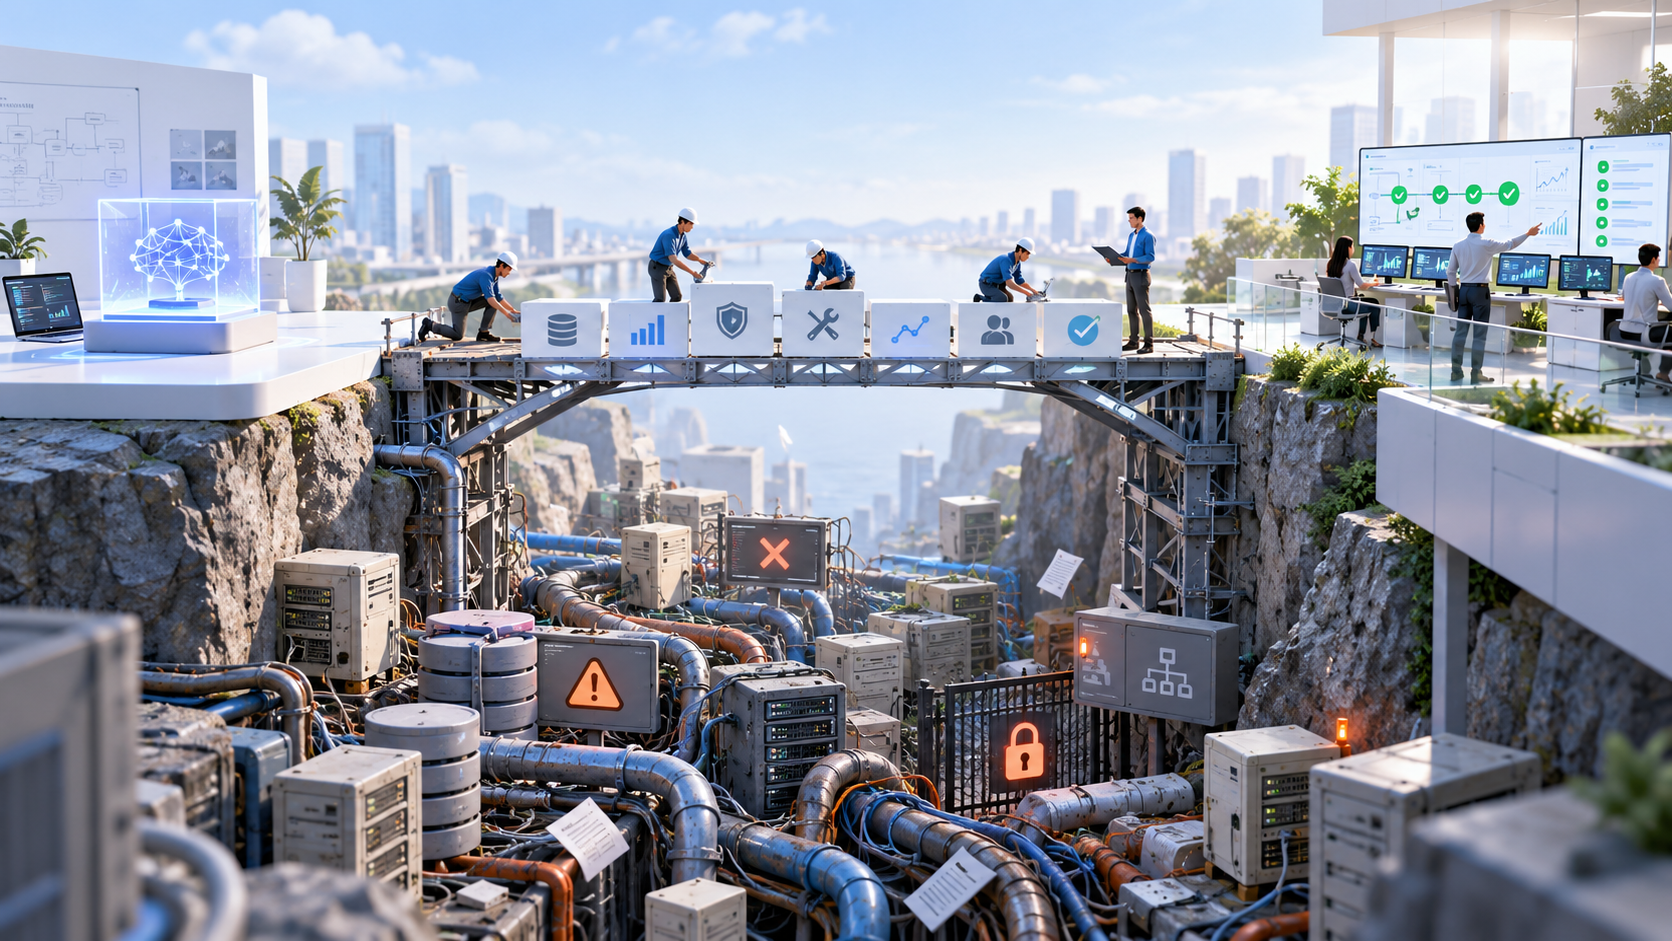
FDE跨越企业AI从Demo到生产的鸿沟
模型只是起点。数据、系统、评估、安全、规则、信任和组织协作共同决定能否进入生产。
4.1 FDE模式本身的坑
坑 | 说明 |
|---|---|
过早泛化 | 从已有功能反推企业问题,容易做成没有明确问题的高概念方案。把一个具体客户问题挖深,反而更容易提炼共性。 |
被服务收入拖住 | 短期服务收入可能把组织从产品投入上拉走。FDE要拒绝不符合战略的高收入项目。 |
把技术就绪当成上线 | 摩根士丹利技术管线6~8周,信任建设又用了约4个月。 |
LLM维护硬约束 | 关键规则必须由确定性代码强制执行。 |
LLM直接求解优化 | 更合理的做法是让它调用模拟器等工具。 |
过早搭复杂基础设施 | 先用Playground等低成本手段验证。 |
一人干两份工作 | FDE像顾问加平台工程师的合体,必须学会拒绝低价值会议和任务。 |
定制还是进平台 | 需要权衡快速交付与核心产品长期演进。 |
4.2 工程与产品层面的坑
- 用AI解决不需要AI的问题:复杂决策、规则难维护、依赖非结构化数据,至少满足一项才值得考虑LLM。
- 把“产品不好”当成“AI不好”:用户需要的不只是正确答案,还需要有帮助、可操作的产品体验。
- 一开始就上复杂方案:从最简单方案开始,必要时甚至不需要Agent。
- 过早使用多Agent:先把单Agent能力用足,工具重叠往往比工具数量更容易引发问题。
- 忽视工具接口:工具设计可能比Prompt优化更重要。
- 完全依赖LLM-as-judge:最好的团队仍会每天让专家人工检查生产输出。
- 没有评估体系:这是大量失败AI产品的共同根因。
- 模型升级改变行为:生产环境要锁定版本,新版本先走影子验证。
- 只有一道护栏:按只读/写入、可逆性、权限和财务影响实施分层防御,并明确转人工条件。
真正的分界线:Demo证明模型“有能力”,生产系统要证明它在真实数据、真实约束和真实责任下仍然可靠。
五、团队实践检查清单
选题
- 想清楚队伍是为服务收入还是产品增长服务,并据此拒绝非战略项目。
- 选择核心业务或高价值问题。
- 与确定性方案比较,确认确实需要LLM。
范围界定
- 去现场梳理真实流程;技术复杂的行业要投入更长驻场时间。
- 预设客户描述与真实系统可能不一致,安排验证阶段尽早撞墙。
- 用N=10的小测试完成低成本可行性验证。
开发
- 大规模开发前,和领域专家一起基于专家轨迹建立评估集。
- 硬约束用确定性代码校验,优化问题交给模拟器。
- 从最简方案起步,只有证明能提升效果时才增加复杂度。
- 按照“给模型使用”的标准设计工具接口。
上线
- 分层设置护栏,工具按风险分级,写明转人工条件。
- 把信任建设作为独立阶段,自动化程度随信任逐步提高。
- 每天有人看生产数据,并用人工判断校准自动评估。
沉淀
- 建立现场经验回流产品的固定机制。
- 按照“首个客户约20%复用,2~3个客户后约50%”规划产品化节奏。
附:来源
- [A] Colin Jarvis访谈原始视频:YouTube,2025。
- [B] ZenML LLMOps Database:文章一、文章二,2025。
- [C] 不二小段,《OpenAI FDE负责人最新访谈》,腾讯云开发者社区,2025-11-27。
- [D] Gergely Orosz,What are Forward Deployed Engineers, and why are they so in demand?,The Pragmatic Engineer,2025-08-12。
- [E] Palantir,Dev versus Delta,2019-04-08。
- [F] Anthropic,Building effective agents,2024-12-19。
- [G] OpenAI,A practical guide to building agents,2025。
- [H] Chip Huyen,Common pitfalls when building generative AI applications,2025-01-16。
- [I] LinkedIn Engineering,Musings on building a Generative AI product,2024-04-25。
- [J] Eugene Yan等,What We've Learned From A Year of Building with LLMs,2024-06-08。
- [K] Hamel Husain,Your AI Product Needs Evals。
说明:本文中的数字与案例均按所列来源口径呈现;二手引用和缺少生产结果的数据均已明确标注。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号