从零开始部署Qwen3.8 Flash Next | AutoDL | Strata

从零开始部署Qwen3.8 Flash Next | AutoDL | Strata
夜梦星尘
发布于 2026-10-06 14:19:37
发布于 2026-10-06 14:19:37
0. 前言的前言
如果你有minimax code/opencode/pi等工具,以及模型API,可以直接给AI发送消息:
请你为我在autodl服务器上部署Qwen3.8 Flash Next(合适精度版本),并提供调用接口,使得能够在本地工具中进行调用。
autodl服务器的连接方式为:在你的服务器SSH连接指令,你的服务器密码。
部署请使用项目https://github.com/Niko1221/Strata/blob/main/README.zh-CN.md。
然后就可以关闭夜梦的这篇文章,耐心等待部署完毕了。
1. 前言
当然,如果你能看完这篇文章,夜梦真的会很开心的^ ^
夜梦在几天前写过一篇文章,在AutoDL上部署Qwen3.8-27b并在本地电脑上使用,现在有了一个更优的选择:Qwen3.8 Flash Next,比 Qwen3.8-27b 性能更好~
需要注意的是,如果使用原版 Qwen3.8-Flash-Next,由于 Qwen3.8-Flash-Next 是 176B 参数(125B MoE + 51B N-gram Embedding)模型,官方 FP8 版约 180GB,即使用 Int4 精度也要约95GB,消费级显卡是肯定部署不了的。所以夜梦这里推荐一个GitHub上面的项目,使得 Qwen3.8-Flash-Next 能够在消费级显卡上部署。
本教程使用项目:Niko1221/Strata: Qwen3.8-Flash-Next on any consumer hardware。这个项目能够使得原本需要近百G显存的 Qwen3.8 Flash Next 能够在自己的游戏电脑上运行 Qwen3.8 Flash Next。
本项目支持NVIDIA 或 AMD 显卡(12 GB 及以上),Windows 或 Linux。
发现了Strata项目后,夜梦尝试在autodl上租一台服务器,部署 Qwen3.8 Flash Next,并在本地进行调用。在云服务器上部署就可以随便蹬了=v=
2. 准备
Strata项目对配置的要求如下:
显卡 | NVIDIA GeForce RTX 20、30、40 或 50 系列,或 AMD Radeon RX 7900 XT / XTX、RX 7800 XT / 7700 XT、RX 9060 XT、RX 9070 / 9070 XT、Radeon AI PRO R9700 或 RX 6800 / 6900 系列。需要 12 GB 或以上显存。 |
|---|---|
内存 | 32 GB 或以上。内存大小决定能装下哪个模型。64 GB 可以运行所有规格。 |
硬盘 | 约 80 GB 可用空间。尽量用 SSD:第一次启动会快很多。 |
系统 | Windows 10 / 11 或 Linux,以及 NVIDIA 或 AMD 的最新显卡驱动。 |
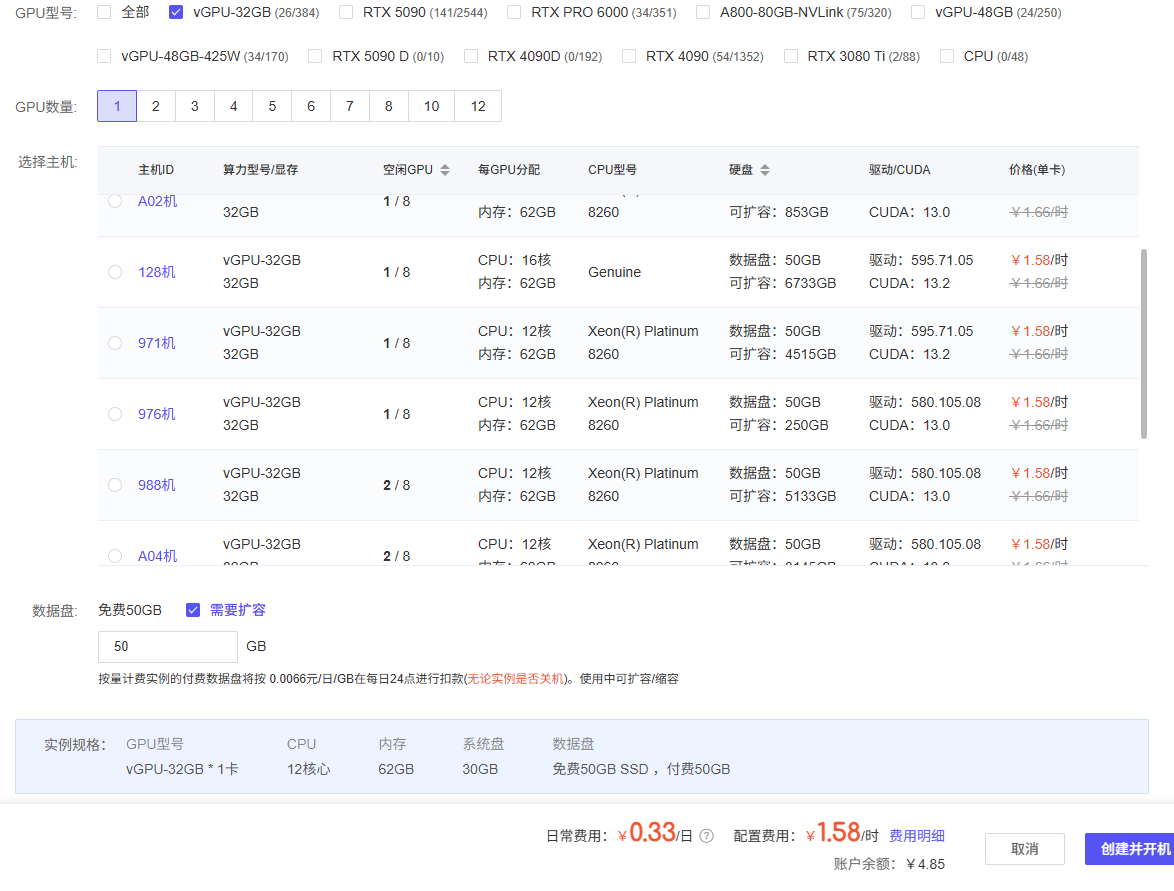
和之前部署 Qwen3.8-27b 前的准备工作一样,我们先注册 AutoDL 并充值。夜梦这里使用的是vGPU 32G(开出来RTX 4080 SUPER 32G) ,12G 显存,只需要 1.58 元 / 小时。由于推荐80+GB硬盘(注意要使用SSD),所以我们在创建前先把服务器的硬盘扩充一下(夜梦这里扩充50G硬盘,0.33元/天):
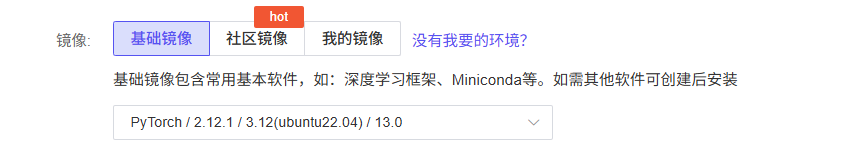
镜像选择PyTouch,版本为2.12.1。Cuda版本选择13.0。
点击创建并开机。可以到控制台查看登录指令与密码。

考虑到硬盘空间(100G)与内存空间(62G),夜梦这里使用 IQ3_XXS(质量best档),作者给出的token速度参考如下:
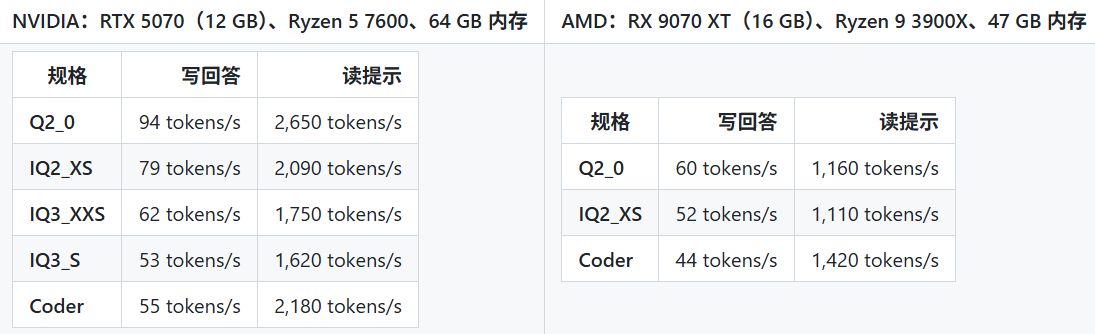
如果使用SSD的话速度基本能有50+tokens/s,还算是快的(比GPT-6.1-Sol快太多了^ ^)。
3. 部署
运行autodl后台提供的SSH连接命令,通过powershell连接服务器。
【以下指令在服务器上运行】
运行:
# 更新与基础工具(tmux 必须有:没有它 tmux new -d 会静默失败,表现为"服务没起来"且无任何日志)
apt-get update
apt-get install -y tmux python3-venv python3-pip

# AutoDL 学术加速(临时生效,仅对当前终端;GitHub 引擎下载用)
source /etc/network_turbo
安装、更新基础环境。然后克隆 Strata 到数据盘:
cd /root/autodl-tmp # 数据盘,关机保留
git clone --depth 1 https://github.com/Niko1221/Strata.git
接下来把网络与编译环境写进脚本,用官方推荐的零交互姿势安装(一条条运行,已用空行隔开):
cat > /root/autodl-tmp/strata-setup.sh <<'EOF'
#!/bin/bash
# Strata 安装脚本(IQ3_XXS,128K 上下文,视觉 GPU 编码器,带 API Key)
cd /root/autodl-tmp/Strata || exit 1

export PATH=/root/autodl-tmp/Strata/.venv/bin:$PATH   # venv 自带 cmake 4.4.3,系统 3.22 太老

source /etc/network_turbo          # AutoDL 学术加速:GitHub 引擎下载用

export HF_ENDPOINT=https://hf-mirror.com   # 模型权重走国内镜像

export no_proxy="$no_proxy,hf-mirror.com,mirrors.aliyun.com,pypi.tuna.tsinghua.edu.cn"  # 镜像站直连,不走代理

./setup.sh --yes --family qwen --model IQ3_XXS --context 131072 --vision gpu \
  --data-dir /root/autodl-tmp/Strata-data --api-key sk-local-flashnext --no-start
echo "SETUP_EXIT=$?"
EOF

chmod +x /root/autodl-tmp/strata-setup.sh

# 挂到 tmux 里跑,SSH 断开不影响;中断了重跑同一条命令会断点续传(下载带 .done 标记 + sha256 校验)
tmux new -d -s strata-setup 'bash /root/autodl-tmp/strata-setup.sh > /root/autodl-tmp/strata-setup.log 2>&1'

# 随时看进度(Ctrl+C 退出查看,不影响后台)
tail -f /root/autodl-tmp/strata-setup.log这个环节的编译和下载需要较长时间,夜梦推荐可以玩会儿游戏,或者直接睡一会儿。完成后我们准备启动。
由于夜梦这里使用的时62G内存、32G显存服务器,内存较大,因此推荐官方设计的 resident 变体:GPU 缓存最常用的几千个专家,其余专家全部常驻内存,n-gram 表走 NVMe 直读(direct 是官方默认、本为 SSD 设计,表不占内存):
python3 - <<'EOF'
import json
p = "/root/autodl-tmp/Strata/strata-iq3_xxs.json"   # 安装器生成的引擎配置,启动脚本会读它
c = json.load(open(p))
a = c["args"]
if "--resident-experts" not in a:
    a.insert(0, "--resident-experts")    # GPU 装不下的专家常驻内存(含 --mmap-experts 语义),稳态零读盘
if "--ple-io" in a:
    i = a.index("--ple-io"); a[i+1] = "direct"   # 28.8G n-gram 表不再锁内存;SSD 直读
json.dump(c, open(p, "w"), indent=1, ensure_ascii=False)
print("patched ok")
EOF运行结果:patched ok(重跑 setup 会覆盖配置,需重打)。然后我们用 tmux 起服务,等 ready 之后在实例内先自测:
FileExpertSource: allocating 19.77 GiB page-locked cache complement
strata generate: resident RAM mode: 19.77 GiB of experts in RAM (page-locked),
                14605 in the GPU cache; adaptive swaps exchange them
                with the GPU cache (no file reads)
启动服务:
tmux new -d -s strata 'cd /root/autodl-tmp/Strata && export HF_ENDPOINT=https://hf-mirror.com && ./run-iq3_xxs.sh 2>&1 | tee /root/autodl-tmp/strata-server.log'

tail -f /root/autodl-tmp/strata-server.log
等日志出现 ready: http://127.0.0.1:8080/v1 即就绪,中间日志大体如下:
[strata] still starting (215 s) - please wait ..
[strata] almost ready ...
[strata] mapping the experts from the model files (about 47 GB, --mmap-experts): ...
ready: http://127.0.0.1:8080/v1  (OpenAI: /v1/chat/completions, Anthropic: /v1/messages, context 131072 tokens, images on, API key required)
在实例内自检,确保成功运行:
# 健康检查
curl http://127.0.0.1:8080/health

# 看模型列表(模型名随便填,Strata 只认一个模型)
curl http://127.0.0.1:8080/v1/models -H "Authorization: Bearer sk-local-flashnext"

# 来一发对话(reasoning_effort:none 关掉思考阶段,否则 max_tokens 会被思考吃光)
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer sk-local-flashnext" \
  -d '{"model":"qwen3.8-flash-next","messages":[{"role":"user","content":"用一句话介绍你自己"}],"max_tokens":256,"reasoning_effort":"none"}'
返回如下内容表明连接通畅:
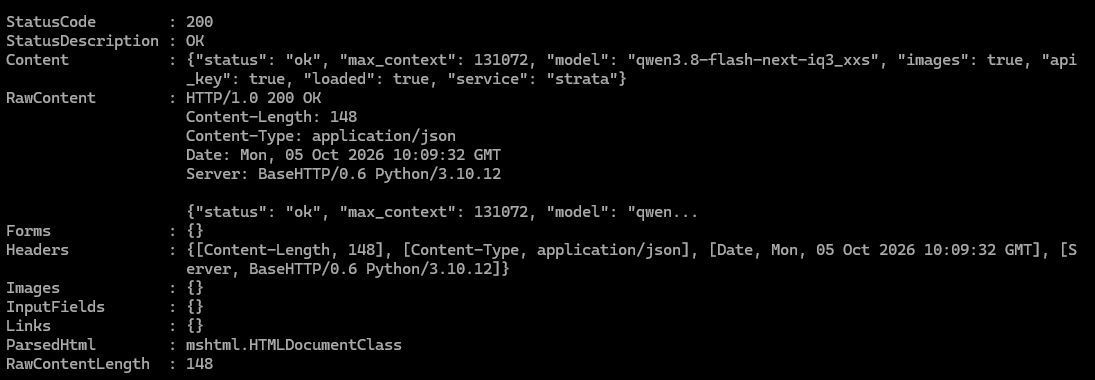
{"status": "ok", "max_context": 131072, "model": "qwen3.8-flash-next-iq3_xxs", "images": true, "api_key": true, "loaded": true, "service": "strata"}【以下指令在自己的电脑上运行,端口和地址改成 AutoDL 后台 SSH 连接命令里的】
到这里启动就完成了,已经可以进行调用。我们在本地终端(非服务器)上运行:
ssh -CNg -L 8080:127.0.0.1:8080 -o ServerAliveInterval=30 -o ServerAliveCountMax=3 -o ExitOnForwardFailure=yes -p 端口 root@地址运行后服务器无输出(正常情况)。
这时,我们就可以在本地进行调用了。
4. 使用
(测试连通性)我们在本地另开一个powershell终端,运行:
curl http://127.0.0.1:8080/health返回如下表明连通:
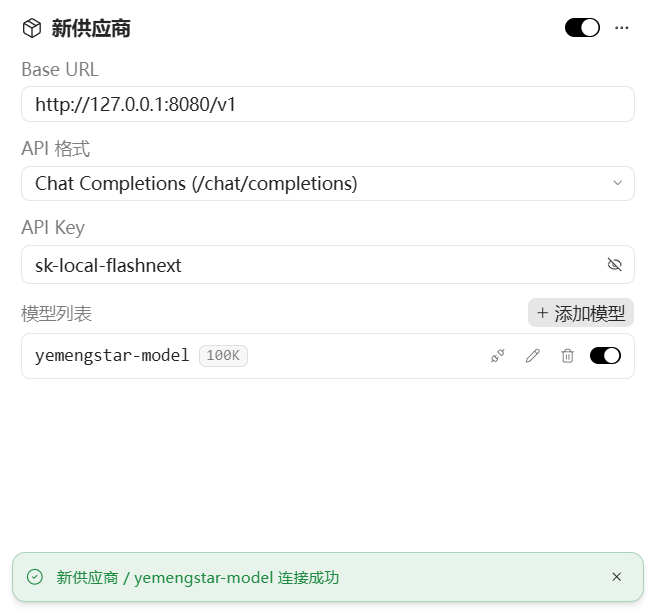
配置如下(模型名随便填写):
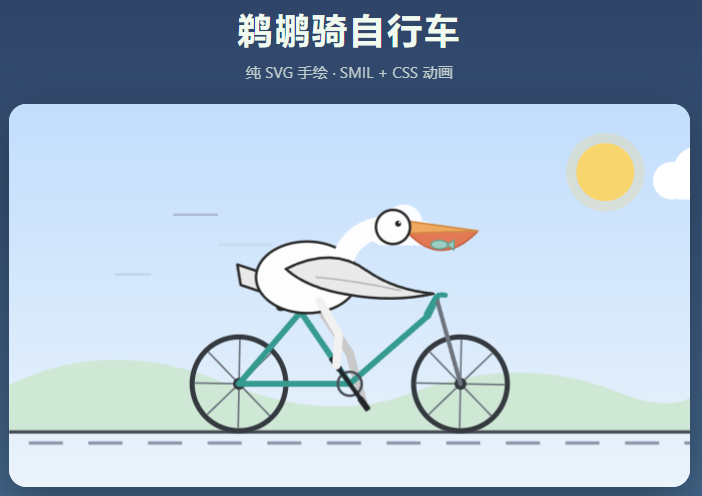
鹈鹕测试如下,用时10分57秒:
不用了可以直接关机,重启后只需在服务器上运行:
# 1. 服务器上启动服务(同样约 45 秒 ~ 4 分钟就绪)
tmux new -d -s strata 'cd /root/autodl-tmp/Strata && export HF_ENDPOINT=https://hf-mirror.com && ./run-iq3_xxs.sh 2>&1 | tee /root/autodl-tmp/strata-server.log'
tail -f /root/autodl-tmp/strata-server.log
然后在本地运行:
ssh -CNg -L 8080:127.0.0.1:8080 -o ServerAliveInterval=30 -o ServerAliveCountMax=3 -o ExitOnForwardFailure=yes -p 端口 root@地址5. 后记
不用了请别忘了在autodl上关机,或者直接释放实例。使用autodl上述配置的使用成本为1.91元/小时,45.84元/天(不使用时可以关机),但看成本还是有些高的,事实上也确实有些高,不如直接使用千问的api了。
本文参与 腾讯云自媒体同步曝光计划,分享自作者个人站点/博客。
原始发表:2026-10-05 ,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号