Milvus 3.0 段数由默认值决定:12% 封口、24 小时寿命、16 压缩槽位
原创
Milvus 3.0 段数由默认值决定:12% 封口、24 小时寿命、16 压缩槽位
原创
术哥
发布于 2026-10-21 23:20:13
发布于 2026-10-21 23:20:13
🚩 2026 年「术哥无界」系列实战文档 第 211 篇原创,Milvus 最佳实战「2026」系列第 36 篇
大家好,欢迎来到 术哥无界 | ShugeX | 运维有术。
我是术哥,一名专注于 AI 编程、AI 智能体、Agent Skills、MCP、云原生、AIOps、Milvus 向量数据库的技术实践者与开源布道者!
Talk is cheap, let's explore。无界探索,有术而行。
封面
官方文档说:Milvus 把写入的实体存在段里,段一满就封存,封存了就新建一个段来装更多实体。
那么满是多少?默认配置下,一个段只装了 12% 就会碰到封口条件。
这行字意味着:写入越快、更新越频繁,段就会越多。
一个干净的大段,要等后台压缩反复工作之后才出现。
issue 区里有旁证(都是 3.0 之前的社区报告):删除 60% 实体时并发搜索出现过延迟尖刺(#37413),upsert 场景下查询时间戳滞后过大(#49435)。这些报告的直接归因各有各的说法,但都踩着同一件事:数据一变多、一删改,段与删除日志的布局就变差,查询要扫的东西变多。
下面把这条链从头走一遍。这组默认值就是判断的起点,拿自己集群的配置就能逐项对上。
01 谁在判已满:十二种信号,一分钟一轮
先回答最基础的问题:谁在盯 growing 段?
Milvus 3.0 的写入路径上,StreamingNode 一边把数据写进 WAL,一边维护一个统计管理器(StatsManager),每个 growing 段都有一份自己的写入统计:行数、字节数、创建时间、最后写入时间。
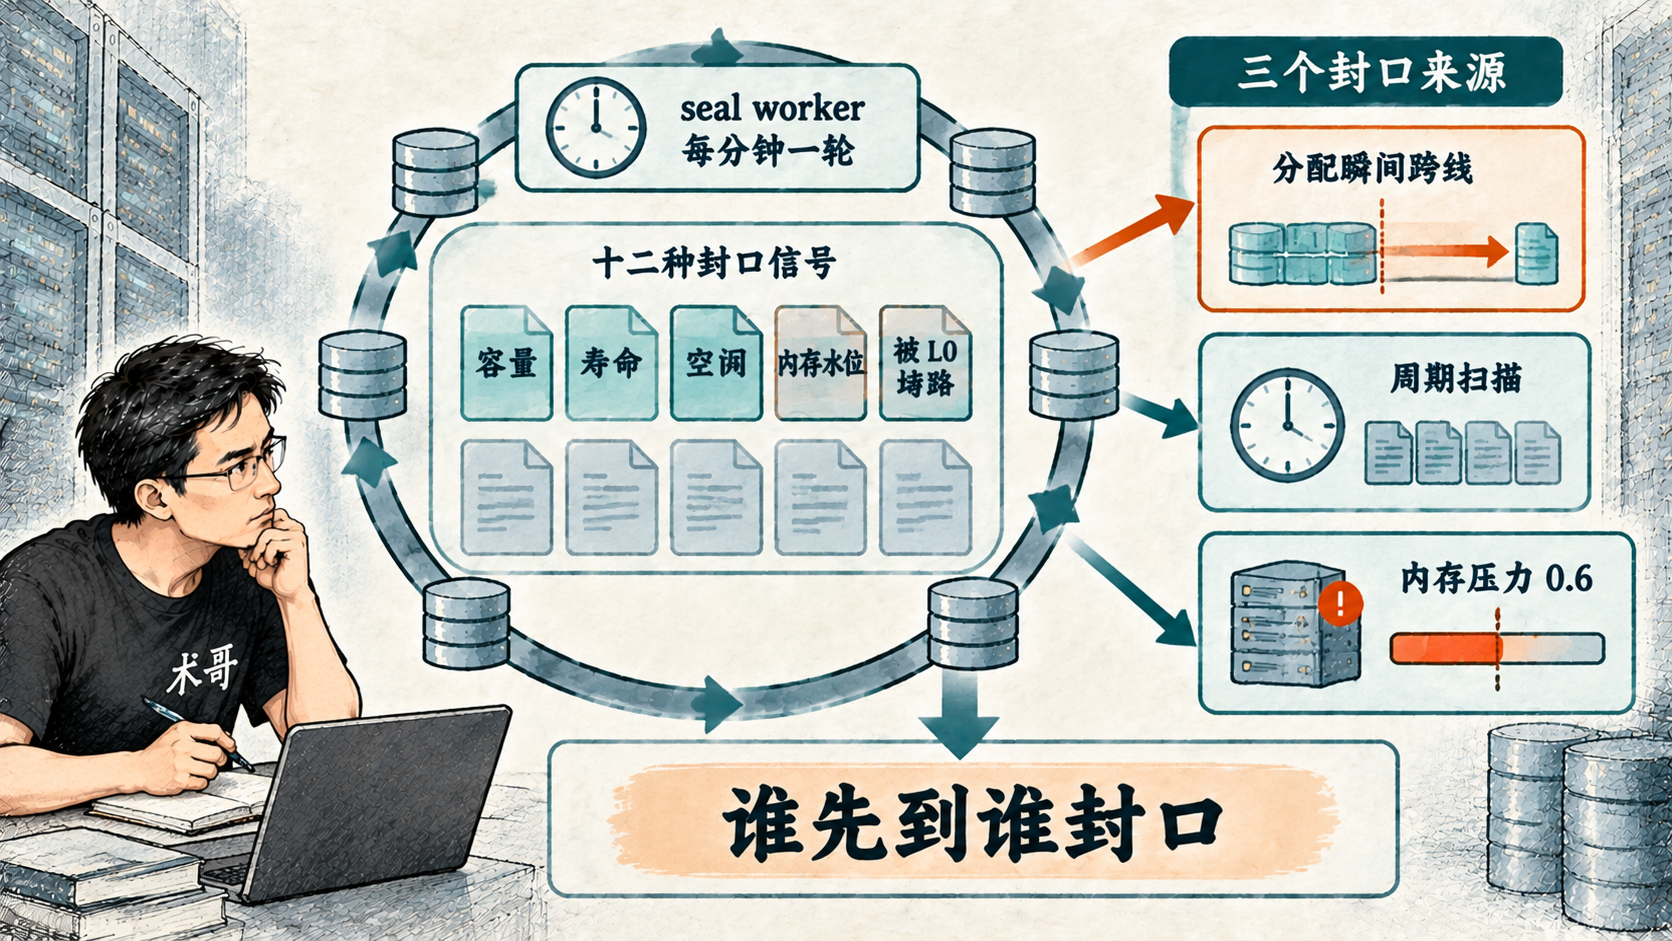
统计管理器背后挂着一个后台工人(seal worker),周期性地把所有 growing 段过一遍,看有没有命中封口条件。
我在源码里数了数封口信号的枚举,一共有十二种名字:partition_not_found、partition_removed、collection_removed、recover、fenced、force、capacity、lifetime、idle、growing_bytes_hwm、node_memory、blocking_l0。
按触发时机分两组:
组别 | 信号 | 什么时候出现 |
|---|---|---|
生命周期类(6 种) | partition_not_found、partition_removed、collection_removed、recover、fenced、force | 段没了、分区没了、被强制指定 |
常驻轮询类(6 种) | capacity、lifetime、idle、growing_bytes_hwm、node_memory、blocking_l0 | 每一轮健康检查都可能命中 |
封口的真实形态是后台每轮扫描里逐段判定,段写满只是触发条件之一。
扫描多久一轮?seal worker 的默认定时器是一分钟,每轮做三件事:容量策略扫描、时间策略扫描、blocking-L0 策略扫描。
容量扫描之外还有两条快路:一次分配当场跨过目标就立刻通知封口,不等下一分钟;节点内存使用率超过阈值(默认 0.6)时,系统持续封口直到总量降下来。
段被封口有三个来源:分配瞬间、周期扫描、内存压力,谁都有可能先到。
你的集群里,段到底是被哪一条封掉的,有人认真查过吗?
seal worker 每分钟扫描环
02 段根本不需要写满才封:12%,24 小时,一次跨线
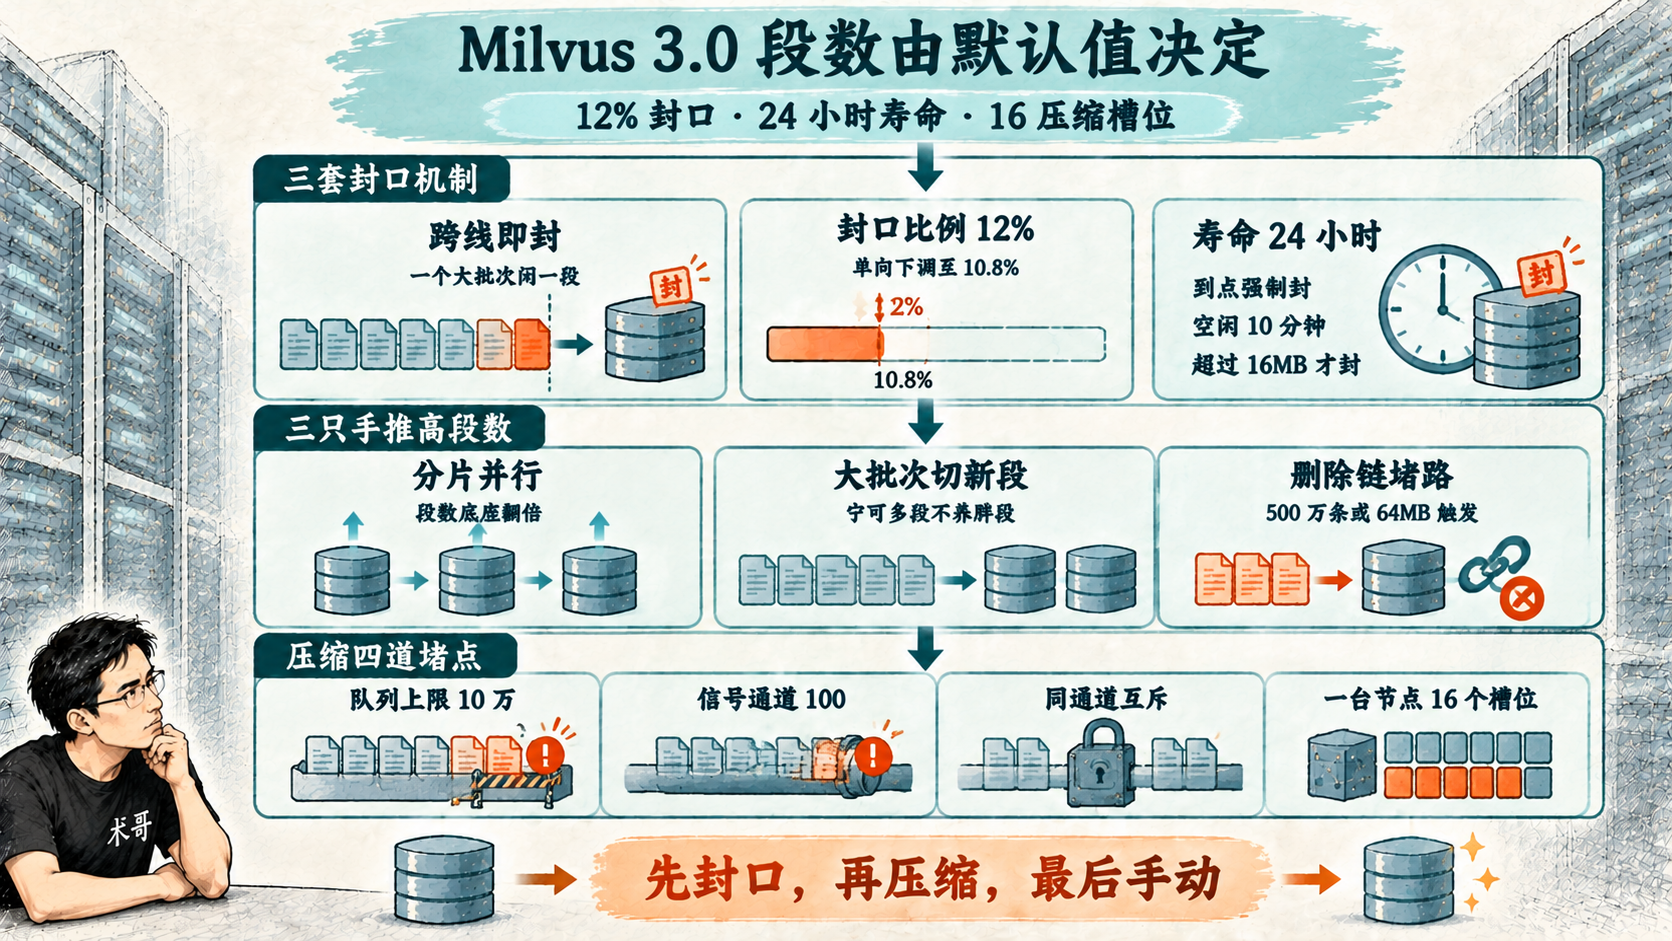
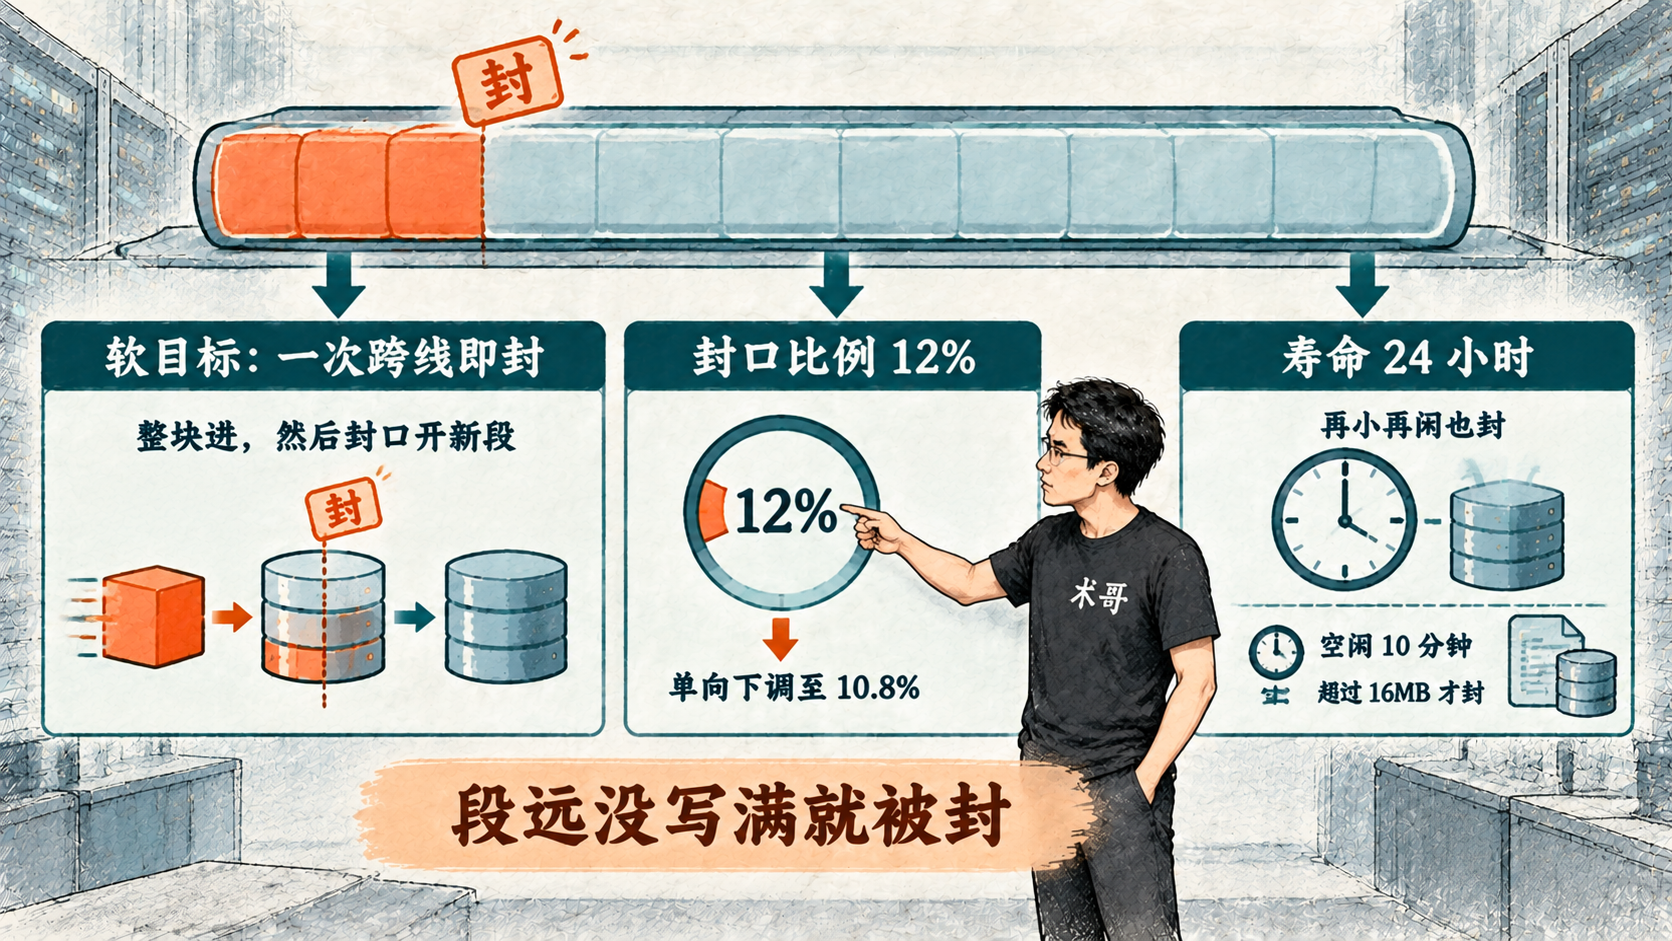
默认配置下,一个段离写满差得远就会被封口,而且有三套机制在同时起作用。
第一套是软目标。每个 growing 段在分配时定下一个软上限(行数或字节数),分配逻辑的注释原文是:
Every segment may accept exactly one allocation that crosses its soft assignment target. Once that crossing allocation has been accepted, all later allocations must move to another segment.
落到行为上:一次 insert 批次是一整块数据,放不下时系统整块塞进去、然后封口、开新段,不把这块切两半。高吞吐下,一个稍大的写入批次就能直接闭掉一个段,再开一个新的,写入越猛,这种跨线即封发生得越频繁。
第二套是封口比例。dataCoord.segment.sealProportion 默认值是 0.12,也就是 12%。
封口的判定是行数达到上限 × 12%,再单向下调至多 10%(sealProportionJitter 默认 0.1,实际封口比例落在 10.8%~12%),防止所有段在同一时刻一起封。
我读到 0.12 这个数字时停下来重新算了一遍。dataCoord.segment.maxSize 默认 1024MB,每段行数上限由它除以单条记录的估算大小得出(maxCountPerL1Segment = maxSize / 单条记录估算大小)。
一个段在只装了十分之一出头的数据时,就已经满足封口条件。
文档说并在分段已满时将其封存,源码说的是段刚过 12% 就可能封存,这两句话中间隔着一个量级。
出处 | 原话 | 落到数字上 |
|---|---|---|
官方文档(数据处理) | 段满了才封存 | 满 = maxSize 上限 |
源码 paramtable | sealProportion = 0.12 | 行数到上限的 10.8%~12% 就够格封 |
第三套是寿命。dataCoord.segment.maxLife 默认 86400 秒,整整 24 小时:不管段多小、多空闲,从创建起超过 24 小时就强制封口。
配套的还有空闲封口:一个段 10 分钟没有写入、且已超过 16MB(minSizeFromIdleToSealed 默认 16MB),也会被封。
L0 段也有自己的 10 分钟寿命。
还要补一句:datacoord 侧还有一套平行的封口策略在跑:段 binlog 文件数超过 32 个会封,channel 上所有 growing 段总量超过 4096MB 时,会先把最胖的那段封掉。
触发线 | 参数 | 默认值 | 一句话行为 |
|---|---|---|---|
软目标跨线 | 分配时软上限 | 由 maxSize 推算 | 单次分配跨线即封,不切块 |
封口比例 |
| 0.12(抖动后 10.8%~12%) | 行数到上限的一成出头就封 |
寿命 |
| 86400 秒(24 小时) | 到期必封,不看数据量 |
空闲 |
| 16MB / 10 分钟 | 又闲又够大就封 |
并行策略 | datacoord 侧 | 32 个 binlog / 4096MB channel 总量 | 文件数或通道总量超限,封最胖的 |
两套策略参数重叠、职责不同,但方向一致:段被主动、提前、反复地封口,是默认配置下的常态。
三套封口机制
03 把段数往上推的三只手:分片、大批次、删除链
封口机制解释了一个段什么时候结束,但段为什么会越来越多还得看三个推手。
推手 | 它做了什么 | 对段数量的影响 | 该看哪个参数 |
|---|---|---|---|
分片(shard) | 写入按 shard 路由到并行通道,每通道各分各的段 | 段数底座随分片数线性翻倍 | collection 的 shard 数 |
大批次 insert | 单次行数超单段上限时,先切 N 个新段装,余量再塞旧段 | 一次大批量直接多出好几个段 | maxSize 与单条记录估算大小 |
删除链(blocking-L0) | 删除日志积到阈值,反向逼 growing 段提前封口 | 删除量越大,提前封口越频繁 | 500 万条 / 64MB 两条 L0 阈值 |
第一个是分片。collection 建几个分片(shard),写入就被路由到几个并行的通道上,每个通道各自分配自己的段。
按这条机制推演,分片数翻一倍,段数量的底座就跟着翻一倍。
这是并行性的代价,属于正常现象,但它是段数曲线的乘数,跑多分片 collection 的人心里要有这个数。
第二个是大批次。分配策略里有一段注释,大意是:写入太快时,时间水位可能滞后,导致段来不及及时封口;为了防止分配出过大的段,这里引入封口比例因子;free < 0 的条件保证分配至少能超过最小可封口尺寸,避免段永远封不了口。
落到行为上:一次 insert 的行数超过单段上限时,系统先切出 N 个新段把数据拆进去,剩下的再找现有段塞。
注释里那句防止分配出过大的段很说明问题:段过大对查询不是好事,系统宁可多切几个段,也不让一个段长得太胖。
导入段带着 isImporting 标记进入段体系,四类压缩策略都先把它排除在候选之外。
第三个是删除链,这一条最容易被忽略。
删除和更新会生成 L0 段(删除日志段),而 L0 段的压缩有个硬约束:只有位置不晚于最早的 growing 段起点的 L0 段,才会被本轮压缩处理。
只要还有 growing 段活着,横跨它们时间范围的删除日志就得排队等着;删除越猛,L0 段越长越大,被 growing 段挡住的删除日志越积越多。
挡到什么时候是个头?源码给了两个阈值:单个通道的 L0 日志条目数达到 500 万条,或大小达到 64MB,就触发堵路封口,把最早的那个 growing 段封掉,给 L0 压缩让路。
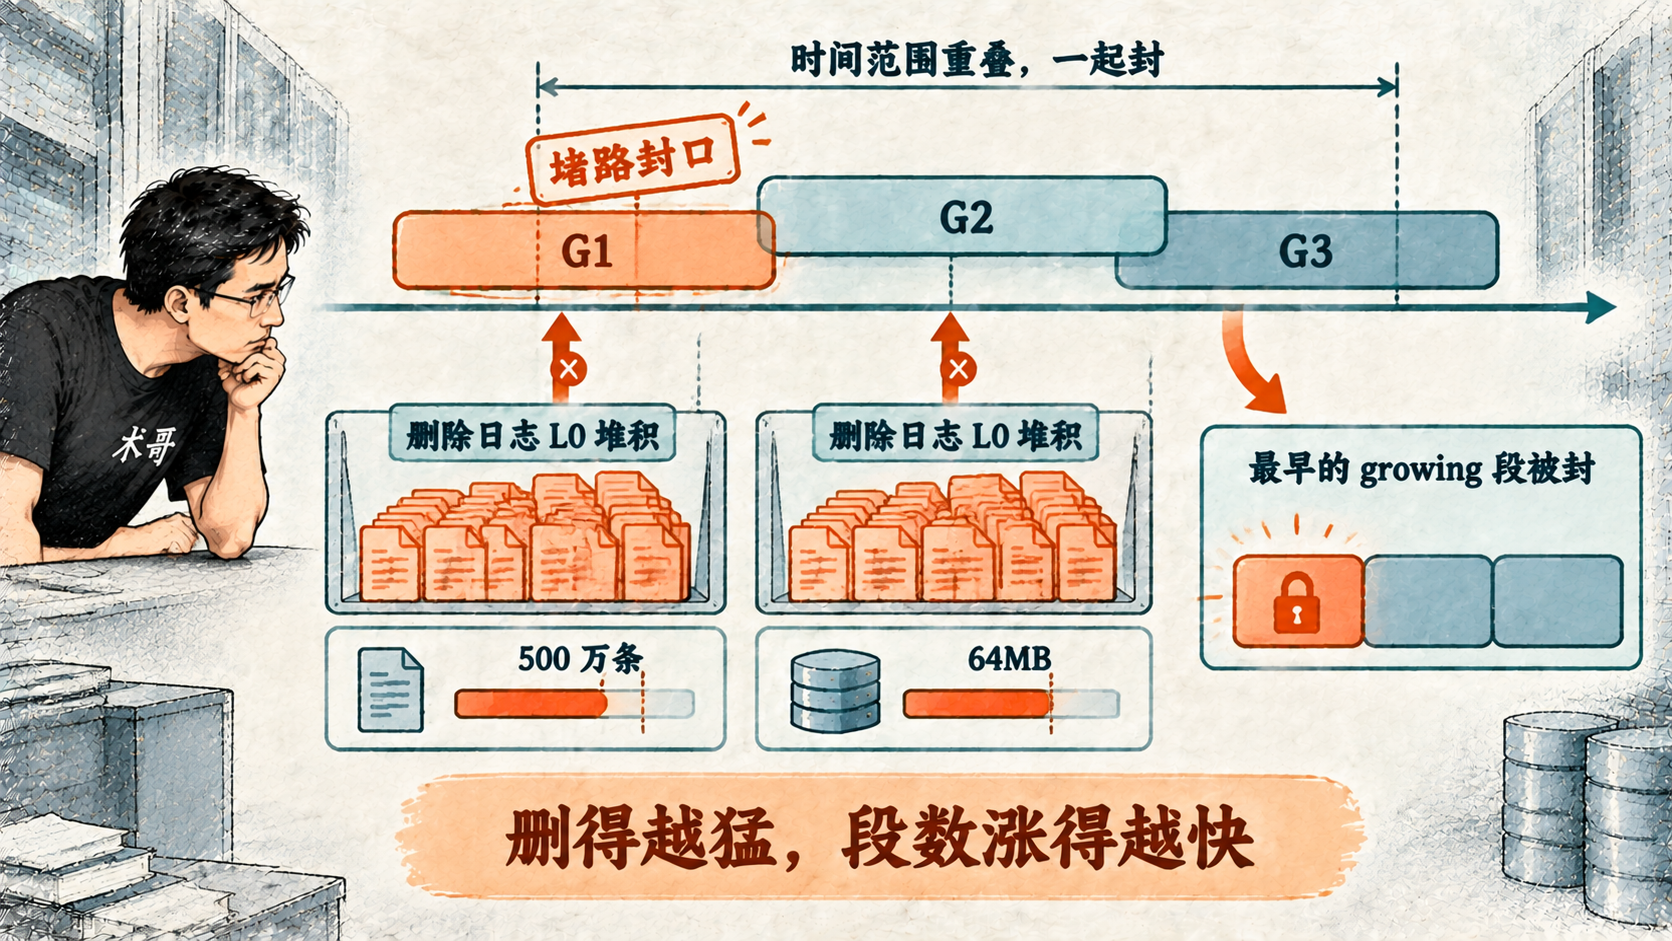
blocking-L0 级联
(L0 段的物理回收角色在第 05 篇已展开,这里只说它与段数量的关系。)
源码里那段 ASCII 图注释把这条链画得很清楚,我转成文字:
G1、G2、G3 是三个时间范围互相重叠的 growing 段,L0a、L0b 两段删除日志累计超过阈值,那么 G1、G2、G3 都会被封,因为它们的时间范围和堵路的删除日志重叠。
一个 upsert 或高频删改的 collection,段数量增长同时受写入量和删除量影响。
删除不是把数据拿走就完了:它先堵住 growing 段,再逼系统提前封口,最后产出更多的段。
04 compaction 在追,但调度链上有四道堵点
后台 compaction 就是来收拾这些段的:把小段合并成大段、把删除痕迹清掉、把 L0 日志并进正式段。
它有自己的触发节奏:L0 压缩每 10 秒检查一轮,mix 压缩每 60 秒,聚类压缩每 600 秒。
单段级还有三条触发线:段里删除行占比达到 20%、删除日志超过 16MB、或删除日志文件数超过 200 个,任何一个命中,这个段就值得单独压缩一遍。
节奏看着够勤快,L0 十秒一轮,mix 一分钟一轮。但合并跟不上段数增长才是常态,段数怎么会一路只涨不落呢?调度链上有四道硬性堵点:
堵点 | 位置 | 限制 | 堵住的后果 |
|---|---|---|---|
队列容量 | compaction 任务队列 | 默认 10 万 | 满了这一轮直接跳过,不生成新任务 |
信号通道 | 自动触发信号 | 容量 100 | 满了报 |
互斥 | 同一 channel | L0 与 mix 互斥,聚类与同标签 mix 互斥 | 一个段同一时刻只能参与一个压缩任务 |
执行槽位 | DataNode | 默认 16 个槽,压缩与导入共享 | 任务排不上机器 |
还有一个优先级问题值得单独说:任务优先器默认是 level,L0 压缩最先,然后是 mix,最后是聚类压缩。
删除风暴下,当队列和槽位被打满时,这个顺序会变成挤压效应。
L0 压缩每 10 秒触发一次、优先级最高,负责把小段合并成大段的 mix 压缩被排到后面,碎片合并长期得不到执行,段数就只涨不落。
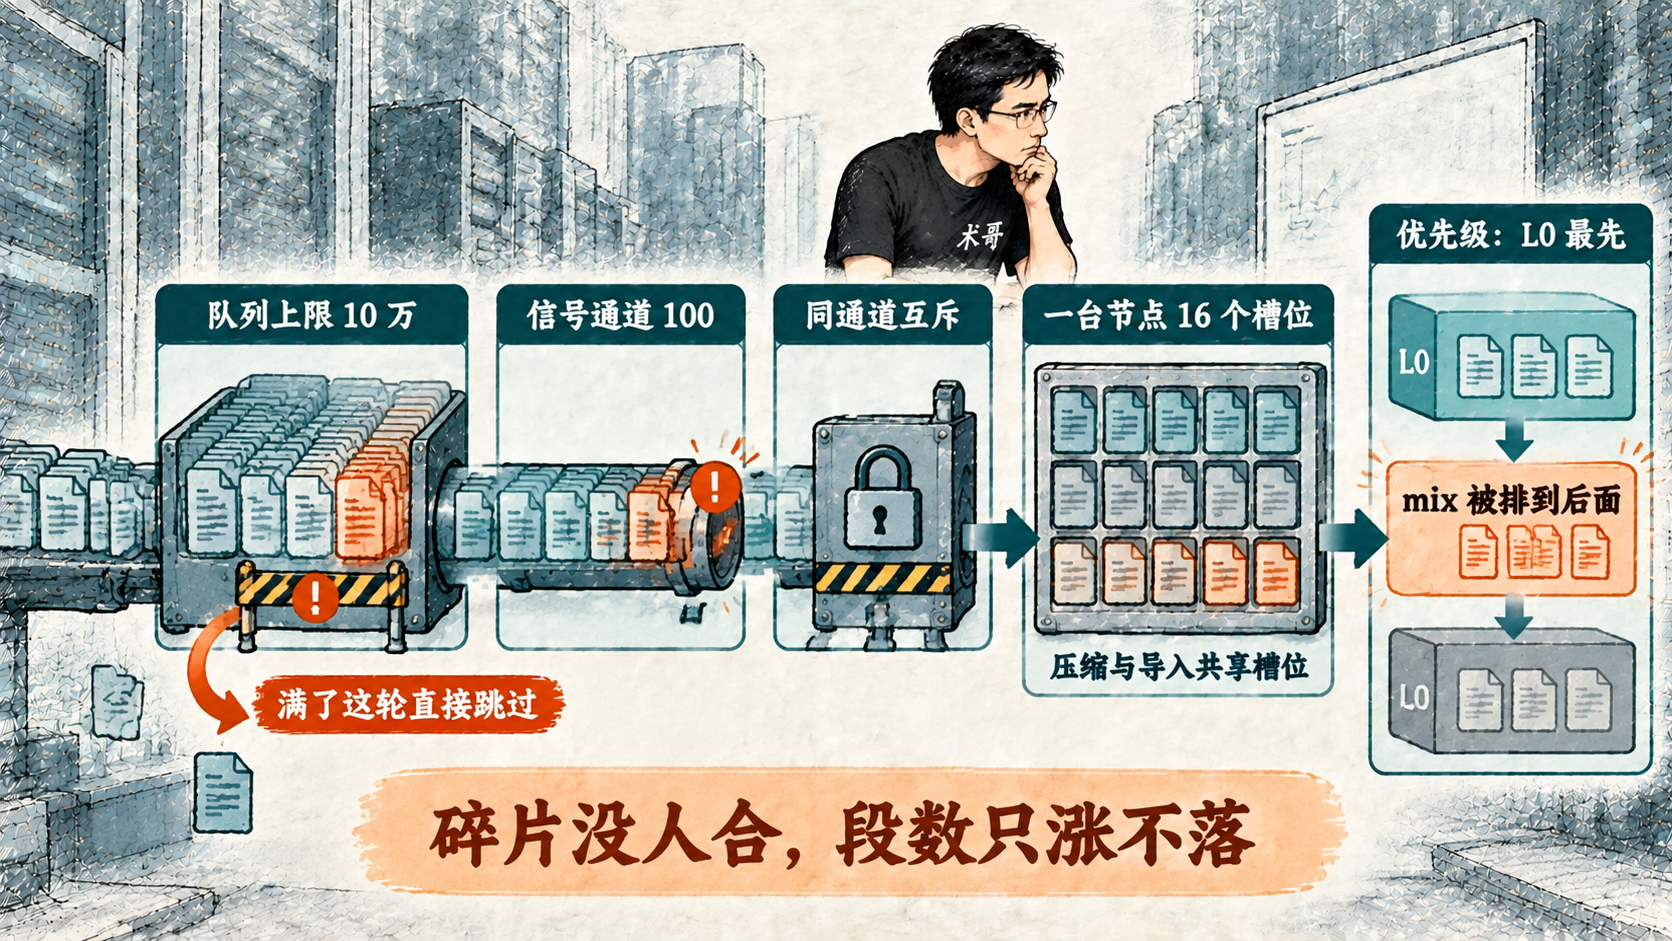
压缩四道堵点
05 手动干预的两个入口,都带着价签
等自动压缩等不来的时候,还有两个手动入口:force merge(强制合并)和 clustering compaction(聚类压缩)。
文档和源码各读一遍,两个入口都不是白用的。
force merge 解决的是标准压缩的一个先天死结。
官方文档原话:标准压缩把段大小维持在上限附近,但仍会留下无法在不超出限制的情况下进一步合并的中等大小的片段。
比如 5 个 2MB 的段配上 3MB 的上限,任意两个合并都超限,标准压缩就永远合不动。
对比表里那句更直接:标准压缩可能会永久卡住,例如两个 60% 的分段不能合法地变成一个 120% 的分段。
原因在合并形状:标准压缩是 m→1,一个任务只能合出 1 个段,输出不能超上限;force merge 是 m→n,可以把段打散重组,输出段数不受 1 个限制。
标准压缩 | force merge | |
|---|---|---|
合并形状 | m→1 | m→n |
输出段数 | 固定 1 个 | 不受 1 个限制,可打散重组 |
输出段大小 | 不得超配置上限 | 不得超安全值,超了静默钳制 |
成熟度 | 默认稳定 | 公开预览(文档:请勿在生产环境中使用) |
适用段布局 | 常规碎片 | 中等段卡死、反复压缩无效 |
段布局卡在中等段、反复触发普通压缩都无效的场景下,force merge 才是对症的那把钥匙。
但 force merge 不是免费的,有三条限制。
第一,它标注为公开预览功能,文档原文是此功能处于公开预览阶段。请勿在生产环境中使用。第二条,异步执行、不阻塞查询,但会实打实消耗 I/O 和内存,官方建议安排在低流量时段。
第三,指定的目标大小并不是想多大就多大:小于配置上限的请求直接被拒,大于安全值的请求会被静默钳制回安全值。安全值怎么算?
源码里的公式是:取所有 QueryNode 内存的最小值和所有 DataNode 内存的最小值,分别除以 4(memoryFactor 默认 4.0),再取两者的较小者;standalone 非池化模式下再减半。
文档给了个算例:最小的 QueryNode 有 16GB 内存,自动计算的目标大小不会超过 4GB。
如果手动指定一个超过安全值的 target_size,系统不会报错,只会按安全值去合并。
合出来的段比想要的小,多半就是被内存上限摁住了。
clustering compaction 则默认根本没开。
它需要先在 schema 里指定一个标量字段做聚类键,然后系统按聚类键的值把实体重新分布到各段,并生成一份叫 PartitionStats 的段-键值映射索引,查询时按聚类键剪枝、只扫相关段。
自动触发要三个开关同时为真,各自的默认值:
开关 | 默认值 | 说明 |
|---|---|---|
全局压缩开关(dataCoord.enableCompaction) | true | 总闸,关了整个 compaction 都没了 |
| false | 功能开关 |
| false | 自动触发开关 |
默认配置下,聚类压缩就是一个手动功能:client.compact(collection_name=..., is_clustering=True)。
它同一时刻对一个 collection 只能跑一个任务,触发节奏还要看增量数据是否超过 512MB、距上次是否超过 24 小时之类。
官方给出过一个内部基准:2000 万条 768 维数据、按聚类键过滤到 99% 剪枝率时,QPS 对比不压缩最多约 25 倍提升。
这个数字是官方内部基准,不是外部可复现的实验。
我的判断是:聚类压缩适合有明确过滤维度、collection 大的场景,小 collection 上了它,收益撑不起代价。
如果只能给一条手动干预的建议,我的选择是:先确认自动 compaction 的队列和优先级没被堵,再谈手动。
手动干预只能临时减压,自动链路的队列和优先级才是主战场。
06 段多到什么时候是问题:代价、曲线、决策次序
最后把代价算清楚。
官方数据处理文档里有句关键的话:为了避免频繁为数据更新建立索引,Milvus 将 Collections 进一步划分为多个分段,每个分段都有自己的索引。
段是索引的载体:段越多,要构建和加载的索引份数越多。
查询时,Proxy 组件会把请求广播给所有相关分片,流节点搜 growing 数据、查询节点搜 sealed 数据;段被封口后还要经过移交(handoff)流程,协调器把 sealed 段平均分配到各查询节点,平衡内存、CPU 和段数。
段数一多,这三件事的盘子都变大:查询要扫的段文件变多,索引进内存的总量变大,移交和均衡的成本变高。
碎片在对象存储侧的体现则是小文件多、列表和读取放大。
那段多什么时候算正常、什么时候算信号?段数量曲线的形状比某个绝对数字更能说明问题。
曲线形态 | 背后状态 | 该不该动 |
|---|---|---|
随数据量同步缓慢上升 | 分片并行、封口机制、后台压缩三者在稳定平衡 | 不用动 |
数据量没涨,段数持续上台阶 | 封口节奏出问题,或压缩链路堵了 | 立刻排查 |
这通常是封口节奏出了问题:可能某个 collection 在做高频 upsert 或批量删除,blocking-L0 级联在持续提前封口;可能压缩队列积压、执行中任务数顶到槽位上限,mix 被 L0 挤压,碎片没人合。
这时候先看清段大小的代价不对称:封口条件本身调得过大(比如把 maxSize 调到 8GB),段会变少但单个段变大,查询节点的加载内存和故障恢复成本会上去。force merge 的 4GB 决定手动合并能合出多大的段。maxSize 决定写入中一个段多大会被封。调大段大小,只是把问题从段数转移到了段大小。
这个次序是我的核心判断,三步:先封口条件,再 compaction 是否跟上,最后才轮到手动干预。每步具体看哪些数字:
次序 | 先排什么 | 具体看哪些数字 |
|---|---|---|
第一步 | 封口条件是否太激进 | 12% 封口比例、24 小时寿命、10 分钟空闲、blocking-L0 的 500 万条 / 64MB |
第二步 | compaction 是否跟得上 | 队列长度、执行中任务数、槽位是否占满、mix 是否被 L0 挤压 |
第三步 | 才轮到手动干预 | force merge 解中等段死结(m→n),聚类压缩按查询模式重组;挑低峰期,先算清最小节点内存 ÷ 4 |
还有个没对上的地方,两边出处不一致。我按源码默认 1024 引用,文档示例 512 一并标注,发行版以实际配置为准。
出处 | maxSize 默认值 | 出处细节 |
|---|---|---|
官方文档 force merge 配置示例 | 512MB | 文档一侧的示例值 |
源码 commit 1306ae0816 paramtable | 1024MB | 本文引用值 |
结论不受这个差异影响:无论上限是 512 还是 1024,12% 的封口比例都意味着段在远小于上限时就被封,段多的机制不变。
回到开头文档说的那件事:段满了就封存,封存了就新建一个段。
这句话的完整版本是:段被一堆默认值提前封口,被分片和大批次切开,被删除链堵着路,然后由一个被容量和互斥约束住的压缩系统慢慢收拾。
知道每个决策长什么样,段多的曲线就从黑盒变成一组可以逐项对表的参数。
你手上一个 collection 现在多少段,对着第 02、04 两张表排一遍,卡在哪一道?
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号