急诊室第二篇:过滤条件为什么没下推
原创
急诊室第二篇:过滤条件为什么没下推
原创
数据库急诊室_阿哲
发布于 2026-11-05 16:19:51
发布于 2026-11-05 16:19:51
这是「数据库急诊室」的第二篇。
第一篇里,我讲了自己为什么把账号叫急诊室,也给了一个简单的分诊方法:一条 SQL 慢,先看它是在等、在读、还是在算,再决定改哪里。这一篇按这个顺序,走一个完整病例。
我是阿哲,八年数据库运维和优化,金融行业甲方出身,后来做独立顾问,集中式和分布式都碰过。只聊能复现的东西;给结论之前,先把口径说清楚。
先给结论:这条 SQL 的索引是齐的,统计信息也是新的,但执行计划里两段都是 Seq Scan。把日期条件从 UNION ALL 外层挪到每个分支的 GROUP BY 之前,下面这组示例数据里,执行时间从 8.4 秒降到 190 毫秒。
这篇不复述 SQL 语法,重点讲三件事:怎么从执行计划判断「条件放晚了」、为什么优化器不推、改写之后要注意什么边界。
下面用一组脱敏示例数据把判断过程走一遍:表名、行数、执行计划、耗时都是为了说明机制构造的,不是生产实测,也不代表任何产品的性能。
一、适用场景
如果你遇到下面这些情况,这篇可能对你有用:
- 索引明明有,
EXPLAIN里还是Seq Scan; - 查询里有
GROUP BY、UNION ALL、DISTINCT或窗口函数; - 过滤条件写在最外层,聚合之后再筛;
- 加索引、
ANALYZE都试过,计划没变。
二、现场:一条日终统计 SQL
业务要统计某个营业日各账户的净流入。SQL 从交接文档里来,一直能跑:
SELECT account_id, sum(amount) AS net_amount
FROM (
    SELECT account_id, biz_date, sum(amount) AS amount
    FROM trade_flow_cur
    GROUP BY account_id, biz_date
    UNION ALL
    SELECT account_id, biz_date, sum(amount) AS amount
    FROM trade_flow_his
    GROUP BY account_id, biz_date
) t
WHERE t.biz_date = DATE '2026-09-30'
GROUP BY account_id;
trade_flow_cur 约 1,860 万行,trade_flow_his 约 2.1 亿行,单日约 60 万行。两张表都有 (biz_date, account_id) INCLUDE (amount) 的索引。
示例快照取的是 9 月 30 日 23:40:那一刻 cur 是 9 月整月,his 是 8 月及以前的归档,所以 9 月 30 日的数据只在 cur 里。
三、执行计划里的三条线索
改前示例计划 EXPLAIN (ANALYZE, BUFFERS) 节选:
Subquery Scan on t
  Filter: (t.biz_date = '2026-09-30'::date)
  ->  Append
        ->  GroupAggregate
              Group Key: trade_flow_cur.account_id, trade_flow_cur.biz_date
              ->  Seq Scan on trade_flow_cur
                    (actual time=0.015..1850.432 rows=18600000 loops=1)
        ->  GroupAggregate
              Group Key: trade_flow_his.account_id, trade_flow_his.biz_date
              ->  Seq Scan on trade_flow_his
                    (actual time=0.021..6120.118 rows=210000000 loops=1)
Execution Time: 8420.6 ms
看三处:
- 扫描节点:两个分支都是
Seq Scan,分别扫了 1,860 万和 2.1 亿行。 - 聚合键:
Group Key里有biz_date,说明每个分支先聚合了所有日期。 - 过滤位置:
Filter在Subquery Scan上,是Append和聚合之后才应用。
这里最关键的区别是 Index Cond 和 Filter:
Index Cond是索引访问条件,数据库只读满足条件的索引项;Filter是读完行之后的逐行判断,读都读了,筛掉也省不下扫描。
这条 SQL 的 biz_date 只出现在 Filter 里,索引的前导列没有参与访问。
四、分诊:先排除等,再排除读,最后落到算
按第一篇的顺序,把「等」「读」「算」各过一遍。
先看「等」:pg_stat_activity 没有长等待,pg_locks 里没有 granted = false,iostat -x 1 的 %util 不到 20%。不是锁,也不是 IO。
再看「读」:pg_indexes 里两张表的索引都在,列顺序 (biz_date, account_id) 也对;last_analyze 是当天,手动 ANALYZE 后计划没变,估算行数和实际也接近。不是缺索引,也不是统计信息过期。
顺手排除了 prepared statement 的 generic plan:EXPLAIN EXECUTE 的计划一样。
最后看「算」:biz_date 是每个分支的 GROUP BY 键,外层的 WHERE 作用在聚合结果上。过滤条件被 GROUP BY 和 UNION ALL 挡在外面,索引只能当 Filter 用。问题落在「算」的边界上。
分诊 | 假设 | 检查动作 | 结果 |
|---|---|---|---|
等 | 锁/IO 争用 |
| 无长等待、无锁等待、磁盘 |
读 | 索引缺失 |
| 索引存在,列顺序 |
读 | 统计信息过期 | 看 | 计划不变,估算行数与实际接近 |
算 | 条件下推边界 | 看 | 条件停在聚合/ |
三组检查里,前两组都排除了,问题落在「算」:不是索引的问题,是条件放晚了。
五、根因:聚合和 UNION ALL 是下推边界
「谓词下推」说人话:数据库希望尽可能早地过滤,能少读一行就少读一行。但有些结构会挡住下推,GROUP BY、UNION ALL、DISTINCT、窗口函数都可能是边界。
这条 SQL 里,biz_date 是每个分支的聚合键。外层的 WHERE 作用在聚合结果上,优化器不能随便把它挪到聚合之前,否则可能改变语义。于是执行顺序变成:
扫描全量 → 按账户+日期聚合 → UNION ALL → 过滤一天 → 按账户再聚合索引 (biz_date, account_id) 只能在扫描之后当 Filter 用。不是索引没用,是条件放晚了。
六、改写:把日期条件放进每个分支
SELECT account_id, sum(amount) AS net_amount
FROM (
    SELECT account_id, sum(amount) AS amount
    FROM trade_flow_cur
    WHERE biz_date = DATE '2026-09-30'
    GROUP BY account_id
    UNION ALL
    SELECT account_id, sum(amount) AS amount
    FROM trade_flow_his
    WHERE biz_date = DATE '2026-09-30'
    GROUP BY account_id
) t
GROUP BY account_id;
改动点:
- 日期条件从
UNION ALL外层挪到每个分支的GROUP BY之前; - 内层不再
SELECT/GROUP BY biz_date,因为每个分支只剩一天; - 外层仍然按
account_id汇总,语义不变。
改后示例计划:
Append
  ->  GroupAggregate
        Group Key: trade_flow_cur.account_id
        ->  Index Only Scan using idx_trade_cur_bizdate_account on trade_flow_cur
              Index Cond: (biz_date = '2026-09-30'::date)
              Heap Fetches: 0
              (actual time=0.030..78.412 rows=612480 loops=1)
  ->  GroupAggregate
        Group Key: trade_flow_his.account_id
        ->  Index Only Scan using idx_trade_his_bizdate_account on trade_flow_his
              Index Cond: (biz_date = '2026-09-30'::date)
              Heap Fetches: 0
              (actual time=0.019..0.021 rows=0 loops=1)
Execution Time: 190.4 ms
七、结果与验证
指标 | 改前 | 改后 |
|---|---|---|
示例执行时间(3 次中位数) | 8,420 ms | 190 ms |
扫描行数 | 228,600,000 | 612,480 |
shared buffers read | 1,712,345 | 8,214 |
计划 |
|
|
结果行数 | 118,432 | 118,432 |
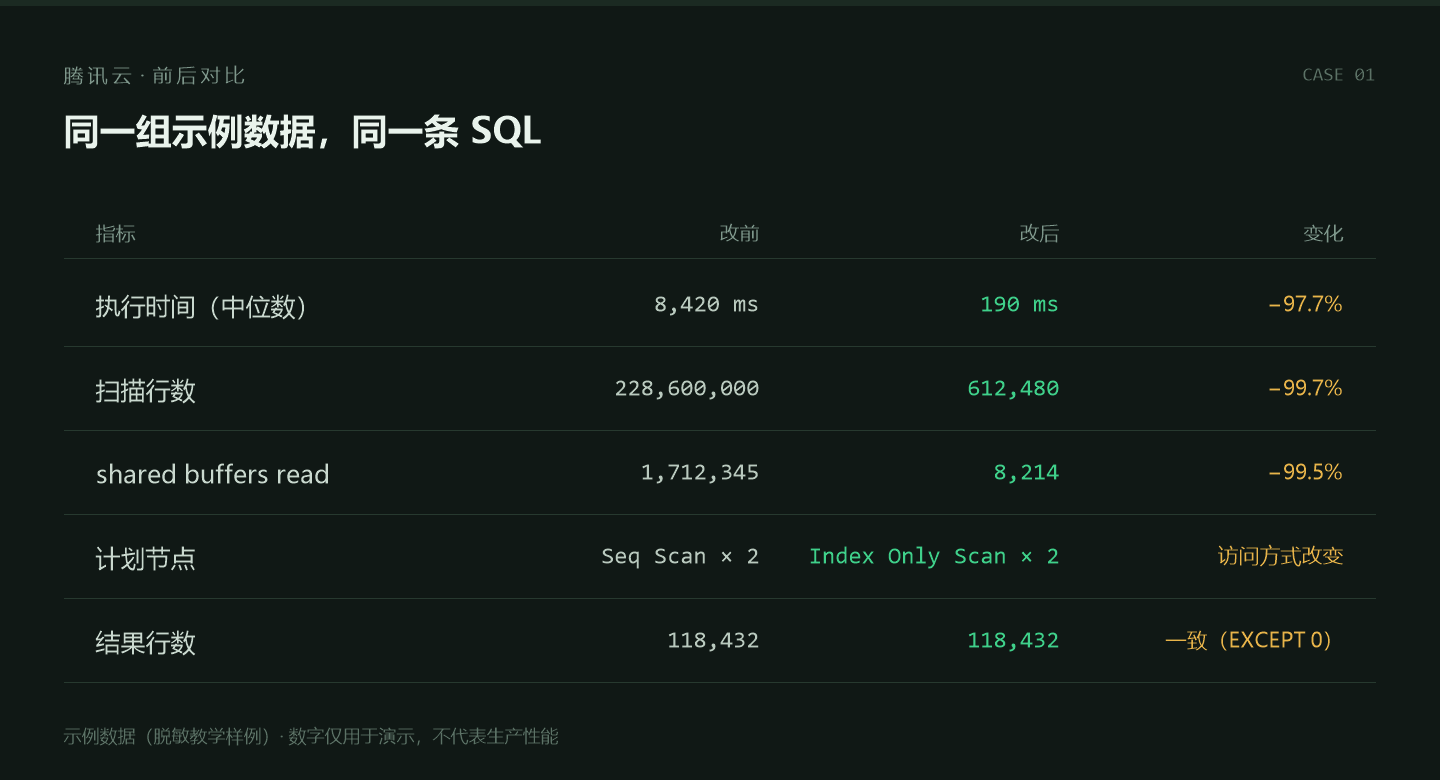
his 分支扫了 2.1 亿行、返回 0 行,因为 9 月 30 日的数据在 cur 里。改前的大部分时间就花在这张「用不上」的表上。
示例里用 EXCEPT 双向核对,两个方向都是 0;sum(net_amount) 的 checksum 也一致。
以上数字来自脱敏示例环境,只用于对比「条件位置」带来的计划差异;不同硬件、版本、数据分布会不同,方法可复用,数字不要照搬。
八、边界与副作用
- 日期写两遍:两个分支必须用同一个参数;用绑定变量或 CTE 固定,避免只改一个分支。
- UNION ALL 重叠:
cur和his如果日期重叠,金额会重复;加边界或改成去重逻辑。 - 大范围日期:跑一个月汇总时,索引扫描可能不如全表扫描;按实际范围测。
- Index Only Scan 依赖 visibility map:批量导入后看
Heap Fetches,必要时VACUUM。 - generic plan:prepared statement 可能切到通用计划;用
EXPLAIN EXECUTE确认。 - 不可下推的写法:
to_char(biz_date, ...)、CASE WHEN里的条件,先改成可 sargable 的写法。 - 版本差异:不是所有库、所有版本都不下推;判断标准是计划里的
Index Cond,不是背规则。
九、检查清单
- 先看
EXPLAIN (ANALYZE, BUFFERS) - 看
Index Cond是否存在 - 看聚合/集合运算是否挡住下推
- 看估算行数与实际行数
- 看
shared buffers read - 改后
EXCEPT双向核对 - 三次取中位数,写清口径
- 检查重叠边界、参数、generic plan
- 保留改前 SQL 可回滚
十、小结
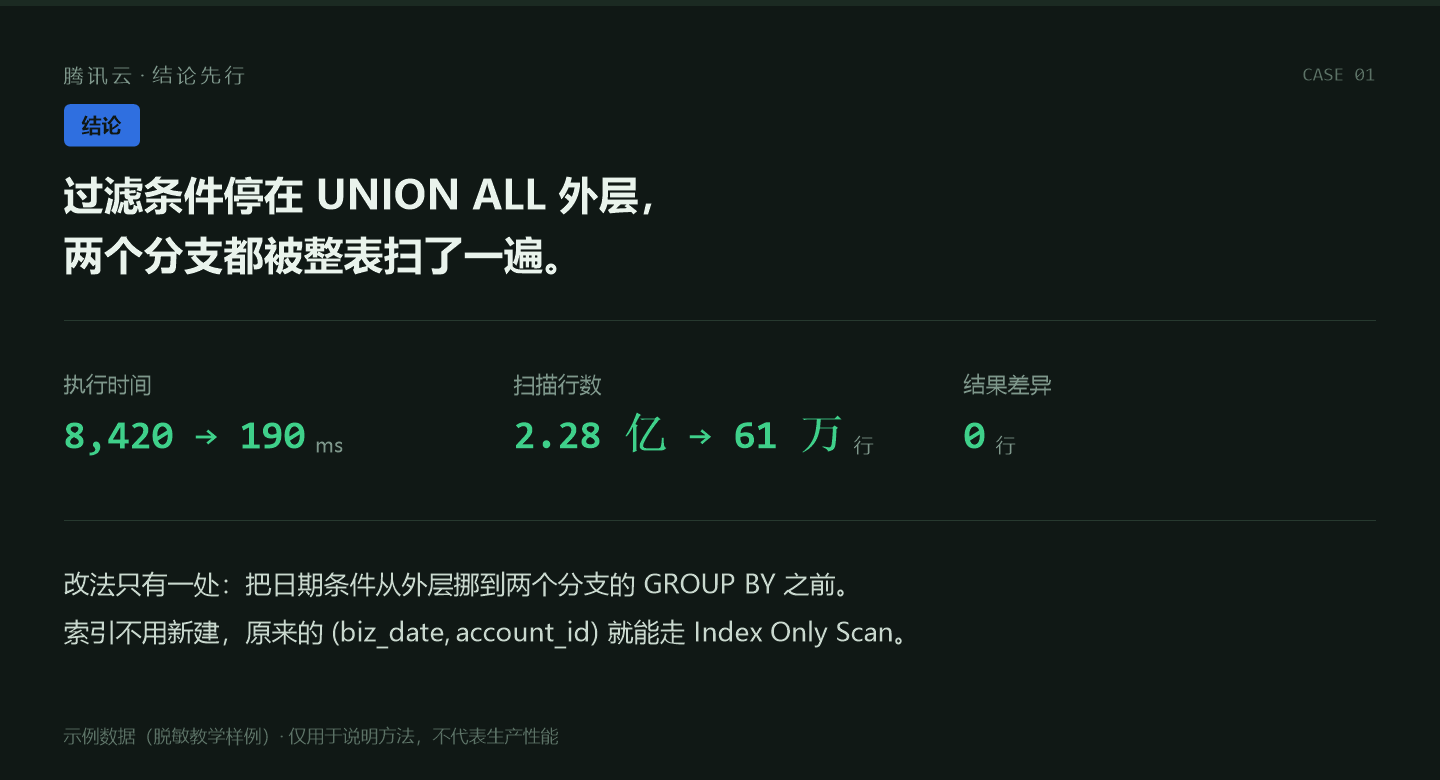
这条 SQL 的教训不是「加索引」,而是「先看条件在哪一层」。索引在,统计信息也新,但条件被聚合和 UNION ALL 挡在外面,索引只能当 Filter 用。
如果你也遇到「索引有、计划不走」,先把执行计划里 Index Cond 和 Filter 的位置找出来。多数时候不是索引的问题,是条件放晚了。
同样的现象可能有别的根因,欢迎带数字来讨论。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号