设备问数的流程重构与两轮验证
原创
设备问数的流程重构与两轮验证
原创
用户12875793
发布于 2026-11-05 17:10:31
发布于 2026-11-05 17:10:31
公司此前参与的同类客户概念验证(POC)中,智能问数的实际效果未达到预期。复盘后,我们把改进重点放在业务问答流程重构和技术组件选用上,希望为后续同类项目积累可复用的方案与经验。
这次重建聚焦结构化设备数据查询:用户用自然语言询问设备结构、部件类别及测量记录,并通过连续追问改变查询条件。测试中,用户提出:“统计全部测量记录中状态为已报警的原始记录数。”条件已经明确,旧版却要求再次确认,没有执行查询。后续增加、撤销筛选的追问,也因上一轮未完成而中断。这个案例将改造重点落到了业务执行过程:用户的本轮要求如何与历史条件合并,合并后怎样驱动查询,查询结果又怎样完整交付。
项目用两轮测试回答不同的问题。第一轮比较新旧实现,检验流程重构后明确请求能否执行、连续追问能否延续,以及答案是否完整;同一批153次问答中,完整回答通过数由110次提高到147次。第二轮在新版基础上,比较DeepSeek、GPT各自有无本体的四组配置,同时检查原有任务和新增的关系推导、资料检查任务。新增20次问答中,GPT的完整通过数由无本体时的14次提高到18次,DeepSeek两组均为11次。
一、业务对象与查询口径
验证面向能源行业设备管理,使用五份脱敏CSV历史快照:现场对象目录、构型树、设备类字典、部件类字典和测量表。其中有16,796个现场对象、24,025个构型对象及12,985条测量记录。
现场对象目录在项目中称为PBS,记录设备、子设备、部件和测点的实际挂接关系。构型是描述设备或部件结构的模型节点,构型树组织这些节点的父子关系;类别字典则提供分类编码及名称。现场对象、构型和类别分别存放,查询时需要按业务关系关联。现场部件XJ2ABC001RR&RRGA01#21对应构型RRGA01#21,该构型引用部件类ZZZZZ00。
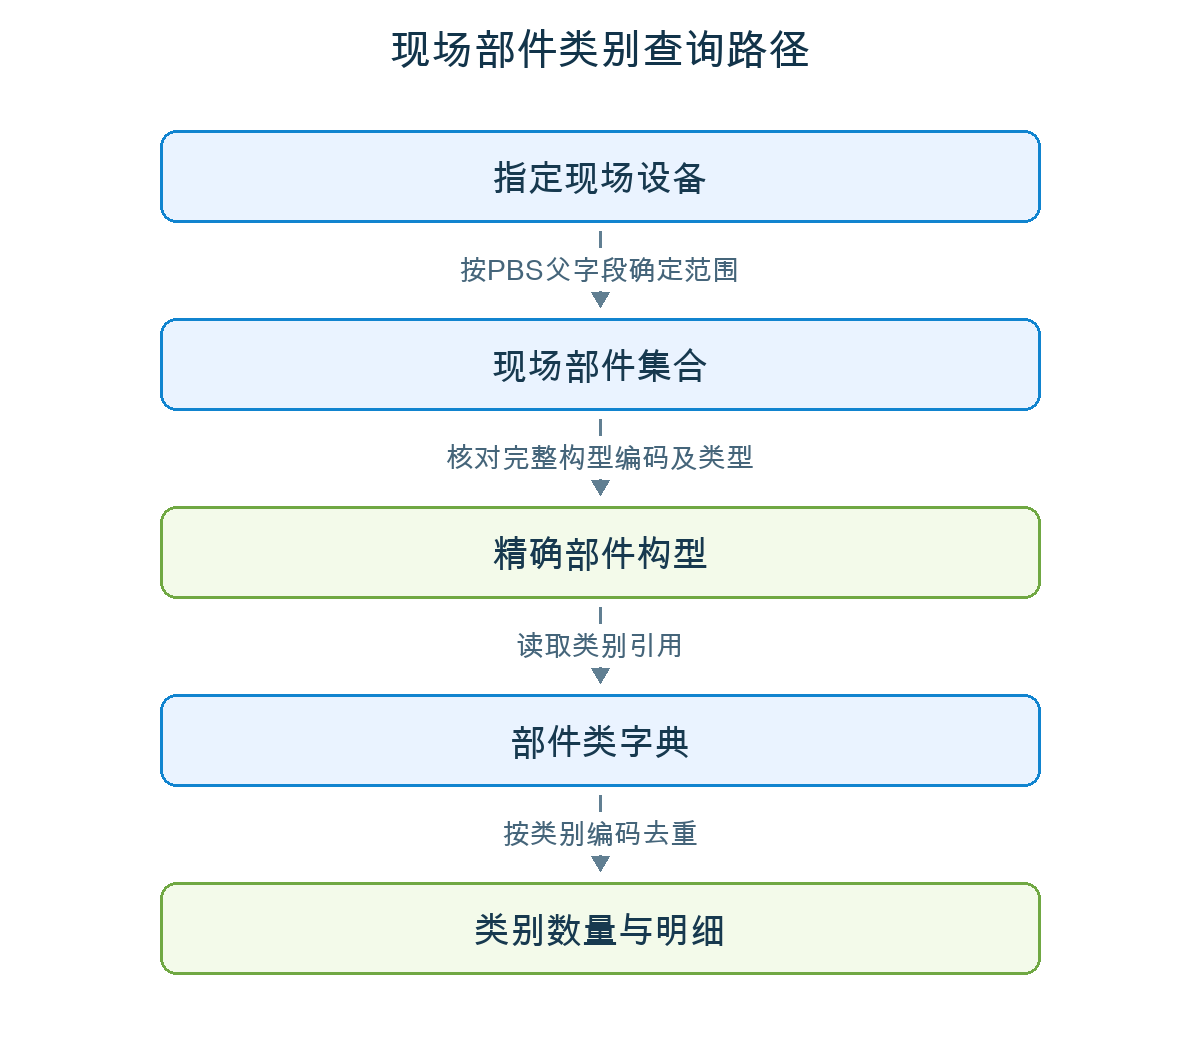
图1 现场部件类别查询路径
在指定现场功能位置及设备类的范围内,一道题涉及90个部件、23个部件类。统计部件实例与按类别去重,回答的是不同问题。另一道构型查询题中,直属部件为0个,全部后代部件有5,749个,遍历范围直接影响答案。
测量表也需要区分记录数与测点数。在“源系统2、状态未提供”的范围内,有4条记录、3个不同完整测点编码。同一测点的多条记录需要保留,不能因为编码相同就合并。
连续追问还会改变当前要求:“扩大为全部后代”修改范围,“取消开启条件”撤销筛选,“按来源统计”增加分组。系统既要识别本轮变化,也要保留仍然有效的条件。
二、业务请求与执行流程
旧版已有对象解析、查询和多层核验,但部分条件明确的请求仍被范围检查拦截,后续追问也因前一步未完成而受阻。新版重新组织这条执行链:保存当前完整查询要求,由模型提取本轮变化,再由程序更新条件、执行查询和交付结果。每次追问都更新同一份结构化请求,未被用户撤销或替换的条件继续保留。
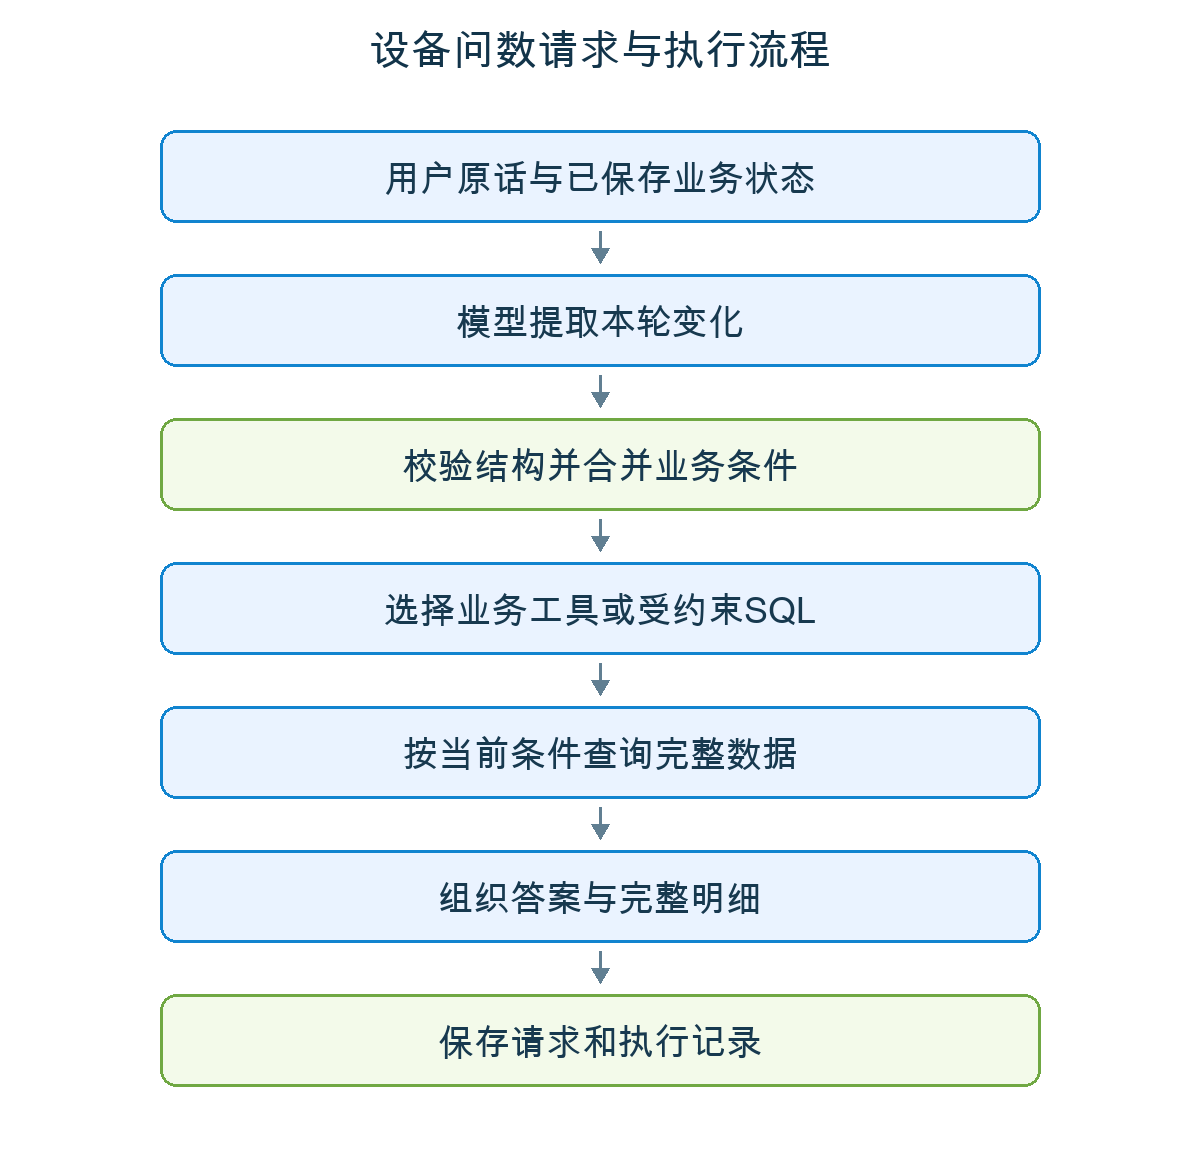
图2 设备问数请求与执行流程
请求状态与逐轮更新
业务状态包含对象、对象域、范围、筛选、分组和指标。对象域区分现场目录、构型树与类别字典,同一编码出现在不同域时分别识别。会话文字用于理解上下文,结构化请求用于驱动查询;两者都保存,但承担不同职责。
模型提交本轮新增、替换或撤销的内容,Pydantic校验请求结构,再由程序与已保存条件合并。新任务重新建立请求,延续任务则在原请求上修改。例如,用户要求“撤销开关条件,仍只看已报警,按源系统分别统计记录数”:
状态更新环节 | 内容 |
|---|---|
上一轮请求 | 状态=已报警;开关=开启;统计原始记录数 |
本轮变化 | 删除开关筛选;增加源系统分组 |
合并后请求 | 在已报警记录中,按源系统分组统计原始记录数 |
项目merge_plan函数中,新任务初始化与撤销筛选的代码如下。previous是已保存请求,plan是本轮变化,field_name将字段别名对应到数据字段:
state = (
    {} if plan.transition == 'new_task'
    else dict(previous)
)
filters = (
    {} if plan.transition == 'new_task'
    else dict(state.get('filters') or {})
)
for field in plan.remove_filters:
filters.pop(field_name(data, field), None)这段代码先区分新任务与延续任务,再删除明确撤销的筛选。后续代码将新增筛选按字段和运算符合并,未提及的条件继续保留。范围修改还要核对原话是否明确包含“直属”“全部后代”等要求。合并完成后,按当前完整请求重新执行查询。Pydantic模型说明
解析仍可能出错。例如,模型把追问判断为新任务,程序就可能清空原条件。因此,执行记录同时保留模型提取的本轮变化和程序合并后的请求,便于区分变化提取错误与条件合并错误。
查询执行与完整交付
层级遍历、构型映射、类别计数等稳定任务,由程序选择已注册业务函数,传入当前条件计算。其他组合需求由模型组织查询步骤,SQL经过结构检查后通过只读连接执行。SQLGlot官方说明
查询结果保存为独立结果集,记录总行数、已保存行数和结果引用。页面先展示预览,用户索取全部明细时继续读取完整结果。统计与排序针对当前条件下的数据执行,页面预览只承担展示作用。
部分稳定任务直接由程序根据工具结果组织答复,减少编码改写与明细遗漏。每轮留下用户原话、本轮变化、完整请求、工具参数、实际结果和首次答复,使错误能够沿请求解析、条件合并、查询计算、答案组织几个环节查找。
三、业务语义与组件分工
上述流程由五层架构承接,分别负责应用交互、智能体执行、业务语义模型、查询计算和数据。执行层管理每轮请求与工具调用,查询层返回实际结果及异常,交互层交付答案与明细;业务语义模型提供各层共同采用的对象定义、关联路径和统计口径。
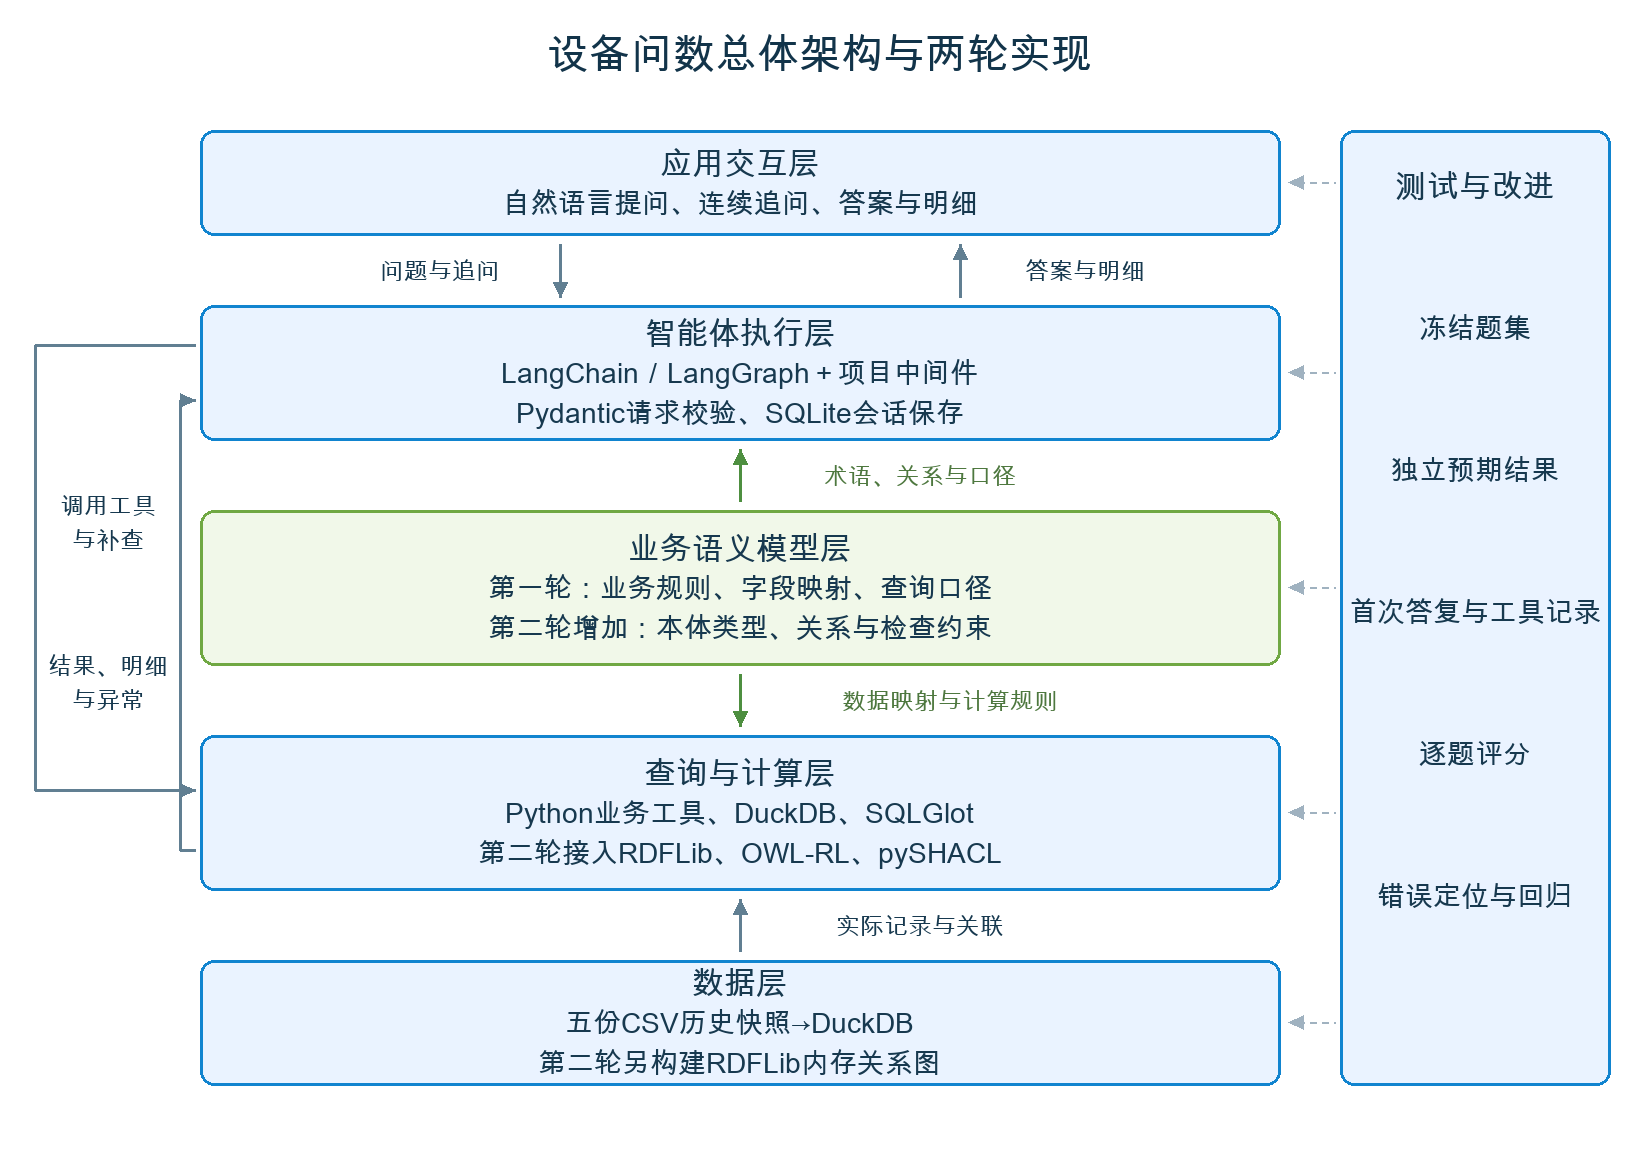
图3 设备问数总体架构与两轮实现
业务语义模型连接模型理解与程序计算。例如,“全部后代”需要明确遍历现场目录还是构型树,“类别数”需要明确经过哪条关联、按什么编码去重。第一轮通过业务规则文件、字段配置和查询函数落实这些定义;第二轮进一步引入独立本体,表达类型、关系和检查约束。
组件及实验版本 | 在项目中的分工 |
|---|---|
LangChain 1.4.7、LangGraph 1.2.18 | 组织模型、消息与工具调用,管理执行过程及会话状态 |
langgraph-checkpoint-sqlite 3.1.2 | 将会话及业务请求保存到SQLite,恢复后继续使用 |
Pydantic 2.14.2 | 定义和校验业务请求结构 |
DuckDB 2.0.0 | 对实际数据执行查询与统计,配合Python关系函数 |
SQLGlot 30.26.0 | 解析SQL,检查允许的语句、表、函数及只读操作 |
项目通过中间件,在模型调用前后加入请求规划、条件合并和结果处理。例如,Pydantic负责请求结构校验,字段别名怎样映射、撤销哪个筛选、某项统计走哪条业务关系,则由配置和项目代码落实。LangGraph执行与状态说明、状态持久化
这些组件与项目代码一起,初步形成面向设备问数的运行时(runtime)和执行控制机制(harness):前者支持模型、工具和状态运行,后者组织业务上下文、调用限制与结果处理。框架提供执行基础,设备关系、统计口径和答复要求仍由项目落实。
四、第一轮:业务流程重构对照
第一轮检验整条业务链路:明确的请求能否执行,追问后是否保留正确条件,最终回答是否包含所需明细与解释。共153次问答,覆盖历史问题、现场追问、组合查询和条件变化,包含连续对话、重复提问及开发中使用过的问题。评测按每次提问后的首次答复计分,连续追问各计一次。
旧版采用同一实现的既有105次问答记录和48次补测记录,新版采用冻结版本对全部153次提问的首次答复。两版按相同业务规则,逐轮复核最终答复、查询结果、完整明细与关系说明。预期结果单独保存,不提供给运行中的智能体。
这一轮同时调整了流程、业务代码和模型分工。旧版用DeepSeek Flash处理请求、Pro核验;新版用Pro规划、Flash处理灵活执行并启用推理模式。成绩反映这些调整共同作用后的整体效果。
评价采用两个指标:“主要结果正确”要求对象、范围及所问数量或字段符合要求;“完整回答通过”还要求所需清单、字段、来源和解释均符合要求,且没有额外错误。
评价指标 | 旧版 | 新版 |
|---|---|---|
主要结果正确 | 112/153(73.2%) | 151/153(98.7%) |
完整回答通过 | 110/153(71.9%) | 147/153(96.1%) |
开篇的报警查询,新版得到48条。另一组连续追问展示了条件更新的效果:
同一对话中的要求 | 旧版 | 新版 |
|---|---|---|
按源系统3统计不同完整测点编码数和原始记录数 | 范围检查拦截,未执行 | 10,659个编码、10,659条记录 |
再只保留开关为关闭的 | 上一轮未完成,要求重述 | 保留来源,增加关闭:22个编码、22条记录 |
取消来源限制,关闭条件继续保留 | 对话继续受阻 | 撤销来源,保留关闭:27个编码、27条记录 |
这组对话第三次提问的关键是删除来源限制,同时保留关闭条件及原有的两项统计指标。对这类追问,需要同时核对当前条件、实际查询参数和答复结果,才能判断任务是否正确延续。
新版仍有2次主要结果错误,另4次主要结果正确但完整回答未通过。例如,直属子设备数量为1个,新版答对了,却额外称全部后代也只有1个,实际为2个。“主要结果正确”与“完整回答通过”两个指标,使这种附加解释错误也被保留下来。
第一轮由此形成了可继续复用的检验方式:用单题检查对象与口径,用连续题检查条件变化,用完整回答指标检查明细、来源及解释。第二轮在这套流程上扩展能力,并重新检查原有题目。
五、第二轮:本体与模型配合对照
第二轮在新版副本中接入本体,保留第一轮实现作为冻结基线。这一轮检查两件事:本体能否补充类型继承、关系推导和资料检查能力,以及扩展后原有问答是否保持稳定。
本体扩展的业务内容
这里的本体是一套程序可以读取的业务定义:有哪些对象类型、它们如何关联,以及数据需要满足哪些约束。第一轮的这些定义分布在业务规则文件、配置及查询函数中;第二轮将类型继承、对象关系和资料约束集中到独立本体,再把实际对象映射进去。RDFLib 7.6.0组织和查询关系图,OWL-RL 7.6.2按本体规则推理,pySHACL 0.40.2检查用SHACL表达的数据约束。项目负责模型定义、数据映射及工具接入。RDFLib、OWL-RL、pySHACL
模型定义15种类型、14种对象关系和6组检查约束。基础图包含59,181个按数据域分别建立的对象身份,以及12,985个测量记录节点,共604,690条三元组。三元组是一条“对象—关系或属性—对象或值”记录,例如“构型RRGA01#21—所属部件类—ZZZZZ00”。
关系图提前组织对象的身份、类型和关联,提问时可以沿这些关系查找。图在RDFLib内存中组织,推理按当前对象相关范围执行;测量值和阈值等详细字段仍由DuckDB读取。测量表共有12,981个不同完整测点编码,对应12,985条记录,同码记录分别保留。
本体还区分现场父链与类型继承。部件挂在设备下,是两个具体对象的关系;“部件是一种结构对象”,则是类型定义。询问部件上位类型时,DeepSeek无本体组回答“设备、功能位置”,GPT无本体组说明缺少继承定义。有本体组获得类型定义与推理工具后,给出了:
部件 Part → 结构对象 StructuralObject → PBS对象 PBSEntity → 实体 Entity
这道题区分了“具体对象挂在哪个设备下”和“对象类型属于哪个上位类型”。本体组获得了可执行的类型定义,模型才有相应依据回答该项目的类型层次。
四组配置与测试结果
第二轮沿用新版的业务执行流程,设置DeepSeek、GPT各自有无本体的四组配置。四组共用同一批数据、题目和扩展后的请求结构;无本体组使用原有业务规则与查询工具,有本体组额外接入本体定义、推理和检查工具。表中差异对应本体定义与工具一并接入后的效果;本体引擎与实现同等定义的Python程序未另作对照。
每组重新运行原153次问答,检查扩展后已有任务是否退步;另运行新增20次关系与资料检查问答,检验新增能力。每组173次,四组合计692次首次答复。不同对话独立建会话,同一对话内顺序追问。
规划模型提取本轮变化,执行模型处理灵活查询。DeepSeek组使用deepseek-v4-pro规划、deepseek-v4-flash执行,推理强度为low;GPT组两阶段均使用gpt-6.1-sol,推理强度为medium。以上为实验接口记录的标识,成绩对应所列配置。第二轮扩展了请求结构并重新运行全部题目,回归成绩与第一轮分别列示。
原153次问答:检查原有任务
模型 | 本体 | 主要结果正确 | 完整回答通过 |
|---|---|---|---|
DeepSeek | 无 | 149/153(97.4%) | 147/153(96.1%) |
DeepSeek | 有 | 149/153(97.4%) | 146/153(95.4%) |
GPT | 无 | 150/153(98.0%) | 150/153(98.0%) |
GPT | 有 | 151/153(98.7%) | 151/153(98.7%) |
新增20次问答:检查本体扩展能力
模型 | 本体 | 主要结果正确 | 完整回答通过 |
|---|---|---|---|
DeepSeek | 无 | 14/20(70%) | 11/20(55%) |
DeepSeek | 有 | 15/20(75%) | 11/20(55%) |
GPT | 无 | 16/20(80%) | 14/20(70%) |
GPT | 有 | 19/20(95%) | 18/20(90%) |
在新增20次问答中,GPT完整通过数由14次提高到18次,DeepSeek仍为11次;在原153次问答中,DeepSeek有本体组还少通过1次。本体提供了更明确的定义与工具,模型是否正确选择关系、使用工具并转述结果,仍影响最终成绩。下面的两道失败题分别对应结果转述和关系选择问题。
工具输出与最终回答
一道资料检查题中,构型小类GALA的父编码GAL在构型树中缺失。pySHACL返回1项父引用问题,DeepSeek本体组最终却报2项,额外将空部件类字段判为问题;GPT本体组保留1项。检查规则只要求部件构型填写部件类引用,小类不适用这项必填要求。W3C SHACL规范
这道题把检查工具与答案组织两个环节分开了:工具已正确列出问题,模型增加了不适用的必填要求。后续可让程序直接组织问题数量及清单,模型只在同一约束下补充说明,减少转述时增加错误的机会。
另有一题要求从测点找到所属设备构型,四组均误答为部件精确构型MOHB01#1-59,正确设备构型是沿构型父链找到的MOHB01。两者都有实际编码,仅检查编码存在无法区分是否回答了所问关系。后续可在工具调用前明确目标对象类型,返回后再核对类型,并将这道题保留为后续版本的必测题。
六、复用条件与改进方向
这次实践最出乎我意料的,是业务流程对问答效果的影响。用户一句“取消来源限制”,需要经过条件撤销、其他条件保留、重新查询和结果交付多个步骤。把这些步骤落实到状态、工具及执行记录中,才能逐轮核对问题出在哪里。
后续同类项目可以先明确对象域、关系路径和计数口径,再保存结构化业务请求,处理新增、撤销和范围变化。稳定关系与统计交给业务函数,灵活查询保留必要的结构检查;验收同时核对结果、明细、来源和解释。连续题则应查看每轮请求与工具参数,检查前后条件是否一致。
当类型、推导关系和资料约束需要被多个任务反复使用时,可以接入独立本体。扩展后既复跑已有任务,也用新题检查新增定义、工具调用与最终回答。已有SQL和业务函数能稳定完成的查询可以沿用;已有智能体平台的团队,可以复用其执行和状态能力,接入相同业务服务。
两轮验证保留了可继续检查后续改动的业务题集和执行记录,以及对应的对象定义、状态更新逻辑、查询工具与本体约束。新项目接入自己的实际数据和问题,重新核对字段映射与业务规则,再按相同方式检查完整任务,逐步积累可复用的实施经验。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号