把 21.6 万字蒸馏成 8 张能力卡:一次完整实操与发布前的版权自查
原创
把 21.6 万字蒸馏成 8 张能力卡:一次完整实操与发布前的版权自查
原创
王磊-医药信息化
发布于 2026-11-09 23:01:39
发布于 2026-11-09 23:01:39
本文首发于腾讯云开发者社区,作者「王磊-医药信息化」,原创实操记录。
周末花了一整天做一件事:把一本 21.6 万字的书,拆成 8 张可被 agent 调用的能力卡,再据此写出一篇长文。
这篇不复述书里讲了什么,也不贴任何原书段落。只复盘一条工程链路——怎么把「读书」变成「可执行的判断契约」,以及最后发布前那轮差点踩线的版权与平台规则自查。后者我觉得比方法论本身更值得写下来。
一、我不要读后感,要能力卡
读书笔记通常有三种产物:摘要、读后感、能力卡。
摘要是信息压缩,读后感是个人感受,两者都只服务人。我这次要的第三种,是能被 agent 直接调用的东西:给定一个处境,它能判断该不该出手、按什么顺序做、什么情况下必须停。
所以第一步不是「总结全书」,而是先定义产出契约。每张卡至少要有:触发条件、不适用的场景、执行步骤、失败信号、输出格式。少了「不适用」,读书笔记就会变成万能药——什么困境都能套,等于什么都没说。
这也是我把重点放在心态、心境、思想、哲学、影响与感悟上的原因:这些不是情节,是判断方式,才可能被结构化。
二、五步流水线
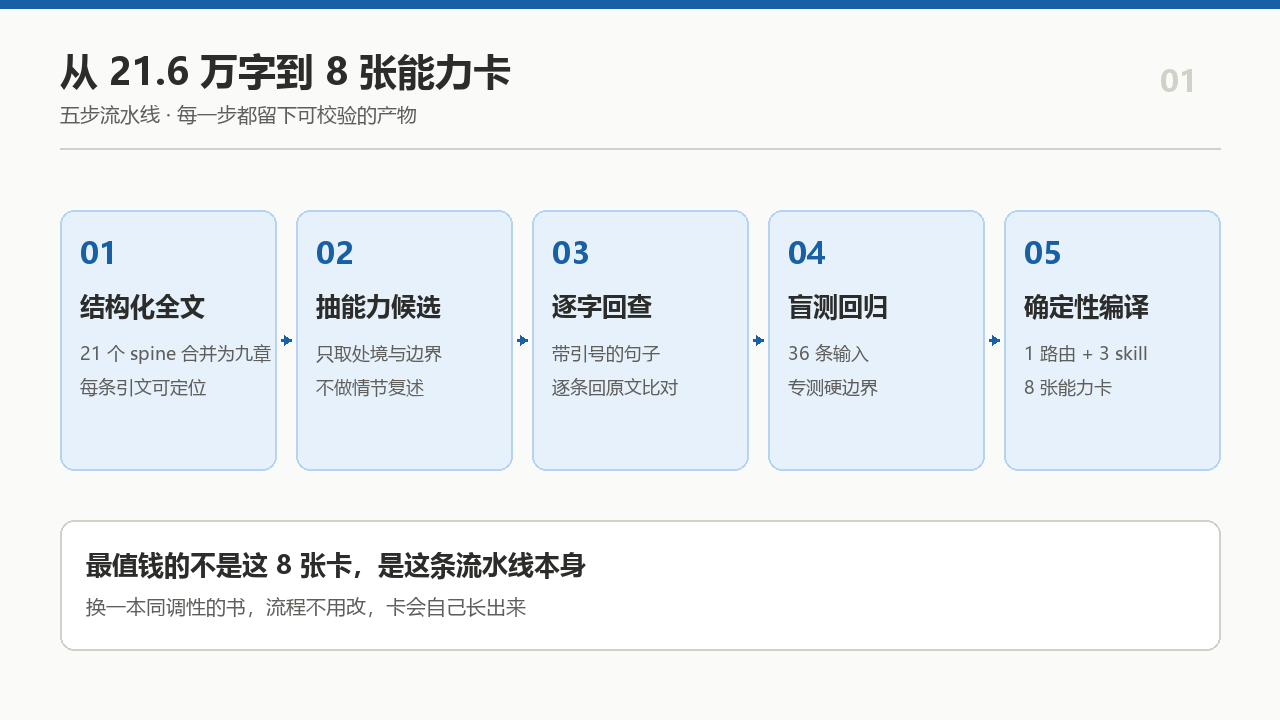
五步流水线:从结构化全文到确定性编译
结构化全文 → 抽能力候选 → 逐字回查 → 盲测回归 → 确定性编译第一步,结构化全文。 21.6 万字先切成 21 个 spine 文件,再合并成标准九章加序、后记。关键不是分词,是让每一条后来的引文都能定位到具体章节。做不到这一点,后面的校验全靠印象。
第二步,抽能力候选。 只读「处境 → 反应 → 边界」,不做情节复述。候选之间允许重叠,先不急着去重。
第三步,逐字回查。 把每一处带引号的句子拿回原文比对。这次 19 处逐字引文全部命中,但顺手抓出两个问题,后面单独说。
第四步,盲测回归。 攒了 36 条输入,专门测硬边界守不守得住。比如给一个明确不会好转的处境,看输出会不会偷偷塞回一句「会好起来的」。这类护栏不测就等于没有。
第五步,确定性编译。 最终产出 1 个路由入口、3 个晋级 skill、8 张能力卡,加上一份 verified.yaml 与回归结果。同一组稳定 ID 贯穿 single 与 pack 两种编译产物。
我觉得最值钱的不是这 8 张卡,而是这条流水线本身:换一本同调性的书,流程不用改,卡会自己长出来。
三、能力卡长什么样
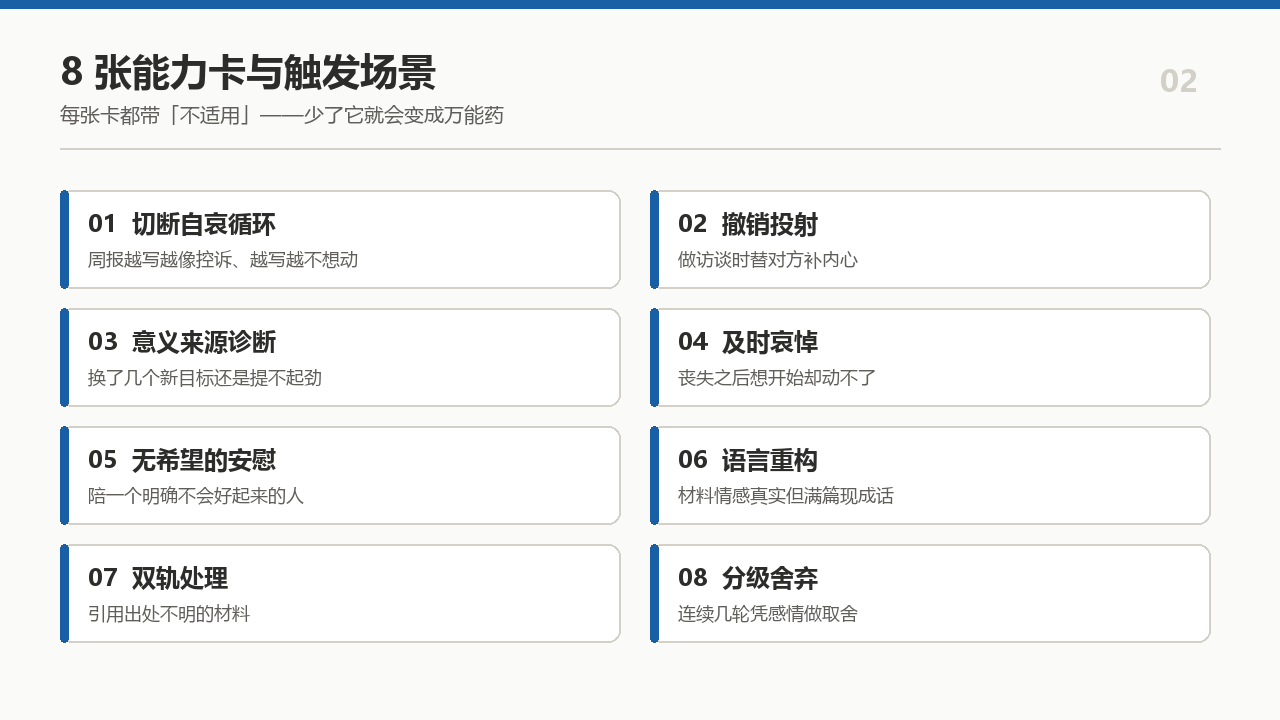
8 张能力卡与各自的触发场景
8 张卡分别对应这些触发场景(用序号列,避免被编辑器把表头吞掉):
序号 | 能力卡 | 什么时候触发 |
|---|---|---|
1 | 切断自哀循环 | 周报越写越像控诉、越写越不想动 |
2 | 撤销投射 | 做访谈时替对方补内心、写人物时拿自己当证据 |
3 | 意义来源诊断 | 换了几个新目标还是提不起劲 |
4 | 及时哀悼 | 丧失之后明明想开始却动不了 |
5 | 无希望的安慰 | 要安慰一个明确不会好起来的人 |
6 | 语言重构 | 材料情感真实但满篇现成话 |
7 | 双轨处理 | 引用一段出处不明的材料,要判断能不能用 |
8 | 分级舍弃 | 连着几轮做取舍,每次都临时凭感情决定 |
一张卡的契约大致是这样,纯文本,不依赖任何框架:
id: comfort-without-hope
trigger: 对方处境在医学或现实层面明确不会好转
hard_boundary:
  - 不说「会好起来的」「终会」「未来可期」
  - 不把对方的痛苦改写成成长素材
failure_signal: 输出里出现任何形式的希望许诺
not_applicable: 处境仍可改变、需要的是行动方案时
failure_signal 这一栏是我后加的。最初的版本只写「该做什么」,回归测试一跑就发现,模型很容易在结尾补一句温柔的话——而那恰好是整张卡要禁止的事。把失败信号写进契约,比反复叮嘱「不要」有效得多。
顺带一个设计教训:跨卡引用别塞进编译产物。我一度想把跨书关系写进 verified.yaml,读代码才发现 also_read 存的是包内 slug,跨包值会被静默丢弃,晋级 skill 还有「不得跨目录引用」的自包含硬门。正确做法是在编译产物之上再加一层人工维护的索引,别让静默失效混进依赖图。
四、逐字回查抓出的两个坑
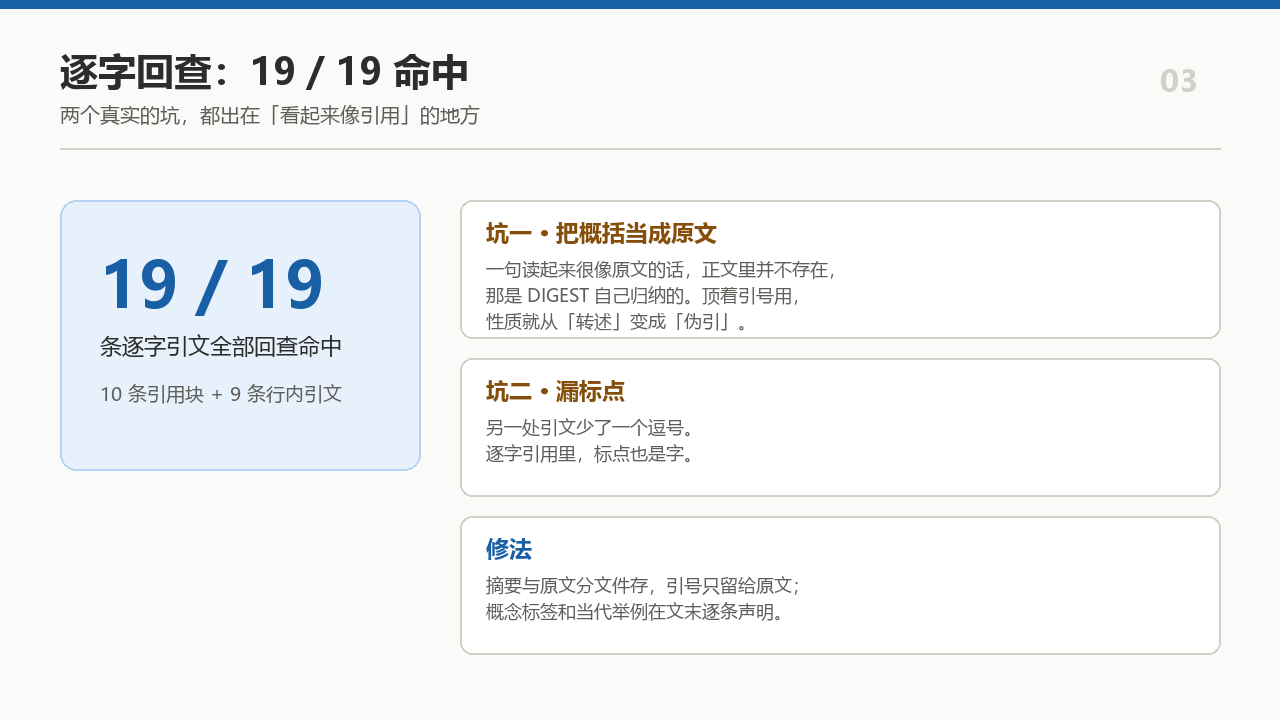
逐字回查 19/19 命中,以及抓出的两个坑
这一步看起来最笨,收益却最直接。
坑一:把摘要层的概括当成了原书引文。 有一句读起来特别像原文的话,回查发现正文里根本不存在,那是 DIGEST 自己归纳的。顶着引号当引文用,性质就从「转述」变成「伪引」。修法很简单:摘要和原文分文件存,引号只留给原文。
坑二:漏标点。 另一处引文少了一个逗号。逐字引用里,标点也是字。
还有一批行内引号,核完确认是概念标签或当代举例,不是逐字引文,于是在文末的编辑备注里逐条声明。「看起来像引用」和「真的是引用」必须分开记账,这是公开发表时最容易被挑出来的地方。
五、从 8 张卡到一篇长文
能力卡堆在一起不是文章。转成叙事时我做了三个决定:
- 先找主线,不是先排卡片。 这本书的序许了一个愿,九章正文却一次次没做到——这条张力就是主线,所有卡片挂上去才有方向。
- 只挑 4 张。 8 张全上会变成功能列表。选最贴当下处境的四张,其余压到背景里。
- 硬边界不妥协。 全文不出现「愿你」「终会」「未来可期」。哪怕平台或编辑器建议加个温暖结尾,也不加——那就把整篇文章推翻了。
写完之后还要反向校验一次:文章的价值是不是来自解读和当代案例,而不是引文本身。如果抽掉引文文章就塌了,那不叫评论,叫搬运。
六、发布前那轮自查(最该抄走的部分)
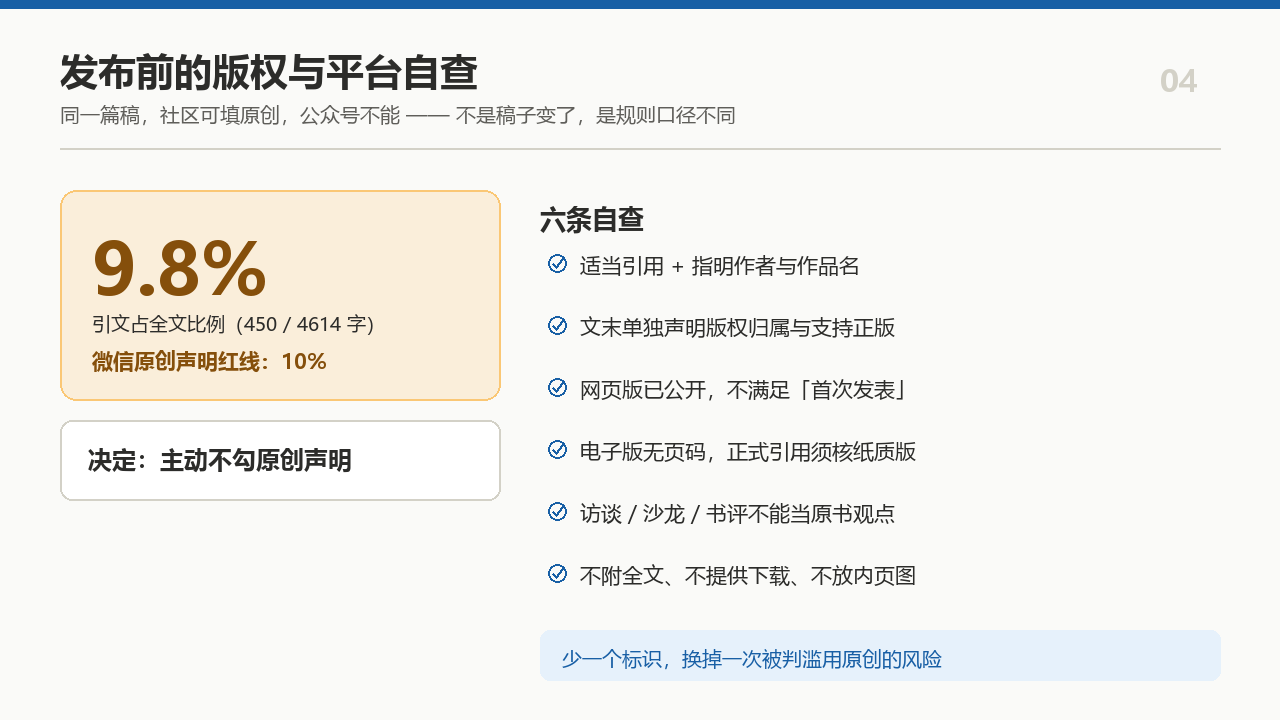
发布前的版权与平台规则自查
这一节是今天真正花时间的地方。
先算法条。 引用他人已发表作品做介绍、评论,属于《著作权法》第二十四条的合理使用范围,但有前提:适当引用、指明作者姓名和作品名称、不影响原作品正常使用、不不合理损害权利人权益。初稿的硬指标是:全文约 4600 字、10 处逐字引文合计约 450 字、占比 9.8%,每处都很短,署名、书名、非官方合作、请支持正版全在文末单独成行。复核时又把三处较长的引文改成了转述,占比降到 7% 上下——这一步不是被迫,是主动把余量留出来。
再看平台规则,这里差点踩线。 微信公众平台的原创声明要求:内容须为自行创作且首次发表,引用他人作品比例不得超过 10% 并明确标注来源;大篇幅整合、非独家授权内容不得声明原创。9.8% 是贴着线走的,而且这篇长文已经先以网页形式公开发布过,「首次发表」这一条也不成立。
结论很干脆:主动不勾原创声明。 少一个标识,换掉一次被判滥用原创的风险,对刚注册的号尤其划算。同一篇稿,在社区可以填「原创」,在公众号不能——不是稿子变了,是两套规则的口径不同。
顺手核了下频次。 订阅号每天 1 次群发、0 点重置、一次最多合并 8 篇;而「发表」不开启群发通知,不占这 1 次额度,内容只进主页和搜一搜。所以「今天已经发过一篇」并不等于「今天不能再发」,只是不同通道的差别。
还有几条容易忘的:
序号 | 检查项 | 这次的处理 |
|---|---|---|
1 | 版本 | 电子版无纸质页码,正式引用须另核纸质版 |
2 | 二手材料 | 访谈、沙龙、书评里的说法不能当原书观点 |
3 | 附件 | 不附原书全文、不提供下载、不放内页截图 |
4 | 导流 | 不在正文里给账号导流,避免被判营销内容 |
5 | 图片 | 只用自己生成的示意图,不用书封或内页图 |
第 2 条这次真救了场:初稿里有个被到处当成书中核心概念的说法,回查发现只出现在一次沙龙发言里,正文一次都没有。把二手话当主旨,整篇都会歪。
七、一天下来的产物
序号 | 产物 | 说明 |
|---|---|---|
1 | 结构化全文 | 九章 + 序 + 后记,可定位 |
2 |
| 约 3.4 万字,摘要层,与原文严格分开 |
3 | 8 张能力卡 | 含触发条件、失效场景、失败信号 |
4 |
| 稳定 ID,供编译复用 |
5 | 盲测与回归 | 36 条输入,专测硬边界 |
6 | 编译产物 | 1 路由 + 3 skill |
7 | 两篇长文 | 一篇单书解读、一篇两书并置 |
8 | 网页版 | 独立发布,可转发 |
9 | 公众号草稿 | 正文与引用样式已存后台 |
真正能带走的是第 3 到第 5 项背后的契约设计,以及第 6 节那张自查表。书换一本,这些都不用重写。
八、我没做的事
说清楚边界,免得这套流程被误用:
- 不代点「发表」,不代做扫码登录——账号权限在本人手里;
- 不给版权结论背书,上面只是我这次的自查记录,不构成法律意见;
- 不搬运原文、不附原书文件,本文从头到尾没有引用任何一段书中文字;
- 不为凑数放宽硬边界,也不为了「显得温暖」在结尾补希望。
一天做完这些,最后停在「不勾原创」这个决定上,其实挺合适:能复用的是方法,该守的是边界,剩下的重在参与。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号