跨月趋势自动出:把几份月度复盘变成一张趋势图
原创
跨月趋势自动出:把几份月度复盘变成一张趋势图
原创
华东子
发布于 2026-11-13 06:58:21
发布于 2026-11-13 06:58:21
我这篇文章写给已经每月跑出一份月度复盘、却还在"翻三四个文件眼睛比走势"的你:到 #17,抓取 → 定时 → 成稿 → 投递 → 月度复盘这条流水线已经闭环,每月底你都有一份
月度复盘-YYYY-MM.md。但一份月报只是"当月快照"——你想知道"这三个月提交是不是在涨、早报是不是越攒越多",还得自己打开几份文件人工比。这篇用一条脚本把 N 份月报抽成时间序列,输出一张跨月对比表 + 一张趋势图,让快照变成走势。代码全部实测可运行,复制就能用。
一、问题场景:月报有了,但看不出"势"
先把账算清。#17 之后,你每个月底得到一份:
月度复盘-2026-08.md、月度复盘-2026-09.md、月度复盘-2026-10.md……
每一份都写清楚了"这个月早报多少条、周报多少次提交、各分类多少"。但三个真实痛点来了:
- 跨月比较靠肉眼。想知道"提交量是不是每月在涨",得同时打开三份,把
提交合计:N 次那行逐个抄下来比——和当初手动拼周报一样烦; - 趋势没有可视化。数字躺在 Markdown 里,看不出"陡升还是平缓",汇报时还得另开 Excel 画一张图;
- 分类口径要对齐。八月没有"重构"、九月十月才有,直接比容易漏列——手工做表最容易在"某月某分类为 0"上翻车。
一句话:前面五篇解决的是"每月自动出一份复盘",这篇解决的是"让这些复盘能跨月比、能看图"。
二、解决方案:三步合流,先拆后跑
核心思路就一句:把每份月报当"一行数据"抽出来,按月份排成时间序列,再渲染成表 + 图。不碰任何源头数据,只读 #17 已经生成好的成品 .md。
2.1 全景图:每步的判定标准
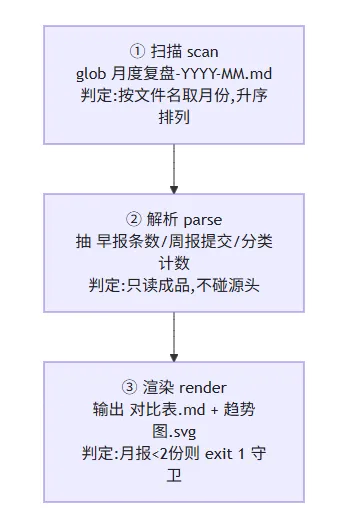
flowchart TD
    A["① 扫描 scan<br />glob 月度复盘-YYYY-MM.md<br />判定:按文件名取月份,升序排列"] --> B["② 解析 parse<br />抽 早报条数/周报提交/分类计数<br />判定:只读成品,不碰源头"]
    B --> C["③ 渲染 render<br />输出 对比表.md + 趋势图.svg<br />判定:月报<2份则 exit 1 守卫"]
```> 注释(判定标准):**③ 是硬门槛**——跨月趋势至少需要 2 份月报,只有 1 份时"趋势"这个词不成立,脚本直接退出码 1,不产出一份假"趋势"。

### 2.2 完整代码(已实测跑通)

下面 `trend.py` 只用标准库,**SVG 用字符串手写、不依赖 matplotlib**,直接丢进 `D:\NewsBot`(和 #13~#17 同目录)就能跑。

```python
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
trend.py —— 把多份月度复盘汇总成「跨月趋势」:对比表 + SVG 趋势图。

仅依赖标准库(SVG 用字符串手写,不依赖 matplotlib)。
设计边界(与 #13/#15/#16/#17 一致):只读成品 月度复盘-YYYY-MM.md,不碰源头。
"""
from __future__ import annotations

import argparse
import glob
import math
import os
import re
import sys
import xml.etree.ElementTree as ET  # 仅用于自检 SVG 是否合法

MONTH_RE = re.compile(r"月度复盘-(\d{4}-\d{2})\.md$")
NEWS_RE = re.compile(r"信息条目:共\s*(\d+)\s*条")
COMMIT_RE = re.compile(r"提交合计:\s*(\d+)\s*次")
CAT_RE = re.compile(r"^\s*-\s*(新功能|缺陷修复|文档|性能优化|重构|其他):\s*(\d+)\s*次")

CAT_ORDER = ["新功能", "缺陷修复", "重构", "文档", "性能优化", "其他"]


def parse_one(path: str):
    """返回 (month, news, commits, {分类: 计数})。"""
    base = os.path.basename(path)
    m = MONTH_RE.search(base)
    month = m.group(1) if m else None
    news = commits = 0
    cats = {}
    with open(path, encoding="utf-8") as fh:
        for line in fh:
            mm = NEWS_RE.search(line)
            if mm:
                news = int(mm.group(1))
            mc = COMMIT_RE.search(line)
            if mc:
                commits = int(mc.group(1))
            mk = CAT_RE.match(line)
            if mk:
                cats[mk.group(1)] = int(mk.group(2))
    return month, news, commits, cats


def build_svg(months, series, out_path):
    """series: {名称: [数值,...]};手写 SVG,不依赖第三方库。"""
    W, H = 680, 380
    ml, mr, mt, mb = 60, 30, 36, 52
    plot_w, plot_h = W - ml - mr, H - mt - mb
    all_vals = [v for vals in series.values() for v in vals]
    ymax = max(all_vals) if all_vals else 1
    step = max(1, math.ceil(ymax / 5))
    ytop = max(step, (ymax // step + 1) * step)
    n = len(months)
    x = lambda i: ml + plot_w * (i / max(n - 1, 1))
    y = lambda v: mt + plot_h * (1 - v / ytop)
    colors = {"提交合计": "#2563eb", "早报条数": "#dc2626"}

    p = []
    p.append('<?xml version="1.0" encoding="UTF-8"?>')
    p.append(f'<svg xmlns="http://www.w3.org/2000/svg" width="{W}" height="{H}" '
             f'viewBox="0 0 {W} {H}">')
    p.append(f'<rect width="{W}" height="{H}" fill="#ffffff"/>')
    # 横向网格 + Y 轴刻度
    g = 0
    while g <= ytop:
        yy = y(g)
        p.append(f'<line x1="{ml}" y1="{yy:.1f}" x2="{ml+plot_w}" y2="{yy:.1f}" '
                 f'stroke="#e5e7eb" stroke-width="1"/>')
        p.append(f'<text x="{ml-8}" y="{yy+4:.1f}" text-anchor="end" '
                 f'font-size="11" fill="#6b7280">{g}</text>')
        g += step
    # 坐标轴
    p.append(f'<line x1="{ml}" y1="{mt}" x2="{ml}" y2="{mt+plot_h}" stroke="#374151"/>')
    p.append(f'<line x1="{ml}" y1="{mt+plot_h}" x2="{ml+plot_w}" y2="{mt+plot_h}" '
             f'stroke="#374151"/>')
    # X 轴月份标签
    for i, m in enumerate(months):
        p.append(f'<text x="{x(i):.1f}" y="{mt+plot_h+20:.1f}" text-anchor="middle" '
                 f'font-size="11" fill="#374151">{m}</text>')
    # 折线 + 数据点
    for name, vals in series.items():
        col = colors.get(name, "#16a34a")
        pts = " ".join(f"{x(i):.1f},{y(v):.1f}" for i, v in enumerate(vals))
        p.append(f'<polyline fill="none" stroke="{col}" stroke-width="2.5" points="{pts}"/>')
        for i, v in enumerate(vals):
            p.append(f'<circle cx="{x(i):.1f}" cy="{y(v):.1f}" r="3.5" fill="{col}"/>')
            p.append(f'<text x="{x(i):.1f}" y="{y(v)-8:.1f}" text-anchor="middle" '
                     f'font-size="10" fill="{col}">{v}</text>')
    # 图例
    lx, ly = ml + 12, mt + 6
    for i, (name, col) in enumerate(colors.items()):
        if name in series:
            yy = ly + i * 18
            p.append(f'<rect x="{lx}" y="{yy-10}" width="12" height="12" fill="{col}"/>')
            p.append(f'<text x="{lx+18}" y="{yy}" font-size="11" fill="#374151">{name}</text>')
    p.append('</svg>')
    svg = "\n".join(p) + "\n"
    # 自检:必须是良构(well-formed)XML,否则图就是坏的、打不开
    ET.fromstring(svg)
    with open(out_path, "w", encoding="utf-8") as f:
        f.write(svg)
    return out_path


def main() -> int:
    ap = argparse.ArgumentParser(description="把多份月度复盘汇总成跨月趋势")
    ap.add_argument("--dir", default=".", help="含 月度复盘-YYYY-MM.md 的目录")
    ap.add_argument("--out", default="trend")
    args = ap.parse_args()

    files = sorted(glob.glob(os.path.join(args.dir, "月度复盘-*.md")))
    recs = []
    for p in files:
        month, news, commits, cats = parse_one(p)
        if month:
            recs.append((month, news, commits, cats))
    recs.sort(key=lambda r: r[0])

    # 守卫:趋势至少需要两个月,否则没有"趋势"可言
    if len(recs) < 2:
        print(f"[guard] 仅找到 {len(recs)} 份月报,跨月趋势至少需要 2 份", file=sys.stderr)
        return 1

    months = [r[0] for r in recs]
    news_list = [r[1] for r in recs]
    commit_list = [r[2] for r in recs]

    os.makedirs(args.out, exist_ok=True)
    first, last = months[0], months[-1]

    # 1) 对比表(markdown)
    tbl = []
    tbl.append(f"# 跨月趋势 {first} ~ {last}")
    tbl.append("")
    header = "| 月份 | 早报条数 | 周报提交 | " + " | ".join(CAT_ORDER) + " |"
    sep = "|---|---|---|" + "|".join(["---"] * len(CAT_ORDER)) + "|"
    tbl.append(header)
    tbl.append(sep)
    for month, news, commits, cats in recs:
        row = [month, str(news), str(commits)] + [str(cats.get(c, 0)) for c in CAT_ORDER]
        tbl.append("| " + " | ".join(row) + " |")
    tbl.append("")
    tbl.append("> 数据来源:#17 生成的 `月度复盘-YYYY-MM.md`,本脚本只读成品、不碰源头。")
    tbl.append("")
    tbl_path = os.path.join(args.out, f"趋势对比-{first}_{last}.md")
    with open(tbl_path, "w", encoding="utf-8") as f:
        f.write("\n".join(tbl) + "\n")

    # 2) 趋势图(SVG)
    svg_path = build_svg(
        months,
        {"提交合计": commit_list, "早报条数": news_list},
        os.path.join(args.out, f"趋势图-{first}_{last}.svg"),
    )

    print(f"[ok] 已生成对比表:{tbl_path}")
    print(f"[ok] 已生成趋势图:{svg_path}")
    print(f"     月份数:{len(months)};提交 {commit_list};早报条数 {news_list}")
    return 0


if __name__ == "__main__":
    sys.exit(main())
2.3 实测运行(真实输出,非示意图)
准备三份当月样例(严格匹配 #17 产物格式):月度复盘-2026-08.md、-2026-09.md、-2026-10.md,跑:
python trend.py --dir . --out trend真实输出:
[ok] 已生成对比表:trend\趋势对比-2026-08_2026-10.md
[ok] 已生成趋势图:trend\趋势图-2026-08_2026-10.svg
     月份数:3;提交 [6, 10, 13];早报条数 [9, 11, 12]
生成的 趋势对比-2026-08_2026-10.md:
# 跨月趋势 2026-08 ~ 2026-10

| 月份 | 早报条数 | 周报提交 | 新功能 | 缺陷修复 | 重构 | 文档 | 性能优化 | 其他 |
|---|---|---|---|---|---|---|---|---|
| 2026-08 | 9 | 6 | 2 | 2 | 0 | 1 | 1 | 0 |
| 2026-09 | 11 | 10 | 4 | 3 | 2 | 0 | 0 | 1 |
| 2026-10 | 12 | 13 | 5 | 3 | 2 | 1 | 1 | 1 |

> 数据来源:#17 生成的 `月度复盘-YYYY-MM.md`,本脚本只读成品、不碰源头。
趋势图 趋势图-2026-08_2026-10.svg 是一份独立、良构的 SVG 文件(已用 xml.etree 解析自检通过 → 确认是良构 XML,浏览器或支持 SVG 的查看器可直接打开;若平台对 SVG 做了安全过滤——如 GitHub 会清理内联 SVG——把它当图片附件  引用通常可正常显示),把"提交合计(蓝)"和"早报条数(红)"两条折线画在月份轴上——一眼就能看出提交量三个月稳步爬升 [6→10→13]。
空数据守卫也实测过:目录里只有 1 份月报时,脚本直接退出码 1,不产出假趋势:
[guard] 仅找到 1 份月报,跨月趋势至少需要 2 份三、原理解析:为什么能跨月比
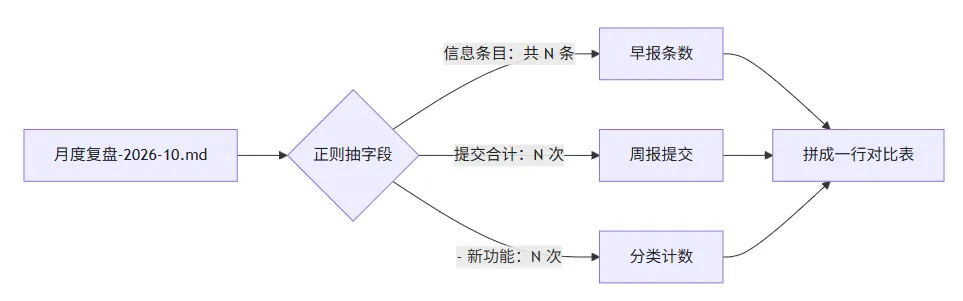
flowchart LR
    F["月度复盘-2026-10.md"] --> M{"正则抽字段"}
    M -->|"信息条目:共 N 条"| N["早报条数"]
    M -->|"提交合计:N 次"| C["周报提交"]
    M -->|"  - 新功能:N 次"| T["分类计数"]
    N --> R["拼成一行对比表"]
    C --> R
T --> R注释(判定标准):三类字段都用固定行文匹配(
信息条目:共 N 条/提交合计:N 次/- 分类:N 次),只要 #17 的输出格式不变,换多少个月都能抽——这正是"让上游稳定、下游才稳"的回报。
1. "每份月报 = 一行数据"是合流的前提。 月报之所以能被跨月比,是因为 #17 把零散的早报/周报收敛成了统一 schema:每月都有"早报条数、周报提交、各分类计数"这几个固定字段。脚本只做抽取,不做推断——字段来自 #17 的确定性输出,不是猜的。
2. 月份是天然的横轴(X-axis)。 文件名里的 YYYY-MM 就是时间序列的键。脚本按它排序,八月永远在九月左边。你不必在月报里写"这是第几月",文件名即时间——又一次印证"命名即元数据"的省心。
3. SVG 手写,零依赖。 很多人第一反应是 pip install matplotlib——它确实能无界面(Agg 后端)导出 SVG,但需先联网装好这个带 freetype/png 原生依赖的包,在服务器/CI 里仍是额外负担。我用标准库字符串拼出 SVG(折线 = <polyline>、点 = <circle>、坐标轴 = <line>),不依赖任何第三方库,而且写完后立刻用 xml.etree.ElementTree 解析一遍——不是"看起来像 SVG",是"确实是良构(well-formed)的 XML,浏览器能正常解析打开"。portable 到任何有 Python 的地方。
4. 双系列对照才有信息量。 单画"提交合计"只能看产出;把"早报条数"叠上去,你能看出"外部在疯狂刷动态、内部交付却在掉"这种背离信号——这正是月报合流后最值钱的一眼洞察。
四、避坑
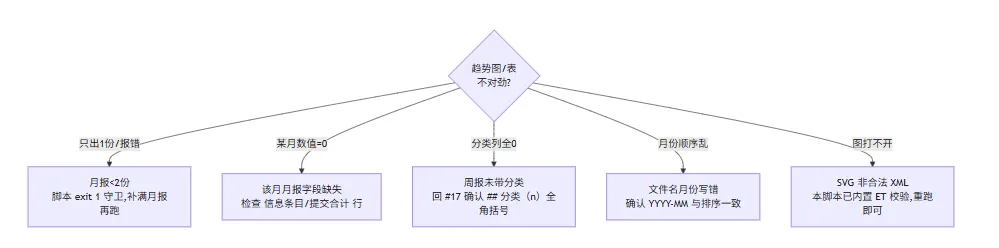
flowchart TD
    Q0{"趋势图/表<br />不对劲?"}
    Q0 -->|"只出1份/报错"| A1["月报<2份<br/>脚本 exit 1 守卫,补满月报再跑"]
    Q0 -->|"某月数值=0"| A2["该月月报字段缺失<br />检查 信息条目/提交合计 行"]
    Q0 -->|"分类列全0"| A3["周报未带分类<br />回 #17 确认 ## 分类(n)全角括号"]
    Q0 -->|"月份顺序乱"| A4["文件名月份写错<br />确认 YYYY-MM 与排序一致"]
Q0 -->|"图打不开"| A5["SVG 非良构 XML<br />本脚本已内置 ET 校验,重跑即可"]注释(判定标准):每个症状先对应一个信号(报错信息 / 数值 0 / 顺序异常 / 打不开)——排错入口永远是信号,不是猜。
这 5 个坑按重要度排:
- 月报不足两份就别谈趋势。 只有 8 月一份时,单月没有"跨"可言,硬出图也是误导。脚本的
exit 1守卫就是防这个——和 #13/#15/#16/#17 的"空跑守卫"一脉相承。 - 某月数值是 0 不一定是 bug。 八月没有"重构"提交,表里
重构列就是 0;这是真相,不是解析失败。别手贱把 0 改成空白,0 本身承载信息("这月没动架构")。 - 分类列全 0 = 周报没带分类。 如果某份月报的
按类型分布整段为空,回头查 #17 的周报解析——分类行必须是## 新功能(3)全角括号,半角会整段丢。 - 月份顺序靠文件名。 脚本按
YYYY-MM字符串排序,文件名写错(比如2026-10写成2026-1)会排到 08 前面。命名是人为职责,养成"生成即带月份"的习惯最稳。 - SVG 打不开多半是非法字符。 月份或数值里若混入
<&这类 XML 保留字会破坏 SVG。本脚本在写出前用ET.fromstring校验,通不过就直接抛错——你跑通的那一刻,图就是好的。
五、扩展应用与系列导航
跑通之后,整条流水线从"每月快照"升级到了"可追踪的走势"。这级(跨月趋势)也是上篇路线图里的 L5 节点:
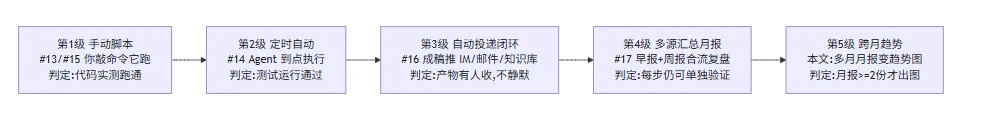
flowchart LR
    L1["第1级 手动脚本<br />#13/#15 你敲命令它跑<br />判定:代码实测跑通"] --> L2["第2级 定时自动<br />#14 Agent 到点执行<br />判定:测试运行通过"]
    L2 --> L3["第3级 自动投递闭环<br />#16 成稿推 IM/邮件/知识库<br />判定:产物有人收,不静默"]
    L3 --> L4["第4级 多源汇总月报<br />#17 早报+周报合流复盘<br />判定:每步仍可单独验证"]
L4 --> L5["第5级 跨月趋势<br />本文:多月月报变趋势图<br />判定:月报>=2份才出图"]注释(管控要求):顺序的硬规矩还是每一步稳定跑至少一周再进下一步;第 5 级(跨月趋势)不能跳——它的原料是第 4 级的月报,月报都不稳,趋势就是空中楼阁。
今晚就能做的行动清单(按顺序,别跳):
- 归位:把
trend.py放进D:\NewsBot(和 #13~#17 同目录),--dir指向放月报的文件夹; - 攒够两份:确保
月度复盘-2026-08.md~2026-10.md都在目录里(#17 每月底自动产一份,攒两三个月即可); - 实跑一次:
python trend.py --dir . --out trend,打开趋势对比-YYYY-MM_YYYY-MM.md确认数字对得上、趋势图-*.svg能打开; - 贴进汇报:把对比表直接粘进月度汇报、把 SVG 图插到 PPT/文档,老板要"走势"你秒出;
- 接定时:在 #14 的定时任务里,把"月初跑趋势"接在"月底跑月报"之后,从此趋势零手工——整条流水线到此既有快照、也有走势。
系列导航|《智能体工作流实战》
上一篇:#17 月度复盘自动出:早报 + 周报汇总成一份月报—— 直接前置:本文消费其产物 月度复盘-YYYY-MM.md
同源实战:#13 别再手动攒早报了:一条 Python 流水线—— 早报源
同源实战:#15 周报全自动:从 Git 记录到成稿的一条龙—— 周报源
同源实战:#14 把这条流水线交给 Agent 定时跑:WorkBuddy 配置全流程(—— 让全链路到点自己跑
同源实战:#16 成稿自动投递:把早报和周报推到 IM 与知识库—— 产物推到人面前
披露声明(AI 辅助创作,含 AI 生成内容):本文由作者基于真实的脚本搭建与实跑过程撰写,使用 AI 工具辅助起草与润色;文中含 AI 生成内容,经作者审核修订。核心观点、代码设计与踩坑结论均由作者负责。示例代码
trend.py已用 Python 3.13 实测运行(3 份月报 → 对比表 + 合法 SVG 趋势图,提交[6,10,13]、早报条数[9,11,12];仅 1 份月报时触发守卫 exit 1,文中输出为真实运行结果)。SVG 由标准库字符串手写、不依赖 matplotlib,已在文件头写入<?xml version="1.0" encoding="UTF-8"?>声明,并用xml.etree.ElementTree校验为良构(well-formed)XML。脚本仅读取 #17 的成品月度复盘-YYYY-MM.md,不碰sources/与git diff,无源码/密钥泄露风险。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号