轨迹回放链路设计:实时位置与历史查询如何协同
原创

车载终端上传一条位置数据后,平台可能既要更新实时监控,又要保存历史轨迹,还要识别相关事件。三个任务的数据来源相同,处理目标却不同。
实时位置关心当前状态,历史查询关心一个时间段内的记录,事件计算还需要结合前后数据。把它们全部放进同一个同步处理过程,容易让某一项任务的耗时影响其他任务。
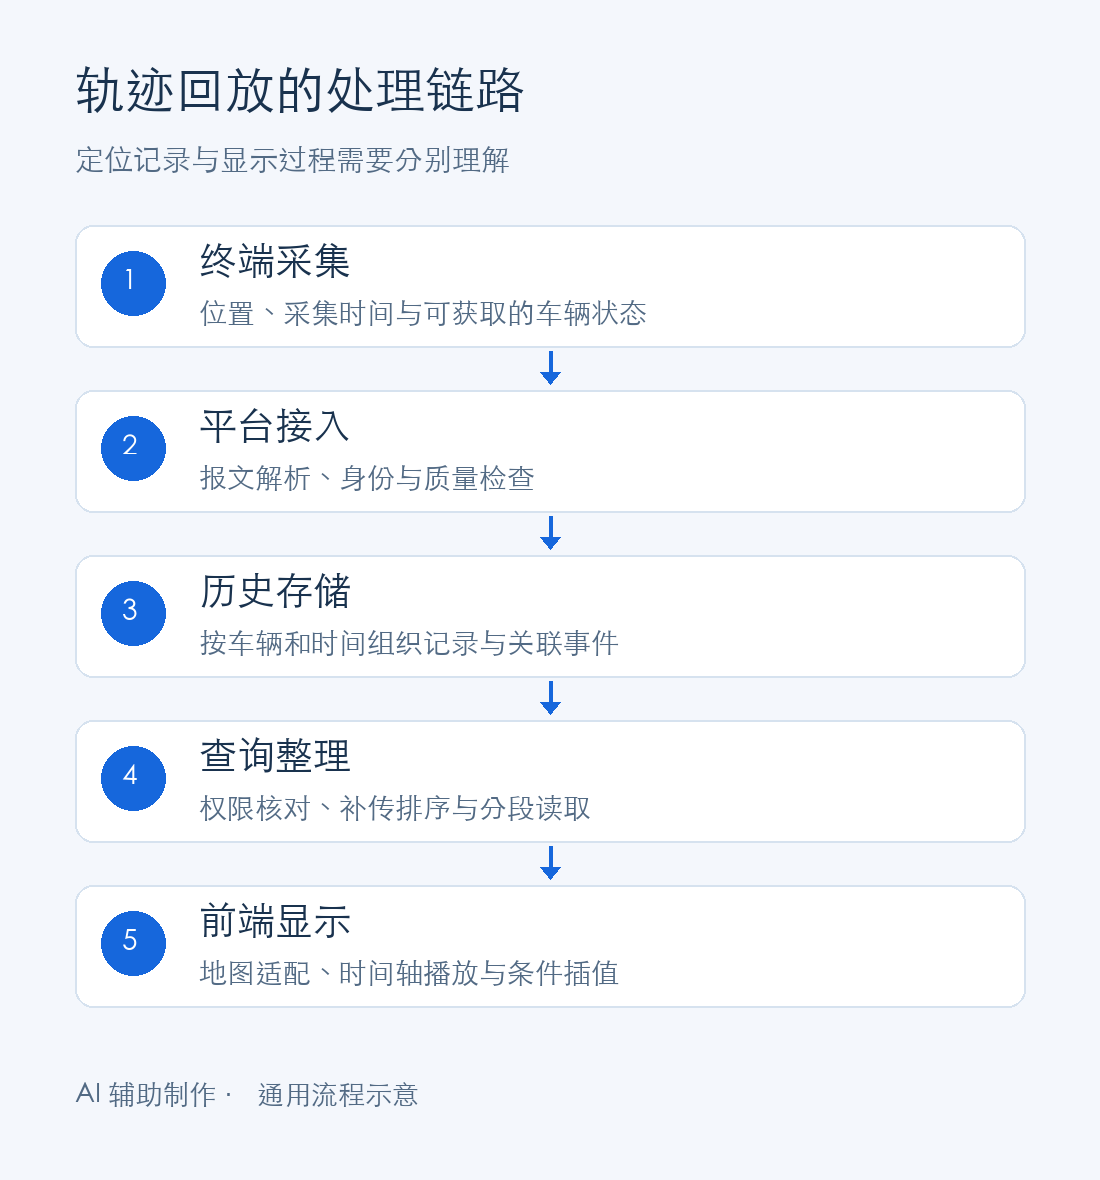
轨迹数据处理流程示意
定位数据从采集到回放的处理流程示意。
接入层先建立可追溯的数据入口
终端接入需要处理连接与身份、报文格式、协议解析和基础质量检查。校验码用于发现传输或格式问题,不能替代身份认证。
进入后续流程的位置记录,应包含能够追溯的设备信息、采集时间和接收时间。对于异常时间、无效定位和解析失败,分别记录处理状态,方便判断问题发生在哪一层。
这里讨论通用架构,不限定数据库、消息队列或部署平台。是否增加中间件,应由吞吐、延迟、可靠性需求和运维能力决定。
实时更新与历史写入采用不同判断
一条旧位置晚到后,通常仍有必要进入历史数据,但不能仅因它最后到达,就无条件覆盖当前车辆位置。
实时状态更新需要结合采集时间及质量策略判断;历史层则需要容纳补传、重复和乱序,并在查询时组织正确的时间顺序。状态新旧还要考虑设备时间异常,不能把未经校验的时间戳直接当作可信排序依据。
如果两个处理分支分别完成,页面短暂出现“实时已更新,历史还没查到”的情况,应能被监控和解释。这属于需要定义的可见性窗口,而不是靠界面刷新次数判断。
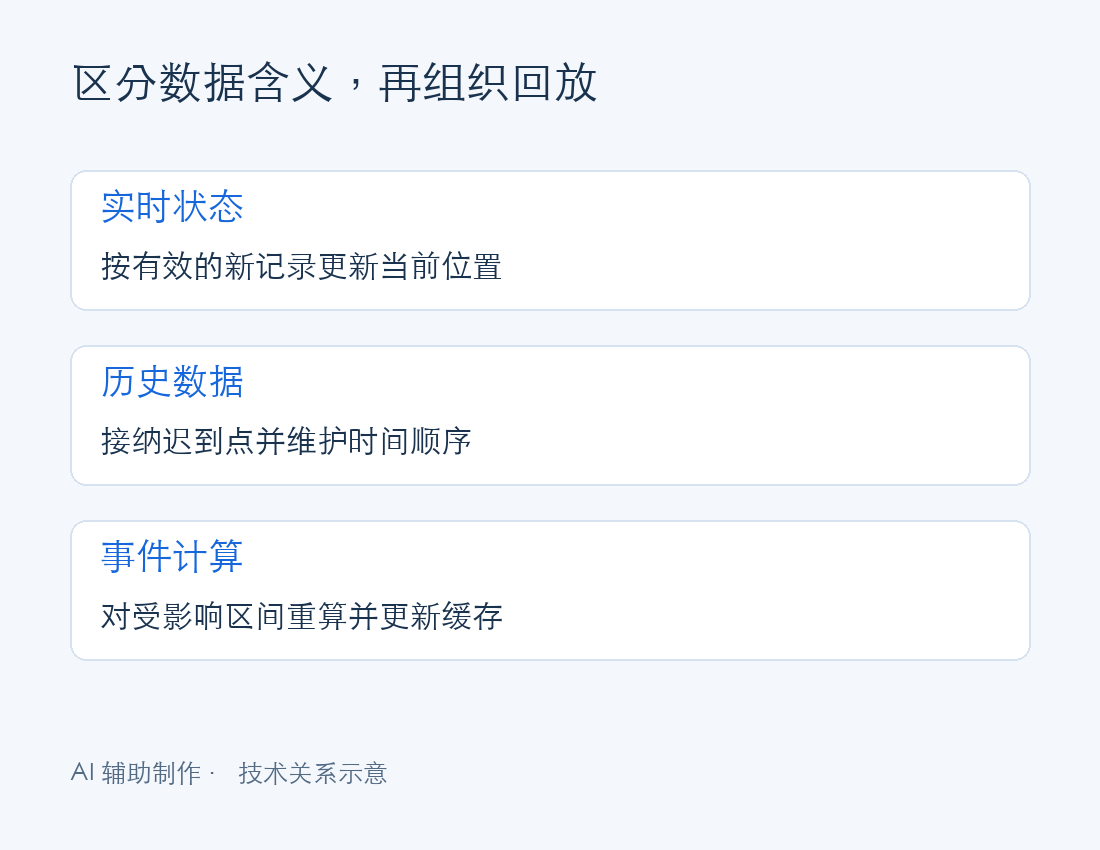
轨迹数据与处理关系示意
数据含义与处理关系示意。
使用消息队列,也要设计重复与失败处理
通过消息队列拆分任务,可以让历史写入、实时推送和事件计算分别消费。但队列不自动提供整个业务链路的“只处理一次”。
消费重试可能带来重复写入,数据库成功而确认消息失败也可能导致再次消费。因此,写入和派生任务都需要幂等策略,并明确消息顺序的作用范围。不同车辆之间不必强求全局排序,同一车辆的设备切换与迟到记录仍需按业务处理。
解析失败和暂时写入失败应分开对待。前者需要记录原因并检查协议适配,后者可以在受控重试后转入待处理队列,避免无限重试阻塞正常数据。
历史查询与事件结果保持关联
用户查询时,先限定车辆权限和时间范围,再读取历史点位及关联事件。补传数据可能改变停留边界或点间距离估算,相关缓存和统计需要有失效或重算机制。
抽稀只服务于绘线时,时间轴和事件应保持独立关联。长间隔缺点应分段表达,不能由前端连续动画掩盖数据缺失。
观察链路时,不只看接口耗时
可以分别关注报文解析失败、数据迟到、重复处理、队列积压、历史写入延迟和回放查询耗时。它们用于定位问题,不能在没有测试数据时换算成容量或性能承诺。
还应核对一条记录是否从入口走到了预期分支,以及补传后相关历史结果是否更新。业务正确性与运行性能需要一起观察。
这条链路的核心,是让实时状态、历史记录与事件计算使用清楚的数据语义,再根据任务特点拆分处理。组件增加多少,并不直接决定轨迹回放是否可靠。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号