论文精读 | 2024 [ICLR] TimeMixer: 可分解多尺度融合的时间序列预测

论文精读 | 2024 [ICLR] TimeMixer: 可分解多尺度融合的时间序列预测

时空探索之旅
发布于 2024-11-19 16:20:00
发布于 2024-11-19 16:20:00
论文标题:TimeMixer: Decomposable Multiscale Mixing for Time Series Forecasting
作者:Shiyu Wang(王世宇), Haixu Wu(吴海旭), Xiaoming Shi, Tengge Hu, Huakun Luo, Lintao Ma, James Y. Zhang, and Jun Zhou
机构:蚂蚁集团,清华大学
论文发表:[ICLR 2024]The Twelfth International Conference on Learning Representations
论文链接:https://openreview.net/forum?id=7oLshfEIC2
代码:https://github.com/kwuking/TimeMixer
TL; DR:TimeMixer是一种基于多尺度融合架构的时序预测模型,它通过解耦多尺度时间序列的过去信息和未来预测,实现了在长期和短期预测任务上的卓越性能和效率。
关键词:时序预测,多尺度融合,长时预测,解耦,MLP
点击文末阅读原文跳转本文openreview链接。
标题与作者
摘要
TimeMixer模型针对时间序列预测的复杂性提出了一个多尺度混合架构,旨在利用过去可分解混合(PDM)模块提取过去的关键信息,并通过未来多预测器混合(FMM)模块进行未来序列的预测。具体来说,TimeMixer首先通过平均下采样生成多尺度观测,然后PDM采用可分解设计更好地处理季节性和趋势变化的不同属性,通过在精细到粗略和粗略到精细方向上分别混合多尺度季节性和趋势组件。FMM在预测阶段集成多个预测器,利用多尺度观测中的互补预测能力。该模型在多个长期和短期预测任务中均实现了一致的最先进性能,并在所有实验中展现出卓越的效率。
主要工作和创新点
- 多尺度混合视角: 论文从一种新的多尺度混合视角来处理时间序列预测中的复杂时间变化,利用解耦变化和来自多尺度序列的互补预测能力。
- 简单但有效的预测模型: 论文提出了TimeMixer模型,它在历史信息提取和未来预测阶段都能结合多尺度信息,这得益于论文量身定制的可分解和多预测器混合技术。
- 在广泛基准上的一致最先进性能: TimeMixer在一系列广泛的基准测试中实现了长期和短期预测任务的一致最先进性能,并在所有实验中展现出卓越的效率 。
模型框架
- TimeMixer模型采用了一个多尺度混合架构,旨在解决时间序列预测中的复杂时间变化问题。该模型主要采用全MLP(多层感知机)架构,由过去可分解混合 (PDM) 和未来多预测器混合 (FMM) 两大块构成,能够有效利用多尺度序列信息。
- PDM负责提取过去的信息并将不同尺度上的季节性和趋势组分分别混合。
- FMM通过集成多个预测器(主要是)的方式来提高未来序列的预测准确性,每个预测器都基于不同尺度上的信息进行预测。
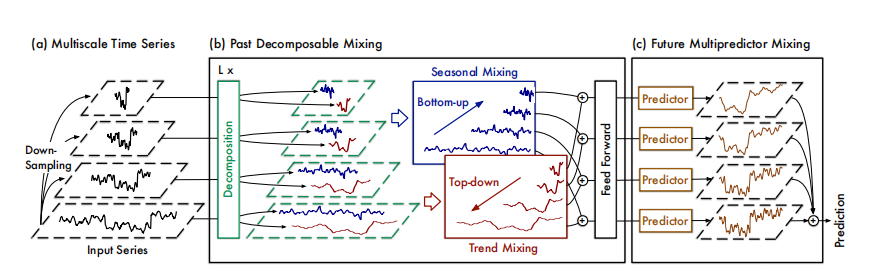
首先对过去的观察数据
进行下采样,通过平均池化最终得到多尺度时间序列的集合
,其中
,
,
表示变量的数量。最低级别的序列
是输入序列,包含最精细的时间变化,而最高级别的序列
代表宏观变化。然后将这些多尺度序列投射到嵌入层得到深层特征
,可以公式化为
。通过上述设计,得到了输入序列的多尺度表示。
接下来,利用堆叠的过去可分解混合(PDM)块来混合不同尺度的过去信息。对于第
层,输入是
并且 PDM 的过程可以公式化为:
其中
是总层数,并且
表示混合过去的表示,有
通道。至于未来预测阶段,采用未来多预测器混合(FMM)块来整合提取的多尺度过去信息
并生成未来预测,即:
其中
代表最终预测。通过上述设计,TimeMixer 能够成功捕捉到来自解开的多尺度观测的关键过去信息,并预测未来,从多尺度过去信息中获益。
PDM模块
通过过去分解混合(PDM)块,将分解的季节和趋势成分分别混合成多个尺度。
具体来说,对于第
个PDM块,首先将多尺度时间序列
分解为季节性部分
和趋势部分
,通过来自Autoformer(Wu et al., 2021)的序列分解块。考虑到季节趋势部分的独特属性,将混合操作应用于季节性和趋势性,以分别与来自多个尺度的信息进行交互。总的来说,第
个PDM块可以被形式化为:
其中
包含两个线性层,中间有GELU激活函数,用于通道之间的信息互动。
,
分别代表季节性和趋势混合。
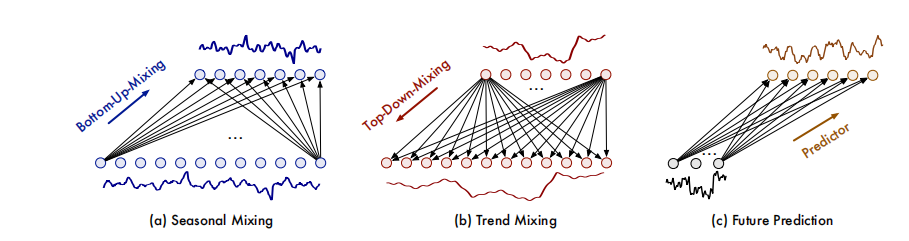
- 季节性混合:采用自下而上的方法,纳入低层次精细尺度时间序列的信息,可以为粗尺度的季节性建模补充详细信息。使用自底向上混合层在第 m 个尺度上以残差方式实现季节性信息的自底向上交互,可以被形式化为: 对于
做:
。 其中
被实例化为带有中间GELU激活函数的两个线性层,沿着时间维度,其输入维度是
,输出维度是
。
- 趋势混合:针对趋势部分与季节性部分相反,趋势项的详细变化可能会引入噪声,影响宏观趋势的捕获。请注意,较高层次的粗尺度时间序列能够更容易地提供清晰的宏观信息。因此,采用自上而下的混合方法,利用来自粗尺度的宏观知识来指导细尺度的趋势建模。 技术上,对于多尺度趋势组件
,我们采用自上而下的混合层在第
个尺度上以残差方式实现自上而下的趋势信息交互: 对于
做:
。(5) 其中
是两个带有中间GELU激活函数的线性层,其输入维度是
,输出维度是
,受到季节性和趋势混合的赋能,PDM逐渐聚合详细的季节性信息从细到粗,并将宏观趋势信息与以往的先验知识融合,最终实现在过去信息提取中的多尺度混合。
不同混合线性层
FMM模块
在L个PDM块之后获得了多尺度过去的信息,表示为
。由于不同尺度的序列呈现出不同的主导变化,它们的预测也表现出不同的能力。为了充分利用这些多尺度信息,论文提出了一个聚合多尺度序列预测并呈现未来多预测器混合块的方法:
其中
代表从第m尺度序列中的未来预测,最终输出是
。
指的是第m尺度序列的预测器,首先采用单层线性层直接对长度为F的未来进行回归,从长度为
的过去信息中提取,然后将深层表示投影到C个变量上。注意FMM是一个集合体,不同的预测器基于来自不同尺度的过去信息,使得FMM能够整合混合多尺度序列的补充预测能力。
实验
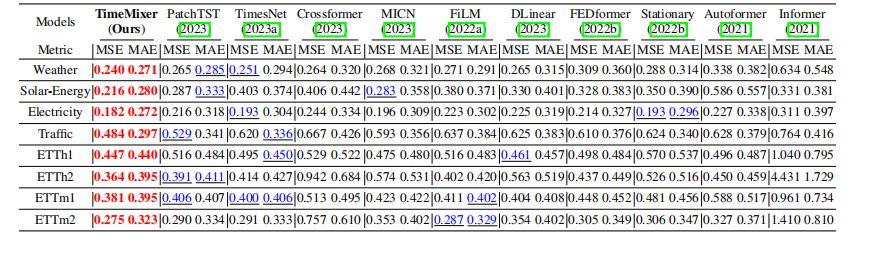
长期预测数据集
- ETT(Electricity Transformer Temperature)数据集:包含4个子集(ETTh1, ETTh2, ETTm1, ETTm2),主要信息为温度,以15分钟为频率记录,预测长度为96至720。
- Weather:气象数据集,记录了21个变量,包括10分钟频率的气象信息,预测长度为96至720。
- Solar-Energy:太阳能发电数据集,包含137个变量,记录了10分钟频率的电力信息,预测长度为96至720。
- Electricity:电力消耗数据集,包含321个变量,记录了小时频率的电力信息,预测长度为96至720。
- Traffic:交通流量数据集,包含862个变量,记录了小时频率的交通信息,预测长度为96至720。
短期预测数据集
- PEMS(公共环境监测站)数据集:包含PEMS03、PEMS04、PEMS07和PEMS08四个公共交通网络数据集,分别记录了358、307、883和170个变量,预测长度为12,记录频率为5分钟。
- M4数据集:包含不同频率的100000个时间序列,涵盖小时、日、周、月、季度和年度频率,主要用于短期预测。
实验结果
长期结果
长期结果
短期结果
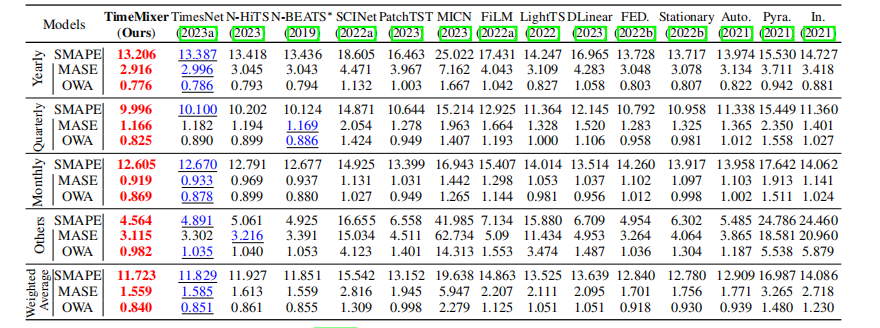
短期结果(M4)
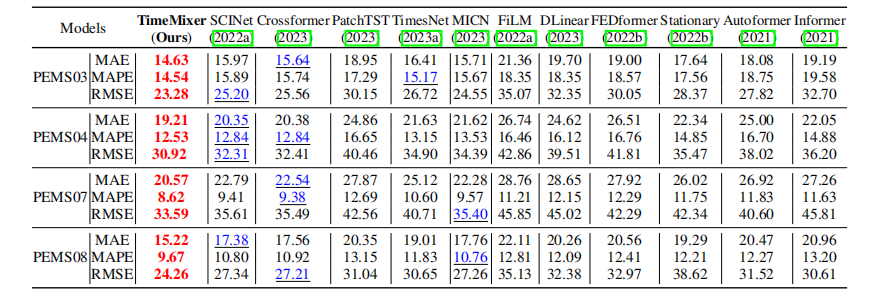
短期结果(PEMS)
权重和效率分析
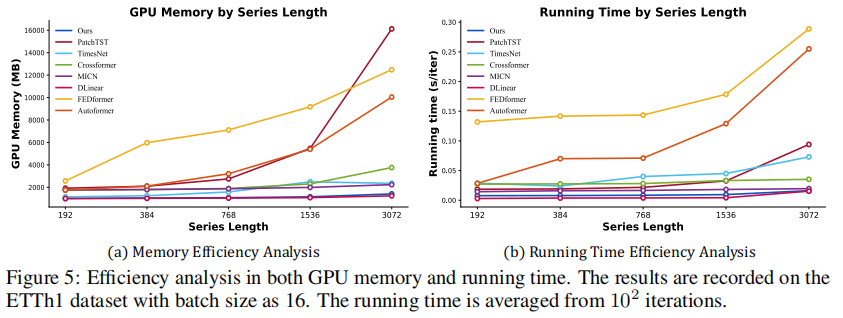
效率分析
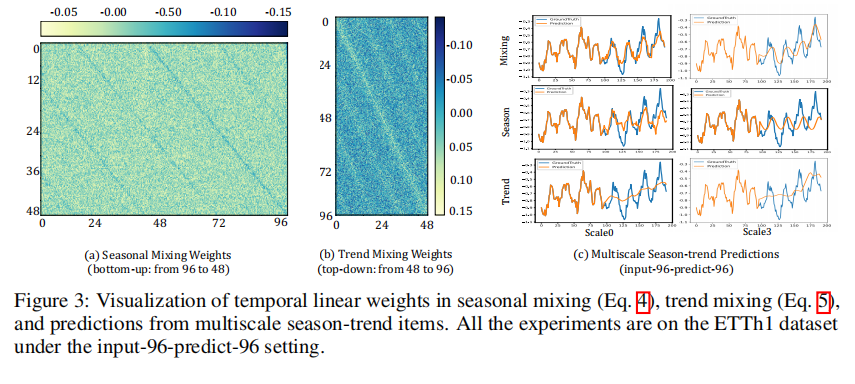
权重
不同尺度趋势可视化
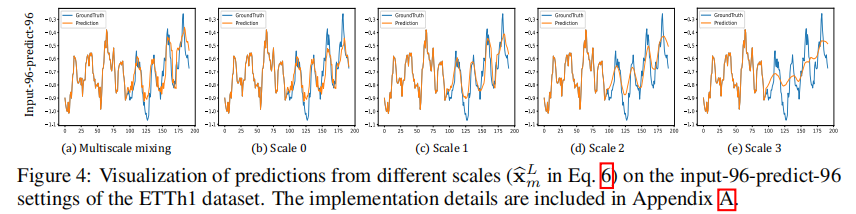
不同尺度趋势可视化
在本文的附录部分,提供了更为详尽的实验内容供读者参考。对于这些实验的深入分析和讨论,感兴趣的读者可以进一步查阅原文以获取完整的信息和细节。(点击文末阅读原文,即可跳转至论文原文链接)
结论
TimeMixer模型的主要贡献和特点可以总结如下:
- 多尺度混合架构:TimeMixer采用了创新的多尺度混合架构,有效处理时间序列数据在不同时间尺度上的变化。
- 解耦过去信息:通过Past-Decomposable-Mixing(PDM)模块,模型能够解耦时间序列的过去信息,提取季节性和趋势性特征。
- 互补预测能力:利用FutureMultipredictor-Mixing(FMM)模块,TimeMixer集成了多个预测器,以利用多尺度观测数据的互补性,提高预测精度。
- 高效的运行时间:得益于全MLP(多层感知机)基础架构,TimeMixer在运行时表现出了良好的效率,适合实时或近实时预测场景。
在一系列长期和短期的预测任务中,TimeMixer均取得了一致的先进性能,证明了其在时间序列预测领域的有效性。
如果觉得有帮助还请分享,在看,点赞
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2024-03-24,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号