AI论文速读 | CCM:从相似到超越:时间序列预测的通道聚类

AI论文速读 | CCM:从相似到超越:时间序列预测的通道聚类

时空探索之旅
发布于 2024-11-19 16:24:32
发布于 2024-11-19 16:24:32
题目:From Similarity to Superiority: Channel Clustering for Time Series Forecasting
作者:Jialin Chen ; Jan Eric Lenssen ; Aosong Feng ; Weihua Hu (胡緯華); Matthias Fey ; Leandros Tassiulas ; Jure Leskovec ; Rex Ying(应智韬)*
机构:耶鲁大学(Yale),Kumo.AI,德国马普所(信息研究所),斯坦福大学(Stanford)
网址:https://arxiv.org/abs/2404.01340
Cool Paper:https://papers.cool/arxiv/2404.01340
关键词:时间序列预测,通道聚类,内在相似性,跨通道依赖,零样本预测,可解释性
TL; DR: 本文提出了一个用于时间序列预测的通道聚类模块(CCM),通过基于通道相似性的动态聚类来解决现有通道独立(CI)和通道依赖(CD)策略的局限性。这种方法结合了CI和CD策略的优势,提高了预测性能和模型可解释性,并支持对未见数据的零样本预测。
作者简介(倒数第二个作者、通讯、四作): Jure是Stanford教授,应该是图神经网络第一人了(GraphSAGE,node2vec等等)。 (发现Jure把谷歌学术头像换了)
通讯Rex Ying(应智韬)是Yale的助理教授,Jure的博士,KDD 2022博士论文奖WINNER 奖
Rex Ying(应智韬)Weihua Hu (胡緯華)Kumo AI创始成员之一,Jure的博士,KDD 2023杰出博士论文奖
Weihua Hu (胡緯華)
摘要
近几十年来,时间序列预测引起了人们的广泛关注。先前的研究表明,通道独立(CI)策略通过单独处理不同的通道来提高预测性能,但它会导致对未见过的实例的泛化能力较差,并忽略通道之间潜在必要的交互。相反,通道依赖(CD)策略将所有通道与甚至不相关和不加区别的信息混合在一起,这会导致过平滑问题并限制预测准确性。因此目前缺乏有效平衡各个通道处理以提高预测性能而不忽视通道之间基本相互作用的通道策略。受到对时间序列模型针对通道混合的性能提升与一对通道的内在相似性之间的相关性观察的启发,开发了一种新颖且适应性强的通道聚类模块(CCM)。CCM 对具有内在相似性的通道进行动态分组,并利用聚类标识(cluster identity)而不是通道标识(channel identity),结合了 CD 和 CI 的优点。对真实世界数据集的大量实验表明,CCM 可以 (1) 将 CI 和 CD 模型的长期和短期预测性能平均分别提高 2.4% 和 7.2%;(2)利用主流时间序列预测模型实现零样本预测;(3)揭示通道之间内在的时间序列模式并提高复杂时间序列模型的可解释性。
Q: 这篇论文试图解决什么问题?
A: 这篇论文试图解决的问题是在时间序列预测中如何有效地管理通道(channels)之间的相互作用。具体来说,它探讨了两种主要的通道策略——通道独立(Channel-Independent, CI)策略和通道依赖(Channel-Dependent, CD)策略——的局限性,并提出了一种新的方法来平衡这两种策略。
CI策略通过独立对待每个通道来提高预测性能,但它在未见实例上的泛化能力较差,且可能忽略了通道之间潜在的相互作用。而CD策略将所有通道混合在一起处理,虽然能够捕捉复杂的通道关系,但容易导致过平滑问题,限制了预测准确性。
为了解决这些问题,论文提出了一个新颖的通道聚类模块(Channel Clustering Module, CCM),它基于通道之间的内在相似性动态地对通道进行分组,并利用聚类标识代替通道标识,结合了CD和CI策略的优点。CCM通过战略性地对通道进行聚类,同时学习表达性强的原型嵌入,使得模型能够在训练阶段对未见样本进行零样本预测。
论文的主要贡献包括:
- 提出了一种新颖的统一通道策略CCM,适用于大多数主流的时间序列模型。
- 通过从聚类中学习原型,CCM能够在单变量和多变量场景中对未见样本进行零样本预测。
- CCM在长期和短期预测性能上均展现出优越性,提高了预测的准确性和鲁棒性。
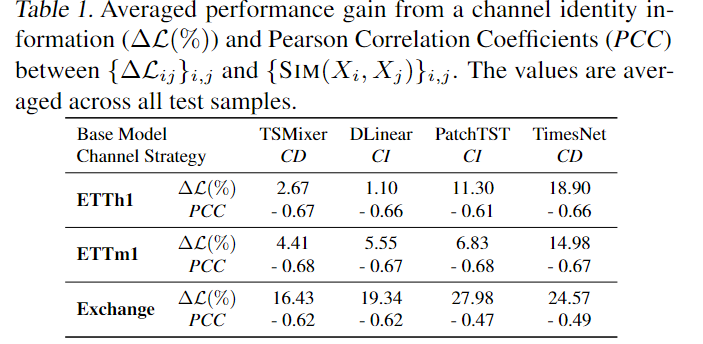
通道标识信息的平均性能增益和皮尔逊相关系数(PCC)
Q: 有哪些相关研究?
A: 这篇论文中提到的相关研究主要集中在时间序列预测模型和通道策略方面。具体来说,包括以下几个方面:
- 时间序列预测模型:
- 传统机器学习方法,如Prophet (Taylor & Letham, 2018; Triebe et al., 2021) 和 ARIMA (Zhang, 2003),这些方法主要捕获时间序列中的趋势和季节性成分。
- 深度学习方法,包括卷积神经网络(CNNs)(Wu et al., 2022; Liu et al., 2022a; Bai et al., 2018; Wan et al., 2019; Sen et al., 2019),递归神经网络(RNNs)(Hewamalage et al., 2021; Rangapuram et al., 2018; Smyl, 2020; Salinas et al., 2020; Bai et al., 2018),以及基于Transformer的模型(Zhou et al., 2021; Liu et al., 2022b; Wu et al., 2021; Nie et al., 2022; Zhang & Yan, 2022; Liu et al., 2023b; Wen et al., 2022; Tang & Matteson, 2021; Zhou et al., 2022b; Liu et al., 2021; Feng et al., 2024),这些模型能够处理更复杂和高效的时间序列数据。
- 线性模型,如DLinear (Zeng et al., 2022) 和 TSMixer (Chen et al., 2023),它们在长期时间序列预测中简单有效,但在处理非线性和复杂模式时可能性能不足。
- 通道策略在时间序列预测中:
- 大多数深度学习模型采用CD策略,旨在利用跨通道的全谱信息。
- CI策略则是为每个通道独立建立预测模型,这种方法在某些情况下可能具有高性能和低鲁棒性。
- 先前的研究还探索了通过有效聚类通道来提高预测能力的应用,例如在图像分类、自然语言处理和异常检测等领域。
- 其他相关工作:
- 趋势-季节性分解(Zeng et al., 2022; Cleveland et al., 1990; Wen et al., 2020)和多周期性分析(Benaouda et al., 2006; Percival & Walden, 2000; Wu et al., 2022; Wang et al., 2022; Zhang et al., 2024; Yi et al., 2023; Zhou et al., 2022a)在高级模型的预处理阶段继续发挥重要作用。
这些相关研究为论文提出的CCM提供了理论和技术背景,并且论文中提出的CCM在多个基准数据集上的实验验证了其在时间序列预测中的有效性和优越性。
Q: 论文如何解决这个问题?
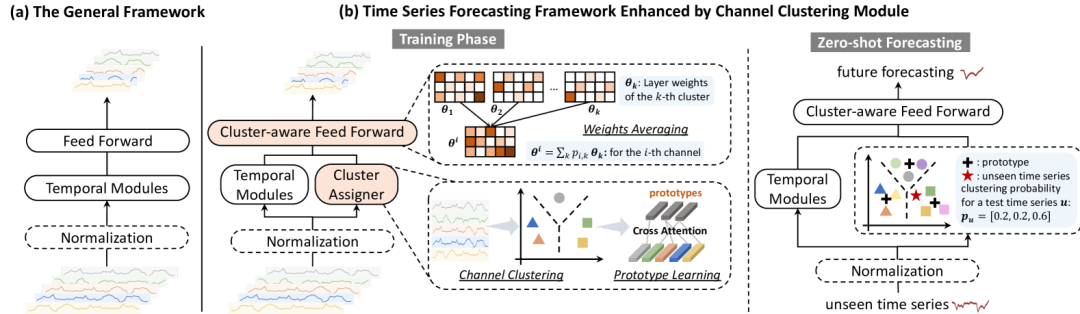
CCM
(a):大多数时序模型的通用框架 (b):CCM 应用于基本模型时修改的两个核心模块: 聚类分配器(cluster assigner)和聚类感知前馈(cluster-aware Feed Forward)
A: 论文提出了一个名为Channel Clustering Module(CCM)的新方法来解决时间序列预测中的通道管理问题。CCM的核心思想是基于通道之间的内在相似性对通道进行动态聚类,以此来平衡个体通道处理和跨通道依赖性建模。以下是CCM解决这个问题的具体步骤:
- 通道聚类:CCM首先初始化一组聚类嵌入(cluster embeddings),然后通过多层感知机(MLP)将每个通道的输入时间序列转换为嵌入向量。接着,计算每个通道嵌入与其所属聚类嵌入之间的相似度,并通过归一化内积来确定每个通道与各个聚类的关联概率。
- 原型学习:在训练阶段,CCM使用一种修改过的交叉注意力机制来创建每个聚类的原型嵌入。这些原型嵌入作为预训练知识,可以帮助模型在未见样本上进行零样本预测。
- 聚类损失:为了提高聚类质量,CCM引入了一个特定的聚类损失函数(ClusterLoss),该损失函数结合了自监督学习中的通道与聚类对齐和不同聚类之间的区分度。
- 聚类感知前馈:CCM为每个聚类分配一个单独的前馈网络,以捕捉聚类内部的共享时间序列模式。这取代了传统CI和CD策略中的个体通道处理或全局通道混合。
- 零样本预测:利用训练阶段学到的原型嵌入,CCM可以在未见样本上进行零样本预测,这使得模型能够适应新的通道或领域,而无需额外的训练数据。
- 复杂性分析:论文还对CCM的计算复杂性进行了分析,证明了CCM在提高预测性能的同时,对模型复杂度的影响是可控的。
通过上述方法,CCM能够有效地提高时间序列预测的性能,同时增强模型对未见数据的泛化能力。论文通过在多个真实世界数据集上的广泛实验验证了CCM的有效性。
Q: 论文做了哪些实验?
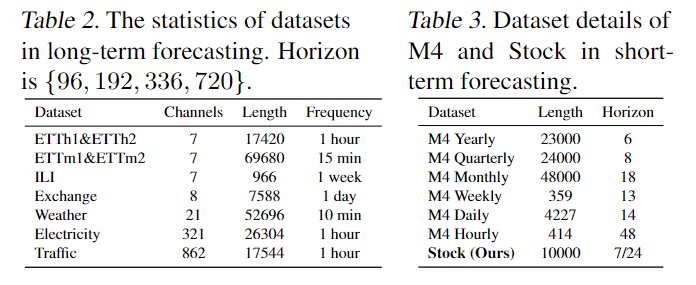
数据集
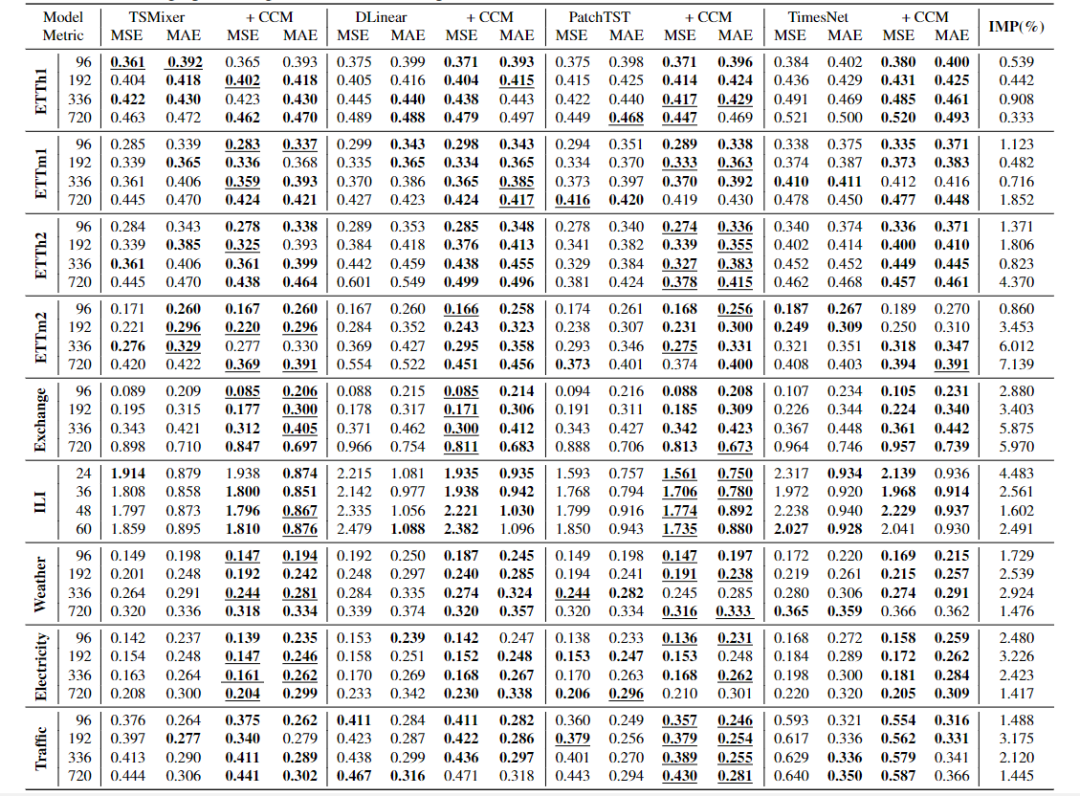
长时预测
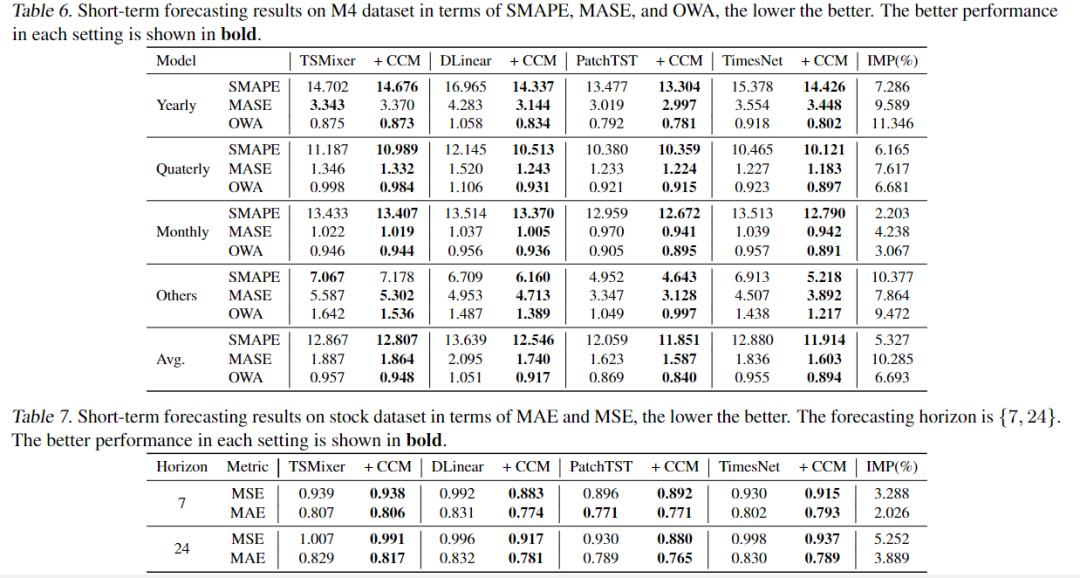
短时预测
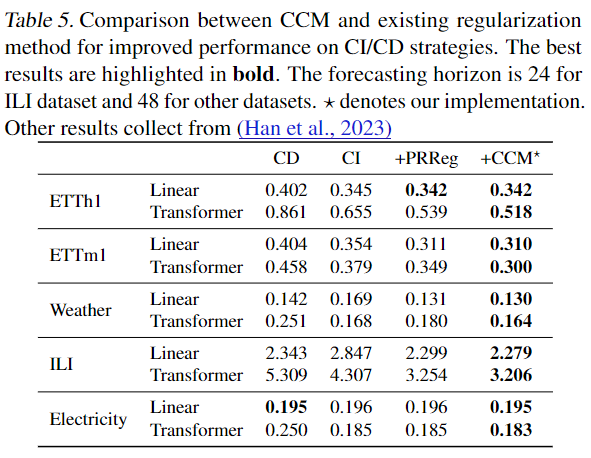
CCM与其他正则方法在CD/CI策略上的比较
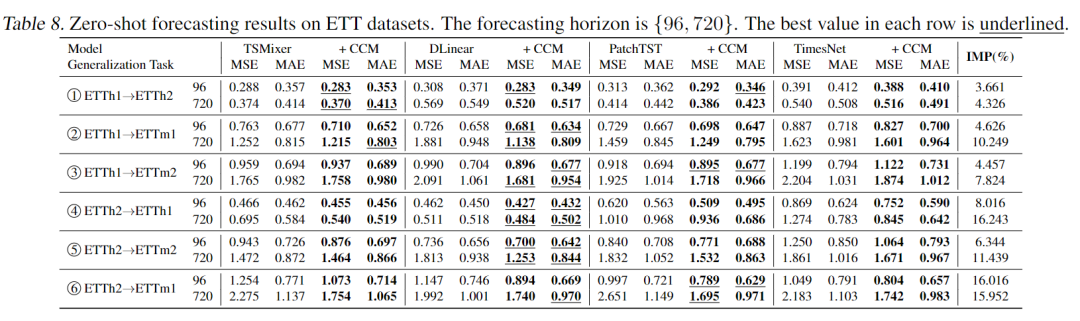
零样本预测
A: 论文中进行了一系列实验来验证Channel Clustering Module (CCM)的有效性和优越性。以下是实验的主要内容:
- 长期预测性能评估:
- 在9个公共多变量时间序列数据集上进行长期预测,这些数据集涵盖了天气、交通和电力等多个领域。
- 使用均方误差(MSE)和平均绝对误差(MAE)作为评估指标。
- 将CCM应用于四种不同的时间序列 backbones(基础模型),包括TSMixer、DLinear、PatchTST和TimesNet。
- 短期预测性能评估:
- 在M4数据集上进行短期预测,该数据集包含不同领域的单变量时间序列。
- 使用对称平均绝对百分比误差(SMAPE)、平均绝对缩放误差(MASE)和整体加权平均(OWA)作为评估指标。
- 股票价格预测:
- 构建一个新的股票单变量时间序列数据集,包含1390只股票的价格历史数据,覆盖10年的时间跨度。
- 在股票数据集上进行短期预测,设置预测范围为7天和24天。
- 使用MAE和MSE作为评估指标。
- 零样本预测性能评估:
- 在ETT数据集上进行零样本预测实验,测试模型在不同领域和不同粒度(采样频率)的泛化能力。
- 使用MSE和MAE作为评估指标。
- 定性可视化:
- 通过t-SNE可视化展示通道和原型嵌入之间的关系。
- 展示聚类感知前馈网络的权重可视化,以揭示模型学习到的特征。
- 消融研究:
- 分析不同聚类比例对模型性能的影响。
- 探讨不同历史窗口长度对短期预测性能的影响。
- 复杂性分析:
- 对CCM的计算复杂性进行分析,评估其在不同模型上的效率。
这些实验不仅证明了CCM在提高预测性能方面的有效性,还展示了其在处理未见数据和不同领域数据时的泛化能力和适应性。通过与现有方法的比较,论文进一步强调了CCM的优势和应用潜力。
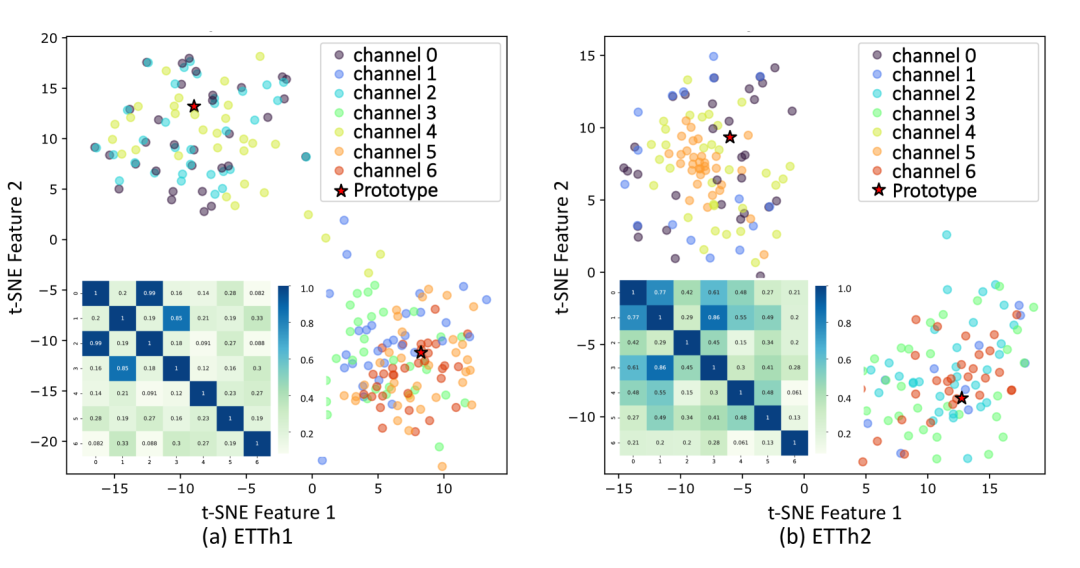
DLinear+CCM的t-SNE可视化
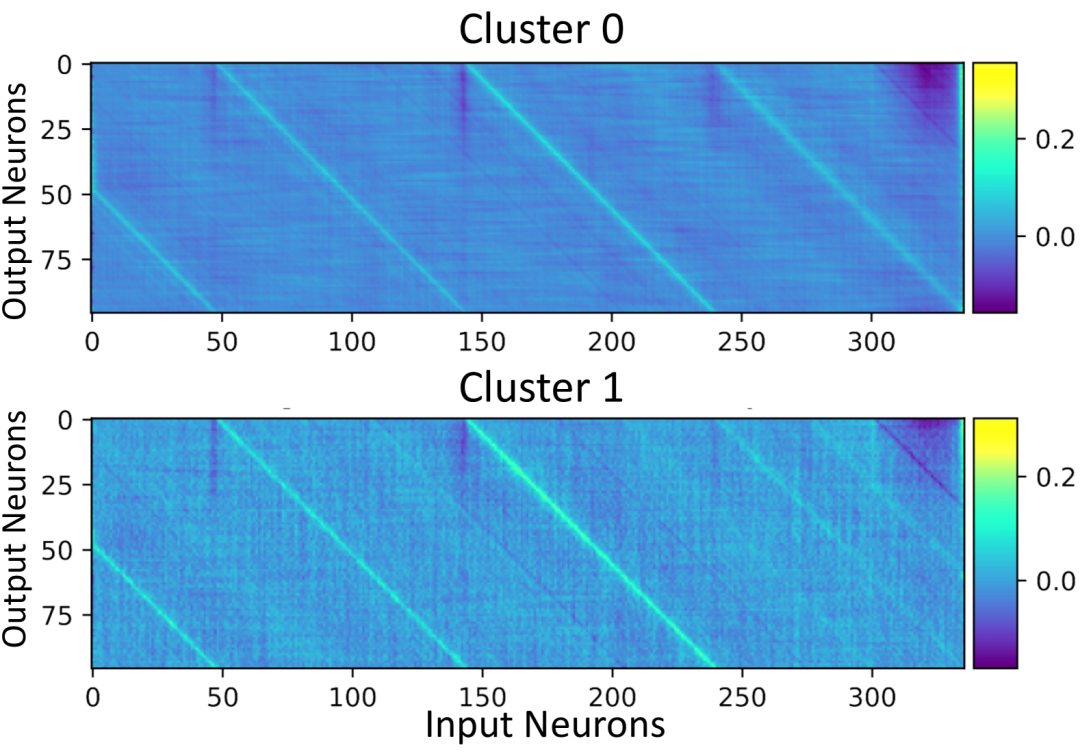
ETTm1聚类线性层的权重可视化
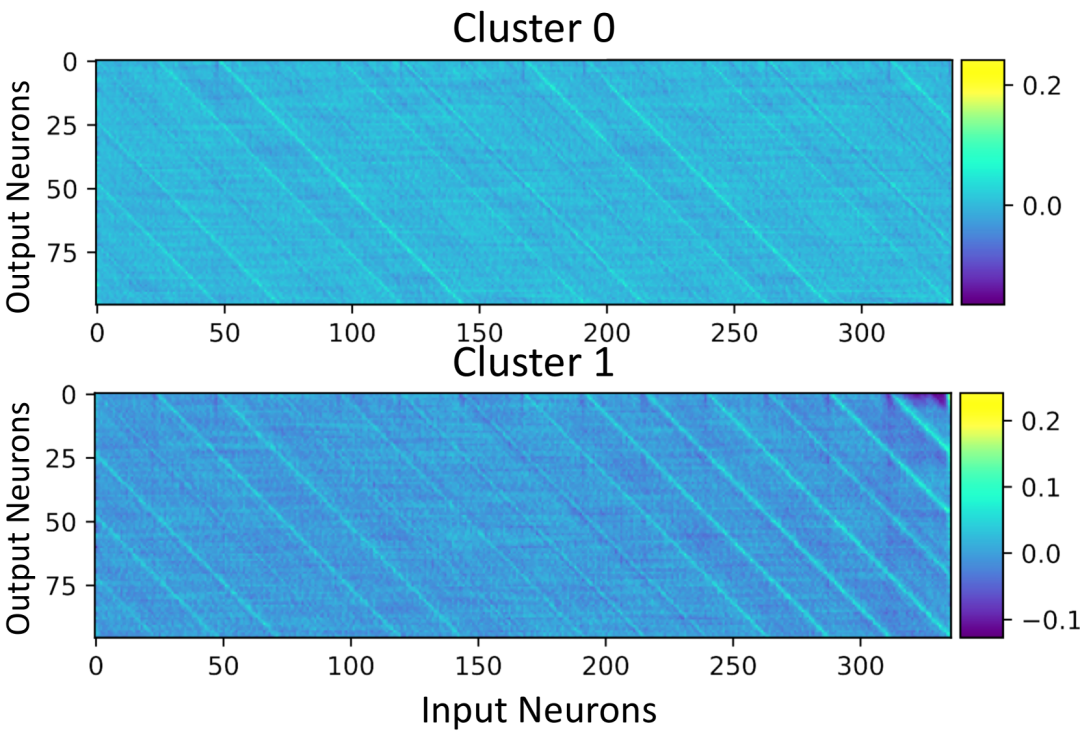
ETTh1聚类线性层的权重可视化
不同聚类的簇有着不同的周期性
Q: 总结一下论文的主要内容
A: 这篇论文的主要内容可以总结如下:
- 问题定义:论文针对时间序列预测中的通道管理问题,提出了一种新的通道聚类模块(CCM),以改善预测性能并克服现有通道独立(CI)和通道依赖(CD)策略的局限性。
- 方法提出:CCM通过基于通道间内在相似性的动态聚类,以及利用聚类标识代替通道标识,结合了CI和CD策略的优点。CCM包括原型学习、聚类感知的前馈网络和聚类损失函数,以提高模型的预测能力和泛化性。
- 实验验证:论文在多个真实世界数据集上进行了广泛的实验,包括长期和短期预测任务,以及股票价格预测。实验结果显示CCM在各种评估指标上均取得了显著的性能提升。
- 零样本预测:CCM能够利用训练阶段学到的原型嵌入,对未见样本进行零样本预测,这表明了其在新场景和新通道上的适应性。
- 消融研究:通过消融研究,论文探讨了不同聚类比例和历史窗口长度对模型性能的影响,提供了对CCM设计选择的深入理解。
- 可视化分析:论文通过可视化展示了CCM的通道聚类结果和模型学习的表示,增加了模型的可解释性。
- 未来方向:论文讨论了CCM的局限性和未来的研究方向,包括将其应用于新领域、优化实时预测效率、动态聚类机制、多任务学习等。
总体而言,这篇论文提出了一个创新的方法来改进时间序列预测模型的通道管理,并通过一系列实验验证了其有效性。
如果觉得有帮助还请分享,在看,点赞
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2024-04-12,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号