不想用代码做单细胞转录组降维聚类分群,试试看网页工具呢?


单细胞转录组数据挖掘有两个很明显的策略:在任意生物学背景下挑选一个单细胞转录组数据集然后降维聚类分群后选择任意一个亚群的特异性高表达量基因作为课题开始,或者课题结束后定位到了少量感兴趣基因后去任意单细胞转录组数据集的降维聚类分群结果里面进行可视化。
如果大家选择了策略一,就需要在自己的生物学背景下挑选一个合适的数据集,然后对这个单细胞转录组进行降维聚类分群后挑选任意一个亚群的特异性高表达量基因作为课题开始。比如2024的这个文章:《A Novel Tumor-Associated Neutrophil-Related Risk Signature Based on Single-Cell and Bulk RNA-Sequencing Analyses Predicts the Prognosis and Immune Landscape of Breast Cancer》,就是挑选了GSE114725这个乳腺癌的单细胞转录组数据集 ,做了降维聚类分群,然后定位到了Tumor-associated neutrophils (TANs) ,然后选择了它的 482 differentially expressed genes as marker genes of TANs.
但是,如果大家仔细看文章,就会发现这个单细胞数据挖掘作者其实并没有自己使用代码做单细胞转录组降维聚类分群,而是使用了单细胞-网页工具,就是 IMMUcan—肿瘤微环境单细胞数据库。可以很简单的无代码的单细胞转录组数据分析:
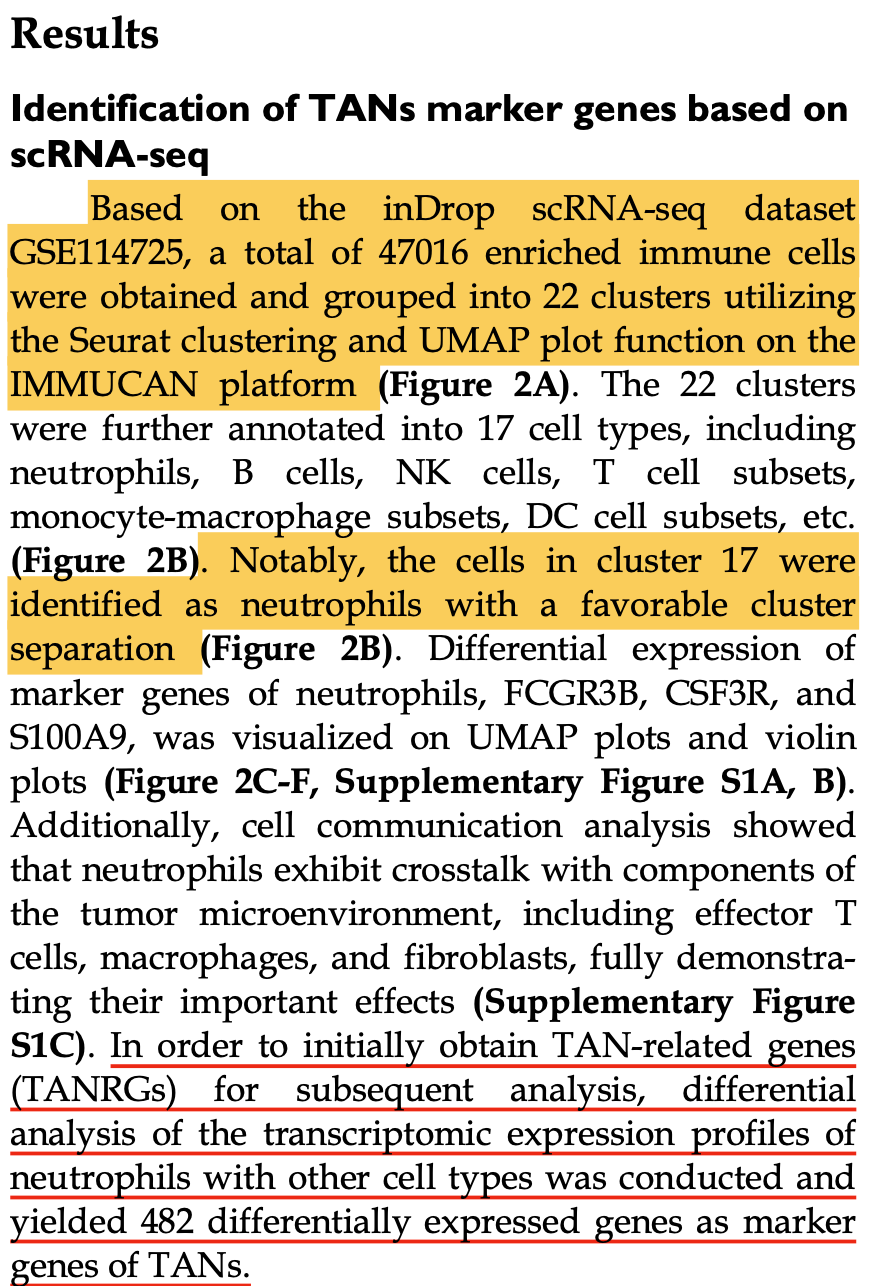
单细胞-网页工具-无代码的单细胞转录组数据分析
出图也没有什么问题,可以看到,中性粒细胞确实是一个很小的一个亚群,而且有很明显的 特征基因 ;
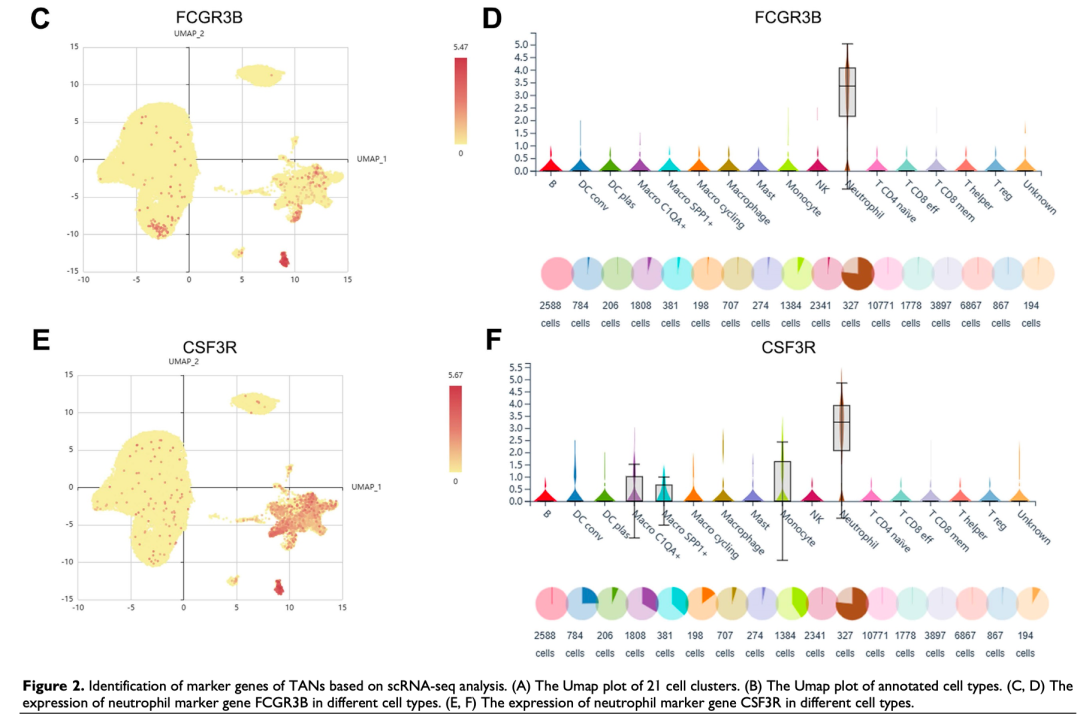
中性粒细胞是很小的一群
如果是使用代码,比如基于r语言的Seurat流程,需要首先读取GEO页面作者给出来了的表达量矩阵文件(GSE114725_rna_raw.csv.gz ):
ct=data.table::fread('inputs/GSE114725_rna_raw.csv.gz',
                     data.table = F)
ct[1:4,1:8]
meta=ct[,1:5]
ct=t(ct[,6:ncol(ct)])
colnames(ct) = meta$cellid
rownames(meta) = meta$cellid

  sce.all=CreateSeuratObject(counts =  ct ,
                             meta.data =  meta)
  as.data.frame(sce.all@assays$RNA$counts[1:10, 1:2])
  head(sce.all@meta.data, 10)
  table(sce.all$orig.ident)

  gplots::balloonplot(
    table(sce.all$patient,sce.all$tissue)
  )
  p=paste(sce.all$tissue,sce.all$patient)
  table(p)
  sce.all$orig.ident=p
代码层面的降维聚类分群也是很简单的,如下所示能看到 4,7,8,10都是髓系,但是4和8很明显是巨噬细胞而7是单核细胞,如何辅助中性粒细胞的基因就可以看到10亚群就是,参考免疫细胞里面的髓系和B细胞细分亚群:
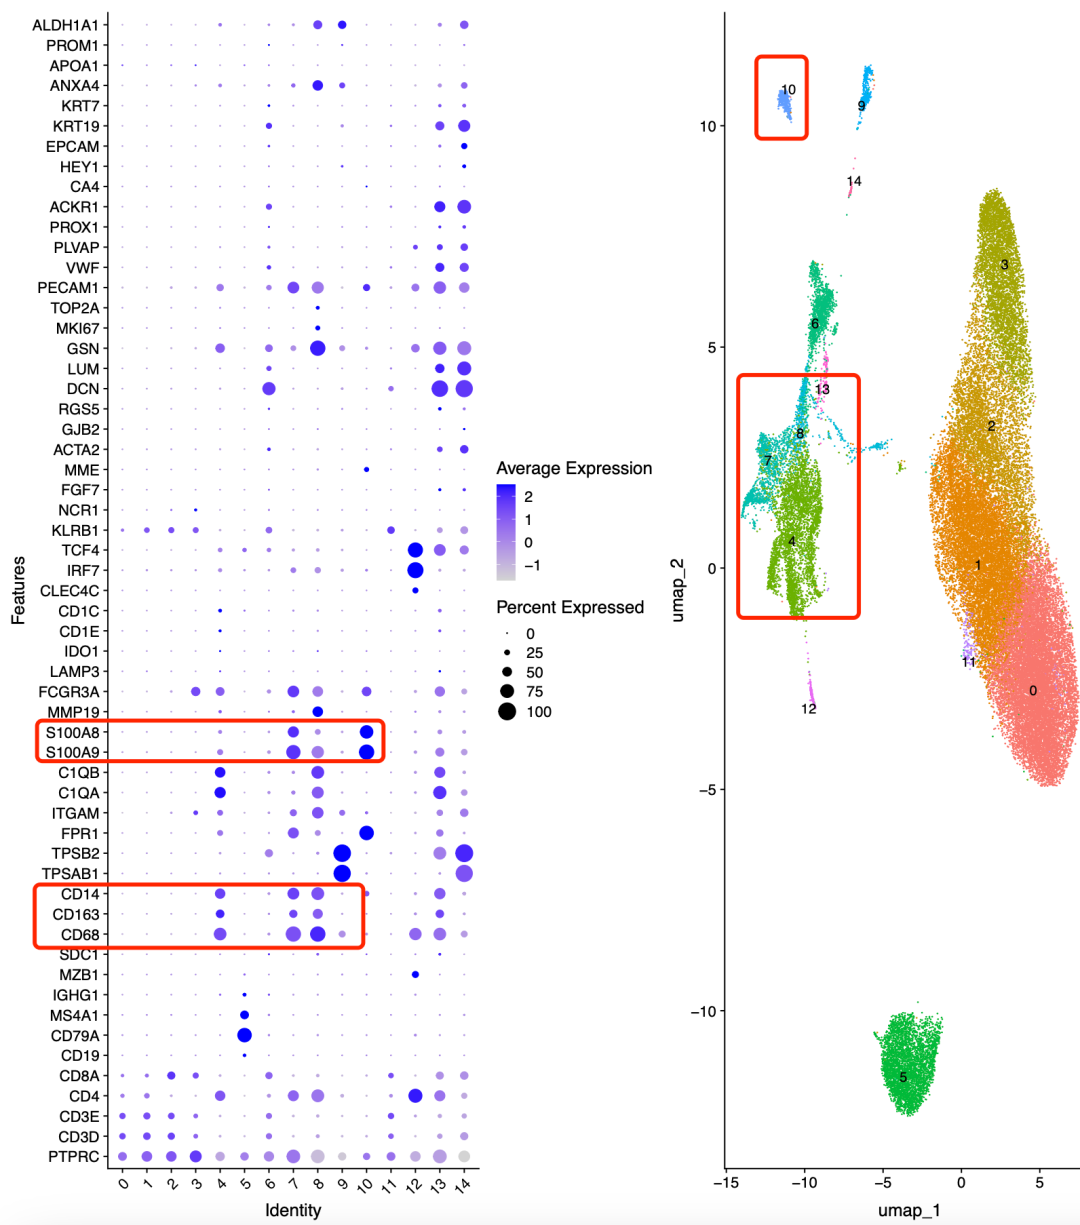
我把这些髓系单细胞亚群的基因也提取出来了,做成为了代码给大家:
th=theme(axis.text.x = element_text(angle = 45,
                                    vjust = 0.5, hjust=0.5))
myeloids = list(
  Mac=c("C1QA","C1QB","C1QC","SELENOP","RNASE1","DAB2","LGMN","PLTP","MAF","SLCO2B1"),
  mono=c("VCAN","FCN1","CD300E","S100A12","EREG","APOBEC3A","STXBP2","ASGR1","CCR2","NRG1"),
  neutrophils =  c("FCGR3B","CXCR2","SLC25A37","G0S2","CXCR1","ADGRG3","PROK2","STEAP4","CMTM2" ),
  pDC = c("GZMB","SCT","CLIC3","LRRC26","LILRA4","PACSIN1","CLEC4C","MAP1A","PTCRA","C12orf75"),
  DC1 = c("CLEC9A","XCR1","CLNK","CADM1","ENPP1","SNX22","NCALD","DBN1","HLA-DOB","PPY"),
  DC2=c( "CD1C","FCER1A","CD1E","AL138899.1","CD2","GPAT3","CCND2","ENHO","PKIB","CD1B"),
  DC3 =  c("HMSD","ANKRD33B","LAD1","CCR7","LAMP3","CCL19","CCL22","INSM1","TNNT2","TUBB2B")
)
p <- DotPlot(sce.all, features = myeloids,
             assay='RNA' ,group.by = 'celltype' )  +th

p
ggsave(plot=p, filename="check_myeloids_marker_by_celltype.pdf")
蛮方便的,大家可以复制粘贴我的代码去自己的单细胞项目里面的髓系免疫细胞里面赶快看看哦。
网页工具并不是万能的
首先,这个网页工具是对所有人公开访问,所以理论上你能拿到的图表和基因别人就能拿到一模一样的,这样的话一模一样的图表出现在两个不同的文章里面就很难说算不算学术不端了。而且,网页工具肯定是不支持大家自定义组合多个数据集,比如新鲜出炉的《Integrated analysis of single- cell RNA sequencing and bulk transcriptome data identifies a pyroptosis-associated diagnostic model for Parkinson’s disease》,就是3个帕金森综合征的单细胞数据集的整合,如下所示 :
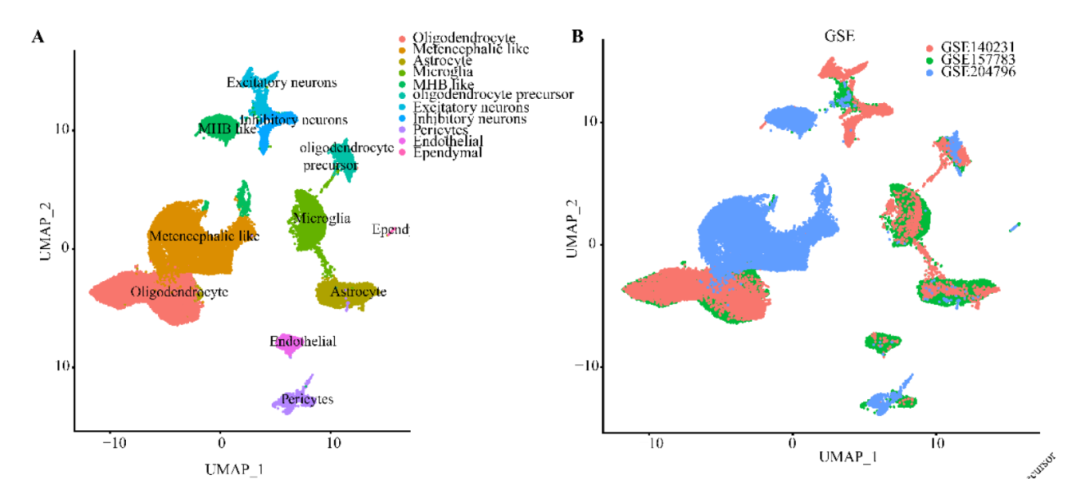
3个帕金森综合征的单细胞数据集的整合
就算是有一个神经退行性疾病的单细胞数据集网页工具,它大概率也是对每个数据集提供独立的查询接口,如果你需要分析3个数据集:
- 12 healthy samples in GSE140231,
- 6 healthy and 5 disease samples in GSE157783,
- 9 healthy samples in GSE204796.
就只能说是自己写代码了。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2024-11-22,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号