[深度学习][python]yolov13+bytetrack+pyqt5实现目标追踪

[深度学习][python]yolov13+bytetrack+pyqt5实现目标追踪
git clone firc-dataset
发布于 2025-07-15 19:08:32
发布于 2025-07-15 19:08:32
【算法介绍】
论文提出了YOLOv13模型,其核心包含三大创新:
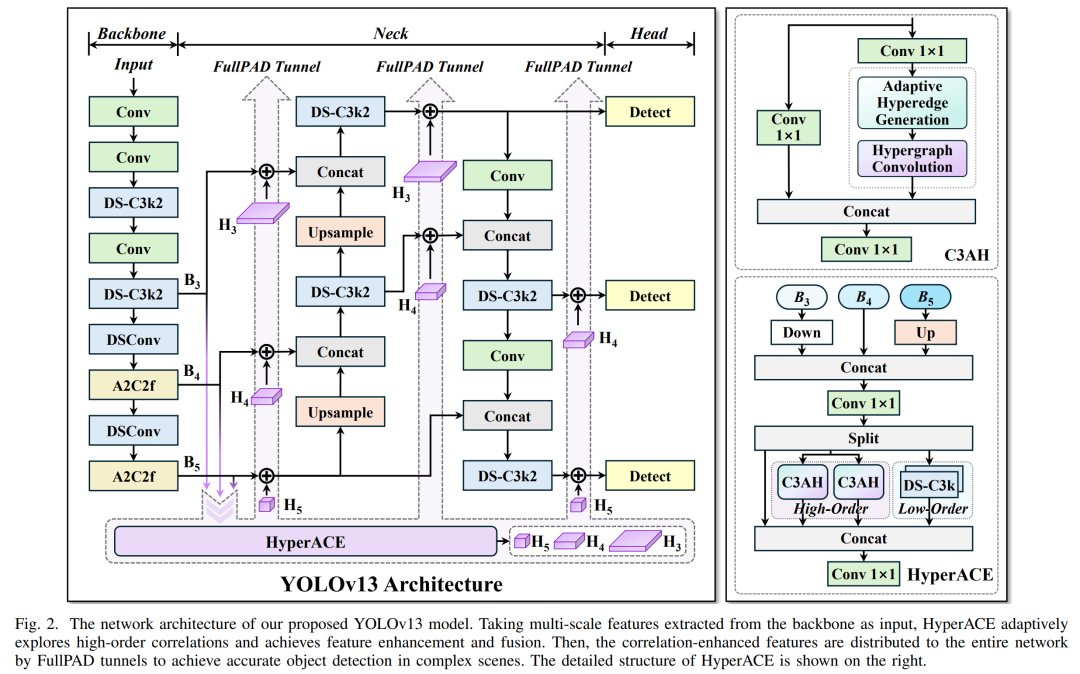
a. 基于超图的自适应相关性增强机制 (HyperACE)
YOLOv13的最核心创新,旨在有效捕捉特征间潜在的高阶关联。
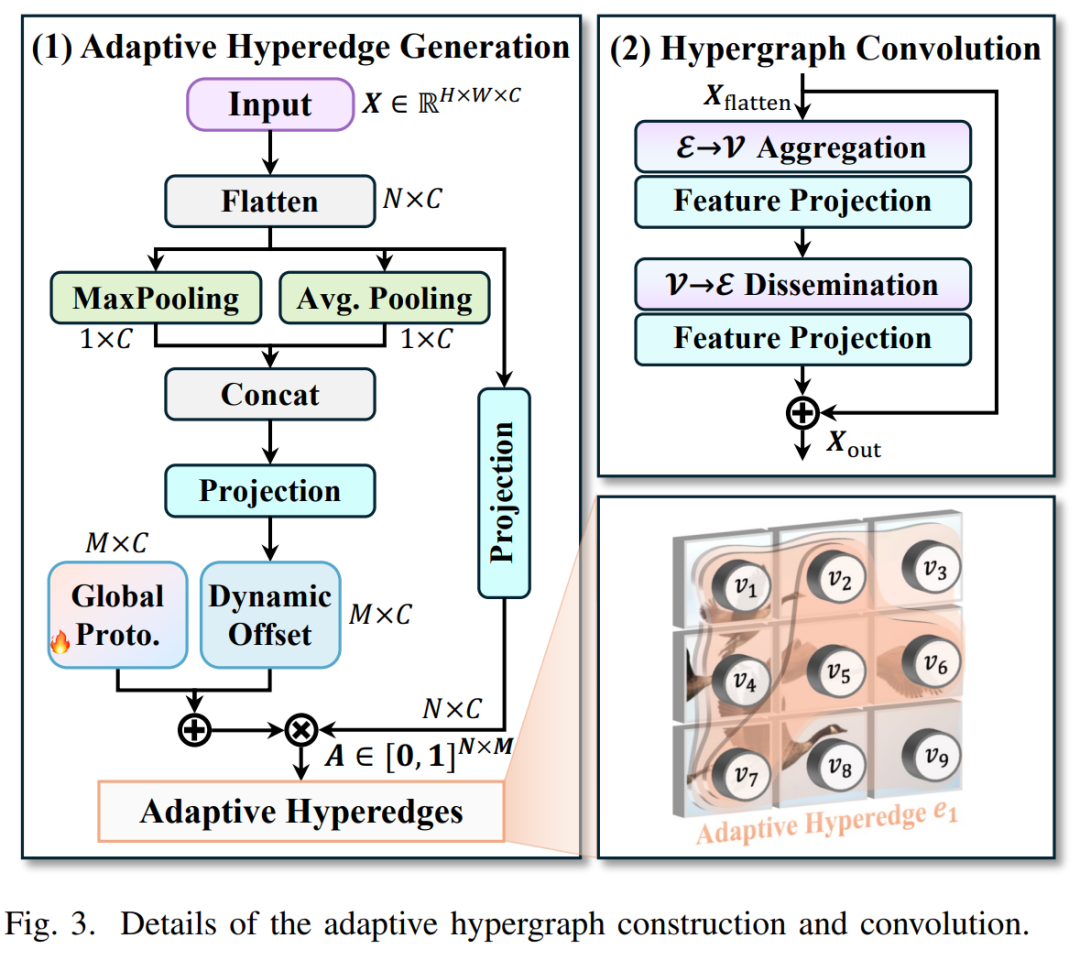
- 基本原理:该机制借鉴了超图(Hypergraph)的理论。与普通图中一条边只能连接两个顶点不同,超图中的一条“超边”(Hyperedge)可以同时连接多个顶点,这使其天然适合建模“多对多”的关系。
- 自适应超边生成:为克服传统超图方法依赖手工设定参数的不足,HyperACE设计了一个可学习的超边生成模块。该模块能根据输入的视觉特征,自适应地学习并构建超边,动态地探索不同特征顶点之间的潜在关联。
- 超图卷积:在生成自适应超边后,通过超图卷积操作进行特征聚合与增强。每条超边先从其连接的所有顶点处聚合信息,形成高阶特征;随后,这些高阶特征再被传播回各个顶点,从而完成对顶点特征的更新与增强。
b. 全流程聚合与分发范式 (FullPAD)
为了最大化HyperACE增强后特征的效用,作者设计了FullPAD这一新的网络信息流范式。
- 工作流程:FullPAD首先从骨干网络中汇集多尺度特征,并将其送入HyperACE模块进行处理。随后,通过专门的“FullPAD通道”,将这些经过高阶关联增强的特征重新分发至网络的多个关键位置,包括骨干网与颈部的连接处、颈部网络内部、以及颈部与检测头的连接处。
- 设计目的:这种设计旨在打破传统YOLO架构中单向的信息流,实现全网络范围内的信息协同与精细化流动,从而改善梯度传播并提升最终的检测性能。
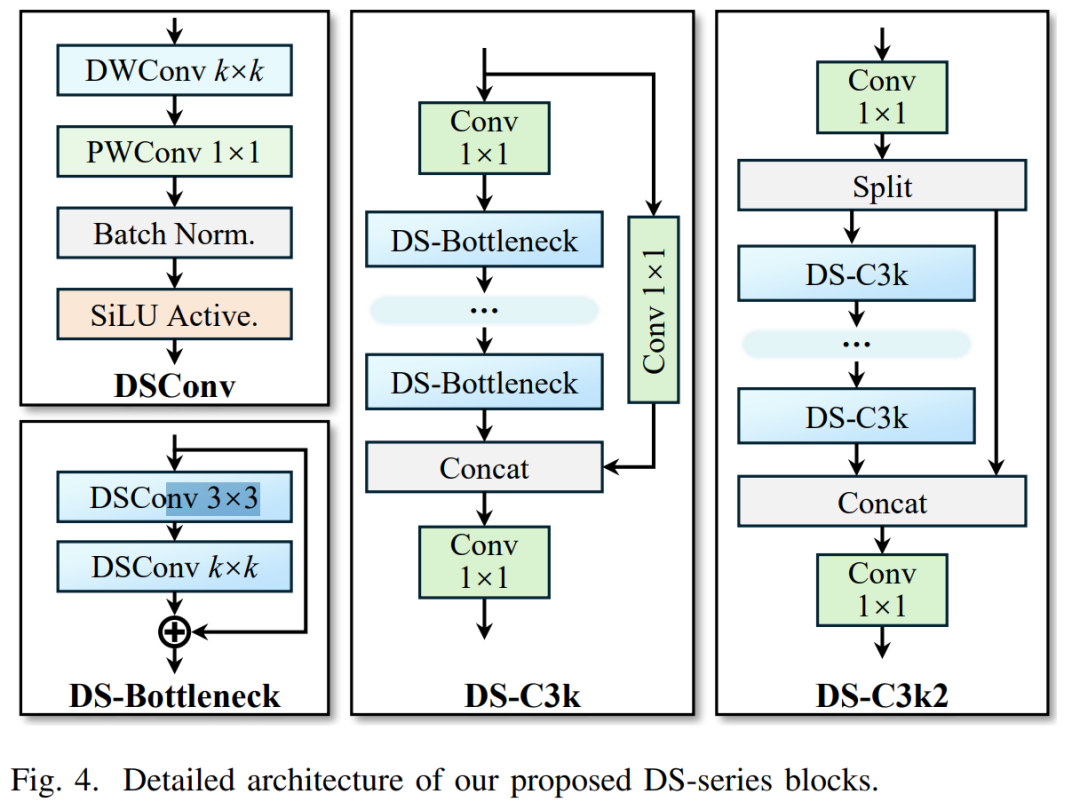
c. 深度可分离卷积轻量化设计
为保证模型的高效率,YOLOv13采用深度可分离卷积(Depthwise Separable Convolution, DSConv)作为基础单元,设计了一系列轻量化模块(如DSConv, DS-Bottleneck, DS-C3k, DS-C3k2),用于替代标准的大核卷积。这些模块被广泛应用于模型的骨干和颈部网络中,在基本不牺牲模型性能的前提下,显著降低了参数量和计算复杂度(FLOPs)。
【效果展示】
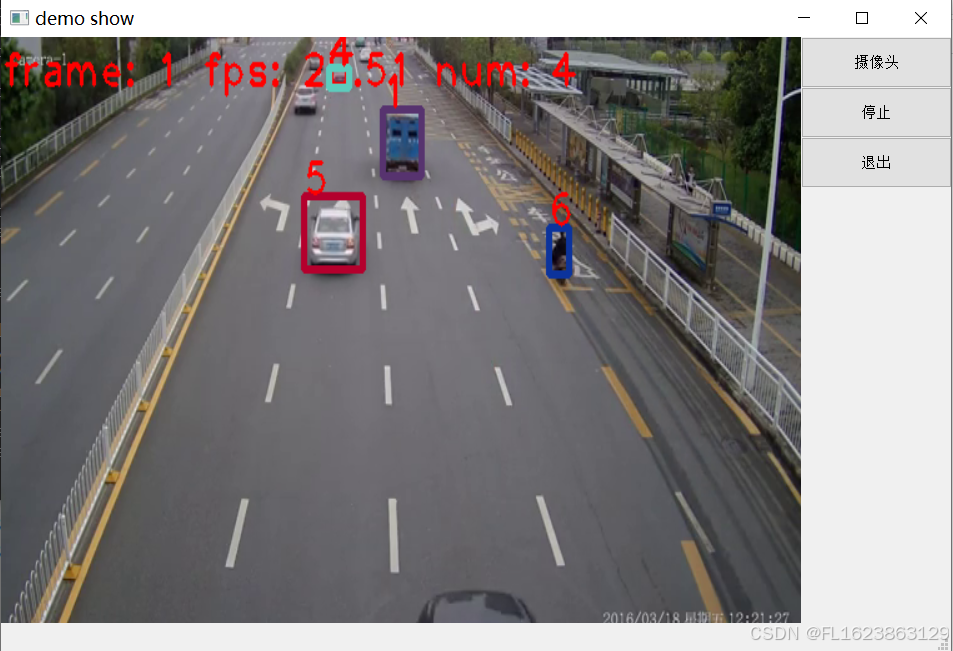
【测试环境】
anaconda3+python3.10 torch==2.5.1 numpy==1.26.4 cython_bbox-0.1.3-cp310-cp310-win_amd64.whl
注意一定要用源码提供cython_bbox进行安装否则会和numpy不兼容。
【视频演示】
bilibili.com/video/BV1ukKozkE9c/
【调用代码】
from Yolov13Detector import *
from ByteTackManager import *
from tracking_utils.timer import Timer
save_file = None  # not None will save video

cap = cv2.VideoCapture('car.mp4')
out = None

frame_fps = int(cap.get(cv2.CAP_PROP_FPS))
# 获取视频帧宽度和高度
frame_width = int(cap.get(cv2.CAP_PROP_FRAME_WIDTH))
frame_height = int(cap.get(cv2.CAP_PROP_FRAME_HEIGHT))
print("video fps={},width={},height={}".format(frame_fps, frame_width, frame_height))
if save_file:
    fourcc = cv2.VideoWriter_fourcc(*'mp4v')
    out = cv2.VideoWriter(save_file, fourcc, frame_fps, (frame_width, frame_height))
detector = Yolov13Detector()
tracker = BYTETracker()
frame_id = 0
timer = Timer()
while True:
    ret, frame = cap.read()
    frame_id += 1
    if not ret:
        print('read over!')
        break
    timer.tic()
    result_list = detector.inference_image(frame)

    if len(result_list)>0:
        online_targets = tracker.update(result_list)
        #print(online_targets)
        online_tlwhs = []
        online_ids = []
        online_scores = []
        for t in online_targets:
            tlwh = t.tlwh
            tid = t.track_id
            vertical = tlwh[2] / tlwh[3] > 1.6
            if tlwh[2] * tlwh[3] > 10 and not vertical:
                online_tlwhs.append(tlwh)
                online_ids.append(tid)
                online_scores.append(t.score)

        timer.toc()
        #print(online_tlwhs)
        online_im = plot_tracking(frame, online_tlwhs, online_ids, frame_id=frame_id + 1,
                                  fps=1. / timer.average_time)
    if save_file:
        out.write(online_im)
    cv2.imshow('frame', online_im)
    if cv2.waitKey(1) & 0xFF == ord('q'):
        break

if save_file:
    out.release()
cap.release()
cv2.destroyAllWindows()
本文参与 腾讯云自媒体同步曝光计划,分享自作者个人站点/博客。
原始发表:2025-07-15,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号