Xinference 大模型推理框架,离线部署,支持vLLM、SGLang、llama.cpp等引擎

Xinference 大模型推理框架,离线部署,支持vLLM、SGLang、llama.cpp等引擎
Ai学习的老章
发布于 2025-10-11 12:12:51
发布于 2025-10-11 12:12:51
大家好,我是 Ai 学习的老章
# 为何要本地部署大模型 # Linux 安装 Docker 完整教程 # 不要再用 Ollama,不要再用 llama.cpp # 内网部署 llama.cpp,运行量化大模型,so easy # 纯离线安装大模型推理引擎,部署量化大模型 # Python 离线安装库,依赖,依赖,还是 TM 的依赖 # Qwen3-Next,性价比最高的非思考大模型 get
0、Xinference
大模型推理引擎,最火的当属 vLLM 和 SGLang,它们之间也在不断在某些知名模型上的优化你追我赶,我个人是 vLLM 的忠实用户,但是最近在部署某个 Reranker 模型时下游对接出现了一些问题,用 xinference(一个性能强大且功能全面的分布式推理框架,它直接支持了 vllm、sglang、llama.cpp、transformers、MLX 等推理引擎,还提供了可视化界面管理各种大模型)虽然也用了 vllm,结果却很 OK。
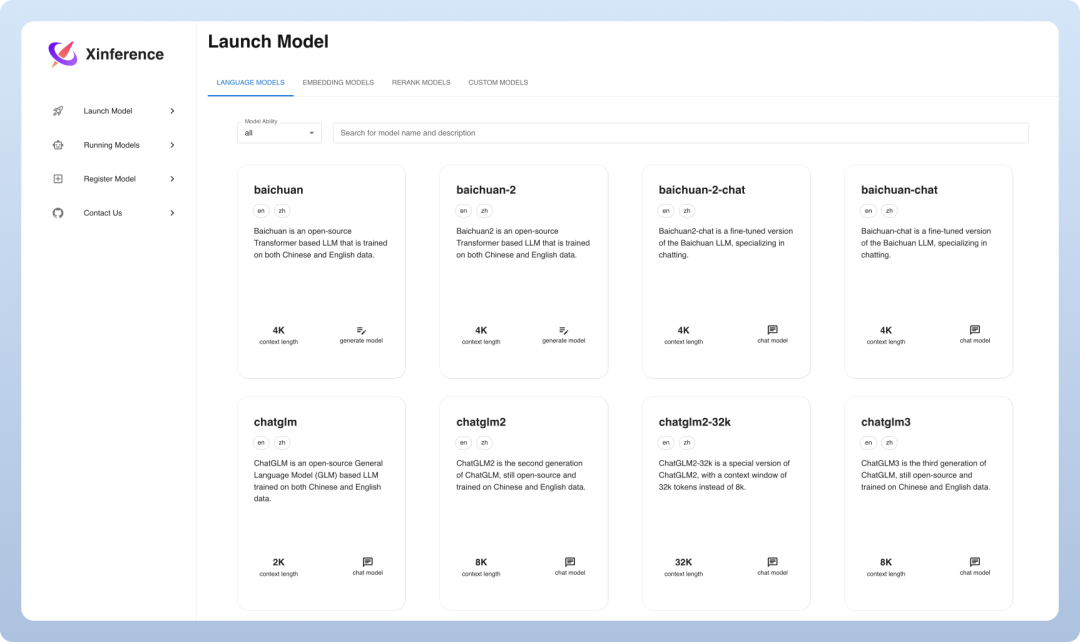
本文就介绍一下如何纯离线部署 xinference,离线拉起大模型
其实如果网络畅通,安装部署那没啥好介绍的,一行命令就 OK 了,下载、部署大模型也仅需点点鼠标。
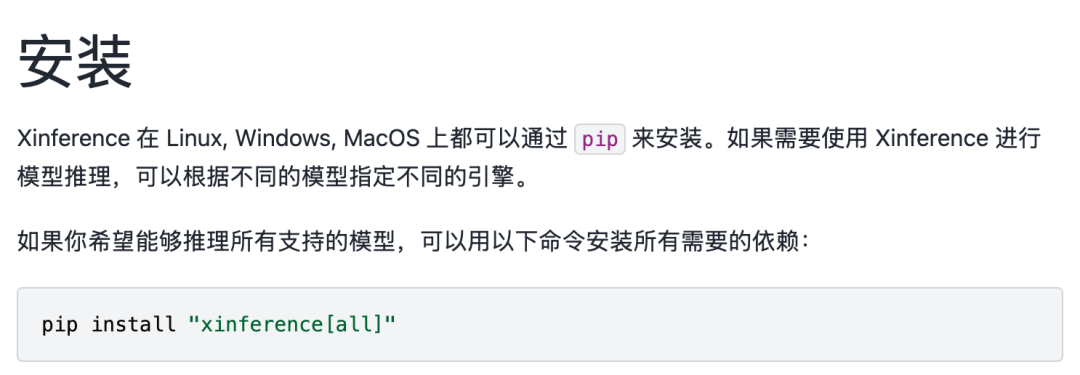
离线就有点麻烦了,需要各种环境依赖,相对简单的方法还是 Docker
1、下载镜像
Xinference 官方镜像已发布在 DockerHub 上的 xprobe/xinference 仓库中。
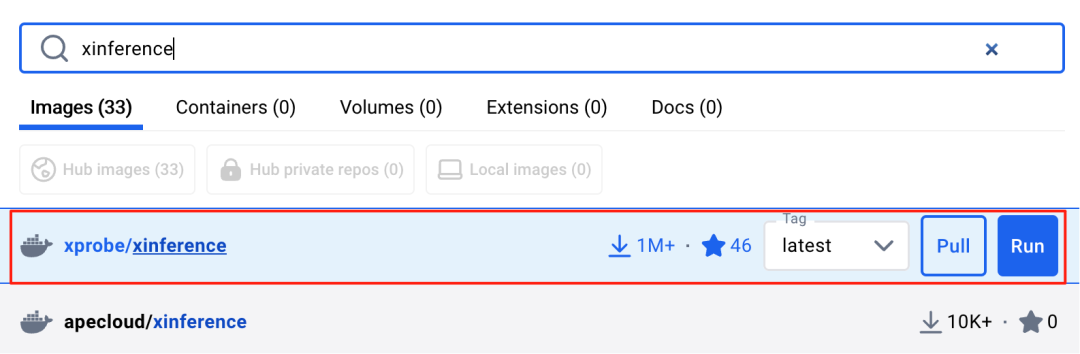
当前可用的标签包括:
nightly-main: 这个镜像会每天从 GitHub main 分支更新制作,不保证稳定可靠。v<release version>: 这个镜像会在 Xinference 每次发布的时候制作,通常可以认为是稳定可靠的。latest: 这个镜像会在 Xinference 发布时指向最新的发布版本- 对于 CPU 版本,增加
-cpu后缀,如nightly-main-cpu。 - 对于 CUDA 12.8 版本,增加
-cu128后缀,如nightly-main-cu128。(Xinference 版本需要至少 v1.8.1)
我直接使用 latest,如果你的开发机与生产机架构不一样,docker pull 的时候记得加 --platform 参数,比如docker pull --platform linux/amd64 xprobe/xinference
也可以使用自定义镜像,对官方版本修改后自行创建 Dockerfile,具体方法可以参考 xinference/deploy/docker/Dockerfile ,没必要折腾。
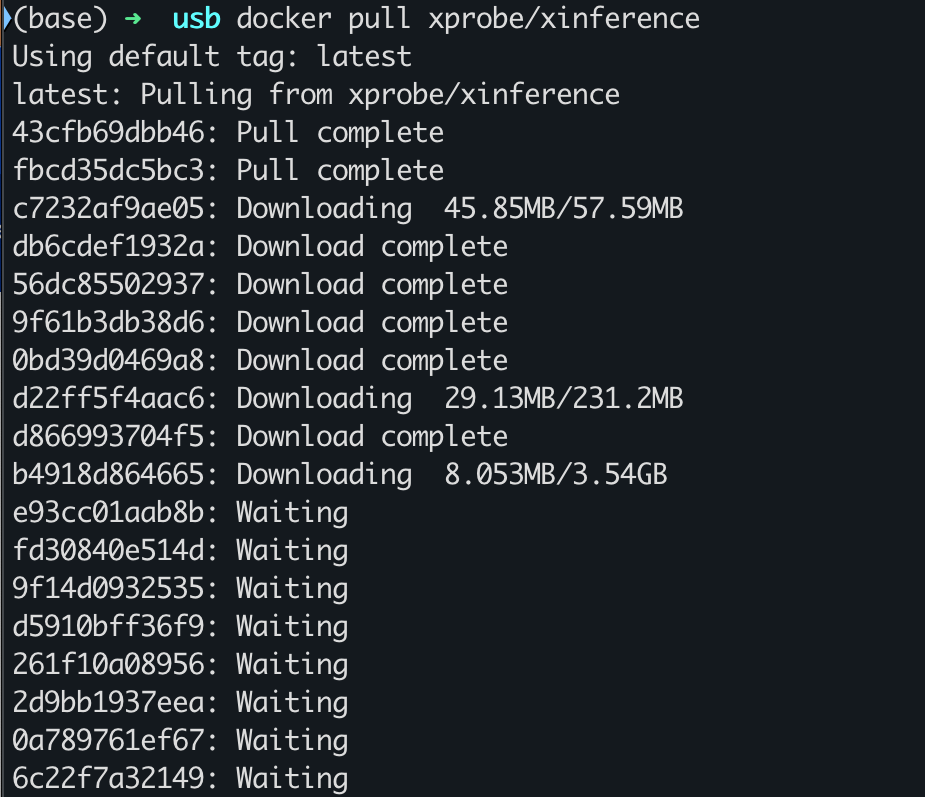
然后保存镜像
docker save xprobe/xinference > xinfer.tar
2、镜像传入内网
不赘述,不同公司有不同工具可以在办公网与生产内网传输数据。
3、**在内网服务器(x86)加载镜像
# 加载镜像,加载过程需要一些时间,完成后,Docker 会输出加载的镜像信息。
docker load i xinfer.tar
# 运行 docker images 命令来查看本地镜像列表,确认xinfer已经成功加载。
docker images

4、启动xinference
执行命令如下:
docker run -e XINFERENCE_MODEL_SRC=local -p 9002:9997 --gpus all -e API_HOST=0.0.0.0 -v /data/aihub/:/models xprobe/xinference:latest xinference-local -H 0.0.0.0 --log-level debug --port 9997
⚙️ 参数详解
- -e XINFERENCE_MODEL_SRC=local 强制 Xinference “本地模式”,不要从互联网加载大模型
- -v /data/aihub/:/models :将宿主机的 /data/aihub/ 目录挂载到容器内的 /models 目录。默认情况下,镜像中不包含任何模型文件,使用过程中会在容器内下载模型。如果需要使用已经下载好的模型,需要将宿主机的目录挂载到容器内。这种情况下,需要在运行容器时指定本地卷,并且为 Xinference 配置环境变量。因为启用了“本地模式”Xinference 现在会主动扫描这个 /models 目录来发现存放的所有模型。
- -p 9002:9997 端口映射,格式为 宿主机端口:容器端口。将电脑的 9002 端口暴露出来,并连接到容器内部运行的 9997 端口。所以,应该通过 http://<你的IP>:9002 来访问服务。
- -e API_HOST=0.0.0.0 和 -H 0.0.0.0 确保服务在容器的所有网络接口上监听。
- --gpus all 为容器分配所有可用的 NVIDIA GPU 资源。
- xprobe/xinference:latest 指定运行的 Docker 镜像。
- xinference-local 启动服务。
- --log-level debug 将日志级别设为“调试”,便于输出所有详细信息来排查问题。
- --port 9997: 告诉服务在容器内使用 9997 端口。
启动成功后就可以在浏览器访问xinference了
http://<你的IP>:9002
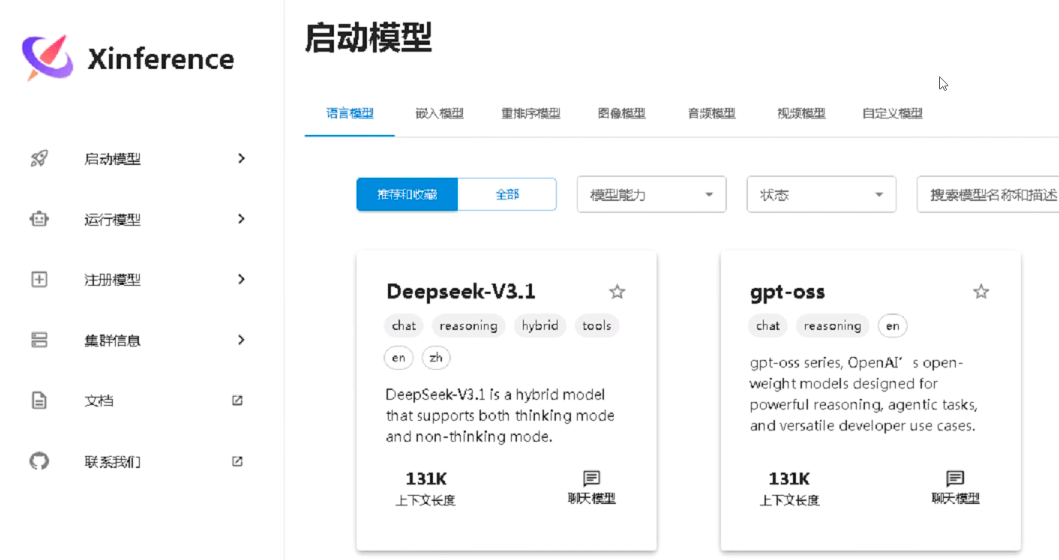
5、启动模型
虽然启动xinference已经挂载了模型地址,启动模型的时候依然会下载(宿主机在内网,无法联网),进入docker 内部查看,发现模型确实已经在了
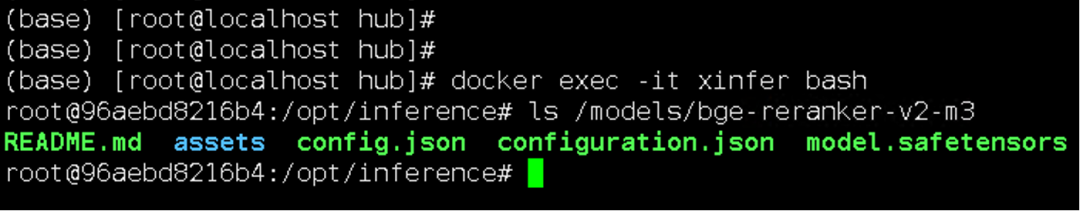
这是怎么回事呢,问了一位专家:xinfer 所谓的缓存是运行成功后的配置给你存起来,这样不用每次启动重新选这些参数;和你模型放在哪里没关系,就算是放在它的默认位置路径里,它也不会显示已缓存。小白的方法是不要自己手工预先下载好,而是直接在页面上选好你的配置让它自己下,它成功运行完第一次之后,你自然会看到是已缓存状态。
但是我要是能联网,谁tm还docker 还手动下载模型,还费劲挂载啊
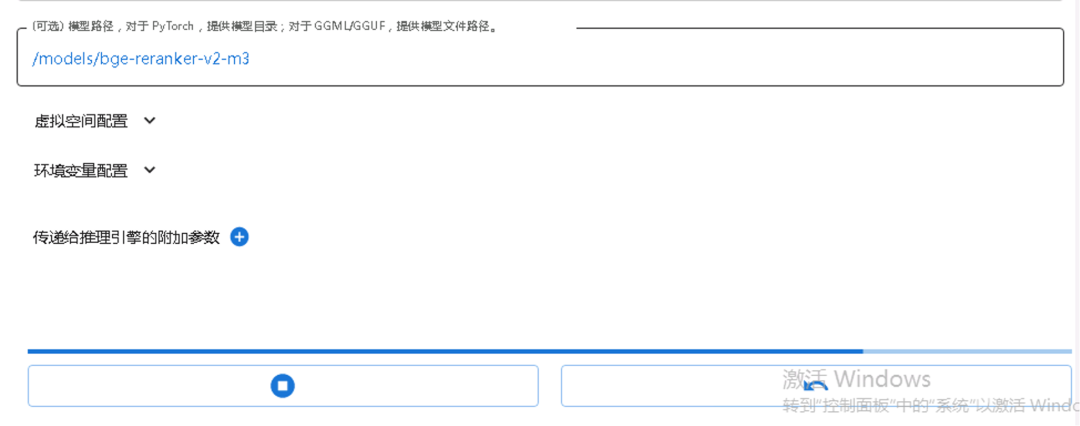
最正确的方式是在启动模型页,手填模型路径
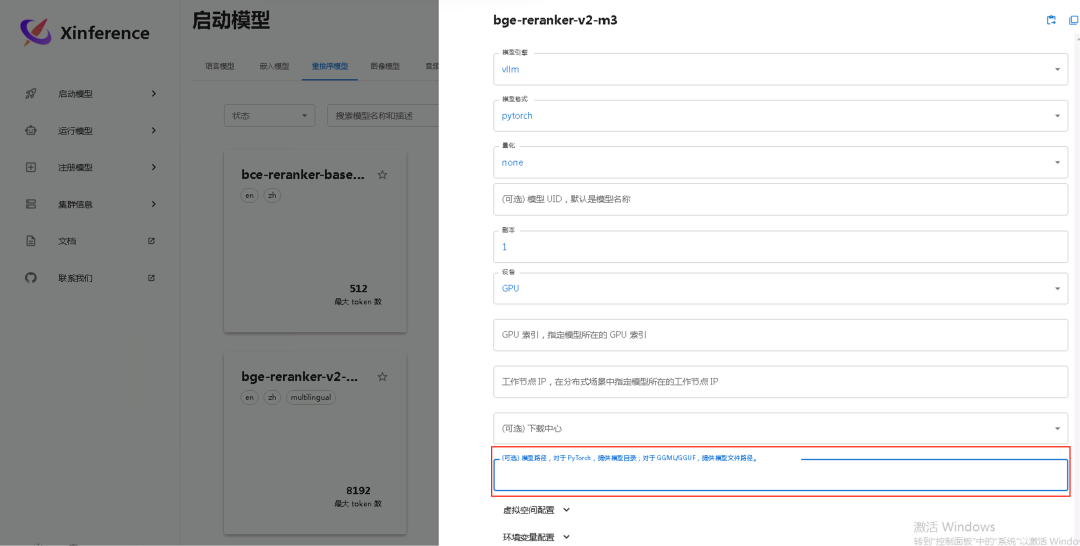
验证这个路径简单的办法是在进入docekr内部 ls 一下这个路径,它能找到目录并能显示出来目录内容,就说明你填写对了
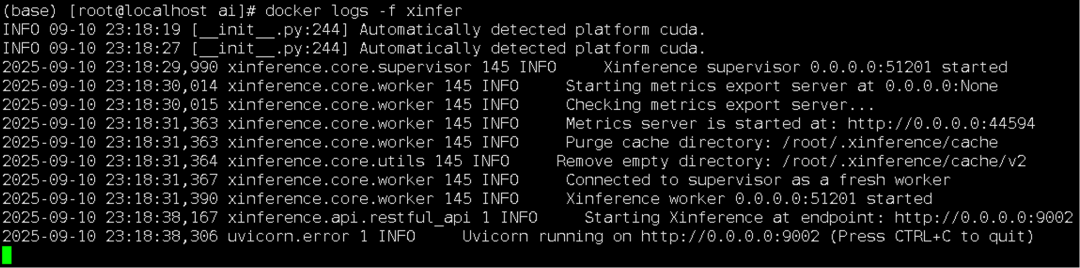
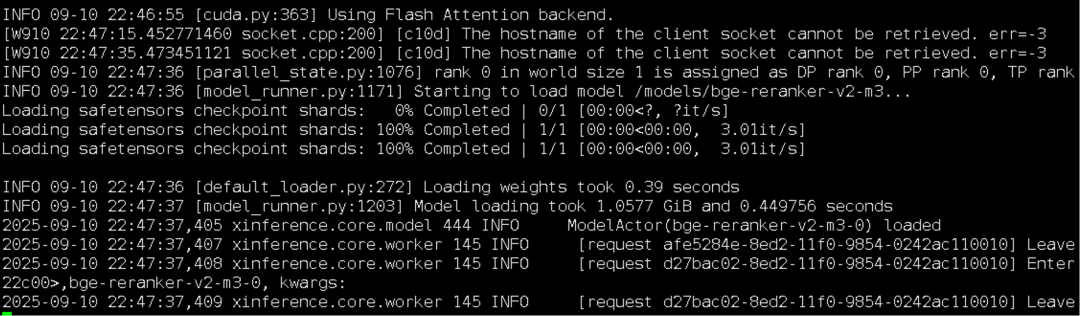
然后docker logs -f xinfer查看日志,发现模型已经成功启动
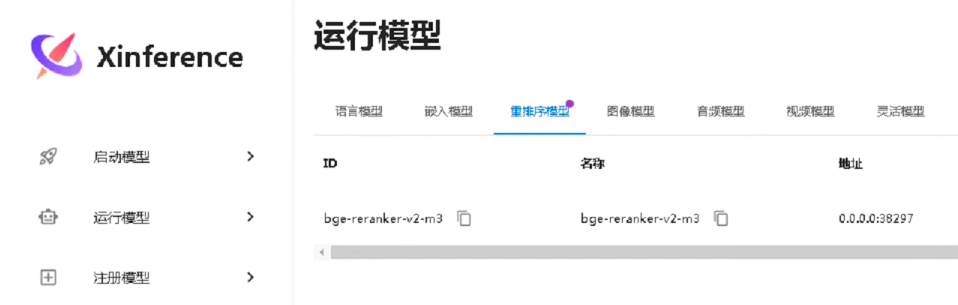
前端页面显示页正常运行中
至此,本文完
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2025-09-14,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号