零基础学AI大模型之ChatModel聊天模型与ChatPromptTemplate实战

零基础学AI大模型之ChatModel聊天模型与ChatPromptTemplate实战

工藤学编程
发布于 2025-12-22 09:39:38
发布于 2025-12-22 09:39:38
大家好,我是工藤学编程 🦉 | 一个正在努力学习的小博主,期待你的关注 |
|---|---|
实战代码系列最新文章😉 | C++实现图书管理系统(Qt C++ GUI界面版) |
SpringBoot实战系列🐷 | 【SpringBoot实战系列】SpringBoot3.X 整合 MinIO 存储原生方案 |
分库分表 | 分库分表之实战-sharding-JDBC分库分表执行流程原理剖析 |
消息队列 | 深入浅出 RabbitMQ-RabbitMQ消息确认机制(ACK) |
AI大模型 | 零基础学AI大模型之LangChain-PromptTemplate |
前情摘要: 1、零基础学AI大模型之读懂AI大模型 2、零基础学AI大模型之从0到1调用大模型API 3、零基础学AI大模型之SpringAI 4、零基础学AI大模型之AI大模型常见概念 5、零基础学AI大模型之大模型私有化部署全指南 6、零基础学AI大模型之AI大模型可视化界面 7、零基础学AI大模型之LangChain 8、零基础学AI大模型之LangChain六大核心模块与大模型IO交互链路 9、零基础学AI大模型之Prompt提示词工程 10、零基础学AI大模型之LangChain-PromptTemplate
零基础学AI大模型之ChatModel聊天模型与ChatPromptTemplate实战
大家好,我是工藤学编程!之前的「零基础学AI大模型」系列已经更新了9篇内容,从大模型基础概念、API调用(含SpringAI),到私有化部署、可视化界面,再到LangChain核心模块,我们一步步搭建了AI大模型的知识框架。
而在实际应用中,多轮对话是最常见的场景——无论是客服机器人、虚拟助手,还是智能问答工具,都需要模型“记住”上下文并连贯响应。今天这篇,我们就聚焦聊天场景的核心:ChatModel聊天模型的原理、Token计算规则,以及LangChain中如何用ChatPromptTemplate实现灵活的对话模板设计。
请添加图片描述
一、什么是ChatModel?专为多轮对话而生的智能系统
ChatModel不是简单的“文本生成工具”,而是大语言模型(LLM)针对多轮对话场景的优化版本。它能理解对话逻辑、追踪上下文,生成符合人类交互习惯的连贯回复,核心定位是“智能对话系统”而非“单次文本生成器”。
1.1 ChatModel的5大核心特性
ChatModel的优势体现在对对话场景的深度适配,具体特性如下表:
核心特性 | 说明 | 示例场景 |
|---|---|---|
上下文感知 | 自动追踪多轮对话历史,理解指代关系(如“它”“这个”) | 用户:“什么是量子计算?”→AI解释→用户:“它有什么应用?”→AI正确关联“它”指量子计算 |
角色扮演能力 | 可设定特定角色(如客服、教师),并在对话中保持角色一致性 | 设定“医疗助手”角色后,AI会拒绝提供诊断建议,仅输出健康科普信息 |
意图识别 | 解析用户深层需求(咨询/投诉/闲聊),优先响应核心诉求 | 用户:“我的订单没收到!”→AI识别为“物流投诉”,自动提示“是否需要转接人工查询” |
情感分析 | 识别用户情绪(积极/消极),动态调整回复语气 | 用户表达不满时,AI回复:“非常抱歉给您带来不便,我们会立刻核查订单状态…” |
安全过滤 | 内置有害内容拦截机制,避免生成暴力、偏见或敏感信息 | 用户请求“生成暴力教程”时,AI拒绝并提示:“我无法协助该请求,请提供合法合规需求” |
1.2 ChatModel vs 传统Text Model:核心差异对比
很多同学会混淆“聊天模型”和“传统文本生成模型”(如GPT-3的text-davinci-003),两者的核心目标完全不同,具体对比如下:
对比维度 | ChatModel(如GPT-3.5-turbo、GPT-4) | 传统Text Model(如text-davinci-003) |
|---|---|---|
核心目标 | 多轮交互式对话,保证上下文连贯 | 单次文本生成(如写文章、生成代码、总结报告) |
输入格式 | 结构化消息序列(含System/User/Assistant角色标识) | 纯文本提示(无角色区分,需手动拼接上下文) |
上下文处理 | 自动管理对话历史,无需手动传入历史文本 | 需开发者手动拼接所有历史对话到提示词中,否则无法识别上下文 |
输出控制 | 内置安全审查和格式约束(如拒绝违规需求、保持角色语气) | 依赖复杂的提示词工程控制输出(如“不要生成暴力内容”需写在提示词里) |
典型应用 | 客服机器人、虚拟助手、智能问答 | 内容创作、数据清洗、代码生成、文本摘要 |
二、ChatModel的角色体系:对话控制的核心
要让ChatModel精准响应,必须先理解它的角色体系——通过定义不同角色的消息,模型能明确“自己该做什么”“用户要什么”“历史对话是什么”。核心角色有3个:
角色类型 | 标识符 | 功能定位 | 使用场景示例 |
|---|---|---|---|
系统角色 | System | 定义AI的行为准则、角色设定、知识范围 | (“system”, “你是一位医疗助手,仅提供健康科普,不做诊断”) |
用户角色 | User | 承载用户的输入信息(提问、指令、反馈) | (“user”, “如何缓解偏头痛?”) |
助手角色 | Assistant | 存储AI的历史回复,维护对话连贯性 | (“assistant”, “建议通过休息、按摩太阳穴缓解,若持续需就医”) |
实战示例:用OpenAI API调用ChatModel
通过代码直观感受角色体系如何工作(以OpenAI的GPT-3.5-turbo为例):
# 1. 导入依赖(需先安装openai库:pip install openai)
from openai import OpenAI

# 2. 初始化客户端(替换为你的API Key)
client = OpenAI(api_key="your-api-key")

# 3. 定义多轮对话消息(包含System/User/Assistant角色)
messages = [
    {"role": "system", "content": "你是一个电影推荐助手,只推荐经典科幻片"},
    {"role": "user", "content": "我喜欢科幻片,推荐三部经典"},
    {"role": "assistant", "content": "1.《银翼杀手2049》(视觉美学巅峰);2.《星际穿越》(硬核科学+情感);3.《黑客帝国》(哲学+科幻)"},
    {"role": "user", "content": "第二部的主演是谁?"}  # 模型能关联“第二部”指《星际穿越》
]

# 4. 调用ChatModel生成回复
response = client.chat.completions.create(
    model="gpt-3.5-turbo",  # 指定聊天模型
    messages=messages       # 传入带角色的对话历史
)

# 5. 输出结果
print(response.choices[0].message.content)
# 输出:《星际穿越》的主演是马修·麦康纳(饰演库珀)和安妮·海瑟薇(饰演布兰德),还有杰西卡·查斯坦等演员参演。
三、多轮对话的Token计算:别踩“上下文窗口”的坑
在使用ChatModel时,很多同学会遇到“对话突然断裂”“模型忘记历史”的问题——本质是Token数量超出了模型的上下文窗口限制。这部分我们就讲清楚Token的计算逻辑和窗口限制。
3.1 上下文包含哪些内容?
多轮对话的“上下文”不是只包含用户最新的提问,而是以下三部分的总和:
- 系统提示(System):始终存在,用于定义AI角色;
- 用户历史输入(User):所有轮次中用户的提问/指令;
- 模型历史回复(Assistant):所有轮次中AI的响应内容。
3.2 Token如何累积?
Token是模型处理文本的基本单位(1个Token≈0.75个英文单词≈0.5个中文汉字)。随着对话轮次增加,上下文的Token会不断累积。
假设每轮对话中:用户输入≈50 Token,模型回复≈100 Token,系统提示≈30 Token(固定),则Token累积过程如下:
- 第1轮:系统提示(30)+ 用户输入(50)+ 模型回复(100)= 180 Token;
- 第2轮:历史上下文(180)+ 新用户输入(50)+ 新模型回复(100)= 330 Token;
- 第3轮:历史上下文(330)+ 新用户输入(50)+ 新模型回复(100)= 480 Token;
- … 以此类推,每轮新增约150 Token。
3.3 上下文窗口限制:不同模型的“天花板”
每个ChatModel都有固定的“上下文窗口大小”,超出后模型会“遗忘”最早的对话内容(或直接报错)。常见模型的窗口限制如下:
- 4k Token:GPT-3.5-turbo(约2000-3000中文字符);
- 8k Token:GPT-4(基础版,约4000-6000中文字符);
- 32k Token:GPT-4 Turbo(进阶版,约16000-24000中文字符);
- 更大窗口:如Claude 3 Opus(100k Token),适合超长篇对话(如文档问答)。
小提示:实际开发中,建议定期“截断”早期对话(保留最近几轮),避免Token超出限制。
四、ChatPromptTemplate:LangChain中构建对话模板的利器
在LangChain框架中,ChatPromptTemplate是专门为ChatModel设计的“对话模板工具”——它能帮我们快速定义角色、管理上下文、动态替换变量,避免重复写硬编码的messages列表。
4.1 ChatPromptTemplate的核心优势
相比直接手写messages列表,ChatPromptTemplate有3个核心价值:
- 支持角色绑定:天生适配System/User/Assistant角色,无需手动写
{"role": "..."}; - 动态变量替换:通过
{变量名}实现参数化(如动态修改AI名字、用户问题); - 维护多轮上下文:轻松组合历史对话模板,无需手动拼接文本。
4.2 消息类型体系:4种核心模板类
ChatPromptTemplate通过不同的“子模板类”对应不同角色,分工明确:
模板类 | 对应角色 | 典型用途 |
|---|---|---|
SystemMessagePromptTemplate | System | 定义AI的角色、规则(如“你是翻译助手”) |
HumanMessagePromptTemplate | User | 接收用户输入(如“翻译{text}到中文”) |
AIMessagePromptTemplate | Assistant | 预设AI的历史回复(如固定开场白“你好!”) |
ChatPromptTemplate | 容器模板 | 组合上述模板,构建完整对话流程 |
4.3 两个关键方法:from_template vs from_messages
ChatPromptTemplate有两个常用方法,分别对应不同的使用场景,我们通过“对比+实战”讲清楚。
方法对比表
方法 | 适用场景 | 灵活性 | 代码复杂度 |
|---|---|---|---|
from_messages | 多角色、多轮对话(如客服机器人、虚拟助手) | 高(支持列表) | 低 |
from_template | 单角色消息模板(需与其他模板组合) | 较低(单角色) | 低 |
实战1:用from_messages构建多轮对话模板
from_messages是最常用的方法,直接通过“角色+模板”的元组列表定义对话流程,支持动态变量:
# 1. 安装LangChain核心库:pip install langchain-core
from langchain_core.prompts import ChatPromptTemplate

# 2. 用from_messages定义模板(包含System/User/Assistant角色,动态变量{name}和{user_input})
chat_template = ChatPromptTemplate.from_messages([
    ("system", "你是一个助手AI,名字是{name},回答要简洁友好。"),  # 系统角色:动态名字
    ("human", "你好,我是用户小A!"),  # 用户角色:固定开场白
    ("ai", "你好小A!有什么我能帮你的吗?"),  # 助手角色:固定回复
    ("human", "{user_input}")  # 用户角色:动态输入
])

# 3. 格式化模板(传入变量值)
messages = chat_template.format_messages(
    name="Bob",  # 替换{name}
    user_input="你最喜欢的编程语⾔是什么?"  # 替换{user_input}
)

# 4. 输出结果(可直接传入ChatModel调用)
for msg in messages:
print(f"角色:{msg.type} | 内容:{msg.content}")输出结果:
角色:system | 内容:你是一个助手AI,名字是Bob,回答要简洁友好。
角色:human | 内容:你好,我是用户小A!
角色:ai | 内容:你好小A!有什么我能帮你的吗?
角色:human | 内容:你最喜欢的编程语⾔是什么?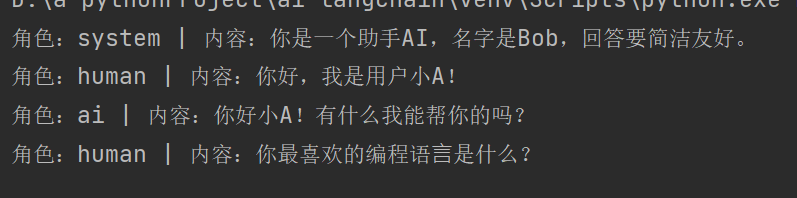
在这里插入图片描述
实战2:结合from_template与from_messages
当需要细分单角色模板(如复杂的系统指令)时,可以先用from_template定义单个角色模板,再用from_messages组合:
from langchain_core.prompts import (
    ChatPromptTemplate,
    SystemMessagePromptTemplate,  # 系统角色子模板
    HumanMessagePromptTemplate   # 用户角色子模板
)

# 1. 用from_template定义单角色模板(支持动态变量{role}、{language}、{question})
system_template = SystemMessagePromptTemplate.from_template(
    "你是一个{role},必须用{language}回答,回答不超过3句话。"
)
user_template = HumanMessagePromptTemplate.from_template(
    "{question}"
)

# 2. 用from_messages组合子模板
chat_template = ChatPromptTemplate.from_messages([
    system_template,  # 导入系统子模板
    user_template     # 导入用户子模板
])

# 3. 格式化模板
messages = chat_template.format_messages(
    role="翻译助手",
    language="中文",
    question="将'I love programming with Python'翻译成中文。"
)

# 4. 输出结果
for msg in messages:
print(f"角色:{msg.type} | 内容:{msg.content}")输出结果:
角色:system | 内容:你是一个翻译助手,必须用中文回答,回答不超过3句话。
角色:human | 内容:将'I love programming with Python'翻译成中文。
在这里插入图片描述
五、总结:ChatModel与ChatPromptTemplate的核心价值
- ChatModel:解决了“多轮对话连贯性”问题,通过角色体系和上下文感知,让AI从“单次文本生成器”变成“能聊天的智能助手”;
- Token计算:记住“上下文=系统提示+历史对话”,避免超出模型窗口限制(如GPT-3.5-turbo的4k Token);
- ChatPromptTemplate:LangChain中的“对话模板神器”,用
from_messages快速构建多轮对话,用from_template细分单角色逻辑,大幅提升开发效率。
如果觉得本文有用,欢迎点赞+收藏+评论,你的支持是我更新的最大动力~ 🚀
本文参与 腾讯云自媒体同步曝光计划,分享自作者个人站点/博客。
原始发表:2025-11-17,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号