零基础5分钟用AI做一个【AI模型价格监控、成本预估和对比小助手】(附Prompt)
原创
零基础5分钟用AI做一个【AI模型价格监控、成本预估和对比小助手】(附Prompt)
原创
轻松悠悠
修改于 2026-09-23 11:33:08
修改于 2026-09-23 11:33:08
不会编程也能做。全程说人话,5 分钟做出一个能天天用的智能体。
一、先说结论:我做出来了什么
先上成品,不废话。
我是基于本地安全和成本考虑,选择的国产桌面智能体AiPy,你可以根据你的习惯来选择实施工具。
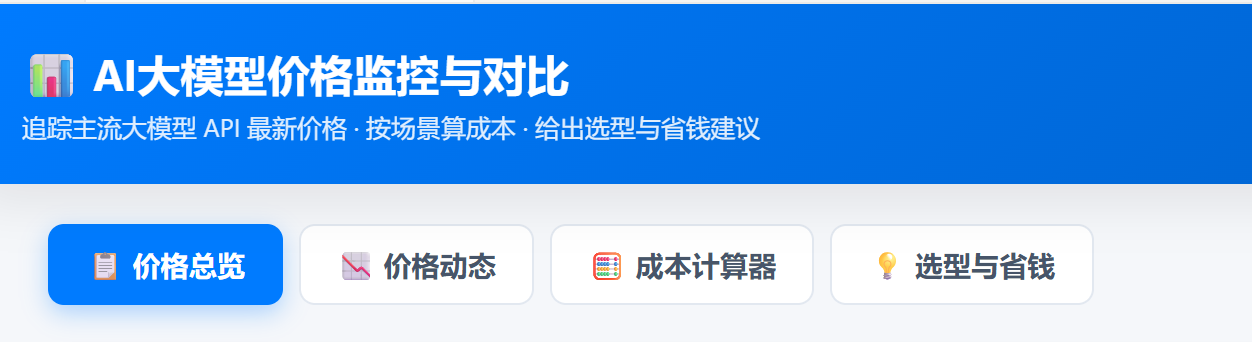
一共 4 个功能区:
功能区 | 能干什么 |
|---|---|
📋 价格总览 | 8 家厂商 17 个模型的价格表,可按厂商/档位/地区筛选,自动把美元折算成人民币 |
📉 价格动态 | 降价标绿、涨价标红,做成时间线,一眼看清谁在涨谁在降 |
🧮 成本计算器 | 输入你的 token 用量,实时算出所有模型各花多少钱,自动排名,可导出 CSV |
💡 选型与省钱 | 速查表 + 8 条省钱招 + 6 个选型注意事项 |
最惊艳的功能:说人话就能算钱。不用懂 token 是什么,直接用大白话描述任务,AI 自动拆解需求、预估用量、推荐模型、算出成本。 |
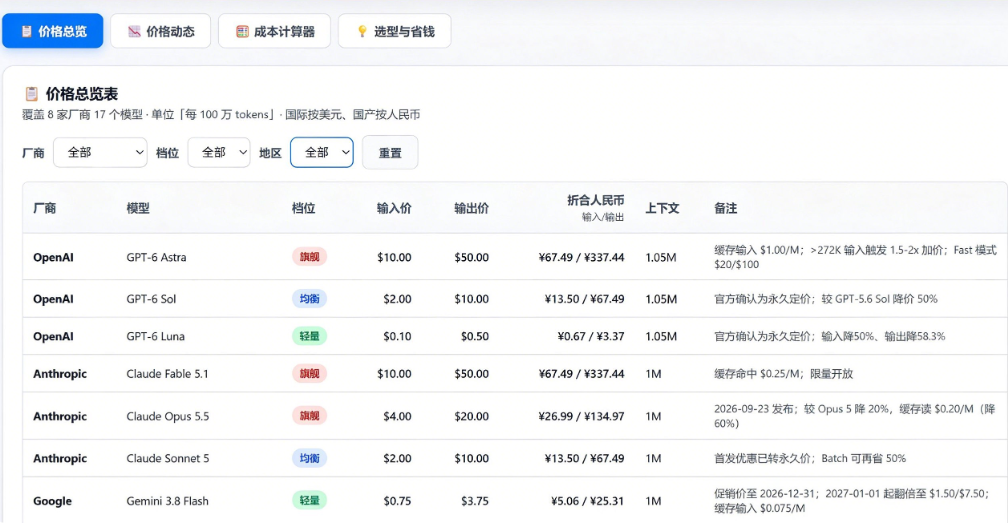
价格一览
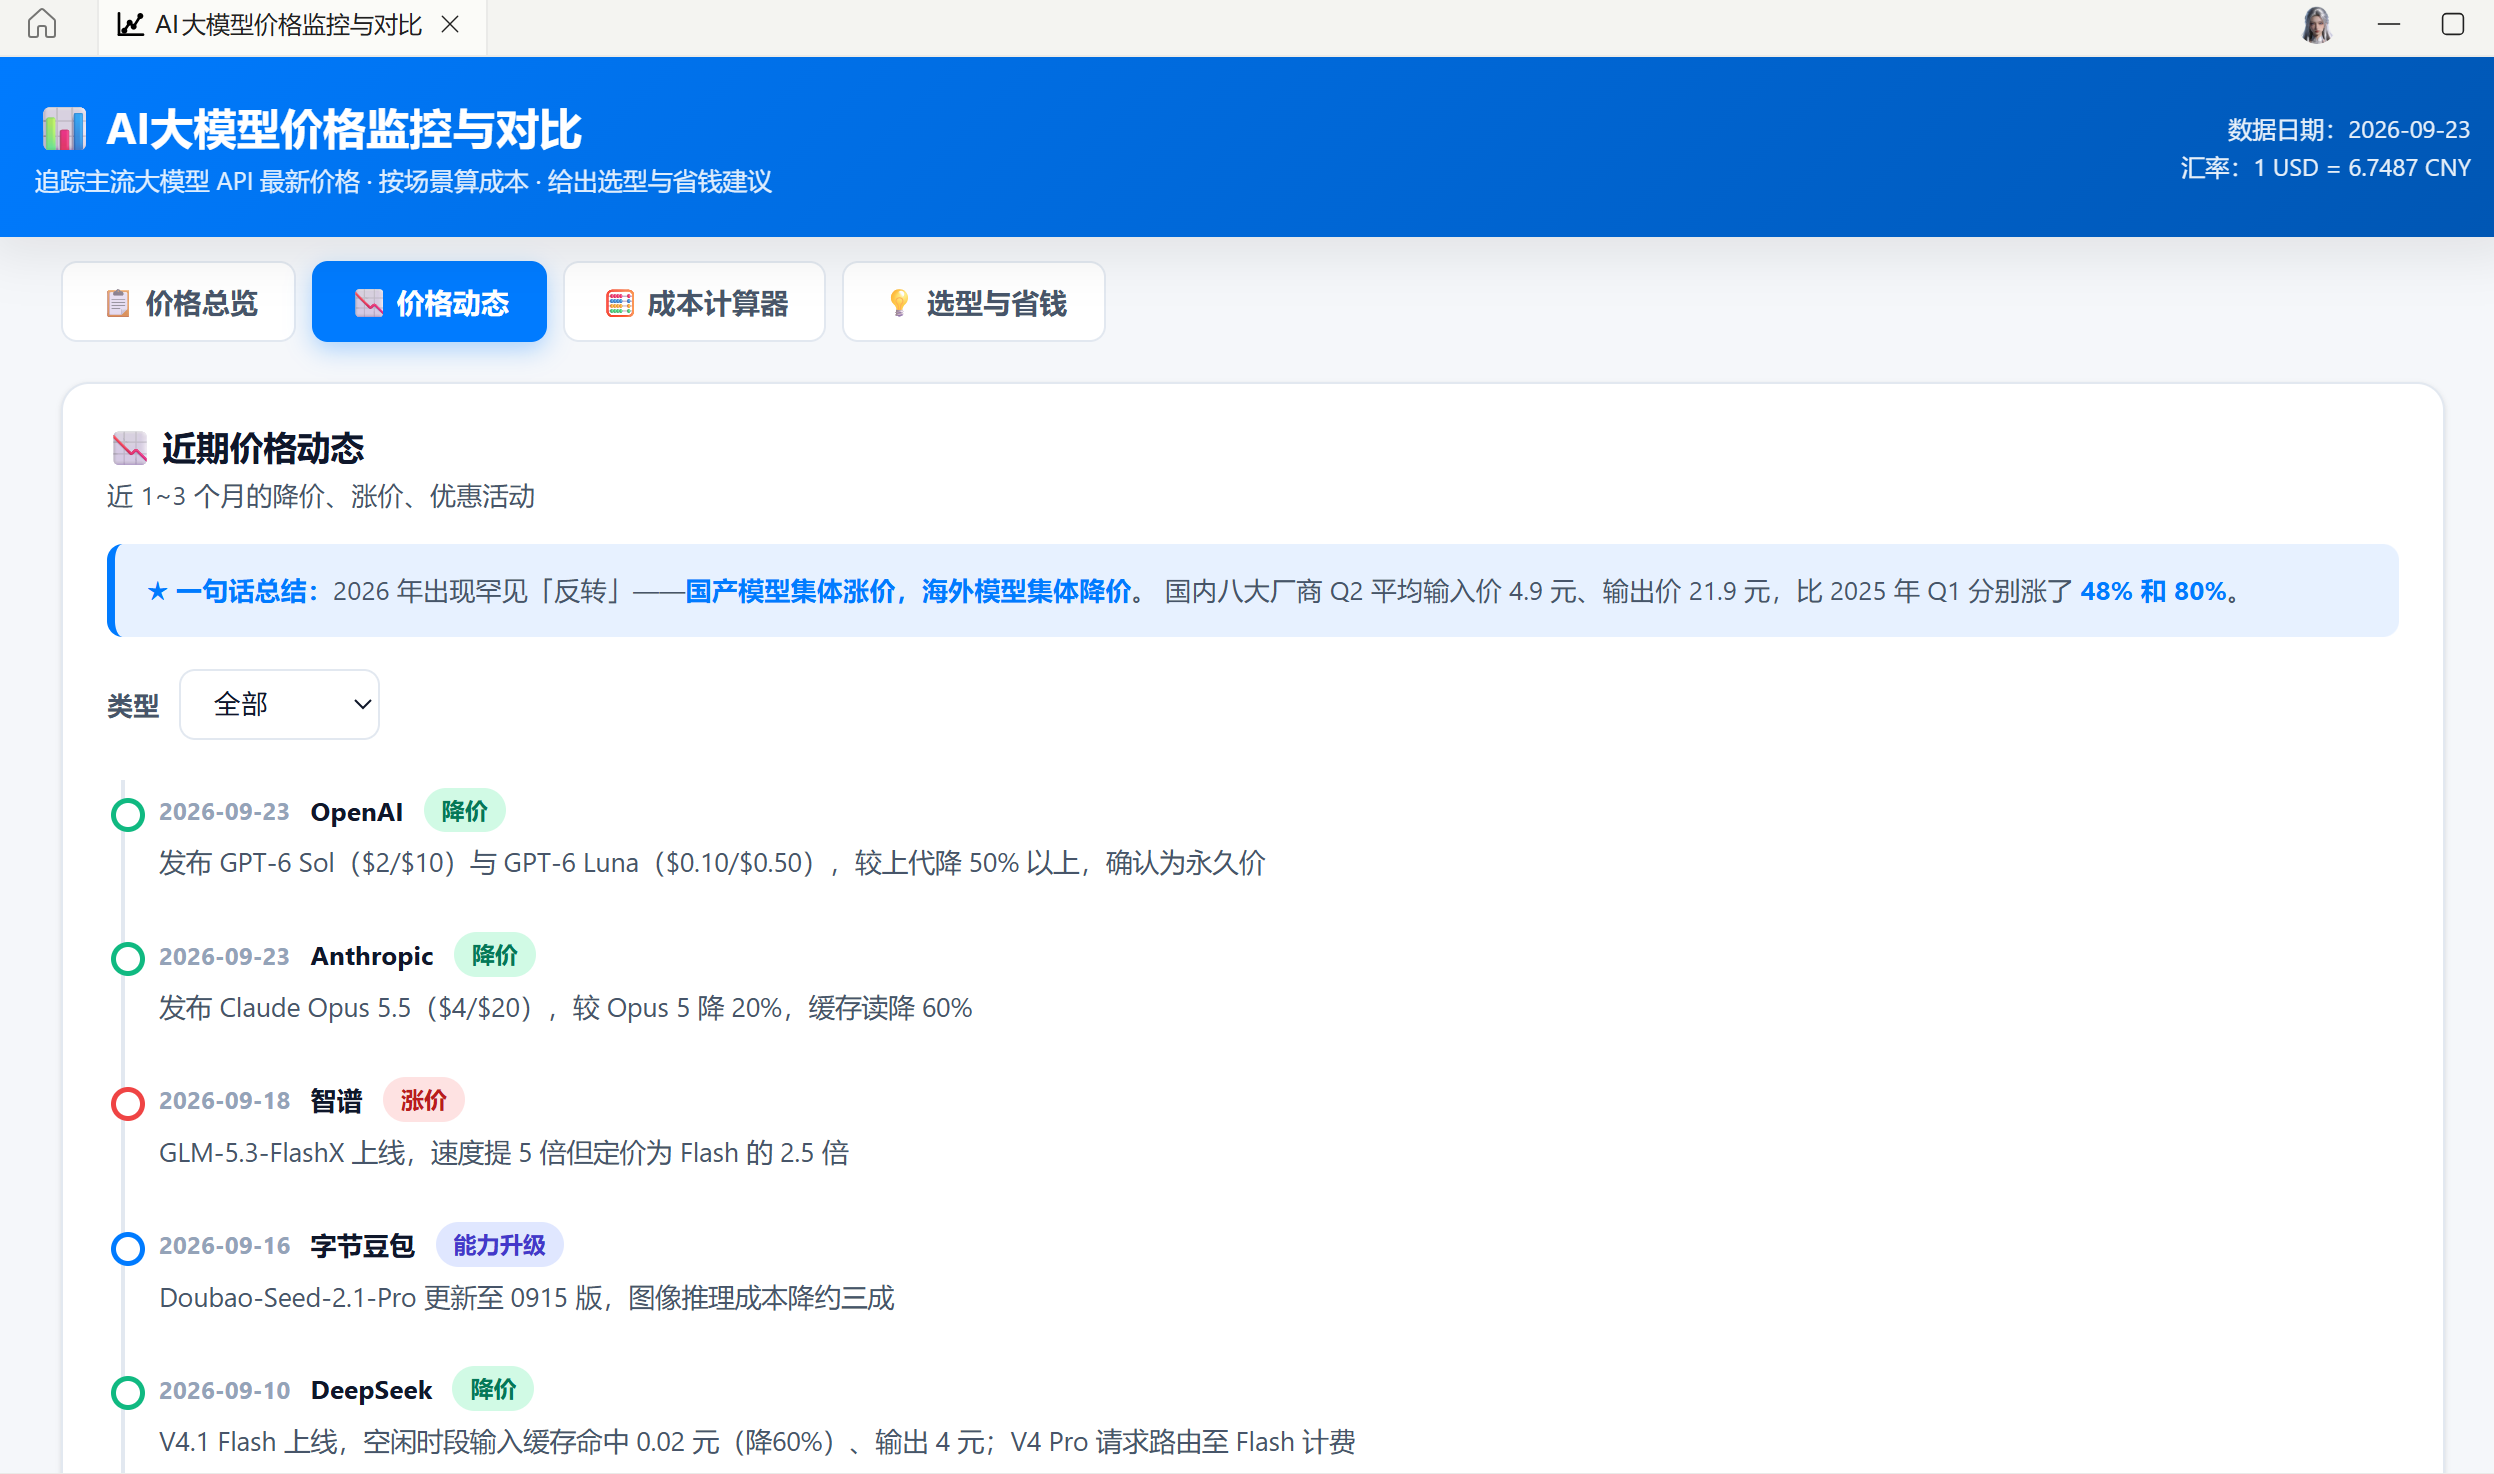
价格动态实时抓捕
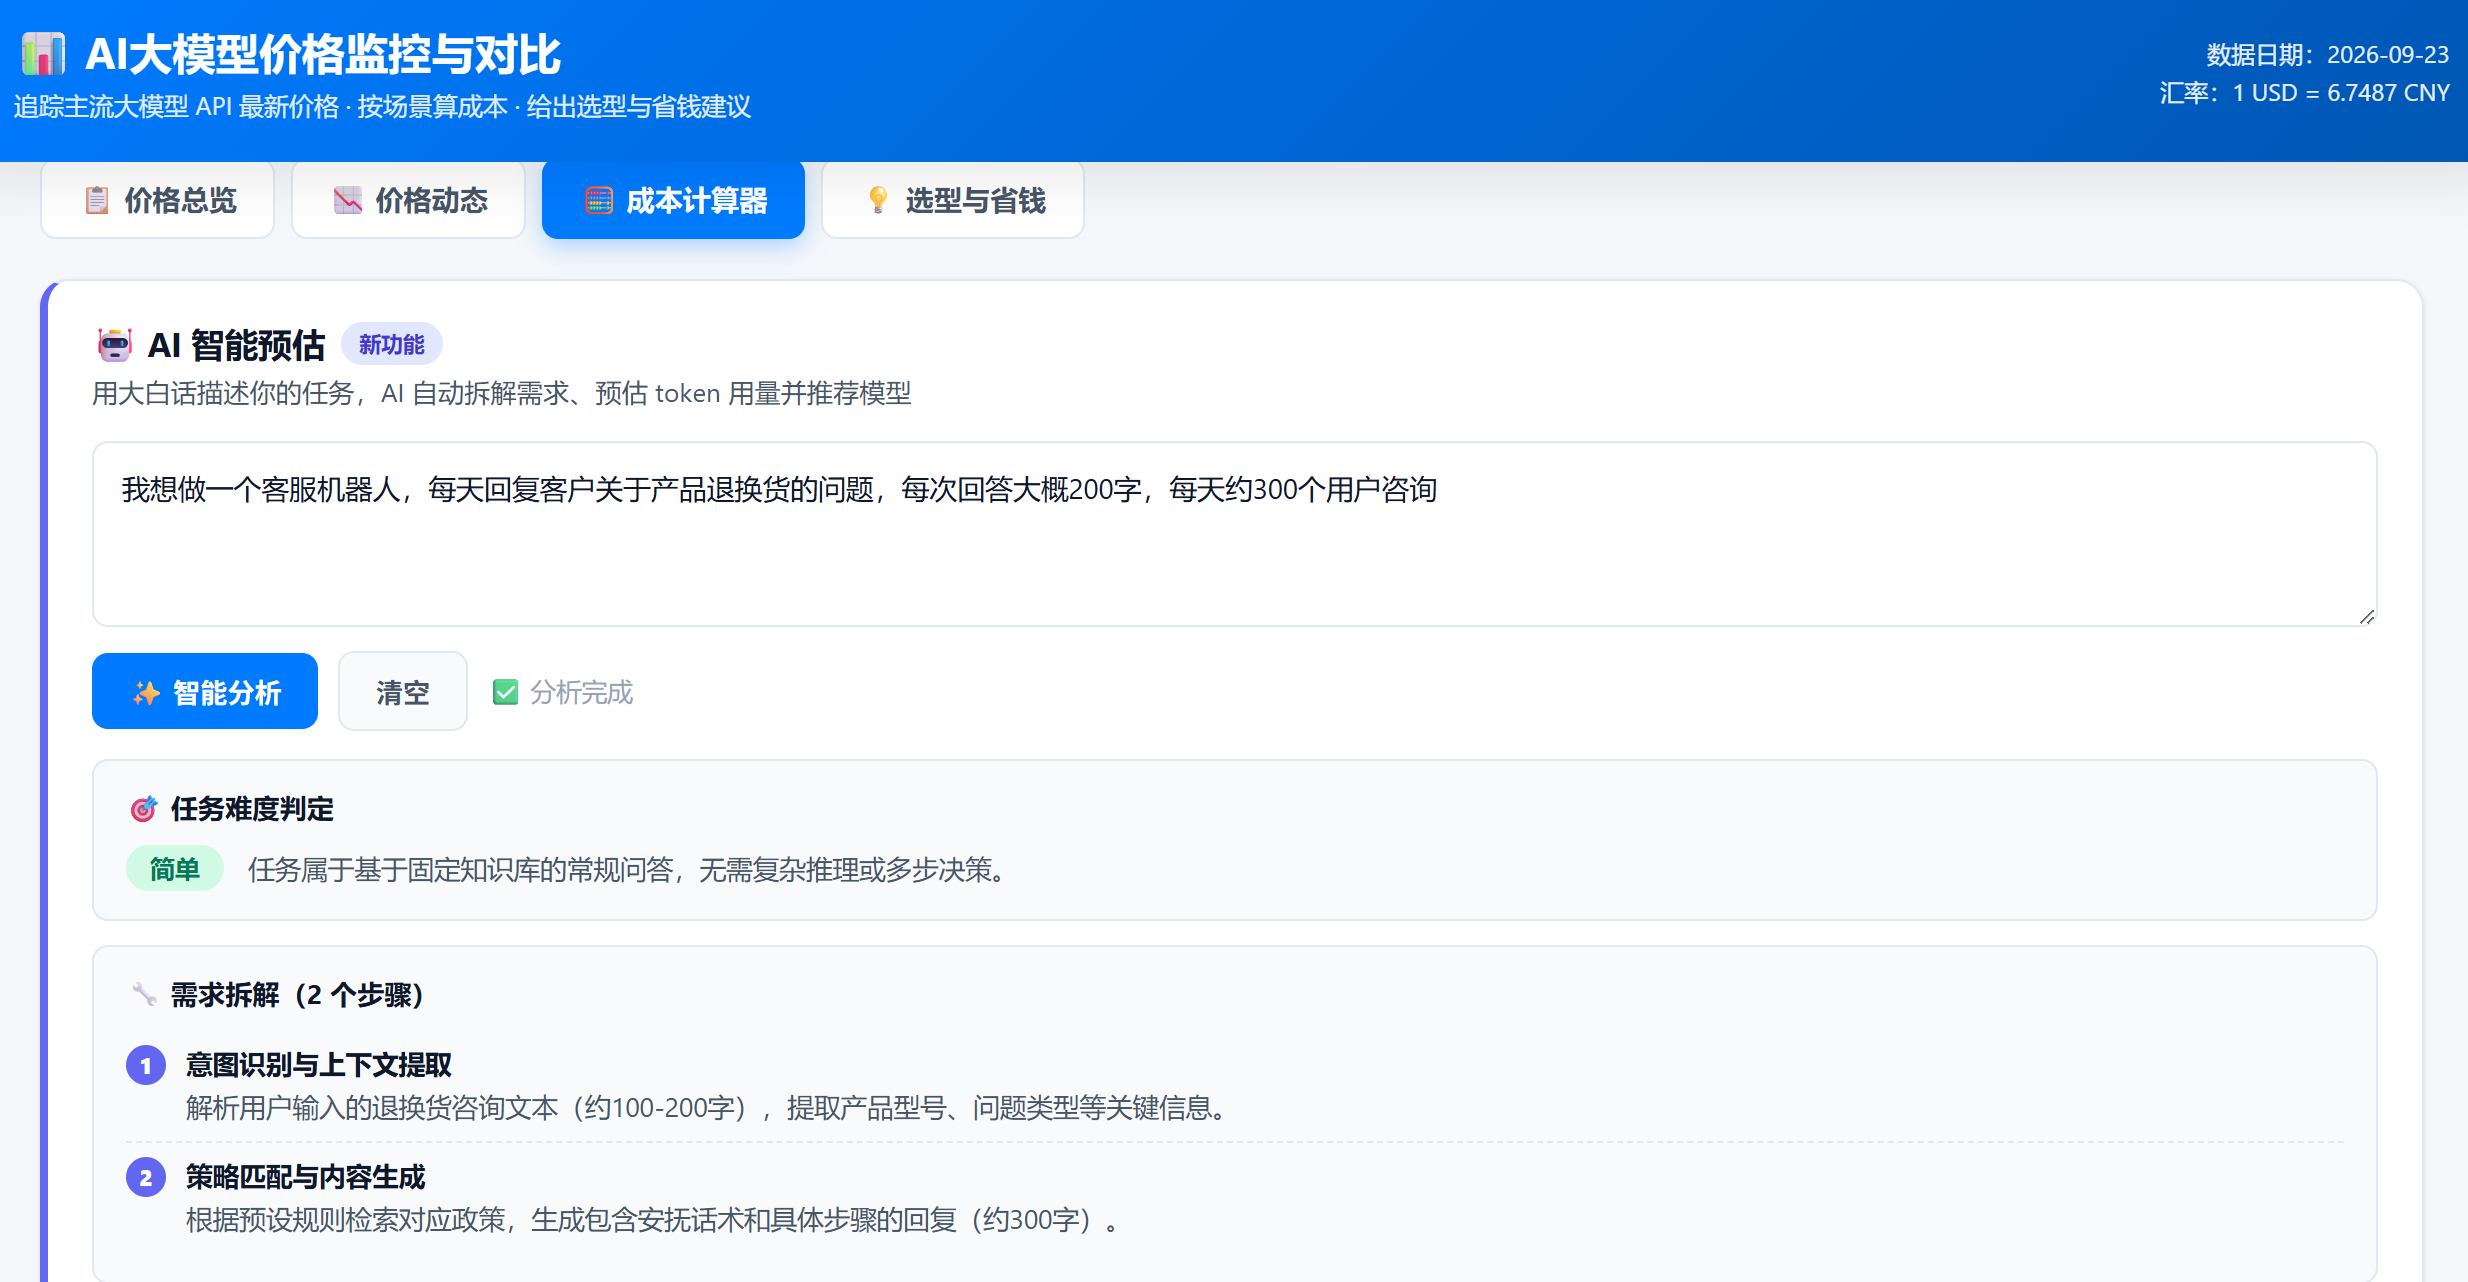
大白话提需求,它进行拆解和预测成本
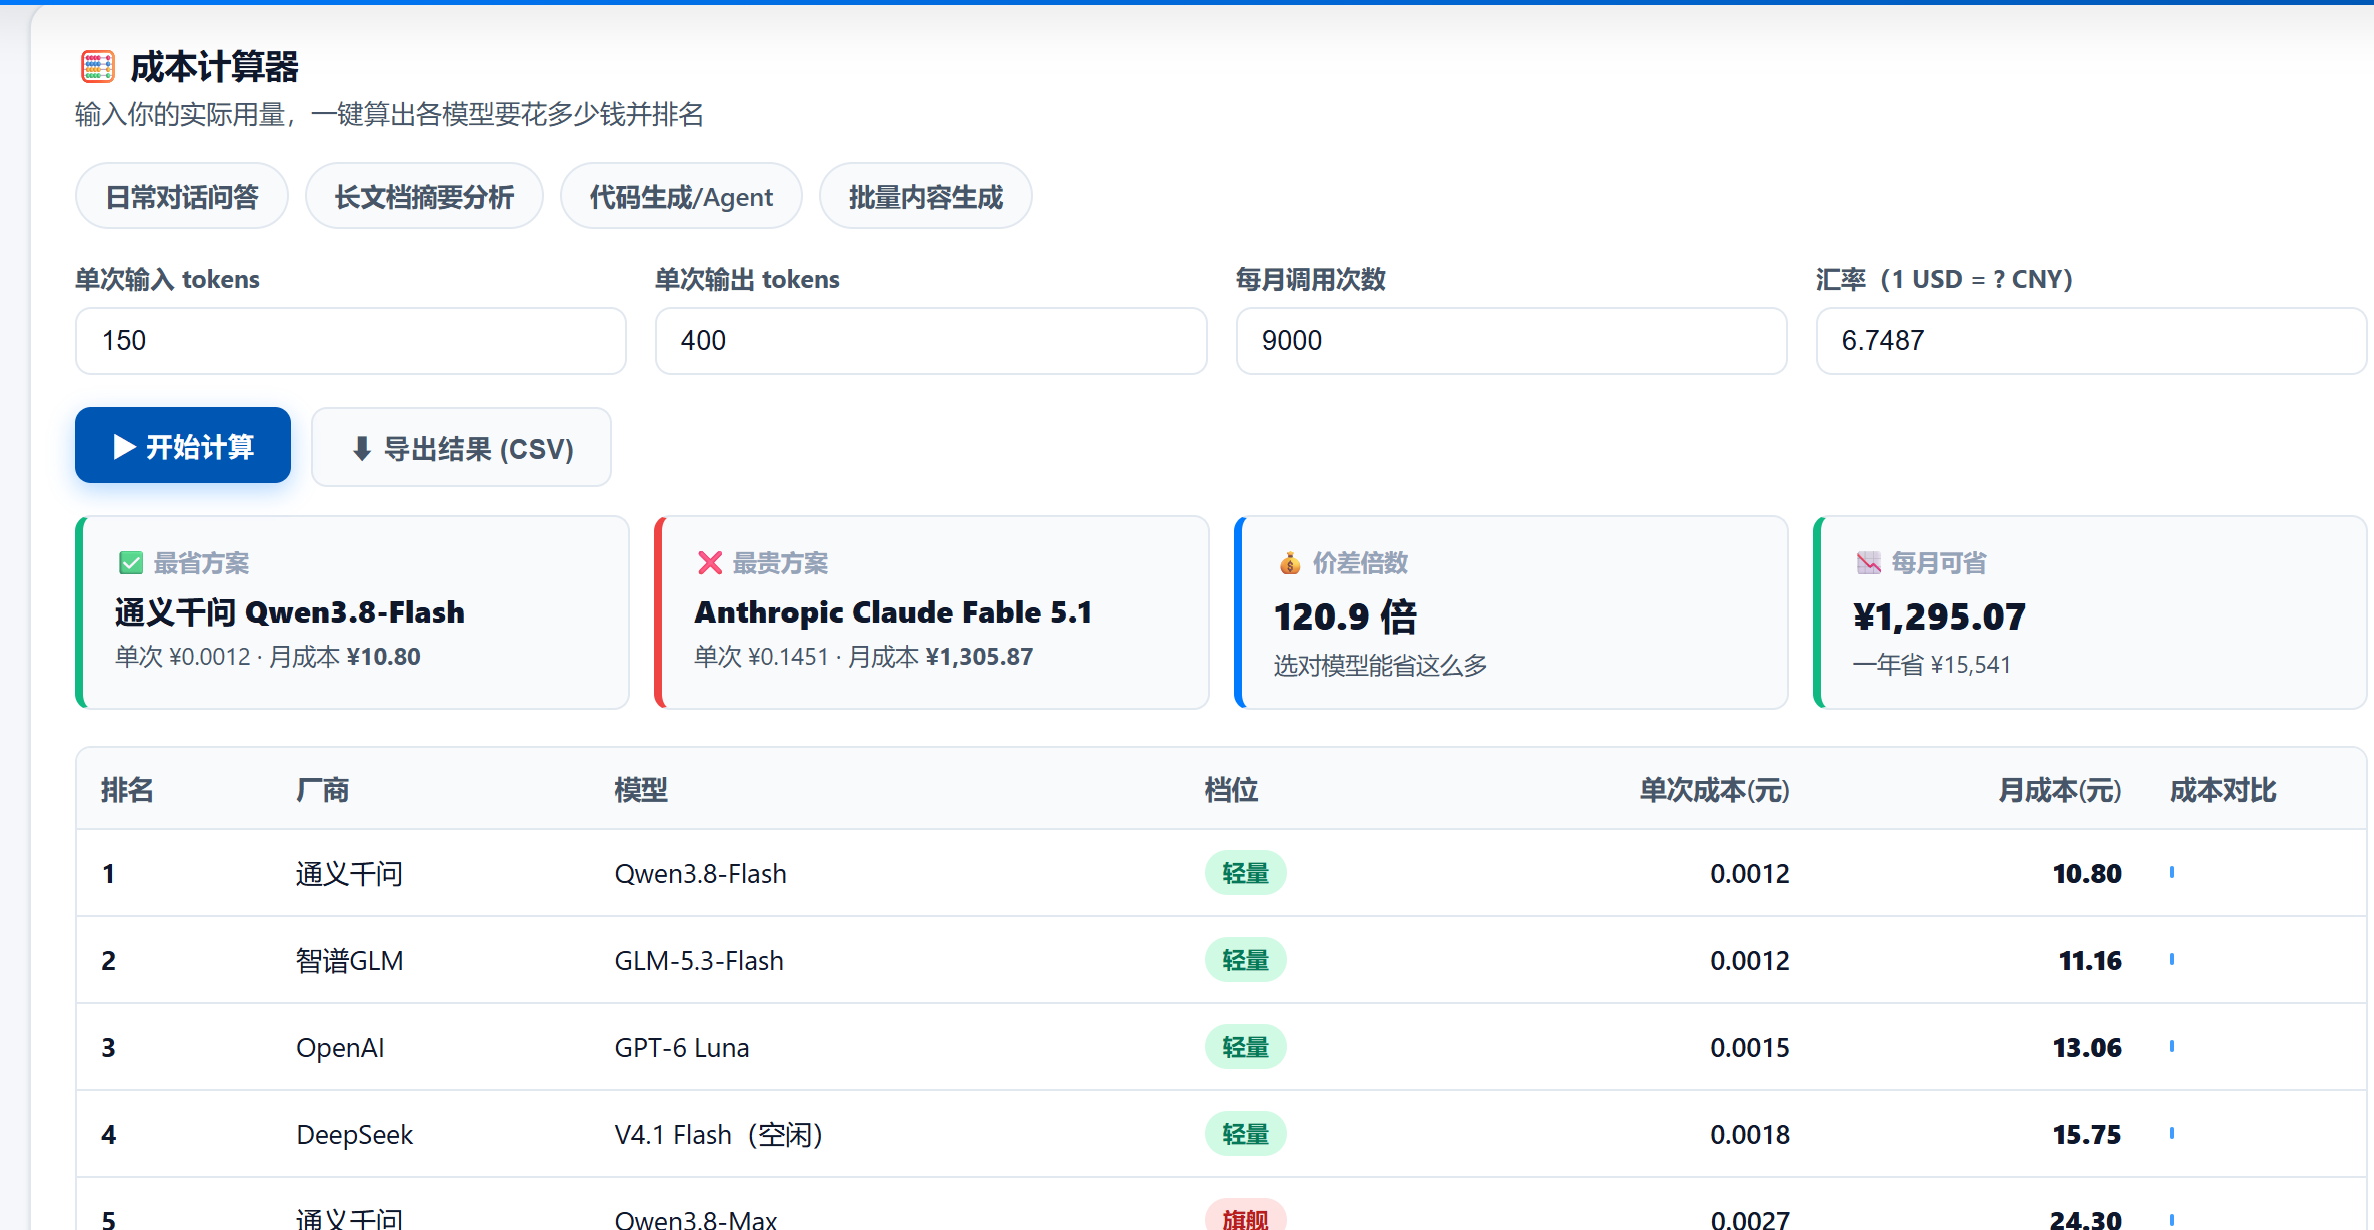
成本计算
二、为什么值得做?先看几个扎心的数字
2026 年的大模型行情,出现了一个罕见反转:
国产模型集体涨价,海外模型集体降价。 据机构统计,国内八大厂商 2026 年 Q2 平均 API 输入价 4.9 元/百万 token、输出价 21.9 元/百万 token,相比 2025 年 Q1 的 3.3 元和 12.2 元,分别上涨 48% 和 80%。而 OpenAI 刚发布的 GPT-6 Sol/Luna 直接砍半。 行情变得这么快,手动查价格表根本跟不上。更关键的是——选错模型,代价极大。 我按四个典型场景实测了一遍: | 场景 | 最省方案 | 月成本 | 最贵方案月成本 | 价差 | | ① 日常对话问答 | Qwen3.8-Flash | 21.5 元 | 2362 元 | 109.9 倍 | | ② 长文档摘要 | GPT-6 Luna | 40.5 元 | 4049 元 | 100.0 倍 | | ③ 代码生成/Agent | Qwen3.8-Flash | 75.2 元 | 8098 元 | 107.7 倍 | | ④ 批量内容生成 | Qwen3.8-Flash | 194 元 | 22946 元 | 118.3 倍 | 同样一个任务,选错模型贵 100 倍以上。 这就是做这个工具的理由。
三、5 分钟做出它:3 段 Prompt 直接抄
全程没写一行代码,就是把需求用大白话讲清楚。下面把我用的 Prompt 原样贴出来,你照着抄就能复现,自己也可以进行微调,但是一定要注意写成AiPy这些能听懂的话语。
第 1 步:让 AI 去查价格(1 分钟)
帮我查一下现在主流大模型 API 的最新价格,包括 OpenAI、Claude、Gemini,
还有国产的 DeepSeek、通义千问、豆包、Kimi、智谱,要输入价、输出价、
上下文长度,还要标注来源和日期。这句话的三个关键点:
- 划定范围——明确要哪些厂商
- 指定字段——输入价、输出价、上下文长度
- 要求可核实——必须标注来源和日期 AI 会自己拆成十几轮搜索,最后整理成结构化数据,每个价格都带来源。
第 2 步:让它算成本(1 分钟)
按四个典型场景算成本:
① 日常对话问答(输入 1K/输出 0.5K/月 1 万次)
② 长文档摘要(输入 50K/输出 2K/月 1 千次)
③ 代码生成 Agent(输入 20K/输出 8K/月 2 千次)
④ 批量内容生成(输入 2K/输出 3K/月 2 万次)
每个场景给我完整的排名表,标出最省、最贵、价差倍数和可节省金额。关键:把场景参数说清楚(输入多少、输出多少、调用多少次),不然 AI 只能瞎猜。明确要求"标出最省、最贵、价差倍数",结果才有对比价值。
第 3 步:让它做成工具(3 分钟)
把这个做成一个带界面的智能体,我要能点开就用。
要有价格总览表、价格动态时间线、成本计算器、选型建议四个部分。
AI 会自己把前后端全写好,包括界面、服务、数据文件,还自动装好。 到这里,一个能用的工具就出来了。
四、进阶:怎么让它"听懂人话"
工具做出来后我发现一个问题:我自己懂 token 是什么,但同事不懂啊。 于是我又提了个需求:
在成本计算器部分,给用户提供一个输入框,用户可以手动输入他的任务需求,
agent 通过分析任务难度、拆解需求和动作,自动预估需要的 tokens,
预估价格,然后给出选型建议。
这句话是整个项目的关键。我把要 AI 干的四件事说得很清楚:① 分析任务难度 ② 拆解需求和动作 ③ 预估 tokens ④ 给出选型建议。 AI 拿到需求后,在后台写了一段专门用来"教 AI 怎么分析任务"的提示词。这是整个功能的灵魂,我完整贴出来:
你是一位资深 AI 应用架构师。用户会描述一个他想用大模型完成的任务,
请你分析并预估 token 消耗。
1. 判定任务难度:简单 / 中等 / 复杂
   · 简单:分类、抽取、翻译、简单问答、格式化
   · 中等:写作、常规代码生成、知识问答、内容总结
   · 复杂:架构设计、多步推理、长链路 Agent、高价值决策分析
2. 把任务拆解成 2-5 个具体动作步骤,每个步骤说明大致要处理多少内容
3. 预估「单次任务」的输入 token 和输出 token(必须给出具体数字)
   · 参考基准:一句话问答约 1000 输入/500 输出;
     一篇 3000 字文档约 5000 输入;一份 50 页报告约 50000 输入
   · 输出 token 通常明显少于输入(除非是生成类任务)
4. 预估合理的「每月调用次数」(根据任务性质判断,
   比如客服机器人可能上万次,写报告可能几十次)
5. 给出选型建议:推荐 2-3 个模型(从轻量/均衡/旗舰中选),说明理由
【输出格式】必须严格返回 JSON,不要有任何其他文字、
不要用 markdown 代码块包裹:
{
  "difficulty": "简单|中等|复杂",
  "difficultyReason": "一句话说明为什么是这个难度",
  "steps": [{"name": "步骤名称", "detail": "这步做什么,大概处理多少内容"}],
  "inputTokens": 数字,
  "outputTokens": 数字,
  "monthlyCalls": 数字,
  "callsReason": "为什么预估这个调用次数",
  "recommendation": [{"tier": "轻量|均衡|旗舰", "model": "模型名", "reason": "推荐理由"}],
  "savingTip": "一条针对该任务的省钱建议"
}
这段 Prompt 有三个设计巧思,值得学:
- 给了参考基准——"3000 字文档约 5000 输入",让 AI 有锚点,不会瞎猜
- 强制返回 JSON——这样程序才能解析,不会返回一堆废话
- 明确说"不要用 markdown 代码块包裹"——这是踩过坑才知道的,AI 特别爱加
json
实测效果
我输入:"我想做一个客服机器人,每天回复客户关于产品退换货的问题,每次回答大概 200 字,每天约 300 个用户咨询" AI 直接返回:
- 任务难度:简单(基于固定知识库的常规问答,无需复杂推理)
- 需求拆解:① 意图识别与上下文提取 ② 策略匹配与内容生成
- Token 预估:单次输入 150、输出 400,月调用 9000 次
- 选型建议:推荐 3 个模型,分轻量/均衡/旗舰三档
- 省钱提示:把退换货政策预设为 System Prompt,可显著减少输入 token 然后点「带入成本计算器」,排名立刻出来——最省 10.8 元/月,最贵 1305.87 元/月,差 120.9 倍。 从"描述任务"到"看到完整成本排名",全程只点了两下。
五、避坑指南:我踩过的 3 个坑
坑 1:AI 返回的内容带 ```json 包裹,程序解析不了
虽然提示词里说了"不要包裹",但 AI 有时还是会加。
解决办法:在代码里做容错——先去掉首尾的 ``` 标记,再截取第一个 { 到最后一个 } 之间的内容。双保险。
坑 2:AI 预估的数字偶尔离谱
比如把月调用次数估成 0 或者负数。 解决办法:加一层字段校验和兜底。如果数字不合法,就用默认值(输入 2000、输出 1000、月调用 1000)。宁可给个保守值,也不能让程序崩掉。
坑 3:中文引号导致代码报错
生成报告时,文案里有个中文引号,直接把字符串搞崩了。这种小坑特别隐蔽。 解决办法:生成内容时统一用英文引号,或者做好转义。
六、我做的 4 处微调
这些微调都是在用的过程中发现"不太顺手",然后跟 AI 说一句"帮我加个 XX 功能"就改好了:
- 加了"带入成本计算器"按钮——AI 预估完 token 后,一键填进下方计算器,不用手动抄数字
- 加了实时联动——改任何一个输入框,排名表立刻刷新,不用反复点"计算"
- 加了 CSV 导出——算完能直接导出来给财务看
- 加了深色模式自适应——跟随主题自动切换
七、省钱心得:3 条最实用的
做完这个工具,我自己也摸出了几条门道:
1. 按难度分层用模型
- 简单任务用轻量(Qwen3.8-Flash / GLM-5.3-Flash)
- 中等用均衡(GPT-6 Sol / Claude Sonnet 5)
- 复杂才用旗舰(GPT-6 Astra / Claude Opus 5.5) 把 80% 的简单请求从旗舰切到轻量,账单能降 70%~90%。
2. 中文任务优先国产模型
Qwen3.8-Flash(0.8 元/2.7 元)比 Claude Sonnet 5(约 13.5 元/67.5 元)便宜约 17~25 倍,中文理解还更贴合。
3. 薅缓存
DeepSeek 缓存命中价 0.02 元/百万 token,是未命中价的 1/50。把固定的 System Prompt、知识库放在请求前缀,成本骤降。 还有几条:利用峰谷时段(DeepSeek 周末全天按空闲价,批量任务挪到周末省一半)、用批量接口(Kimi Batch 只要 60%)、长文档先摘要再喂贵模型、严格控制输出长度(输出通常比输入贵 3~5 倍)。
八、选型速查表
你的需求 | 推荐模型 | 理由 |
|---|---|---|
日常客服/问答机器人 | Qwen3.8-Flash | 月成本仅 21.5 元,中文好 |
高频批量内容生成 | Qwen3.8-Flash / GLM-5.3-Flash | 单价最低,输出便宜 |
长文档摘要/信息抽取 | GPT-6 Luna | 长输入场景全球最省 |
中等难度代码生成 | GPT-6 Sol / Claude Sonnet 5 | 能力与成本平衡点 |
复杂 Agent / 多步推理 | Claude Opus 5.5 | 能力强,缓存读便宜 95% |
最难的科研/高价值决策 | GPT-6 Astra | 能力天花板,但很贵 |
超长上下文(百万级) | Qwen3.8-Max / Kimi K3 | 1M 上下文,国产更划算 |
预算极紧的初创团队 | DeepSeek V4.1 Flash | 闲时 1元/4元,周末更省 |
需要极快响应速度 | GLM-5.3-FlashX | 200 tokens/s,速度优先 |
九、最后说两句
整个过程我一行代码都没写,就是把需求用大白话讲清楚。 回头看,最关键的其实是把需求说清楚。你看我上面那几段 Prompt,都是"要什么、要哪些字段、要什么格式",说得越具体,AiPy这些AI做得越准。
如果你对AiPy比较感兴趣,可以尝试填写我的邀请码ddR5,有free额度 如果你也在为 AI 成本头疼,或者想知道自己那个任务到底该用哪个模型,真心建议试试。 毕竟选对模型,一年能省好几万。
数据说明:本文价格数据更新于 2026-09-23,汇率按 1 USD = 6.7487 CNY 折算。价格以各厂商官网/官方公告为准,实际账单还受缓存命中、峰谷时段、长上下文加价、批量折扣影响,本文按标准价口径测算,属保守估算。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号