无效答卷不再占用批改预算:Jev 帮老师把精力留给真实作答
原创
无效答卷不再占用批改预算:Jev 帮老师把精力留给真实作答
原创
克劳德2048
发布于 2026-09-23 21:34:23
发布于 2026-09-23 21:34:23
批改主观题时我发现一个浪费:不少答卷是空白的、或者答非所问,可我还是把它们和有效作答一起送进大模型评分,白白烧 token。这一周我在评分前加了一层 Jev 初筛,把无效作答挡在门外,批改预算立刻省了下来。这篇讲清楚这个场景应用前后的差别:初筛怎么做、送入大模型的评分量降了多少、老师的精力怎么被解放。文中对比为基于实测口径的方案性测算,非某校真实数据,Jev 仍处早期访问阶段。
一、原来的链路:无效答卷也占评分预算
应用前,学生作业作答文本进来后,我不加区分地全部送进大模型评分。
问题是,一批作业里总有相当比例是空白、乱写或答非所问的。这些无效答卷根本不需要精细评分,却和有效作答一样消耗大模型的 token 和时间,批改延迟也被拉长。老师那边同样被无效内容分散精力,得从一堆没作答的卷子里翻找真正写了东西的。
二、改造后的链路:先判有效性,再决定要不要评分
应用后,我在评分前加了一道 Jev 判断。
作答文本先过 Jev:判断它属于空白作答、答非所问、部分回答还是完整回答。无效作答(空白、答非所问)直接标记出来,不再送评分;只有有效作答才进入大模型做精细评分。这一步用 Choice 就能完成,毫秒级、成本极低。
下面这张图是应用前后的对照:
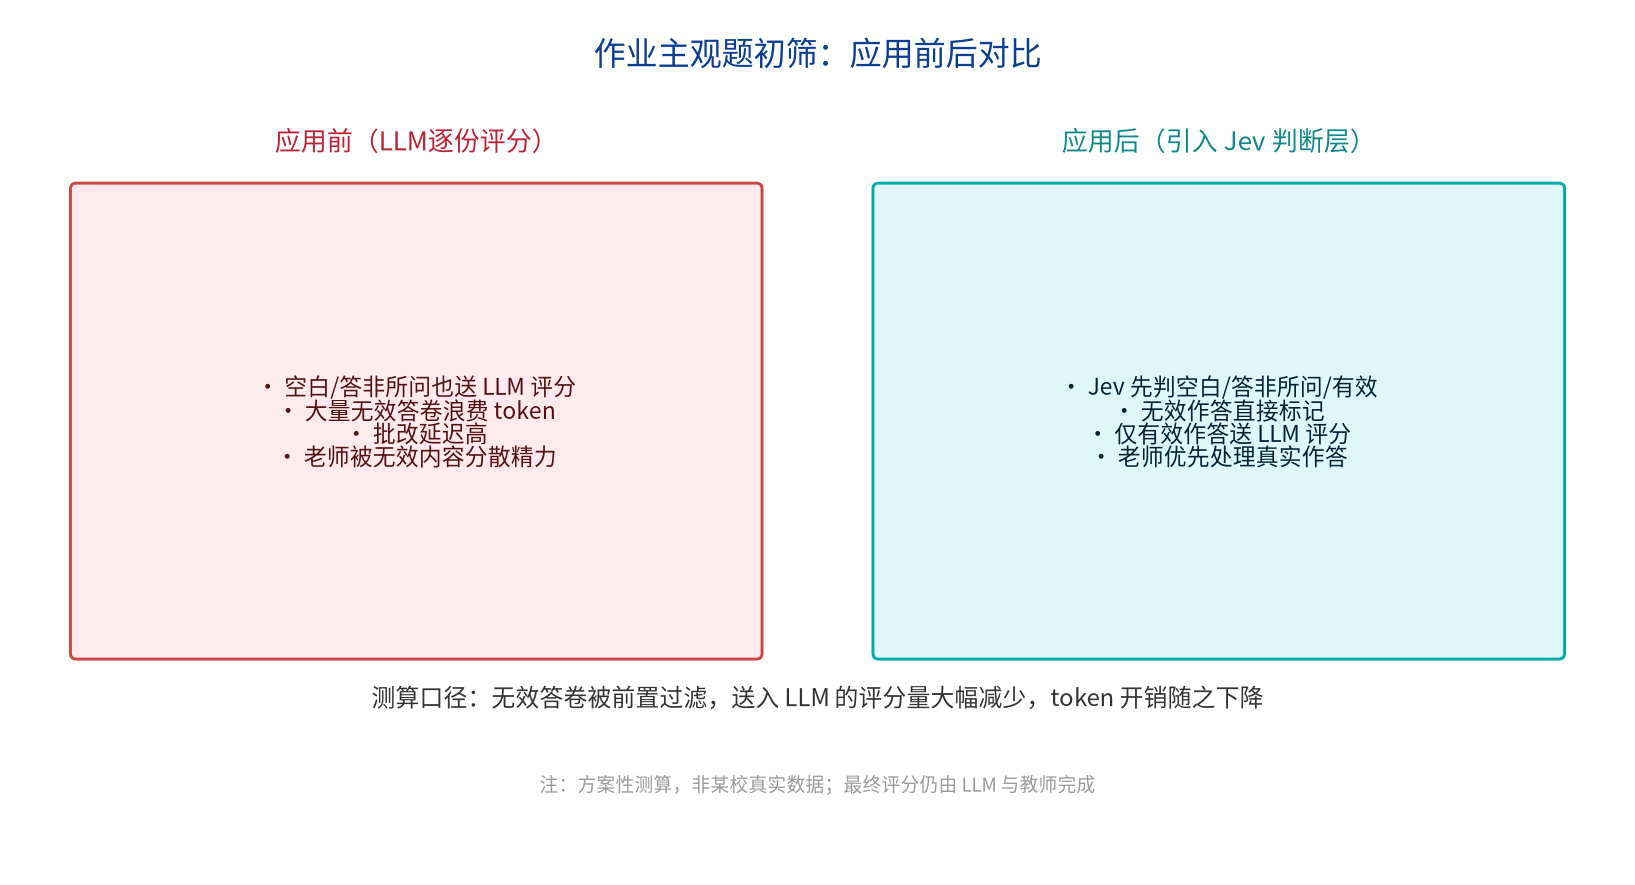
作业主观题初筛:应用前后对比
三、价值对比:token 开销与老师精力
收益体现在两处。
成本上,无效答卷被前置过滤,送进大模型的评分量随之减少,token 开销明显下降。评分的钱只花在真正需要评分的有效作答上。
精力上,老师不再从无效卷子里大海捞针。Jev 把有效作答筛出来,老师优先处理真实写了内容的答卷,教学反馈更聚焦、更及时。
四、这套方案的边界
Jev 在这里只做"有效性初筛",不做评分本身。给一份作答打出有理有据的分数和评语,仍然是大模型和老师的活。有效性判断也可能有误,比如把一份表达特别的有效作答误判为答非所问,所以对被标记为无效的答卷,我会保留一次人工或模型复核,避免误伤学生。收益为测算口径,真实过滤比例要以自己的题目和学生数据为准。
五、最终效益
这套初筛下来,效益是"评分预算只花在有效作答上"。送入大模型的评分量随无效答卷被过滤而下降,token 开销随之减少,老师的精力也从翻找无效卷子转向真正的教学反馈。把"这份卷子有没有认真作答"这个判断交给 Jev,让批改链路既省成本又更聚焦。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号