DocLayout-YOLO:页面轴注意力 + 百万级合成预训练,让 YOLO 读懂文档版面
原创
DocLayout-YOLO:页面轴注意力 + 百万级合成预训练,让 YOLO 读懂文档版面
原创
AI小怪兽
发布于 2026-10-29 15:30:55
发布于 2026-10-29 15:30:55
论文解读 | DocLayout-YOLO:页面轴注意力 + 百万级合成预训练,让 YOLO 读懂文档版面
论文:DocLayout-YOLO: Axis-Attentive Document Layout Detector with Mesh-Guided Synthetic Pretraining 题目译名:《DocLayout-YOLO:轴感知文档版面检测器与网格引导的合成预训练》
作者:Zhiyuan Zhao, Hengrui Kang, Guang Liang, Bin Wang, Conghui He(上海人工智能实验室)
博主简介
AI小怪兽 | 计算机视觉布道者 | 视觉检测领域创新者
深耕计算机视觉与深度学习领域,专注于目标检测前沿技术的探索与突破。长期致力于YOLO系列算法的结构性创新、性能极限优化与工业级落地实践,旨在打通从学术研究到产业应用的最后一公里。
🚀 核心专长与技术创新
- YOLO算法结构性创新:于CSDN平台原创发布《YOLOv13魔术师》、《YOLOv12魔术师》等全系列深度专栏。系统性提出并开源了多项原创自研模块,在模型轻量化设计、多维度注意力机制融合、特征金字塔重构等关键方向完成了一系列突破性实践,为行业提供了具备高参考价值的技术路径与完整解决方案。
- 技术生态建设与知识传播:独立运营 “计算机视觉大作战” 公众号(粉丝1.6万),成功构建高质量的技术交流社群。致力于将复杂算法转化为通俗易懂的解读与可复现的工程代码,显著降低了计算机视觉的技术入门门槛。
🏆 行业影响力与商业实践
- 荣获腾讯云年度影响力作者与创作之星奖项,内容质量与专业性获行业权威平台认证。
- 全网累计拥有 7万+ 垂直领域技术受众,专栏文章总阅读量突破百万,在目标检测领域形成了广泛的学术与工业影响力。
- 具备丰富的企业级项目交付经验,曾为工业视觉检测、智慧城市安防等多个关键领域提供定制化的算法模型与解决方案,驱动业务智能化升级。
💡 未来方向与使命
秉持 “让每一行代码都有温度” 的技术理念,未来将持续聚焦于实时检测、语义分割及工业缺陷检测的商业化闭环等核心方向。愿与业界同仁协同创新,共同推动技术边界,以坚实的技术能力赋能实体经济与行业变革。
一、摘要
文档版面分析(DLA)对现代文档解析系统至关重要。尽管 YOLO 是实时检测器的主流范式,但它在异构文档上的适配仍待探索。为此,我们提出 DocLayout-YOLO——一个文档专用的实时检测器,融合了多样化的合成文档预训练与页面轴上下文建模。
- 数据视角:提出 MeshLayout-1M,用提出的 Mesh-candidate BestFit 算法生成的合成预训练语料,提供大规模、多样化的文档版面,提升对异构文档场景的适配。
- 模型视角:提出 页面轴版面注意力(PALA),沿水平与垂直页面轴捕获长程依赖,同时保持计算高效。
实验表明,DocLayout-YOLO 在四个异构文档基准上达到 SOTA,于 D4LA、M6Doc、HJDataset、PRIMA-LAD 分别取得 72.4% / 75.5% / 96.0% / 73.1% 的 mAP50:95,并以更优的精度—效率权衡超越现有实时检测器。代码、模型与数据均已开源。
二、研究背景和意义
2.1 文档解析时代,版面分析是被低估的"地基"
随着 LLM 与 RAG 的爆发,对高质量结构化文档数据的需求暴涨。而 DLA 要做的,正是定位并分类文本、表格、图等语义区域——它是文档解析与理解的"地基"。地基不稳,上层问答与抽取全都会偏。
一张图看懂"异构文档"有多难:下面这张来自 M6Doc 评测集的样例,单页里同时塞进了多语种正文、跨栏标题、嵌套表格、公式与配图——版面元素在尺度、密度、语言上极度异构,这正是通用检测器在文档上"翻车"的根源。
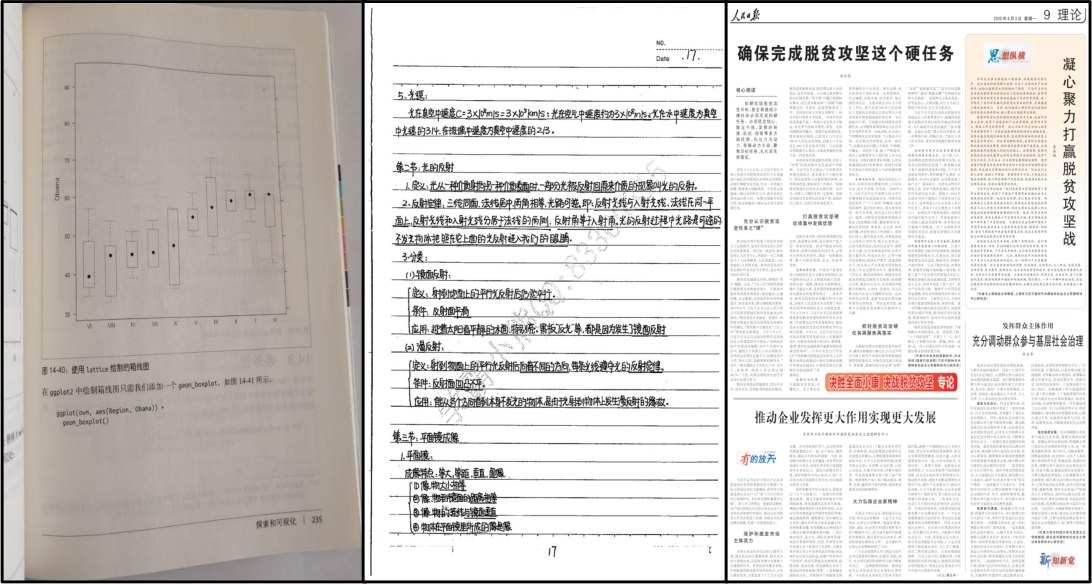
图 1:M6Doc 评测集样例,展示文档版面的强异构性
2.2 现有方法的瓶颈
- 数据两难:现有数据集在"规模 / 版面多样性 / 标注质量 / 成本"上难兼得;人工标注细粒度版面昂贵;已有生成方法多聚焦学术式版面,撑不起多样化文档域预训练。
- 结构建模缺位:文档版面存在强长程依赖——文本行、段落栏、表格网格、图文对之间跨页关联。卷积式 YOLO 缺乏显式机制;YOLOv12 引入的 Area Attention 面向通用视觉建模,并未利用文档"横平竖直"的组织方式。
2.3 研究意义
把"实时 + 高精度 + 轻量"三者第一次统一到文档场景,且仅靠视觉输入就超过多模态方法——这为工业级文档理解大幅降本,也是 YOLO 玩家最容易吃到的领域红利。
三、创新点
- MeshLayout-1M(Mesh-candidate BestFit 合成算法):基于二维装箱(Bin-packing)的 100 万页合成预训练语料,11 类元素、1450 万实例、自动标注。
- PALA(Page-Axis Layout Attention,页面轴版面注意力):替换 YOLOv12 的 Area Attention,沿页面横纵两轴做高效长程建模。
- DocLayout-YOLO 整体:合成预训练 + 轴注意力融合,建立实时 DLA 的 SOTA 与最佳精度—效率权衡。
核心源码:
# doclayout_yolo_core_improvements.py
# DocLayout-YOLO (release-v2) 核心改进模块整理
# 主要包含: PALA (Page-Axis Layout Attention) 与 GL-CRM
# 说明: 以下代码基于论文描述、官方仓库结构及公开技术博客整理,
#       旨在展示核心设计逻辑,具体实现请以官方 release-v2 代码为准。

import torch
import torch.nn as nn
import torch.nn.functional as F


# ============================================================
# 1. Page-Axis Layout Attention (PALA)
# ============================================================
class PALA(nn.Module):
    """
    Page-Axis Layout Attention.
    论文描述: 沿文档页面的水平轴与垂直轴捕获长距离依赖,
    同时保持计算效率。保留了与 Area Attention 相同的特征投影
    与位置编码,但通过更高效的轴式聚合降低延迟。
    参考: release-v2 README 中 "Page-Axis Layout Attention (PALA),
    which captures long-range dependencies along the horizontal
    and vertical page axes"[reference:0]。
    """
    def __init__(self, dim, num_heads=8, qkv_bias=False, attn_drop=0., proj_drop=0.):
        super().__init__()
        self.num_heads = num_heads
        self.dim = dim
        head_dim = dim // num_heads
        self.scale = head_dim ** -0.5

        # 与 Area Attention 保持一致的特征投影
        self.qkv = nn.Linear(dim, dim * 3, bias=qkv_bias)
        self.attn_drop = nn.Dropout(attn_drop)
        self.proj = nn.Linear(dim, dim)
        self.proj_drop = nn.Dropout(proj_drop)

        # 可学习的位置编码 (与 Area Attention 一致)
        self.pos_embed = nn.Parameter(torch.zeros(1, dim))

    def forward(self, x):
        """
        x: (B, N, C) 其中 N = H * W
        """
        B, N, C = x.shape
        # 假设输入是展平的二维特征图,尝试推断 H, W
        # 实际实现中通常由调用方传入 H, W 或通过 shape 维护
        # 这里使用简单的方形假设进行演示,实际请根据特征图尺寸调整
        H = W = int(N ** 0.5)
        if H * W != N:
            # 如果不是完美方形,回退到 Area Attention 的通用处理
            # 或需要外部传入 H, W
            raise ValueError("PALA 需要方形特征图或显式的 H, W 输入")

        qkv = self.qkv(x + self.pos_embed).reshape(B, N, 3, self.num_heads, C // self.num_heads).permute(2, 0, 3, 1, 4)
        q, k, v = qkv[0], qkv[1], qkv[2]  # (B, heads, N, head_dim)

        # 重塑为二维空间 (B, heads, H, W, head_dim)
        q = q.reshape(B, self.num_heads, H, W, -1)
        k = k.reshape(B, self.num_heads, H, W, -1)
        v = v.reshape(B, self.num_heads, H, W, -1)

        # --- 水平轴注意力 ---
        # 对每一行进行注意力聚合 (沿宽度轴)
        q_h = q.permute(0, 1, 2, 4, 3)  # (B, heads, H, head_dim, W)
        k_h = k.permute(0, 1, 2, 4, 3)
        v_h = v.permute(0, 1, 2, 4, 3)
        attn_h = (q_h @ k_h.transpose(-1, -2)) * self.scale
        attn_h = attn_h.softmax(dim=-1)
        attn_h = self.attn_drop(attn_h)
        out_h = (attn_h @ v_h).permute(0, 1, 2, 4, 3)  # 回到 (B, heads, H, W, head_dim)

        # --- 垂直轴注意力 ---
        # 对每一列进行注意力聚合 (沿高度轴)
        q_v = q.permute(0, 1, 3, 4, 2)  # (B, heads, W, head_dim, H)
        k_v = k.permute(0, 1, 3, 4, 2)
        v_v = v.permute(0, 1, 3, 4, 2)
        attn_v = (q_v @ k_v.transpose(-1, -2)) * self.scale
        attn_v = attn_v.softmax(dim=-1)
        attn_v = self.attn_drop(attn_v)
        out_v = (attn_v @ v_v).permute(0, 1, 4, 2, 3)  # 回到 (B, heads, H, W, head_dim)

        # 融合双轴信息
        out = out_h + out_v
        out = out.reshape(B, self.num_heads, N, -1).permute(0, 2, 1, 3).reshape(B, N, C)
        out = self.proj(out)
        out = self.proj_drop(out)
        return out


# ============================================================
# 2. GL-CRM (Global-to-Local Controllable Receptive Module)
# ============================================================
class CRM(nn.Module):
    """
    可控感受野模块 (Controllable Receptive Module).
    通过不同膨胀率的卷积捕获多尺度上下文。
    """
    def __init__(self, channels, dilation_rates=(1, 2, 3)):
        super().__init__()
        self.branches = nn.ModuleList()
        for rate in dilation_rates:
            self.branches.append(
                nn.Conv2d(
                    channels, channels, kernel_size=3,
                    padding=rate, dilation=rate, groups=channels, bias=False
                )
            )
        self.fuse = nn.Conv2d(channels * len(dilation_rates), channels, kernel_size=1)

    def forward(self, x):
        outs = [branch(x) for branch in self.branches]
        out = torch.cat(outs, dim=1)
        return self.fuse(out)


class GLCRM(nn.Module):
    """
    全局到局部可控感受野模块 (Global-to-Local Controllable Receptive Module).
    作为标准 CSP 瓶颈的替代,更好地处理文档元素的多尺度变化。
    参考: 官方博客指出 "GL-CRM 模块作为标准 CSP 瓶颈的替代",
          "包括可控感受野模块 (CRM) 和全局到局部设计 (GL)"。
    """
    def __init__(self, c1, c2, n=1, shortcut=True, g=1, e=0.5):
        super().__init__()
        c_ = int(c2 * e)  # 隐藏通道数
        self.cv1 = nn.Conv2d(c1, c_, 1, 1)
        self.cv2 = nn.Conv2d(c1, c_, 1, 1)
        self.cv3 = nn.Conv2d(c_, c_, 1, 1)
        self.cv4 = nn.Conv2d(c_, c2, 1, 1)

        # 局部分支: 使用 CRM 进行多尺度特征提取
        self.local_branch = nn.Sequential(
            *[CRM(c_) for _ in range(n)]
        )

        # 全局分支: 简单的全局上下文 (可通过池化或大核卷积实现)
        self.global_branch = nn.Sequential(
            nn.AdaptiveAvgPool2d(1),
            nn.Conv2d(c_, c_, 1, bias=False),
            nn.SiLU(),
            nn.Conv2d(c_, c_, 1, bias=False)
        )

        self.shortcut = shortcut and c1 == c2

    def forward(self, x):
        y1 = self.cv1(x)  # 分支1
        y2 = self.cv2(x)  # 分支2

        # 局部多尺度特征
        y_local = self.local_branch(y2)
        # 全局上下文
        y_global = self.global_branch(y2)

        # 全局到局部的融合 (例如通过门控或相加)
        # 这里采用简单的门控机制,实际实现可能更复杂
        gate = torch.sigmoid(y_global)
        y_combined = y_local * gate + y_local  # 残差式融合

        y_combined = self.cv3(y_combined)
        out = self.cv4(y_combined)

        if self.shortcut:
            out = out + x
        return out


# ============================================================
# 3. 整合示例: 在 YOLO 主干中替换标准 Bottleneck
# ============================================================
if __name__ == "__main__":
    # 示例: 构建一个包含 PALA 和 GL-CRM 的简化模块
    B, C, H, W = 2, 256, 32, 32
    x = torch.randn(B, C, H, W)

    # 使用 GL-CRM 替代 CSP 瓶颈
    glcrm = GLCRM(c1=C, c2=C, n=2, shortcut=True)
    out_glcrm = glcrm(x)
    print(f"GL-CRM 输入: {x.shape}, 输出: {out_glcrm.shape}")

    # PALA 通常作用于展平后的序列特征
    # 假设特征图被展平为序列
    x_seq = x.flatten(2).transpose(1, 2)  # (B, N, C)
    pala = PALA(dim=C, num_heads=8)
    out_pala = pala(x_seq)
    print(f"PALA 输入: {x_seq.shape}, 输出: {out_pala.shape}")
四、创新点解读
4.1 问题本质:YOLO 为什么"读不懂"文档
自然图像里目标是相对独立的物体;文档里元素却沿横纵轴规则排布、跨页长程关联。通用 YOLO 把版面当成"普通图片"做检测,直接丢掉了结构先验——这正是它适配文档时"有劲使不上"的根因。
4.2 MeshLayout-1M:用"装箱算法"造出百万页数据
核心思路是把二维装箱变成版面生成器,整个合成流程如下图所示:
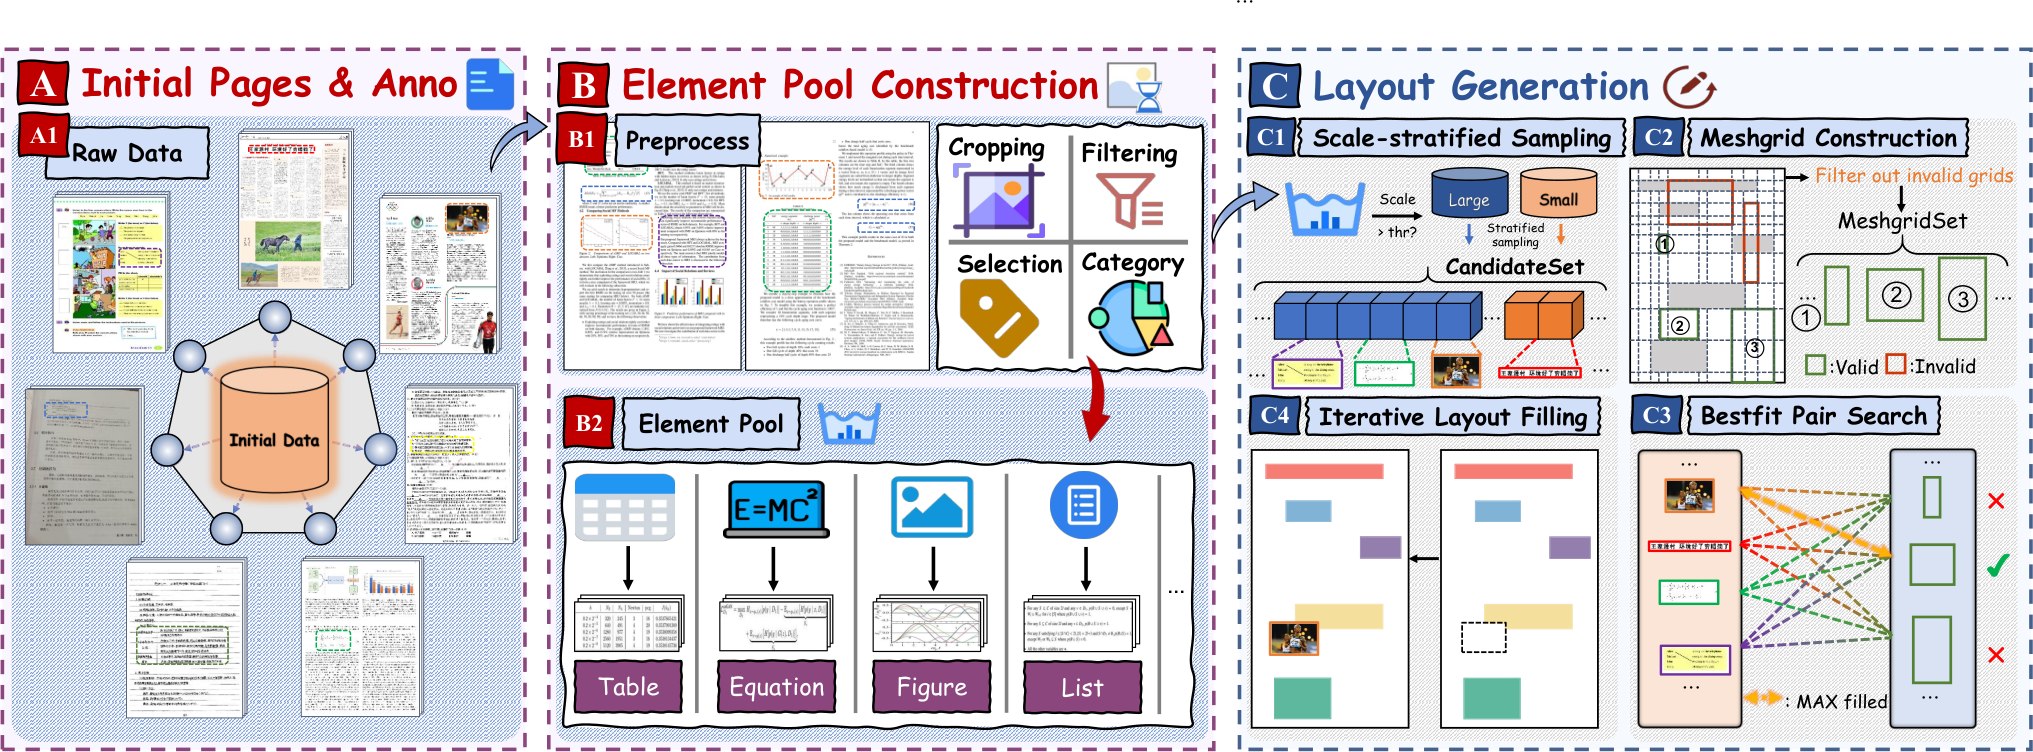
图 2:Mesh-candidate BestFit 合成流水线——元素池采样→网格构建→BestFit 配对→迭代填充
模块拆解:流程分五步——① 以 DocBank 为源建元素池(过滤过小噪声元素、按类别分层);② 网格构建,按现有布局建 meshgrid 并剔除与已放元素重叠的无效格;③ BestFit 配对,为每个候选元素找"填充率最高"的格子居中放置;④ 规模分层采样,大/小元素分组按比例抽,避免小元素淹没全局结构;⑤ 迭代填充直到无合法配对或达最大元素数。
一句话总结:可控地造出单栏 / 多栏 / 杂志式多样化版面。论文给出了布局模板的多样性分布,从单栏到多栏、从报纸到期刊杂志一应俱全:
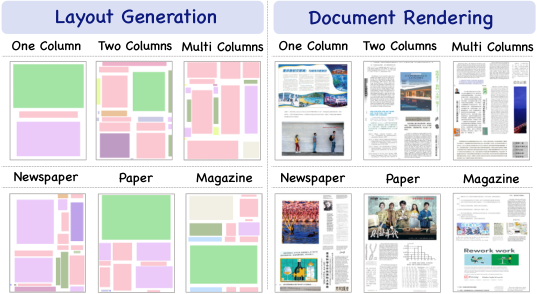
图 3:MeshLayout 生成的布局模板多样性——单/双/多栏 + 报纸/纸张/杂志等版式
质量对照:光说"多"不够,论文还把 Mesh-candidate BestFit 与 Random、Diffusion 两种布局生成路线做了同屏对比。下图中 Ours 一列的版面明显更接近真实文档——有规则、有语义、有留白,而 Random 杂乱、Diffusion 偏"艺术化",都不适合做检测器预训练。
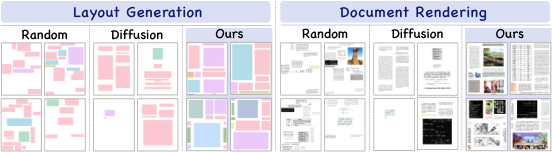
图 4:布局生成与文档渲染质量对比(Random / Diffusion / Ours)
消融实证:去掉网格构建这一步,M6Doc / HJ / PRIMA-LAD 分别掉 1.2 / 2.6 / 3.1 个点——网格约束是真实贡献,不是装饰。
4.3 PALA:把注意力"钉"在页面坐标轴上
先看清对手:在动手设计前,论文把现有几种长程注意力在"感受野形状"上做了同台对比——Swin 的局部窗口、Area Attention 的不连续区域、Criss-cross 的十字、Axial 的串行横/纵,而 PALA 用并行的横纵条带 + 独立归一化,既拿到全局轴结构,又不被方向竞争拖累。
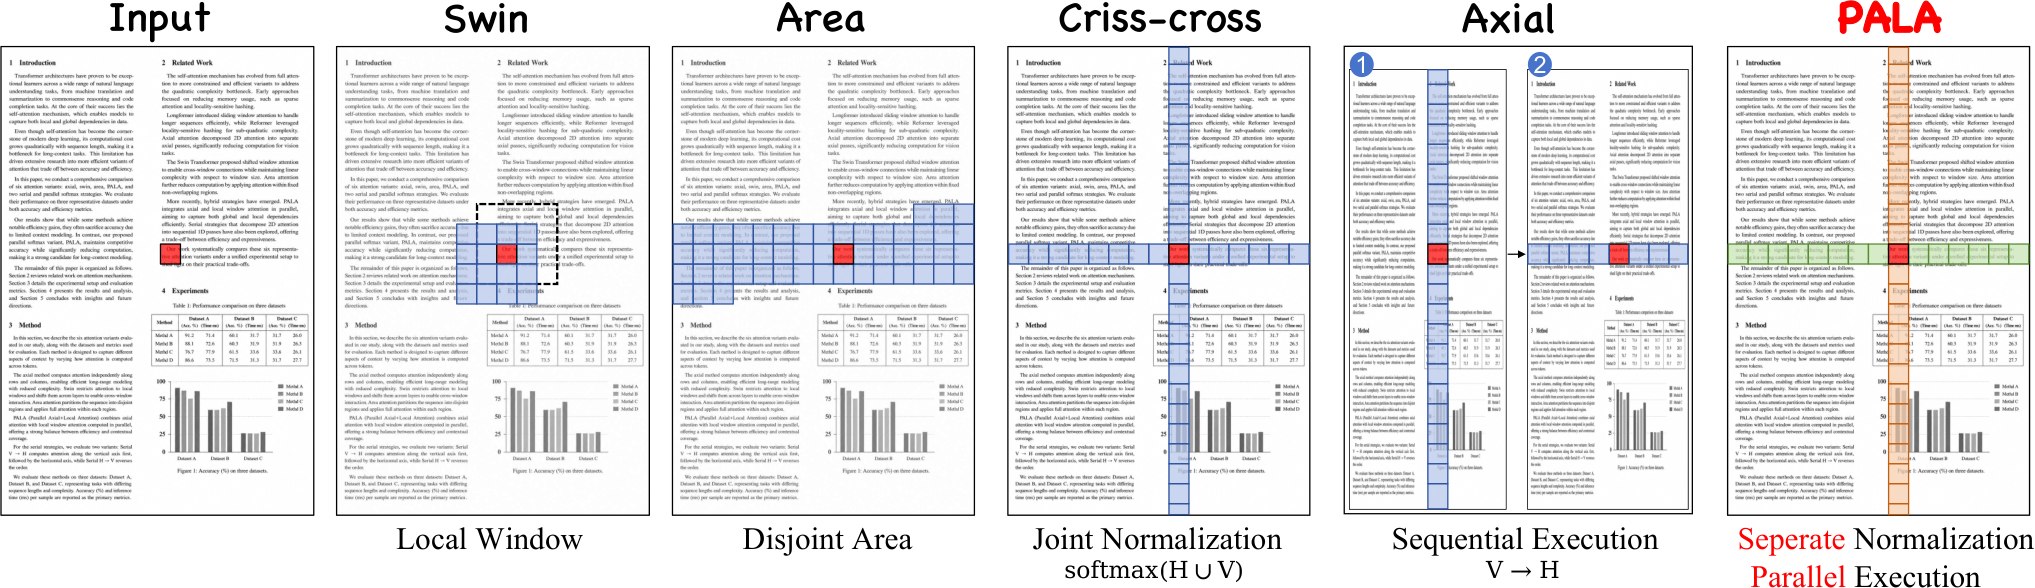
图 5:六类注意力机制感受野对比,PALA(右一)走横纵并行条带路线
模块架构如图 6 所示,拆解成五步:
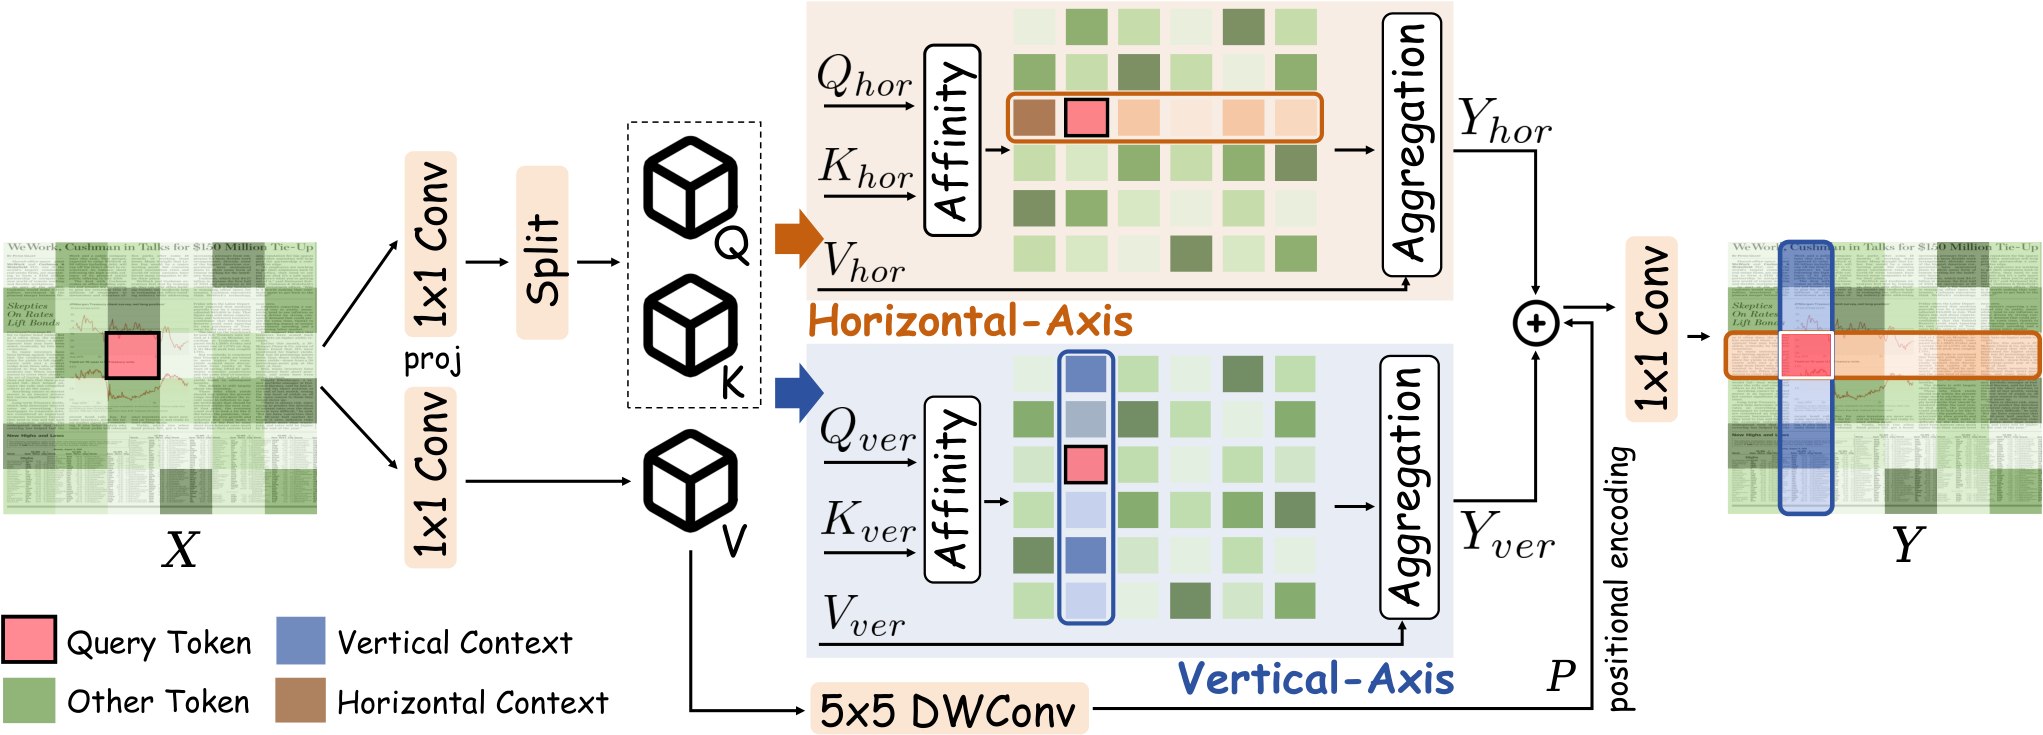
图 6:PALA 模块结构——双轴注意力 + DWConv 局部线索并行融合
- 输入 X → 1×1 投影得 Q/K(沿通道劈分)与 V;局部线索 P = DWConv₅ₓ₅(V)
- 垂直分支:把特征重组为"共享同一横坐标的 H 个位置"序列做注意力 → Y_ver
- 水平分支:重组为"一行"序列,整行聚合 → Y_hor
- 融合:Y = Proj(Y_ver + Y_hor + P),双分支独立归一化,避免方向竞争
- 复杂度:全局注意力 O(B·S⁴·C) → PALA O(B·S³·C),把"维数二次"降到"线性维数";且不像 Area Attention 把上下文限制在预设区域
- 工程细节:保留 YOLOv12 Area Attention 的同款投影与位置编码(参数量 / GFLOP 完全一致),并集成 FlashAttention;实测 N 尺度 mAP 65.3 vs 64.5,FP16 延迟 1.500ms vs 1.656ms
4.4 YOLO 生态可迁移性视角
PALA 是"即插即用"的注意力模块,定位在 YOLO 的 Stage 注意力位(与 Area Attention 同位置替换)。对做文档 / 表格检测的人,直接换掉 Area Attention 即可吃下"横纵结构先验",算力账几乎不变。这与此前我们聊的"EDDConv 类动态模块进 C3K2"是姊妹方案——一个补几何动态、一个补轴结构,都走"轻改动、吃先验"的路线。
五、实验结果
5.1 实验设置
四个异构基准在内容、尺度、语言上刻意拉开差距,下面这张 PRIMA-LAD 历史文档样例能直观说明为什么"泛化"这么难——古旧排版、竖排、手写体,和现代论文 PDF 完全是两码事:
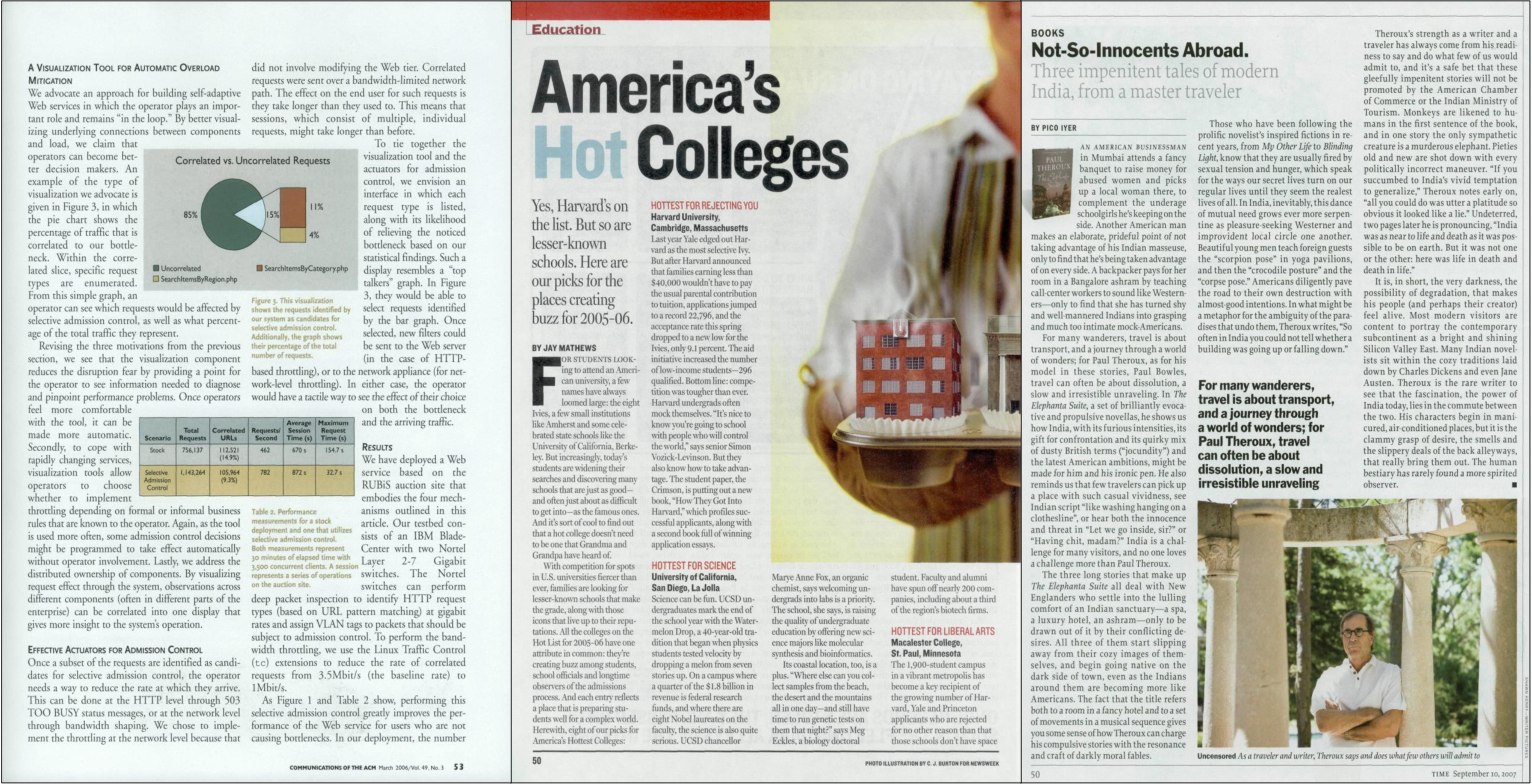
图 7:PRIMA-LAD 历史文档样例,体现基准间的强异构差异
- 数据集:D4LA(27 类)、M6Doc(74 类)、HJDataset(历史文档 7 类)、PRIMA-LAD(5 类)
- 输入 1600×1600;TensorRT FP16 延迟测于 NVIDIA H200,batch=1
5.2 主实验(Table 2,N 尺寸实时检测器对比)
方法 | FLOPs(G) | 参(M) | 延迟(ms) | D4LA | M6Doc | HJ | PRIMA |
|---|---|---|---|---|---|---|---|
YOLOv8-N | 45.9 | 2.8 | 1.1 | 64.6 | 60.2 | 87.8 | 61.3 |
YOLOv10-N | 38.2 | 2.1 | 1.4 | 66.9 | 61.5 | 92.9 | 58.7 |
YOLOv11-N | 33.1 | 2.3 | 1.3 | 65.3 | 62.6 | 88.3 | 60.5 |
YOLOv12-N | 30.2 | 2.2 | 1.7 | 66.5 | 64.5 | 89.6 | 60.4 |
YOLOv26-N | 38.2 | 2.6 | 1.6 | 65.2 | 62.6 | 91.5 | 59.5 |
DocLayout-YOLO-N | 30.2 | 2.2 | 1.5 | 67.2 | 66.2 | 93.6 | 67.7 |
同上算力档,DocLayout-YOLO-N 在四个基准全胜,PRIMA-LAD 领先 YOLOv12-N 达 7.3 个百分点。放大到 X 尺寸更进一步 72.4 / 75.5 / 96.0 / 73.1,相对 YOLOv12-X 延迟再降 18.8%,并以仅 59.4M 参数超越此前最佳单模态方法(D4LA/M6Doc 各 +1.5/+2.6)——甚至无需 OCR 或文本特征,就压过了 LayoutLMv3、VGT、DoPTA-HR 等多模态方法。
5.3 消融与全尺寸增益
- N:较 v12-N +0.7/1.7/4.0/7.3,延迟 −11.8%;较 v8/v10/v26-N 最高 +9.0%
- S:较 v12-S +1.4/1.6/3.1/6.2,延迟 −13.0%
- M:延迟 3.1ms,较 v12-M +0.5/2.4/1.9/5.0,速度 +16.2%;较 RT-DETRv3-R34 省 26.3% FLOPs
- L:较 v12-L +0.9/2.6/0.8/6.5,延迟 5.8→4.7ms
- X:较 v12-X +1.6/1.5/2.0/6.1,延迟 −18.8%
预训练数据量是最关键的旋钮:下图是 MeshLayout 合成数据量从 scratch 到 1M 的 mAP 缩放曲线,整体单调上升、1M 时到顶(75.1),说明"造数据"的收益还没到天花板——这对我们做垂直文档的启发很大。
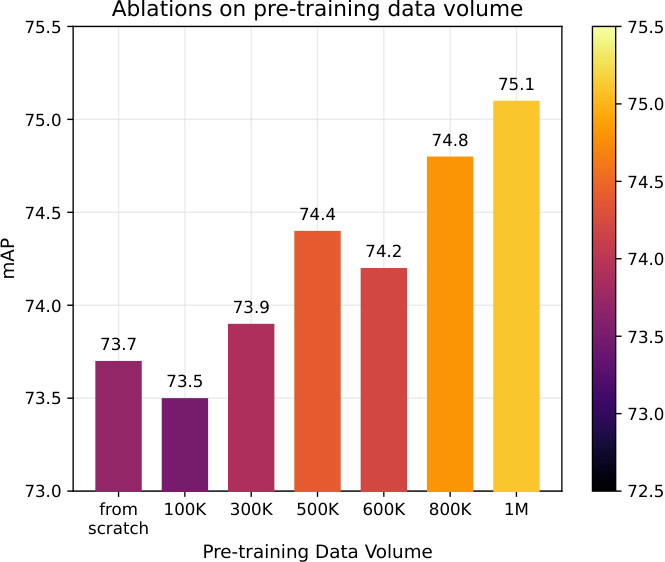
图 8:预训练数据量消融——mAP 随合成页数单调上升,1M 页到顶
眼见为实——热图对比:把 YOLOv12 与 DocLayout-YOLO 的注意力/特征响应画出来,差距一目了然。
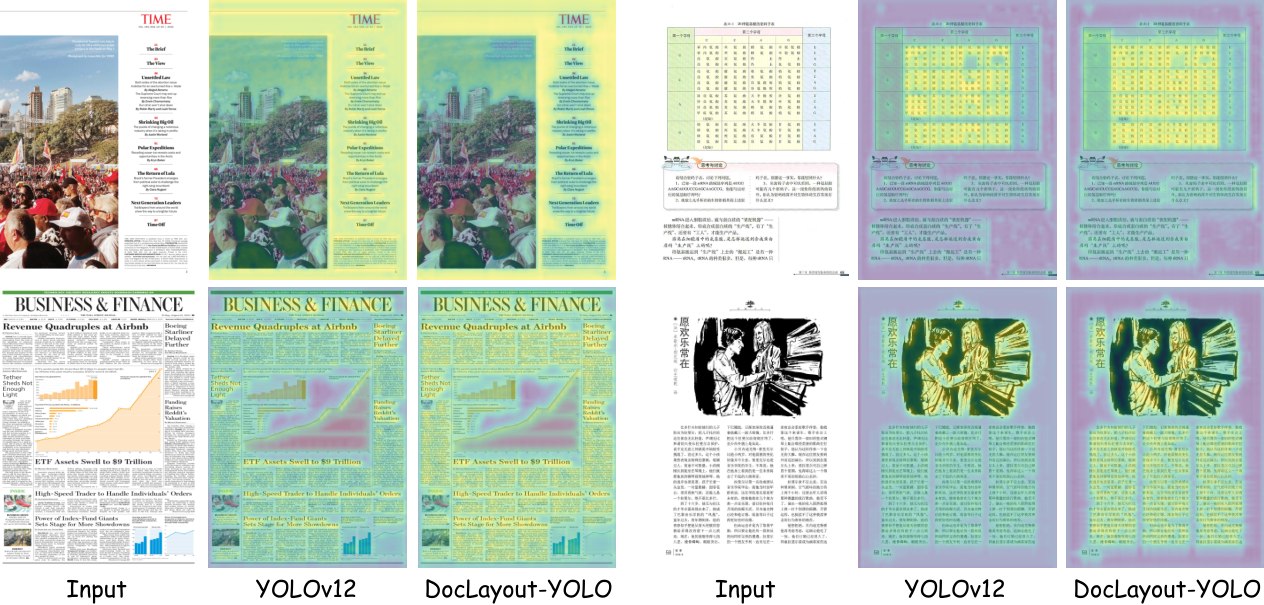
图 9:特征响应热图对比,DocLayout-YOLO 的注意力沿文本行/栏清晰成束
5.4 定性结果:真实检测效果
看图比看数字更直观。下面两张是论文给出的定性检测结果(彩色框 = 不同版面类别,含置信度):
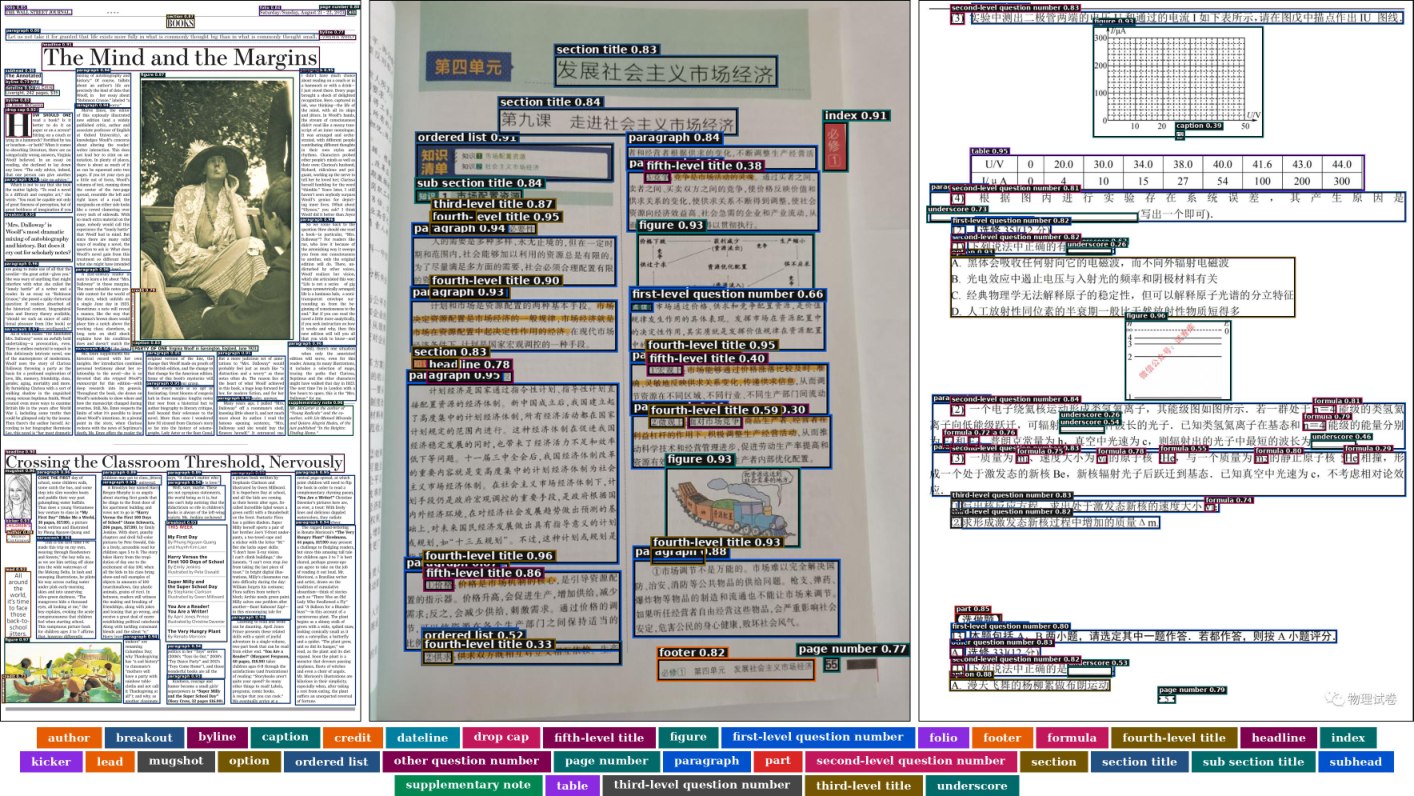
图 10:M6Doc 上的 36 类版面检测结果可视化
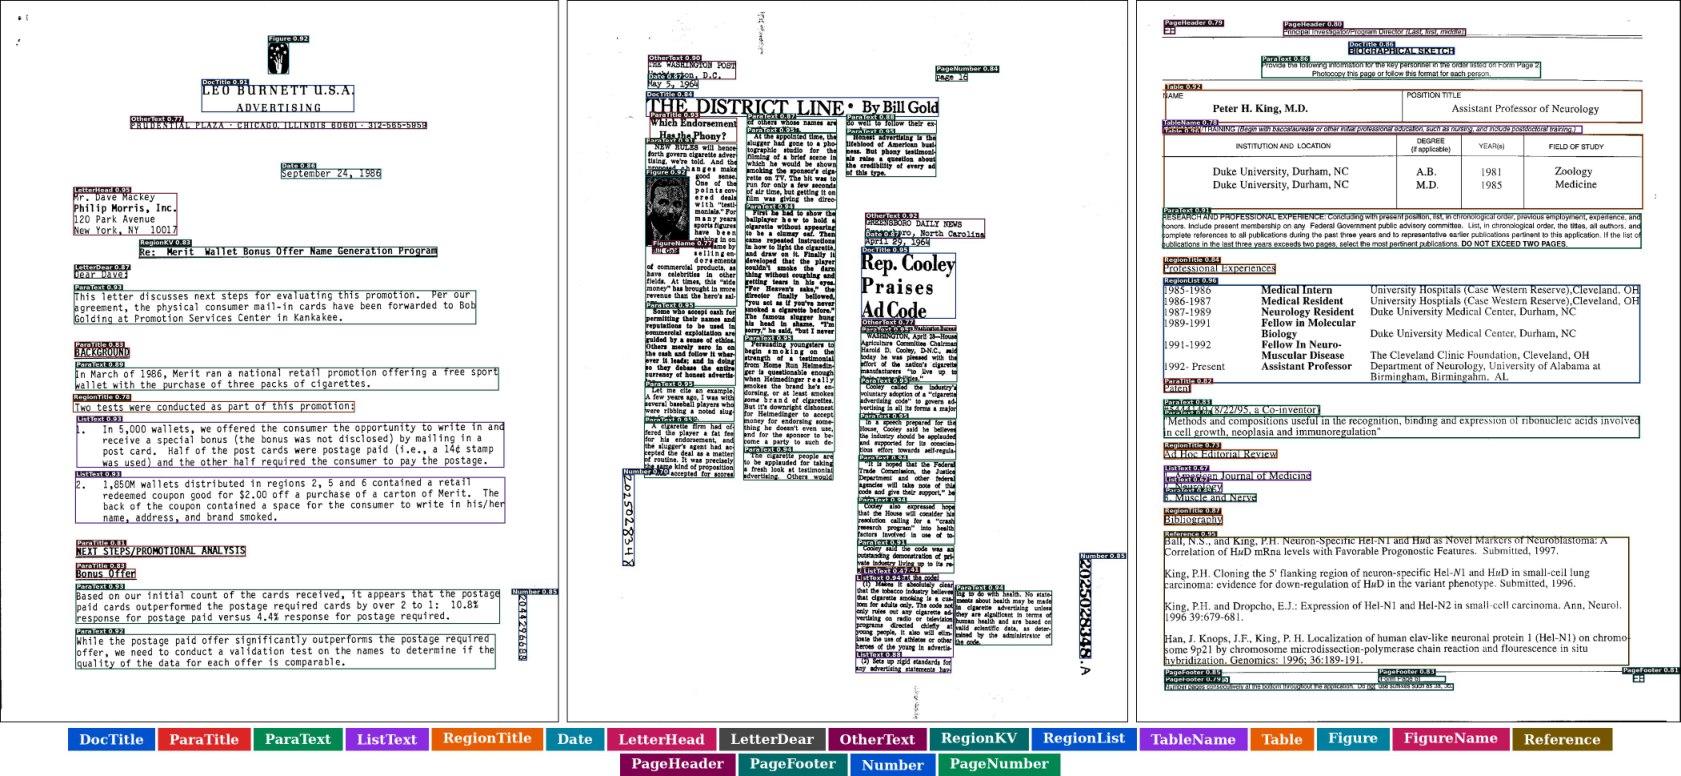
图 11:D4LA 上的检测结果可视化,涵盖多版式历史/现代文档
点评:框的贴合度与类别边界都很干净,连嵌套表格、跨栏标题这类硬骨头也咬得住——这正是"轴结构先验 + 大规模合成预训练"双重加持的落地效果。
六、展望
论文自述局限:
- 部署效率:PALA 实际加速随硬件 / 后端 kernel 优化波动,需算子级优化才能跨平台稳定;
- 建模范围:PALA 围绕横纵规则布局,强旋转 / 透视 / 非轴对齐的复杂版面,需要更灵活的方向建模;
- 合成范围:MeshLayout 元素池源自 DocBank,内容 / 语种 / 外观多样性有限,需扩源并融入更丰富的语义关系。
复现建议:直接拉 release-v2 权重,重点验证 PALA 在你目标 GPU 上的 kernel 效率——论文也提示,这是落地的第一道坎。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号